SnapRef: ComfyUI에서 Anima를 위한 캐시된 KV 참조 어댑터
SnapRef v1a는 어텐션 키와 값을 캐시하여 참조 이미지 한 장으로 Anima 캐릭터를 유지하며, 이미지당 8.9초가 걸립니다. ComfyUI 노드와 FP8 가중치가 포함되어 있습니다.
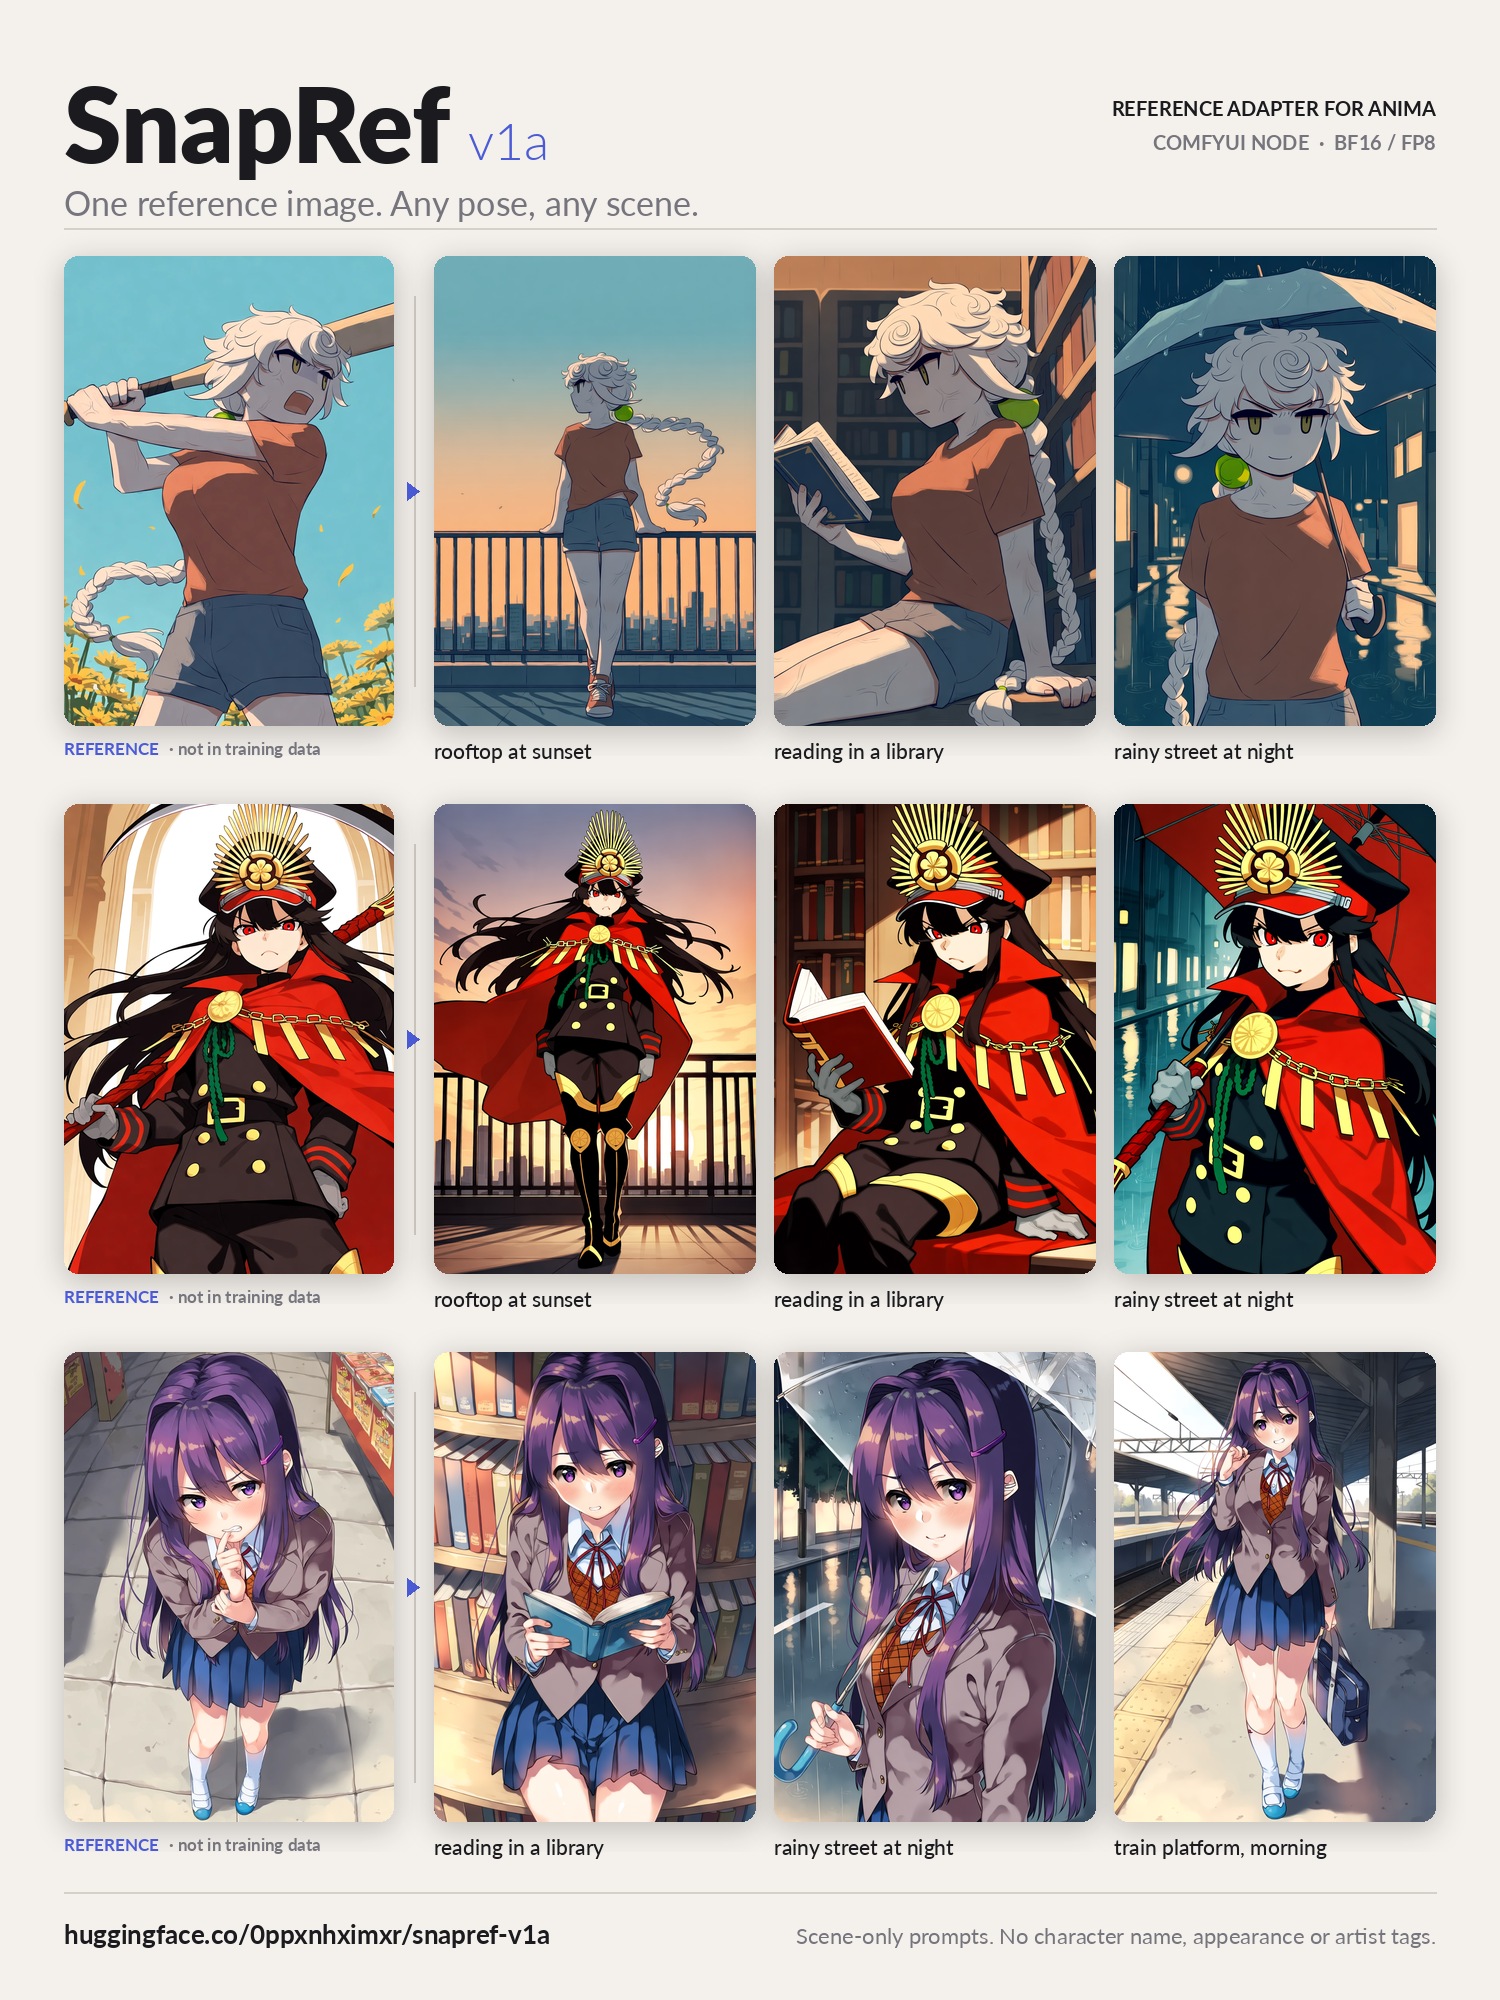
참조 이미지 한 장, 장면만 언급하는 프롬프트.
Anima는 태그 프롬프트 모델이므로, 보통은 프롬프트에 머리카락, 눈, 의상을 일일이 적어 캐릭터를 재현하며, 그것도 모델이 이미 알고 있는 캐릭터에만 해당합니다. 참조 어댑터는 그 작업을 이미지로 옮깁니다. 텍스트는 포즈, 구도, 장소를 담당하고, 참조는 누가 그려질지를 담당합니다.
이 아이디어가 Anima에서 새로운 것은 아닙니다. Anima Reference Adapter는 10월 27일 참조를 오프셋된 두 번째 잠재 데이터 프레임으로 덧붙이는 방식으로 이를 구현했습니다. 비디오 스타일의 사전 지식이 이를 하나의 샷으로 이어가지 못하게 한 것입니다. SnapRef는 다른 경로를 택합니다. 참조를 모델에 한 번 통과시키고 각 레이어가 만들어내는 결과를 캐시한 뒤, 매 샘플링 단계에서 그 캐시를 다시 읽습니다.
참조가 캐시되는 방식
어댑터 파일은 하나의 키 anima_ref_kv/1 아래 묶인 두 개의 LoRA 분기입니다. 28개 블록 전부의 셀프 어텐션, 크로스 어텐션, 두 MLP 레이어에 걸린 rank-128 참조 분기와, 대상 측 셀프 어텐션에 걸린 rank-64 분기입니다. 합계 1억 9,080만 개 파라미터, bf16 기준 382 MB입니다.
참조는 한 번 인코딩되어 고정된 토큰 집합으로 유지되며, 모델의 좌표 공간에서 고유한 위치를 가집니다. 그래서 모델이 참조의 레이아웃을 복사하는 대신 모양을 읽어들이게 됩니다. 샘플링 중에 각 레이어는 자기 토큰과 캐시된 참조에 어텐션합니다. 대상 측 LoRA는 모든 대상 순전파에서 켜져 있고, 기본적으로는 긍정 CFG 분기만 참조를 읽습니다. ref_guidance를 쓰면 두 분기 모두로 보냅니다. 참조가 단계마다 다시 인코딩되지 않으므로, 모델 카드는 비용을 참조 없는 생성 대비 약 15%로 제시합니다.
두 가지 모드가 제공됩니다. cs는 캐릭터와 스타일을 함께 복사하고, char는 캐릭터만 복사하여 아티스트 태그가 스타일을 정할 수 있게 합니다. 별도의 ref_guidance 경로는 약 1.4배의 시간으로 참조 쪽을 더 강하게 밀어붙이며, 색이 과도하게 포화되는 것을 막기 위해 APG나 CFG rescale을 사용합니다. 이전 어댑터에서도 필요했던 것과 같은 보정입니다.
다른 방식과 비교한 비용
저장소에는 comparison_summary.json이 포함되어 있습니다. A100에서 832×1216, 28 스텝, 각 어댑터를 자체 기본값으로 실행해 측정한 동일 조건 타이밍 표입니다.
| 방식 | 이미지당 초 |
|---|---|
| SnapRef v1a | 8.95 |
| ElectronGirl v2 | 14.36 |
| Role-Ref-KV | 12.53 |
| Anima Base, 참조 없음 | 7.72 |
동일성 측면에서 모델 카드는, 학습에서 제외된 캐릭터에 대해 어댑터가 잘못된 참조보다 올바른 참조를 쓸 때 대상을 더 잘 예측한다고 보고합니다. 홀드아웃 디노이징 손실에서 0.0041의 동일성 격차이며, 케이스별 수치는 heldout_loss.json에 있습니다.
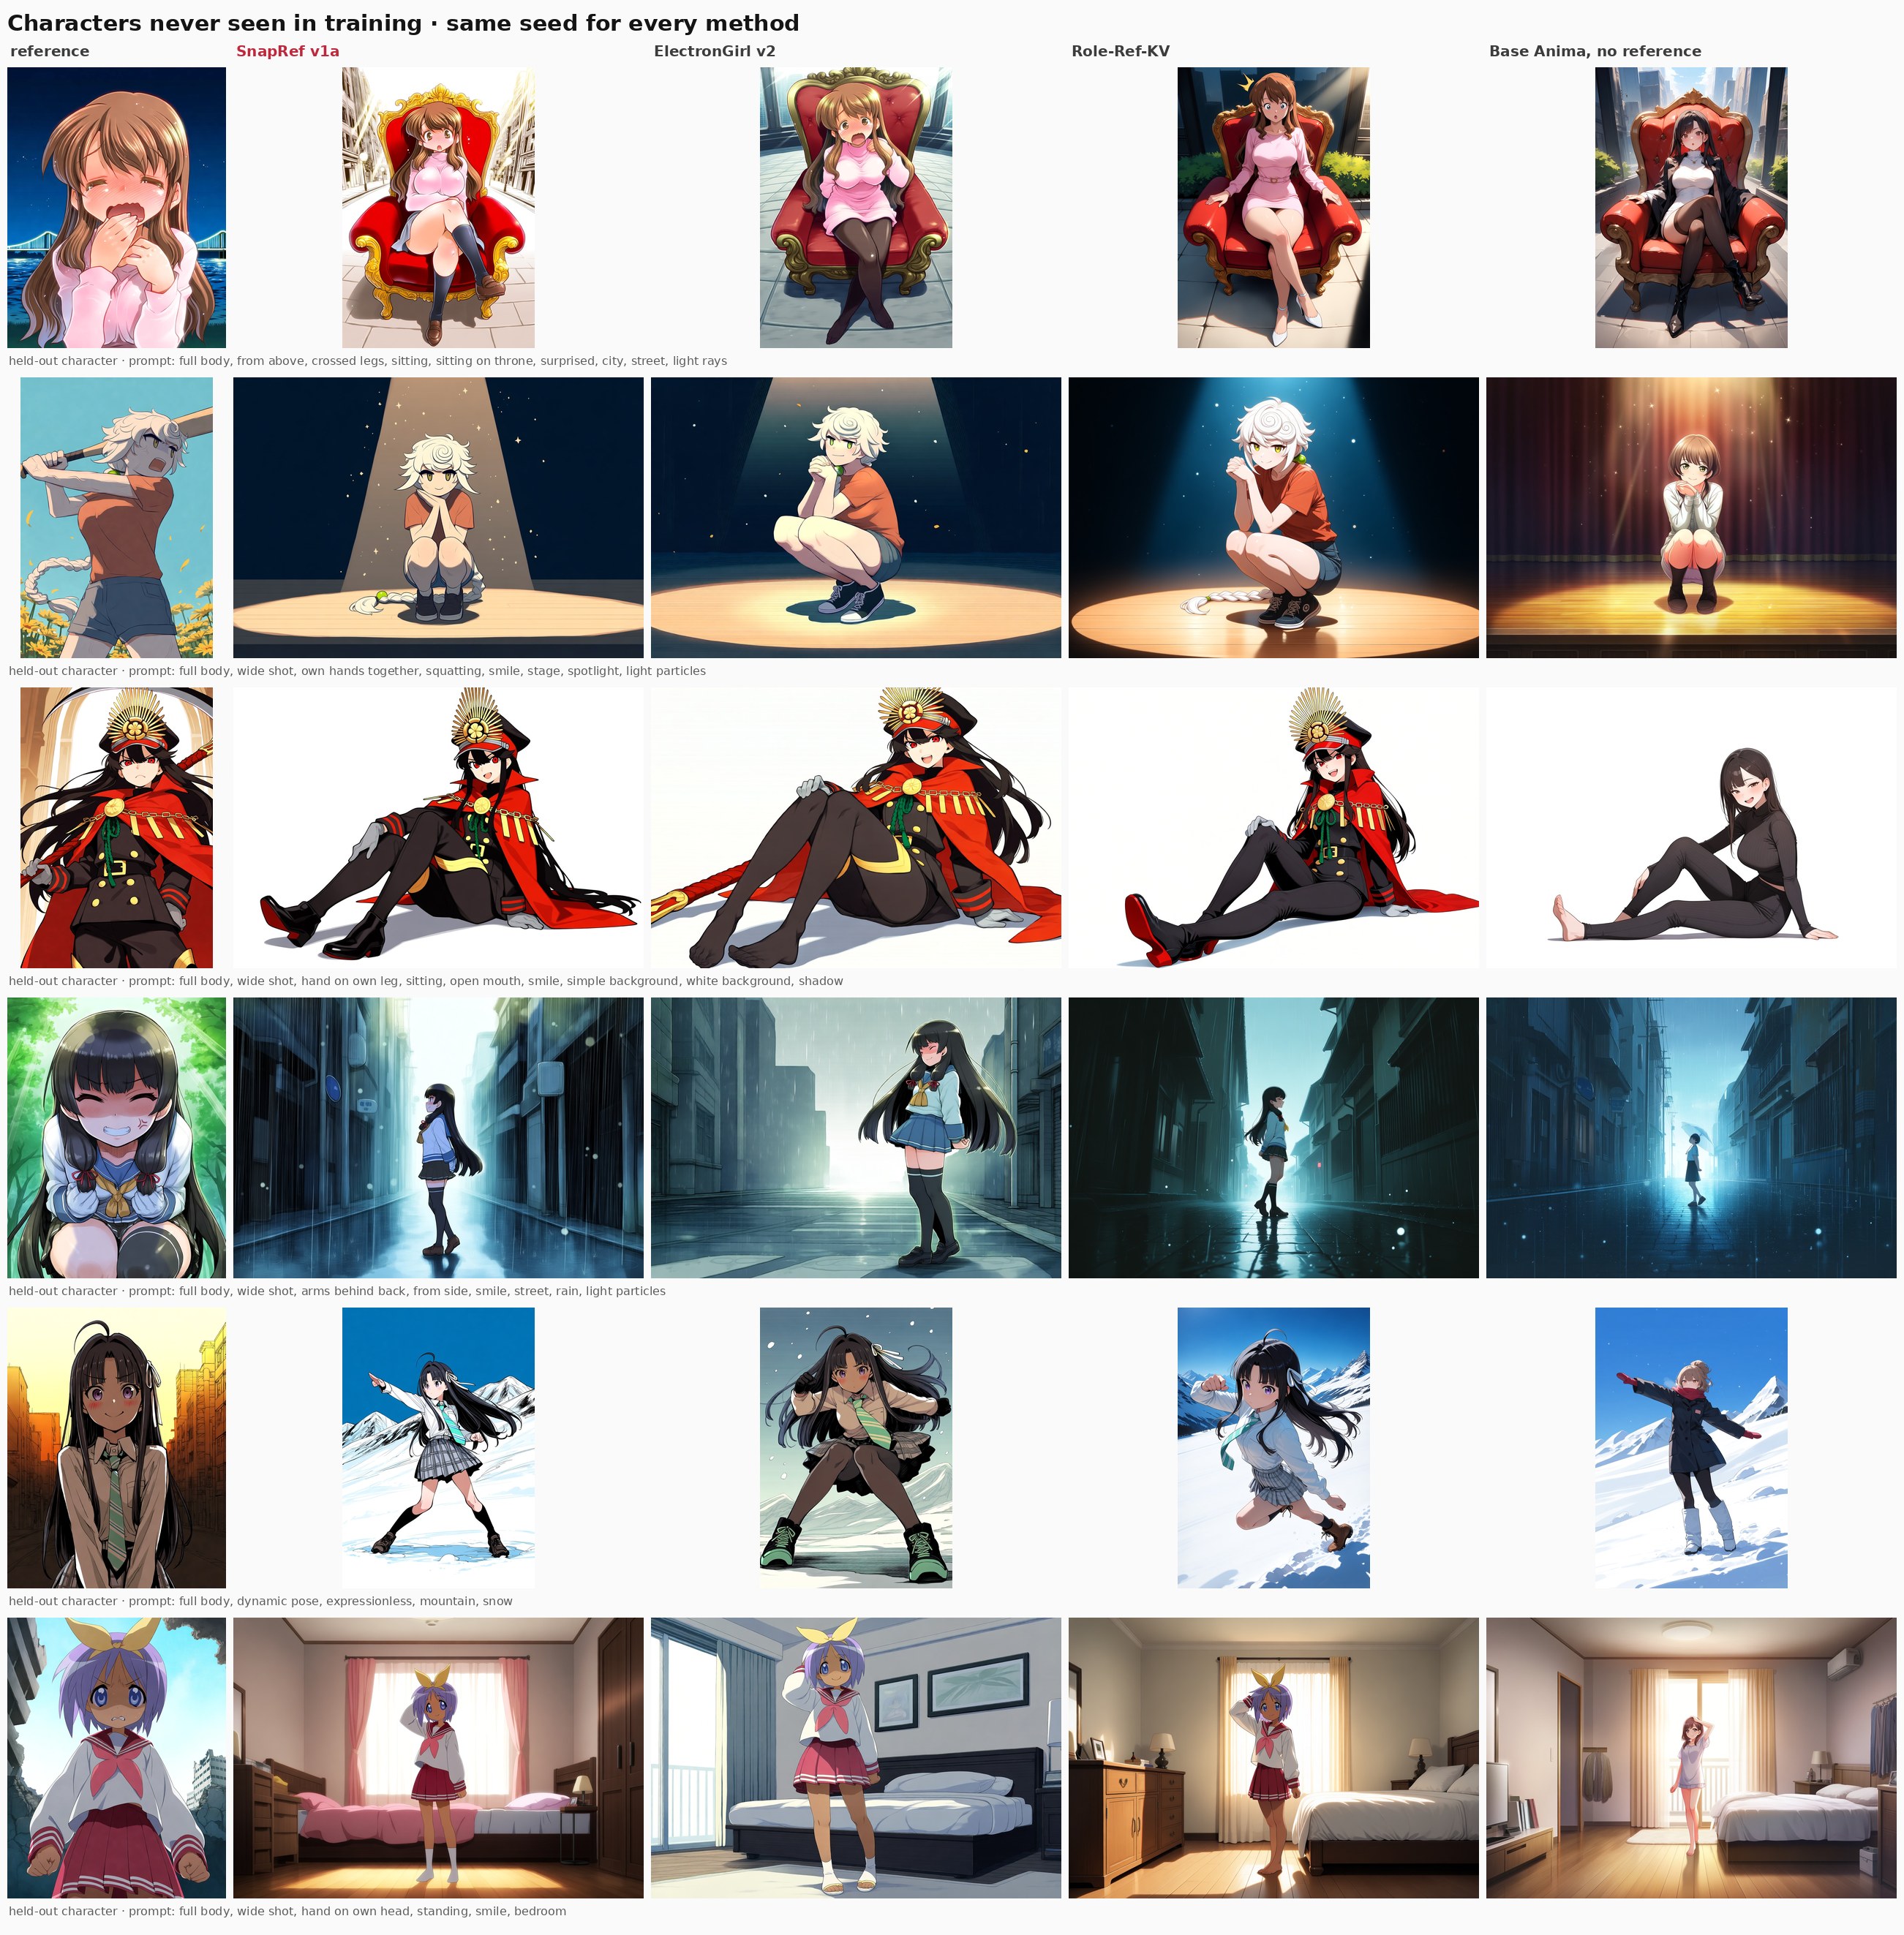
학습에 포함되지 않은 캐릭터. 프롬프트는 장면만 언급하며, 머리카락, 눈, 의상은 참조에서 가져옵니다.
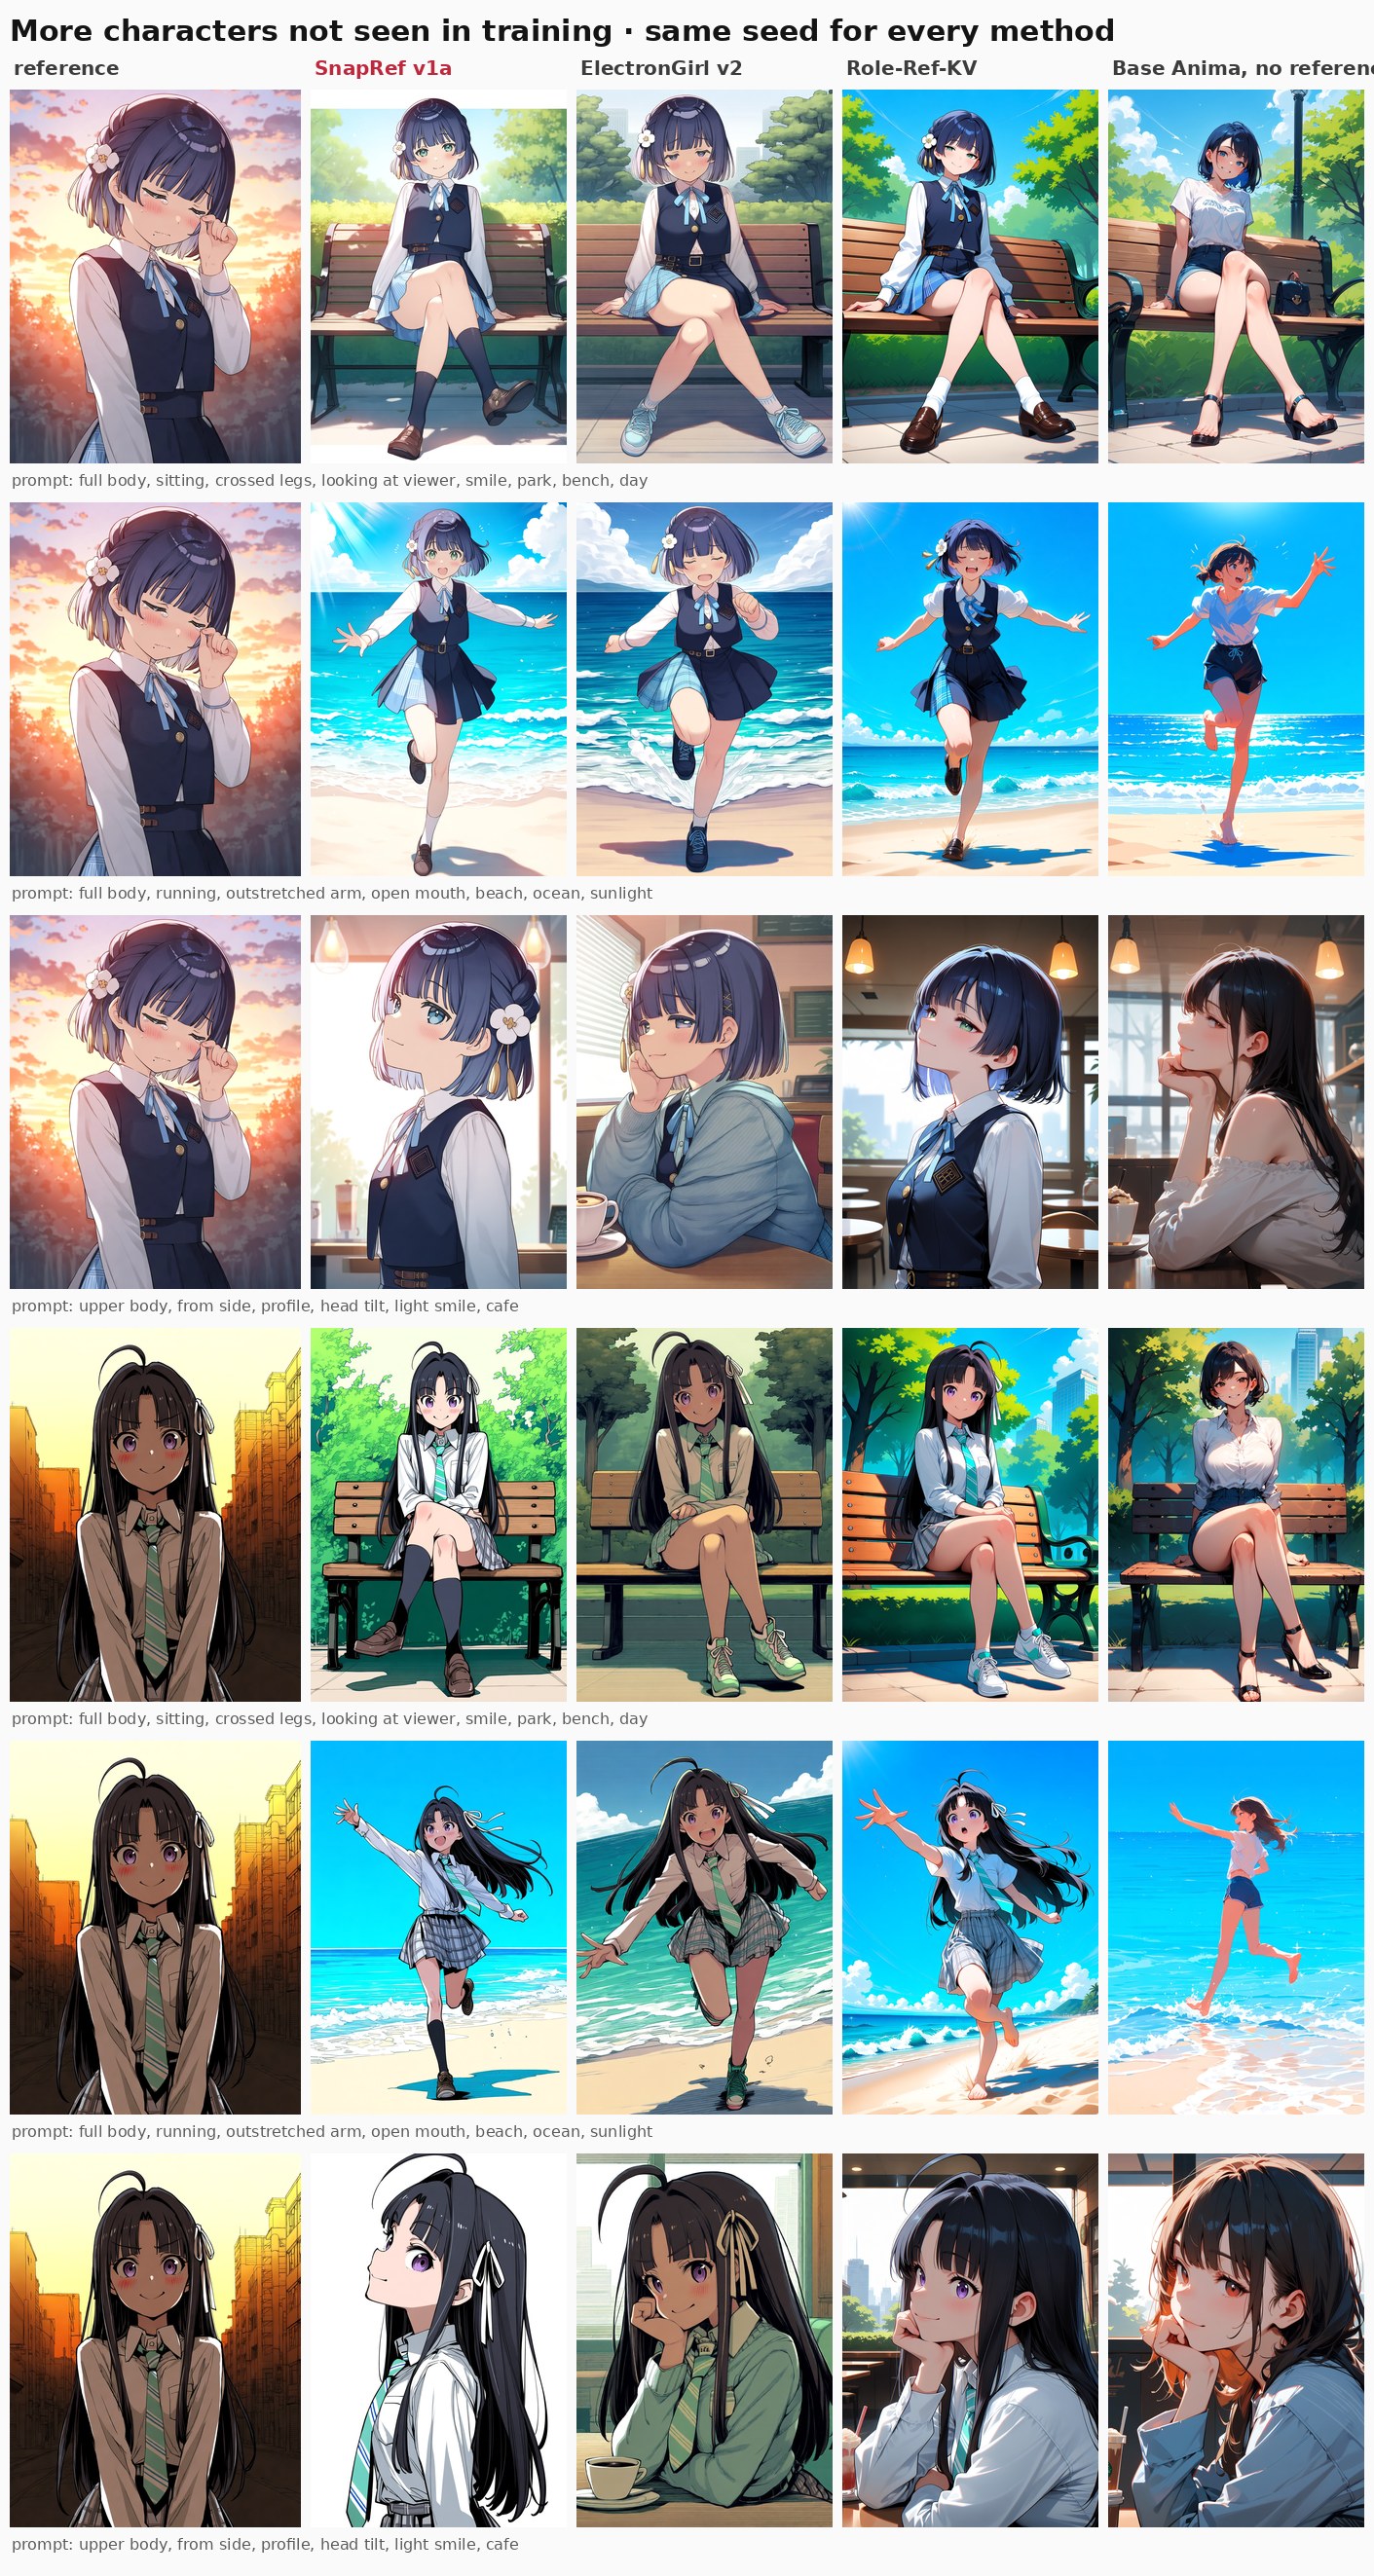
학습 세트 외부의 참조를 어댑터로 실행한 결과.
학습 데이터는 Anima 자체로 생성되었습니다. 2,367개 캐릭터에 걸친 58,300개 이미지로, 각 캐릭터를 하나의 아티스트 스타일로 다양한 장면과 포즈에 걸쳐 그린 뒤 약 120 H100 GPU 시간을 들여 학습했습니다. 두 번째 체크포인트인 SnapRef v1b는 LoRA rank를 두 배로 올렸고, 프롬프트를 더 잘 따르면서 캐릭터도 거의 같은 수준으로 유지합니다.
ComfyUI 쪽 구성
노드 팩은 저장소의 comfyui/snapref/에 있습니다. custom_nodes/로 복사하고, 어댑터를 models/loras/에 넣은 뒤, LoRA 로더가 아니라 SnapRef 노드로 불러오세요. 두 분기가 일반 LoRA가 아니기 때문입니다. 간단 노드는 사진 한두 장, 모드, strength, fidelity를 받고, 고급 노드는 ref_in_uncond, ref_megapixels, ref_caption을 포함한 나머지 모든 항목을 노출합니다.
워크플로 5개가 포함되어 있습니다. 단일 캐릭터, 두 캐릭터, 한 캐릭터의 여러 참조, 다른 어댑터와의 나란히 비교, 그리고 아래의 최소 구성입니다. 두 캐릭터의 경우 지침은 핵심 Image Stitch 노드로 두 참조를 이어 붙이고 프롬프트에 누가 왼쪽에, 누가 오른쪽에 있는지 설명하는 것입니다. 권장 샘플링은 simple과 함께 euler 또는 er_sde, 28~30 스텝, CFG 4.5입니다.
FP8 어댑터는 382 MB 대신 195 MB이며, FP8 Anima 베이스에서도 포함해 사실상 동일한 이미지를 낸다고 보고되어 있습니다. 노드는 10월 31일 참조 인코딩을 fp32로 유지하도록 업데이트되었습니다. fp16 체크포인트, --fp16-unet, 또는 fp16 누산을 쓰는 --fast를 사용하면 이전 버전은 NaN과 검정색 이미지를 만들어냈습니다.
한계가 드러나는 지점
모델 카드는 실패 유형을 숨기지 않고 나열합니다. 귀걸이, 섬세한 무늬, 흉터처럼 아주 작은 세부 정보는 단순화될 수 있고, 어두운 피부의 참조는 더 밝게 나올 수 있으며, 일부 실외 전신 프롬프트는 바닥을 명시하지 않으면 프레임 하단이 밋밋한 흰색 바닥이 됩니다. 장면이 참조의 의상을 덮어쓸 수 있어서 해변 프롬프트는 수영복을 반환합니다. strength를 높이거나 의상을 명시하면 유지됩니다. 두 캐릭터의 경우 참조가 명확히 보여주지 않는 속성, 예컨대 감은 눈 같은 것이 둘 사이에서 섞일 수 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.