Anima Reference Adapter: 이미지 한 장으로 ComfyUI에서 새로운 장면 만들기
Anima Reference Adapter는 이미지 한 장에서 캐릭터와 그 그림체를 유지하면서 프롬프트로 포즈와 배경을 설정합니다. rank-32 LoRA와 세 개의 ComfyUI 노드로 구성됩니다.
태그 프롬프트 기반 애니메이션 모델은 프롬프트에 모든 특성을 일일이 적어야만, 그리고 모델이 이미 알고 있는 캐릭터에 대해서만 요청한 대상을 그려냅니다. 참조 어댑터는 그 작업을 텍스트에서 떼어냅니다. 이미지 한 장을 가리키면 프롬프트는 포즈, 구도, 장소를 자유롭게 설명할 수 있습니다.
비디오 모델에서 빌려온 대부분의 참조 조건화는 그런 교환을 해내지 못합니다. ComfyUI-Cosmos-Reference는 참조 잠재 데이터를 클립의 추가 프레임으로 덧붙이는데, 편집에는 잘 작동하지만 비디오 사전 지식이 그 프레임을 이전 샷으로 읽기 때문에 참조의 포즈와 레이아웃까지 복사합니다. Anima Reference Adapter는 정반대를 요구합니다. 누구를 그리고 어떻게 그릴지는 유지하고, 어디서 어떤 포즈로 그릴지는 버립니다.
참조가 연결되는 방식
Anima는 Cosmos-Predict2 MiniTrainDIT 위에서 동작합니다. 28개 블록, 너비 2048, 16개 헤드, 16채널 Wan 2.1 VAE 잠재 데이터 위의 2×2 공간 패치, Qwen3-0.6B 텍스트 인코더, shift 3의 flow matching을 사용합니다. 덕분에 (t, h, w)에 대한 3D 회전 위치 임베딩을 갖게 되며, 이것이 어댑터가 활용하는 지렛대입니다.
참조 이미지는 출력 해상도에 레터박스로 맞춰지고, 한 번 VAE 인코딩된 뒤 두 번째 잠재 프레임으로 덧붙여집니다. 일반적인 비디오 스타일 참조와 구분되는 세 가지 변경이 있습니다.
- 깨끗한 참조 프레임. 참조 프레임은 타임스텝 0으로, 대상 프레임은 σ로 입력됩니다. 참조 쪽에는 노이즈가 전혀 더해지지 않습니다.
- 오프셋 RoPE. 참조 프레임의 높이 좌표는 대상 그리드를 넘어 이동됩니다(대상 높이 하나에 더해 학습 중 약간의 지터). 따라서 픽셀 단위의 대응이 남지 않고, 모델이 참조를 하나의 샷으로 이어 그릴 수 없습니다.
- 학습된 판독기. 모든 블록의 셀프 어텐션, 크로스 어텐션, 두 MLP 레이어에 α = 32로 적용된 rank-32 LoRA(280개 모듈, 45.9M 파라미터)가 그렇게 이동된 프레임을 읽는 법을 학습합니다. 이 LoRA는 포워드 훅을 통해, 참조를 포함한 모델 호출 중에만 적용되므로 로드된 베이스 모델은 참조 없는 패스도 여전히 실행할 수 있습니다.
가이드 또한 분리됩니다. 참조가 양쪽 CFG 브랜치에 들어가면 텍스트만 증폭됩니다. 대신 가이더는 텍스트와 참조 스케일을 따로 사용하므로, ref_guidance는 cfg를 건드리지 않고 결과를 참조 쪽으로 움직일 수 있습니다. 참조 가이드가 높으면 과포화되기 때문에, 노드는 그 위에 적응형 투사 가이던스 또는 CFG rescale을 적용합니다.
홀드아웃 캐릭터가 보여주는 것
학습 데이터는 합성 데이터이며 Anima 자체로 만들어집니다. 하나의 스타일로 그린 한 캐릭터당 600개 그룹, 각각 구도, 카메라, 포즈, 표정, 배경, 조명을 독립적으로 샘플링한 렌더 6장을 생성하여, 300명의 캐릭터와 427명의 작가에 걸쳐 3,600장의 이미지를 단일 RTX PRO 6000 Max-Q에서 4.25시간에 만들어냅니다. 캐릭터 12명은 완전히 홀드아웃되었고, 남은 576개 그룹에서 17,280쌍의 정렬된 참조-대상 쌍이 생성되었으며, 그중 70%는 대상 프롬프트에서 모든 모양 및 의상 태그를 제거했습니다.
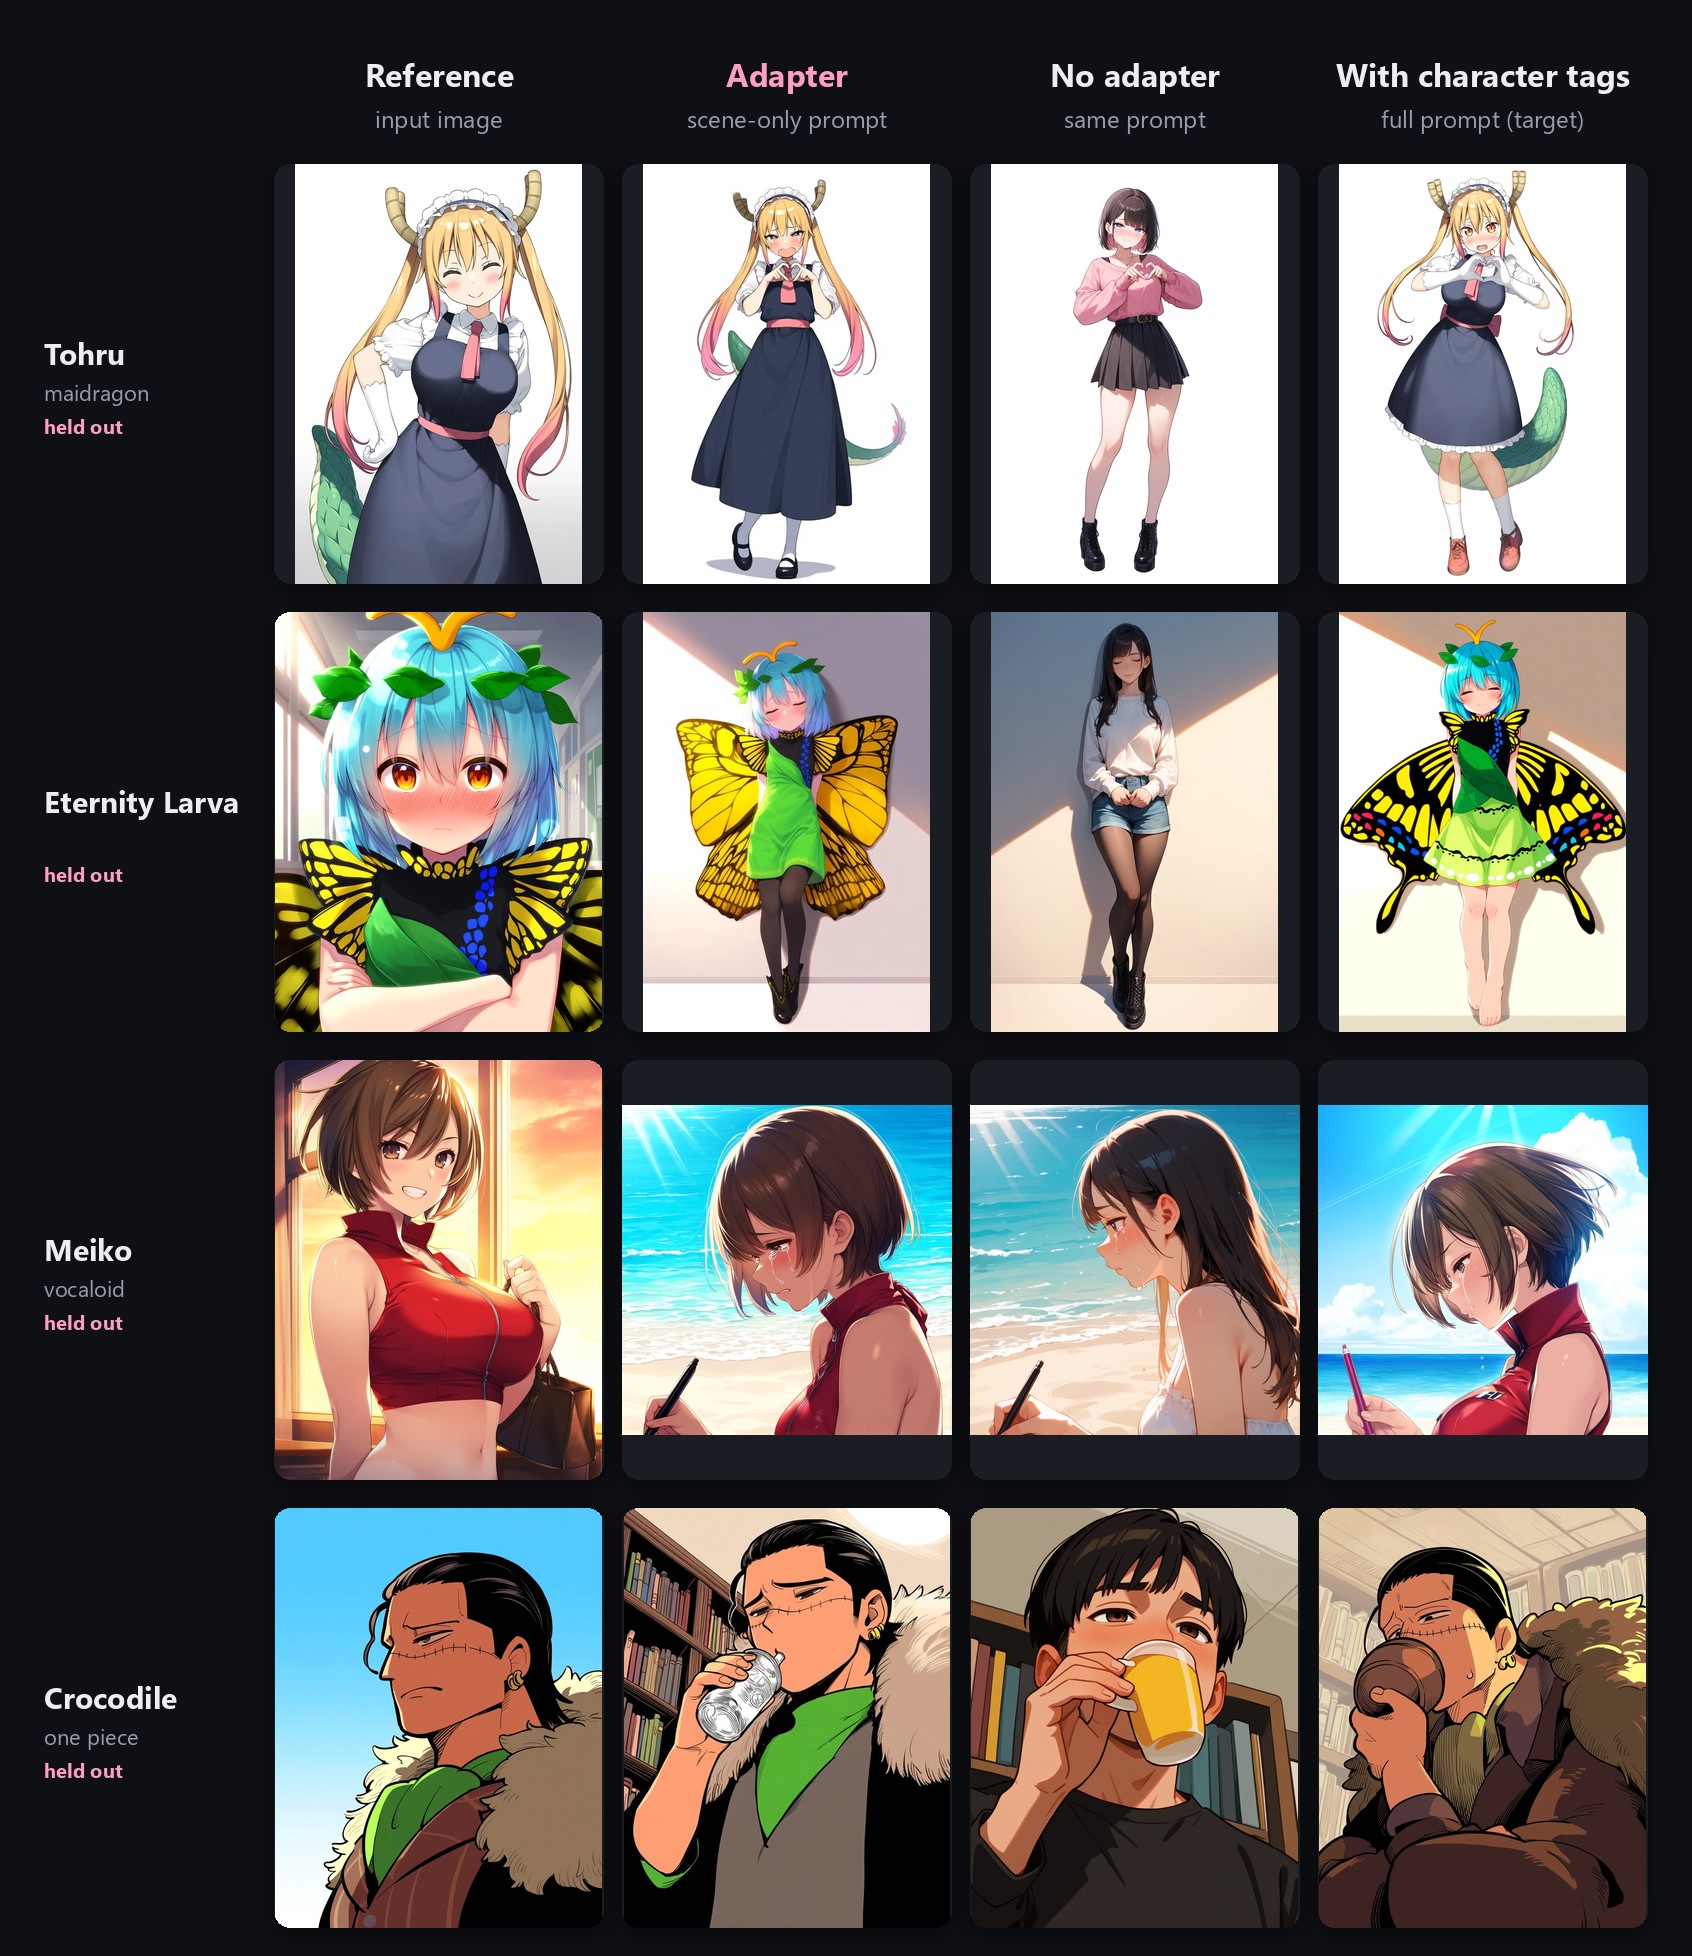
학습에서 한 번도 본 적 없는 홀드아웃 캐릭터. 각 행: 참조; 장면만 설명한 프롬프트를 사용한 어댑터; 어댑터 없이 같은 프롬프트; 전체 모양 태그와 함께 캐릭터를 이름으로 요청한 베이스 모델.
18개의 평가 사례 전반에서 어댑터는 머리카락 색과 스타일링, 눈 색, 의상, 그리고 뿔과 꼬리, 후광, 나비 날개, 메이드 헤드드레스 같은 시그니처 액세서리를 재현했으며, 반면 장면만 설명한 같은 프롬프트를 민짜 베이스 모델에 넣으면 일반적인 캐릭터가 나왔습니다. 포즈, 구도, 배경은 모든 사례에서 프롬프트를 따랐고, 포즈 복사는 관찰되지 않았습니다.
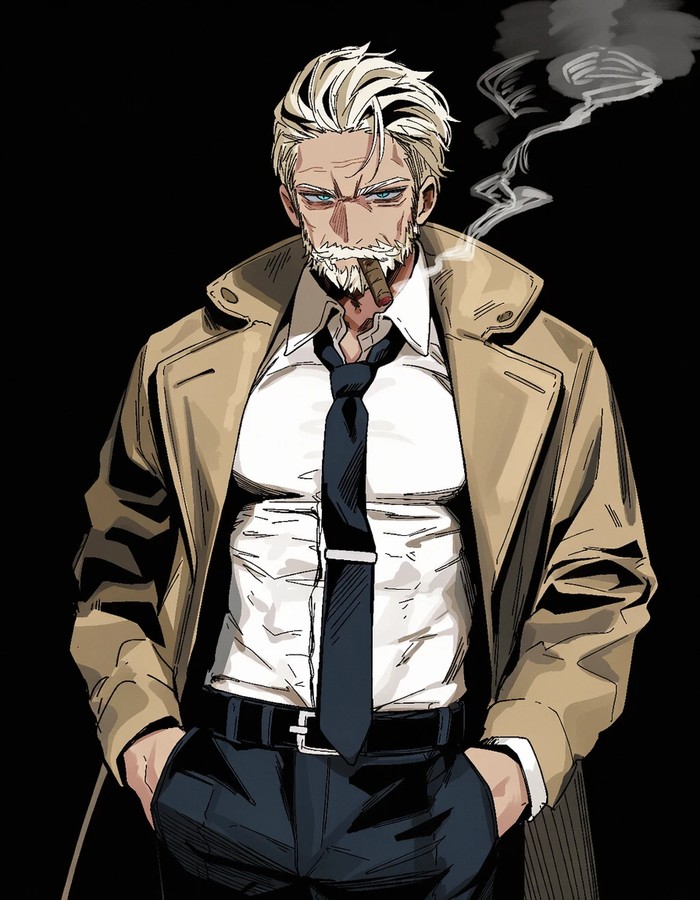
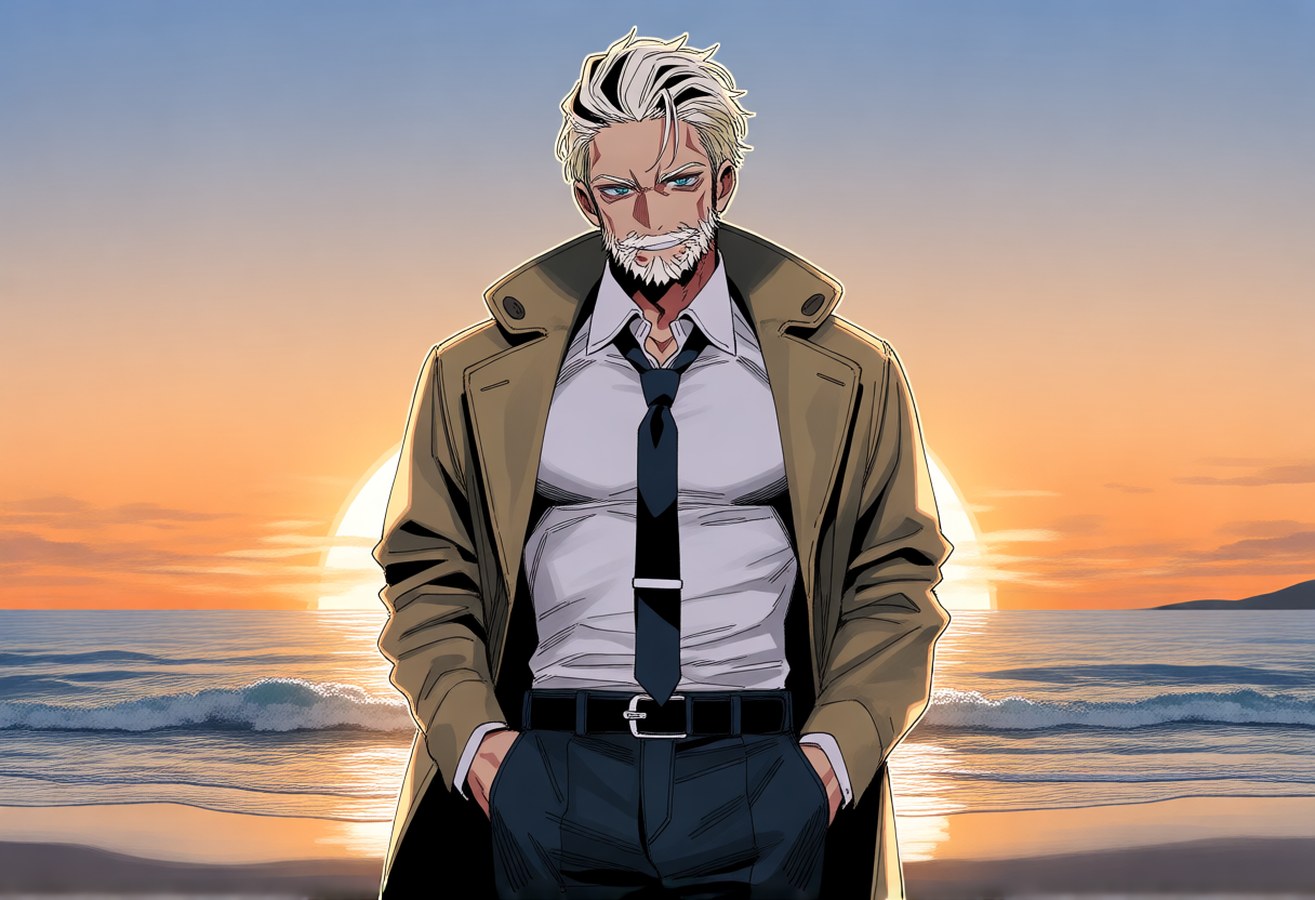
홀드아웃 세트 밖에서도 평범한 참조 두 개가 같은 분리를 보여줍니다.
 |  |
|---|---|
| 참조 A, 어댑터에 제공된 유일한 이미지 | cowboy shot, looking at viewer, smile, beach, ocean, sunset |
프롬프트에는 캐릭터 이름, 작가 태그, 모양 태그가 전혀 없습니다. 권장 설정은 simple과 함께 Euler 2830 스텝, 텍스트 CFG 4.5, 참조 가이드 4.56과 APG, 그리고 bf16 연산입니다. Anima는 fp16에서 오버플로가 발생하기 때문입니다.
스타일은 더 약한 쪽
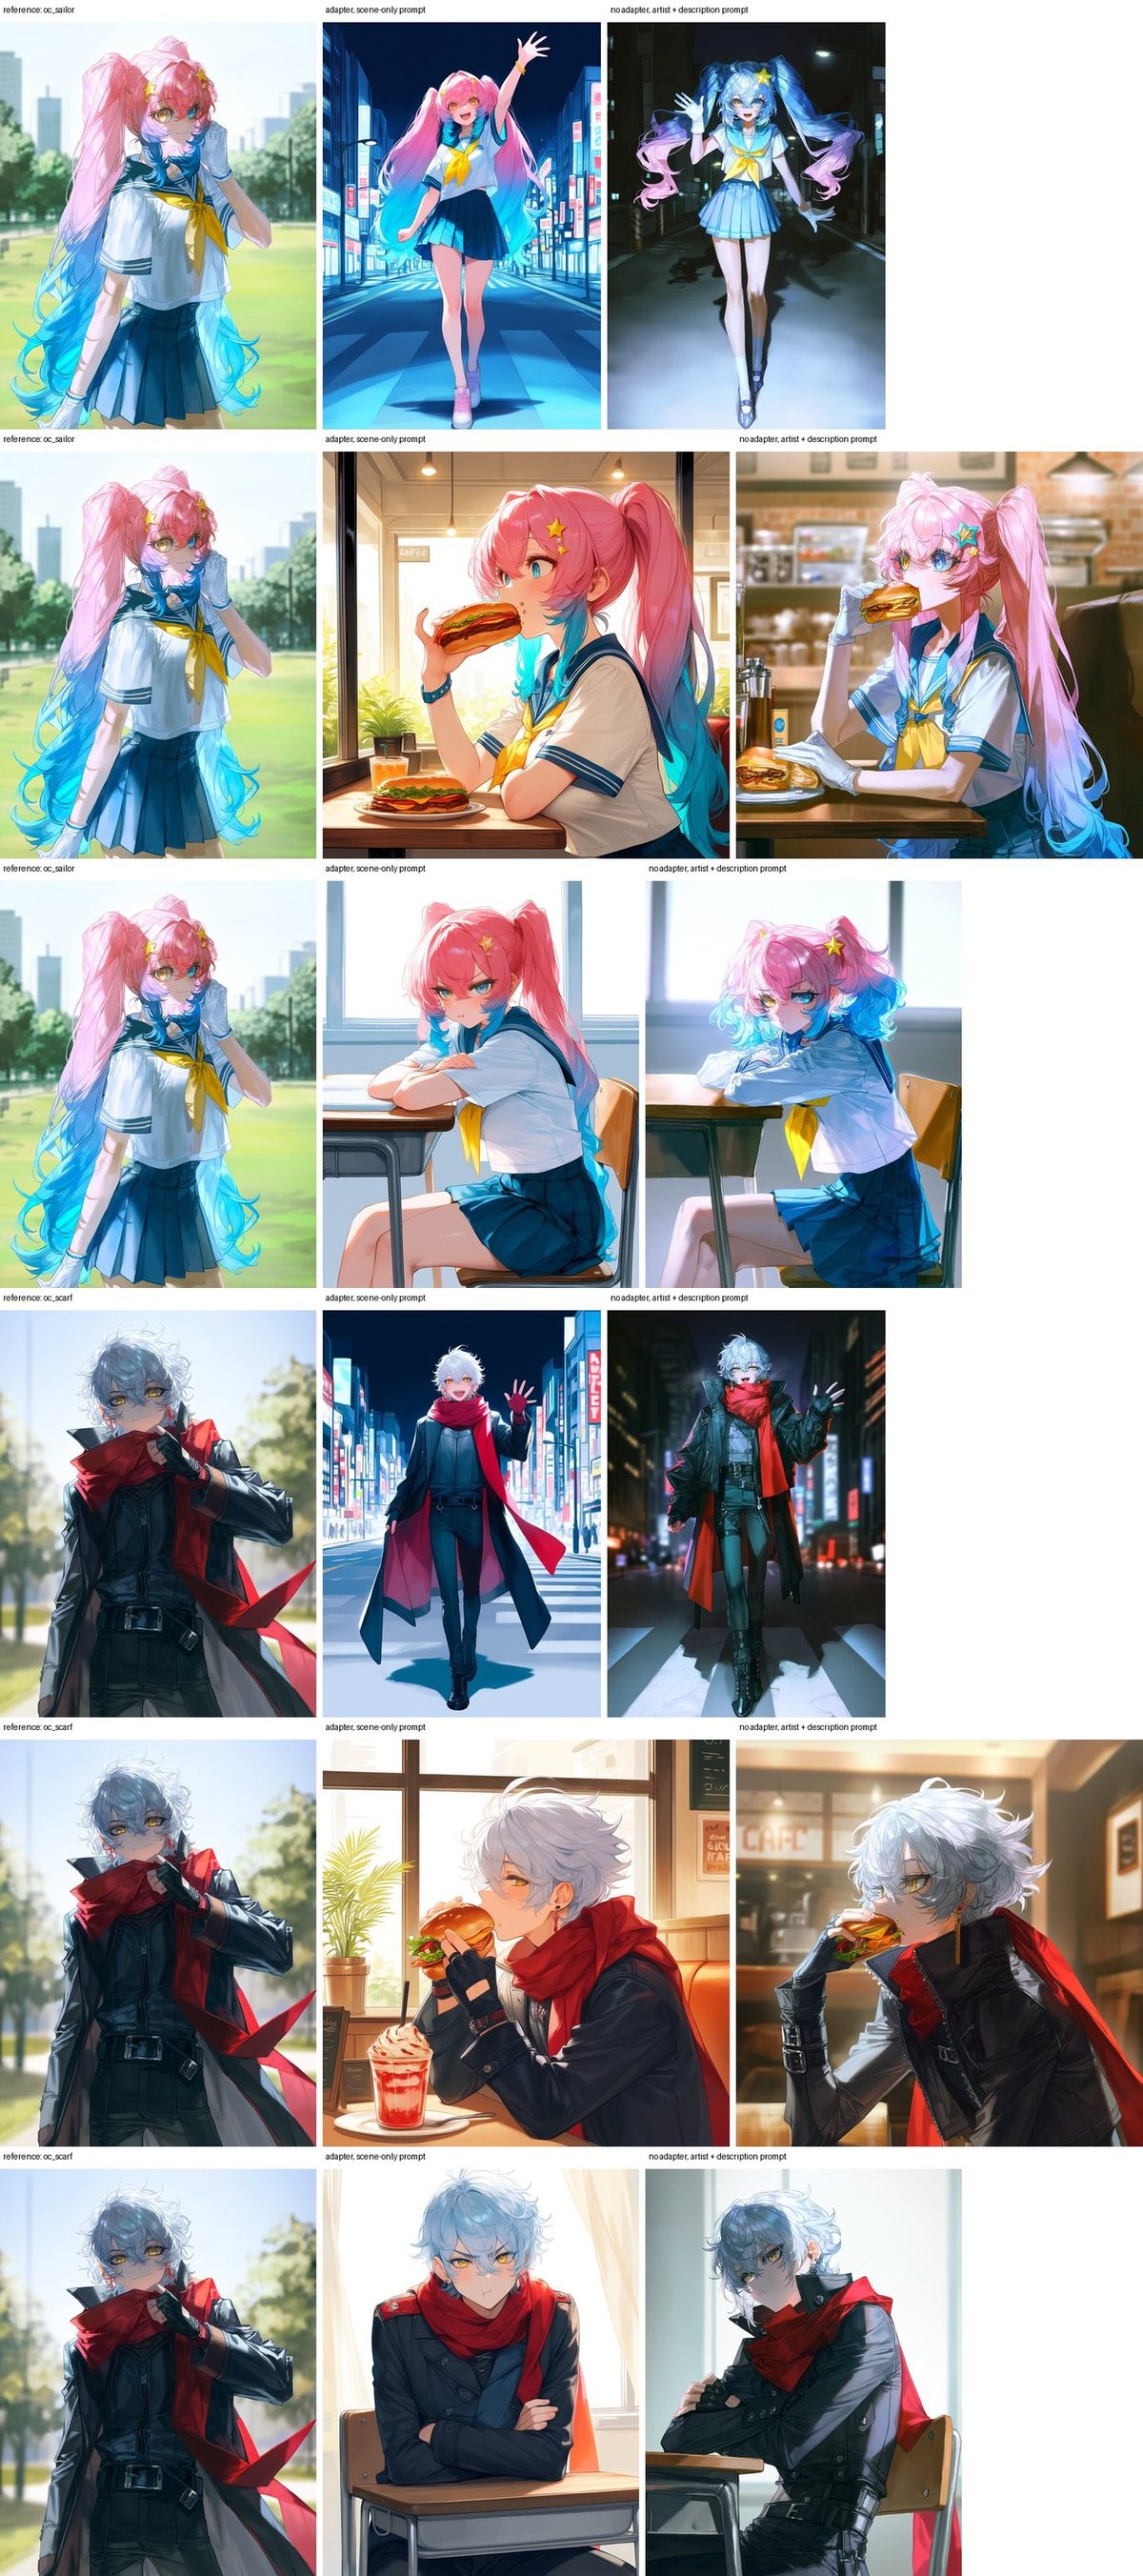
학습에서 한 번도 등장하지 않은 작가 태그로 베이스 모델이 그린 오리지널 캐릭터. 각 행: 참조; 장면만 설명한 프롬프트를 사용한 어댑터; 작가 및 설명 태그를 사용한 베이스 모델.
캐릭터 디자인은 잘 전이됩니다. 그라데이션 트윈테일, 별 모양 머리 장식, 목걸이 스카프, 빨간 스카프와 장갑을 두른 은발 등이 그렇습니다. 작가의 회화적 렌더링, 부드러운 조명, 채도가 낮은 팔레트는 참조 가이드 1에서 전달되지 않으며, 출력물은 더 또렷한 기본 Anima 룩으로 되돌아갑니다.
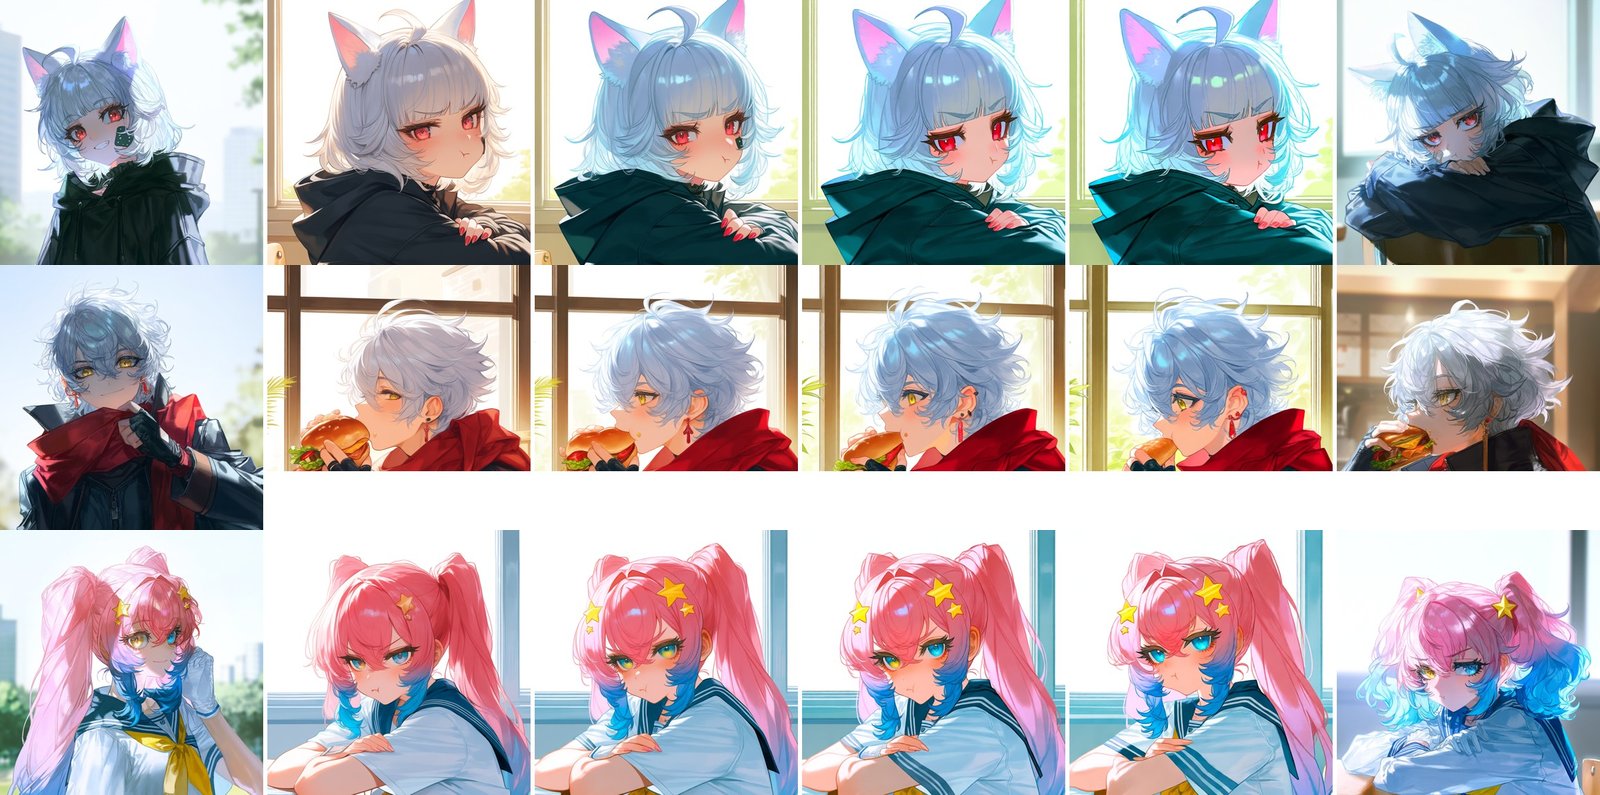
참조 가이드 1, 2.5, 4.5, 6의 크롭을 참조와 나란히, 오른쪽에는 전체 태그를 붙인 베이스 모델.
참조 가이드를 높이면 머리카락 질감과 하이라이트, 눈 렌더링, 차가운 팔레트, 그리고 가이드 1에서는 사라지는 반창고나 홍채 이색증 같은 작은 액세서리가 되살아납니다. 약 4.5를 넘으면 색이 과포화되고 기존의 드리프트가 증폭되는데, APG 또는 rescale 보정이 바로 이를 위한 것입니다. 회화적 렌더링은 여전히 나타나지 않으며, 보고서는 이를 증폭 부족이 아니라 LoRA가 해당 스타일을 거의 학습하지 못한 탓으로 돌립니다. 작성자는 세 가지 작가 스타일로 2,000명의 캐릭터를 담은 더 큰 세트를 생성 중이며, 캐릭터 참조와 스타일 참조를 분리할 계획입니다.
노드
| 노드 | 기능 |
|---|---|
| Anima Ref Adapter Loader | 어댑터 LoRA를 Anima MODEL에 연결합니다. ref_offset_h는 학습 값인 1.0으로 유지됩니다. |
| Anima Ref Latent | 참조를 흰색 패딩과 함께 출력 크기에 맞추고 인코딩하며, 해당 해상도의 빈 잠재 데이터도 함께 반환합니다. |
| Anima Ref Guider | 텍스트 cfg, ref_guidance, APG 또는 rescale 보정, PAG 같은 CFG 이후 패치를 지원하는 SamplerCustomAdvanced용 GUIDER입니다. |
나머지는 ComfyUI 코어가 제공합니다. anima_baseV10.safetensors용 UNETLoader, Qwen3-0.6B 인코더용 CLIPLoader, Qwen-Image VAE용 VAELoader입니다. 기본 그래프는 하나의 고급 사용자 정의 샘플러에서 19개 노드로 실행되며, 두 번째 워크플로는 Anima Safe PAG를 추가합니다. ref_guidance가 1이면 참조가 양쪽 CFG 브랜치에 들어가고 각 스텝 비용은 일반 CFG 스텝과 같습니다. 1을 넘으면 매 스텝마다 모델이 세 번 실행되어 일반 CFG 스텝의 약 1.5배가 됩니다. 예제 워크플로는 ComfyUI-KJNodes의 Patch Sage Attention도 사용하는데, 이는 바이패스할 수 있습니다.
제한 사항
이 파일럿은 300명의 캐릭터로 rank 32에서 2,000 스텝 학습되었으며, 작성자는 그 대가를 나열합니다. 정체성은 스타일보다 훨씬 잘 전이되고, 강하게 회화적인 스타일은 거의 전이되지 않으며, 작은 패턴, 흉터, 귀걸이, 특이한 피부 톤은 자주 소실되고, 큰 의상은 색이 드리프트할 수 있으며, 참조 캐릭터가 때때로 장면 속 오브젝트로 다시 나타납니다. 학습 쌍이 모두 Anima 렌더이므로 어댑터는 베이스 모델의 편향을 물려받으며, 현재까지의 평가는 정성적이며 정체성이나 스타일 유사도 지표는 없습니다.
이용 가능성
어댑터 가중치는 Hugging Face에 anima_ref_adapter_pilot_r32.safetensors(약 92 MB)로 공개되어 있으며 ComfyUI/models/loras/에 넣으면 됩니다. 노드 팩은 ComfyUI/custom_nodes 안에서 git clone https://github.com/ElectronGirl/ComfyUI-Anima-Ref-Adapter.git로 설치하며, Anima 베이스 v1.0과 그 Qwen3-0.6B 텍스트 인코더, Qwen-Image VAE가 필요합니다. 어댑터는 베이스 모델로 학습되었으므로, Anima turbo LoRA를 기존 스텝과 CFG로 어댑터 로더 앞에 여전히 로드할 수 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.