MOSS-Image 색상/깊이 제어, ComfyUI 코어에 추가
커뮤니티 어댑터가 단색 색상 영역 맵과 깊이 맵으로 MOSS-Image를 제어하며 순수 노이즈에서 시작합니다. ComfyUI 코어도 같은 날 지원을 병합했습니다.
MOSS-Image는 OpenMOSS의 5B 텍스트 및 레이아웃 모델로, 같은 주에 코어 ComfyUI 구현과 함께 출시되었습니다. 기존의 구성 제어 수단은 박스의 JSON 레이아웃과 참조 기반 변경을 위한 편집 LoRA입니다. 어느 것도 더 단순한 질문에는 답하지 못합니다. 이 사람을 여기에, 이 크기로, 저 책상 앞에 세우라는 질문 말입니다.
새 어댑터는 그림 대신 두 개의 맵으로 이 질문에 답합니다. 색상은 각 영역이 어디에 위치하는지를, 깊이는 각 표면이 얼마나 멀리 있는지를 인코딩하며, 생성은 여전히 순수 노이즈에서 시작합니다. 참조 이미지에서 복사되어 들어오는 것은 없으므로, 배경은 맵을 추적한 렌더가 아니라 프롬프트에서 나옵니다.
두 개의 맵을 조건화로 사용
카드는 입력을 좁게 정의하는데, 이것이 바로 사용성을 만들어 줍니다:
- 색상 맵: 출력 크기의 RGB 이미지로, 각 객체 또는 영역이 하나의 단색을 받습니다. 색상은 칠하는 색이 아니라 영역 ID이며, 검은색은 미지정을 의미합니다.
- 깊이 맵: 출력 크기의 그레이스케일이며, 가까울수록 흰색입니다.
- 어느 맵이든 생략할 수 있습니다. 어댑터는 색상만 35%, 깊이만 35%, 둘 다 20%, 둘 다 없음 10%의 제어 드롭아웃으로 학습되었으므로, 단일 맵 실행은 학습 분포 안에 머뭅니다.
각 장면은 three.js 마네킹 에디터에서 작성되며, 이 에디터는 셰이딩 렌더, 색상 패스, 깊이 패스를 함께 내보냅니다:
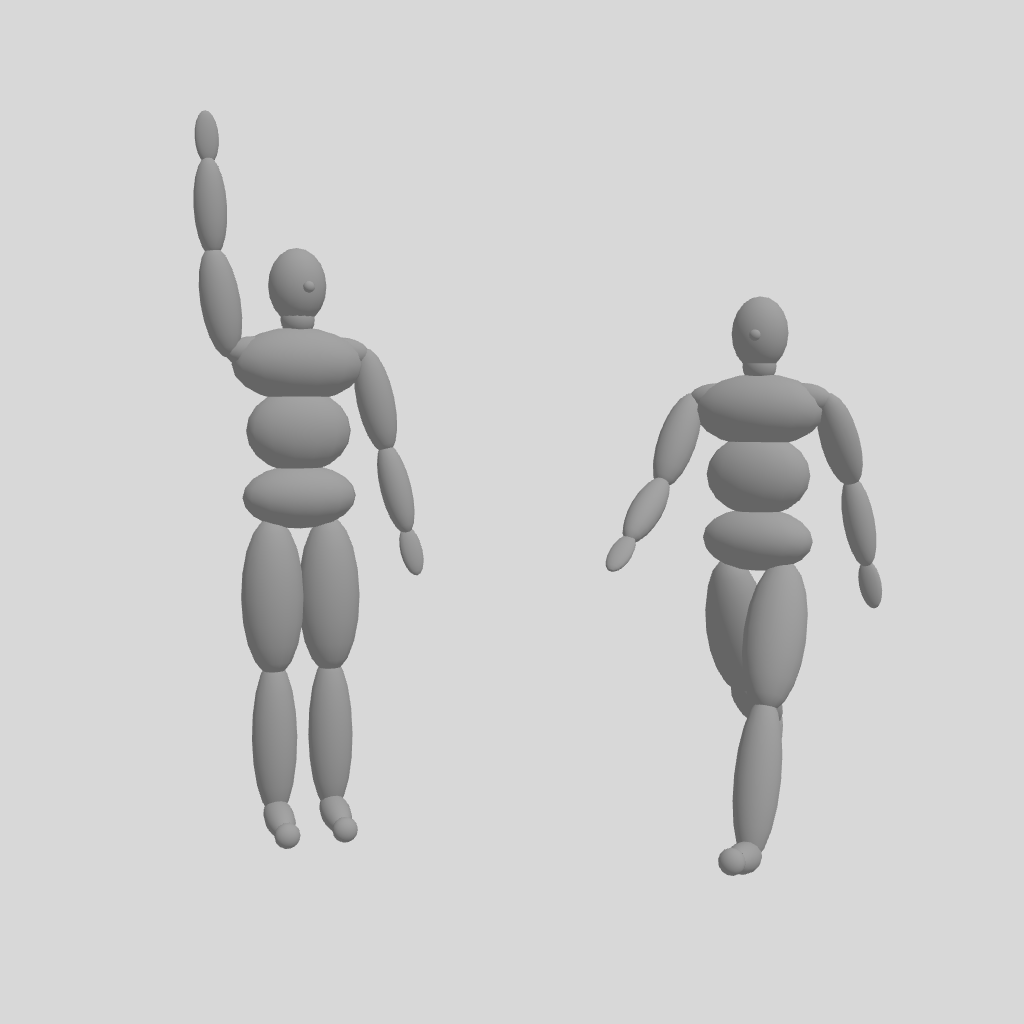 | 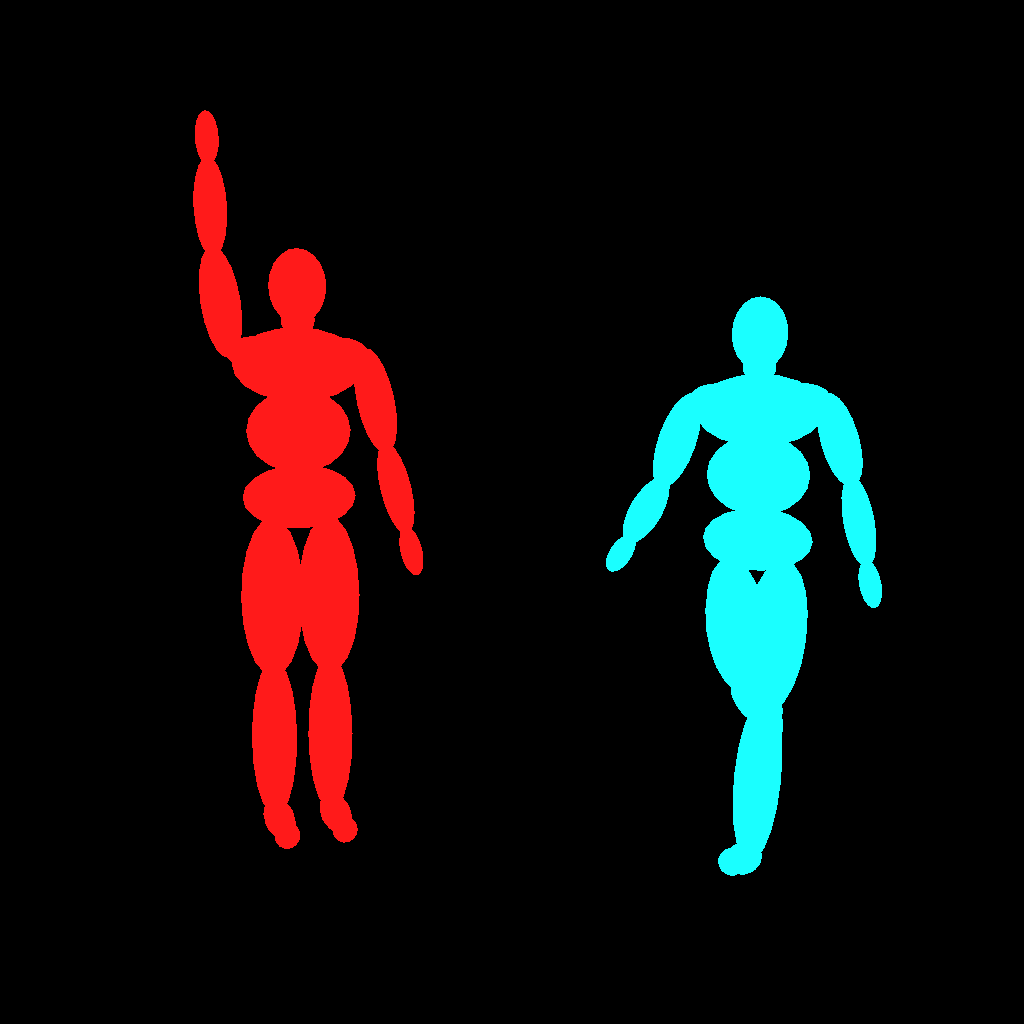 | 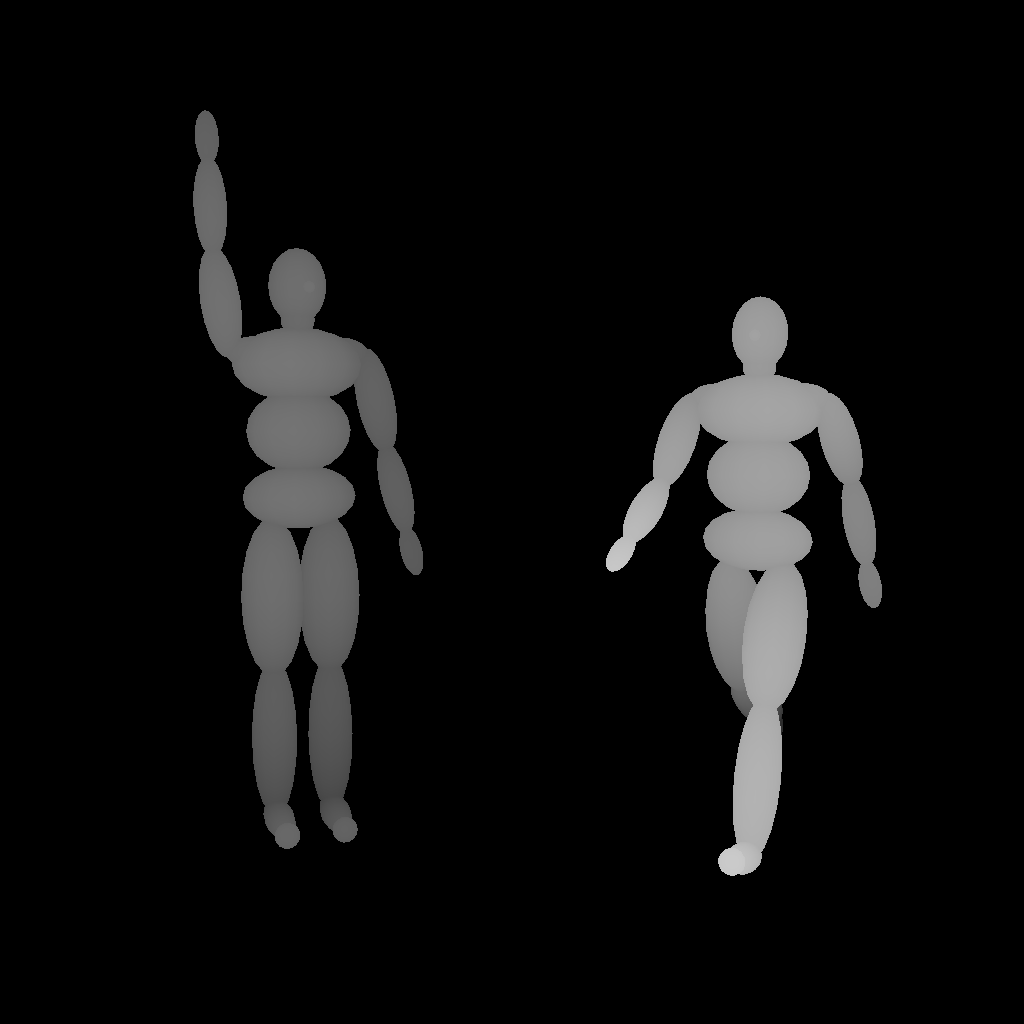 |
|---|---|---|
| 소스 렌더 | 색상 영역 맵 | 깊이 맵, 가까울수록 흰색 |
중요한 비교 대상은 이미지 기반 이미지 생성입니다. 3D 렌더를 img2img 패스에 넣으면 레이아웃은 유지되지만 렌더의 평평한 배경과 회색 표면도 함께 유지됩니다. 어댑터를 사용하면 배치, 크기, 포즈는 맵을 따르고 재질과 조명은 생성됩니다. 그래서 공개된 장면들이 사진이 아니라 3D 마네킹인 것입니다.
출력 결과는 어떤가
카드의 대표 그림은 동일한 두 사람 마네킹 장면의 그리드로, 전체 실행 동안 제어를 유지한 경우와 중간에 제어를 끈 경우를 비교합니다.
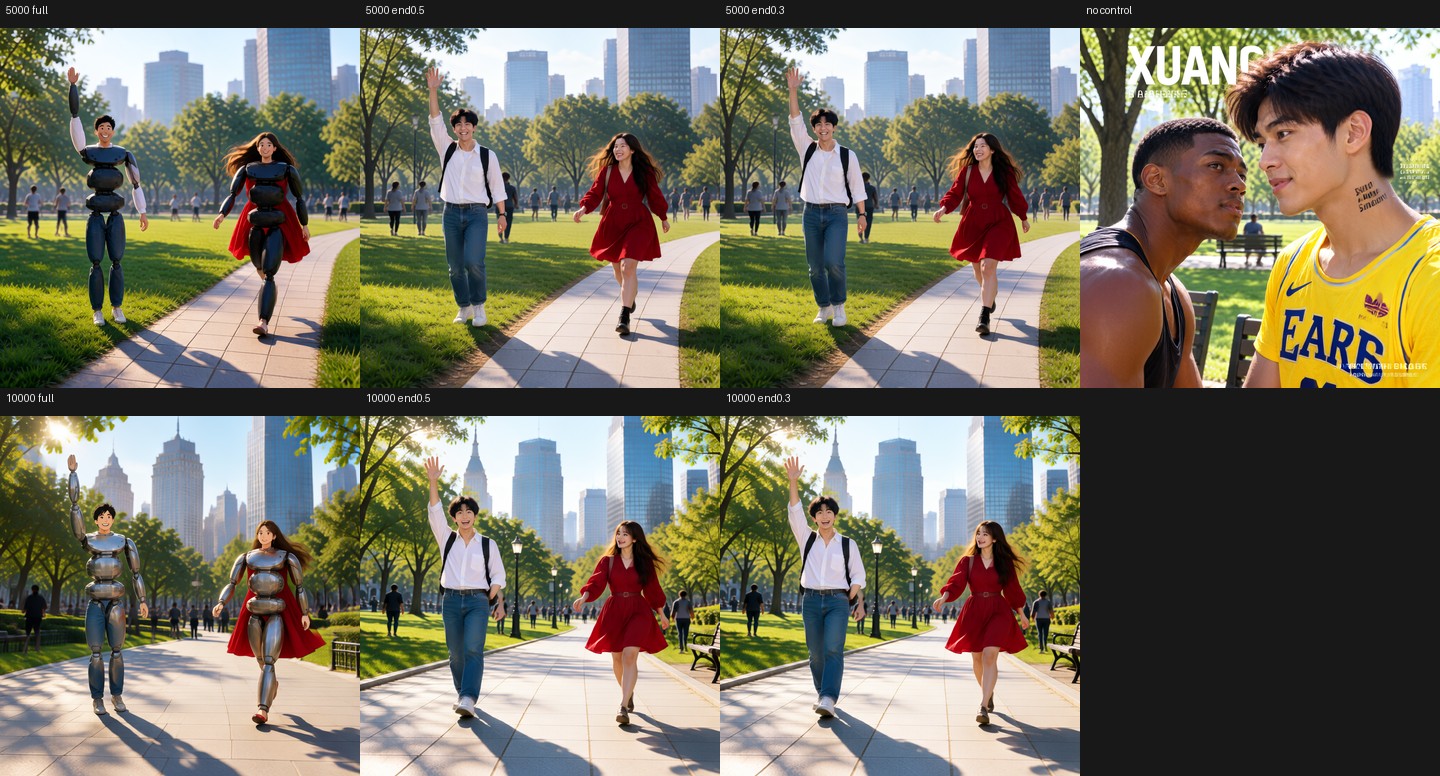
어댑터와 함께 공개됨: 윗줄은 5,000 스텝, 아랫줄은 10,000 스텝이며, 제어를 끝까지 유지한 경우, 0.5에서 종료, 0.3에서 종료, 제어가 없는 베이스 모델을 비교합니다. 끝까지 유지하면 마네킹 표면이 비쳐 보이고, 0.5에서 종료하면 맵이 지정한 곳에 실제 사람이 놓입니다.
이 그리드는 어댑터의 주요 약점을 솔직하게 보여주는 진술이기도 합니다. 전체 실행 동안 제어하면 마네킹이 그대로 재현되는데, 학습 깊이 맵이 실제 사진에서 왔고 맵 어디에도 "나무를 그만두라"고 말하는 정보가 없기 때문입니다. 절반 지점에서 제어를 종료하면 레이아웃은 유지되고 남은 스텝이 피부, 의상, 배경을 해결합니다.
맵만 사용하고 영역별 프롬프트가 없을 때 나타나는 또 다른 실패 모드도 카드가 문서화하고 있습니다. 만화 스타일 색상 맵에서는 패널 레이아웃이 흐트러지고 후반 체크포인트에서 텍스트가 저하됩니다.
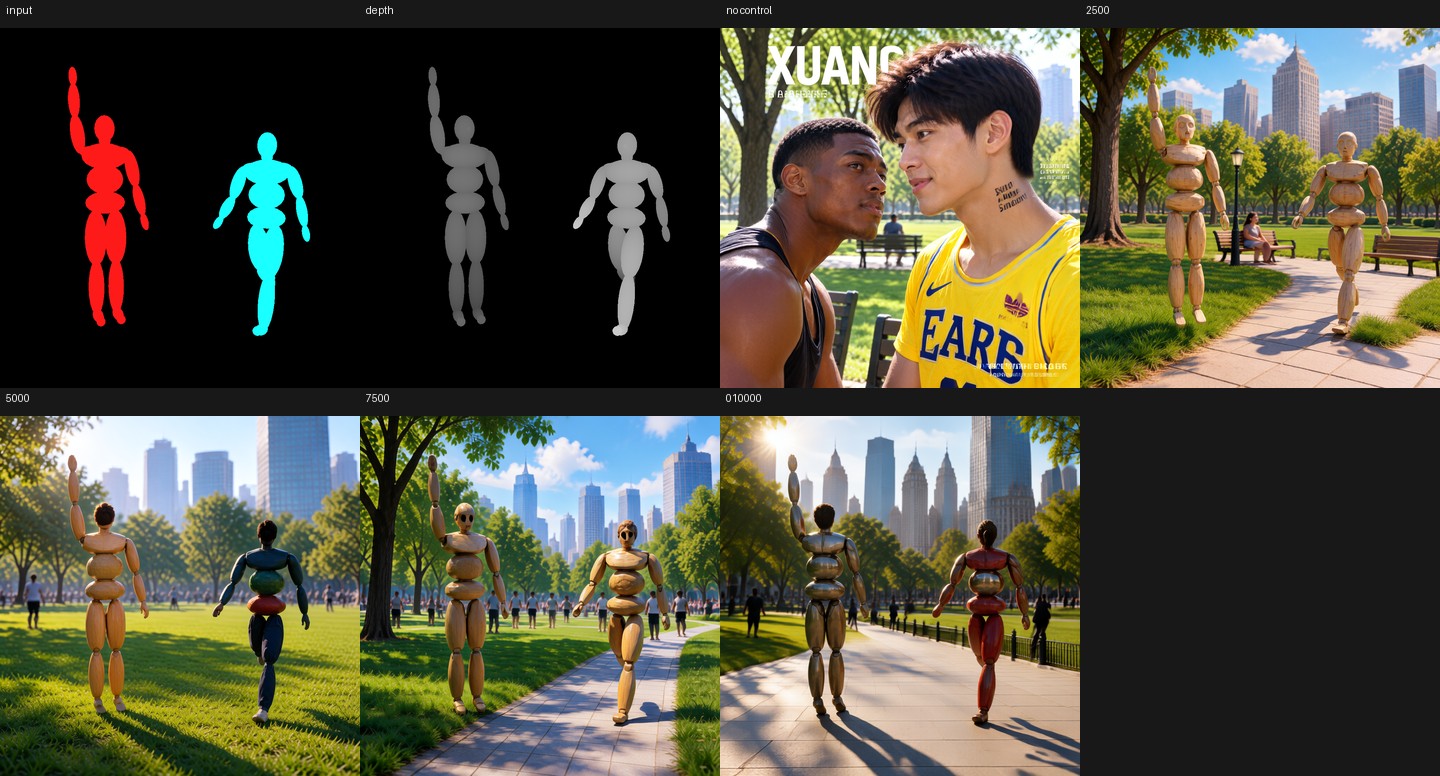
영역별 프롬프트 없이 맵만 사용한 두 사람 장면. 출처: darask0/MOSS-Image-color-depth-control
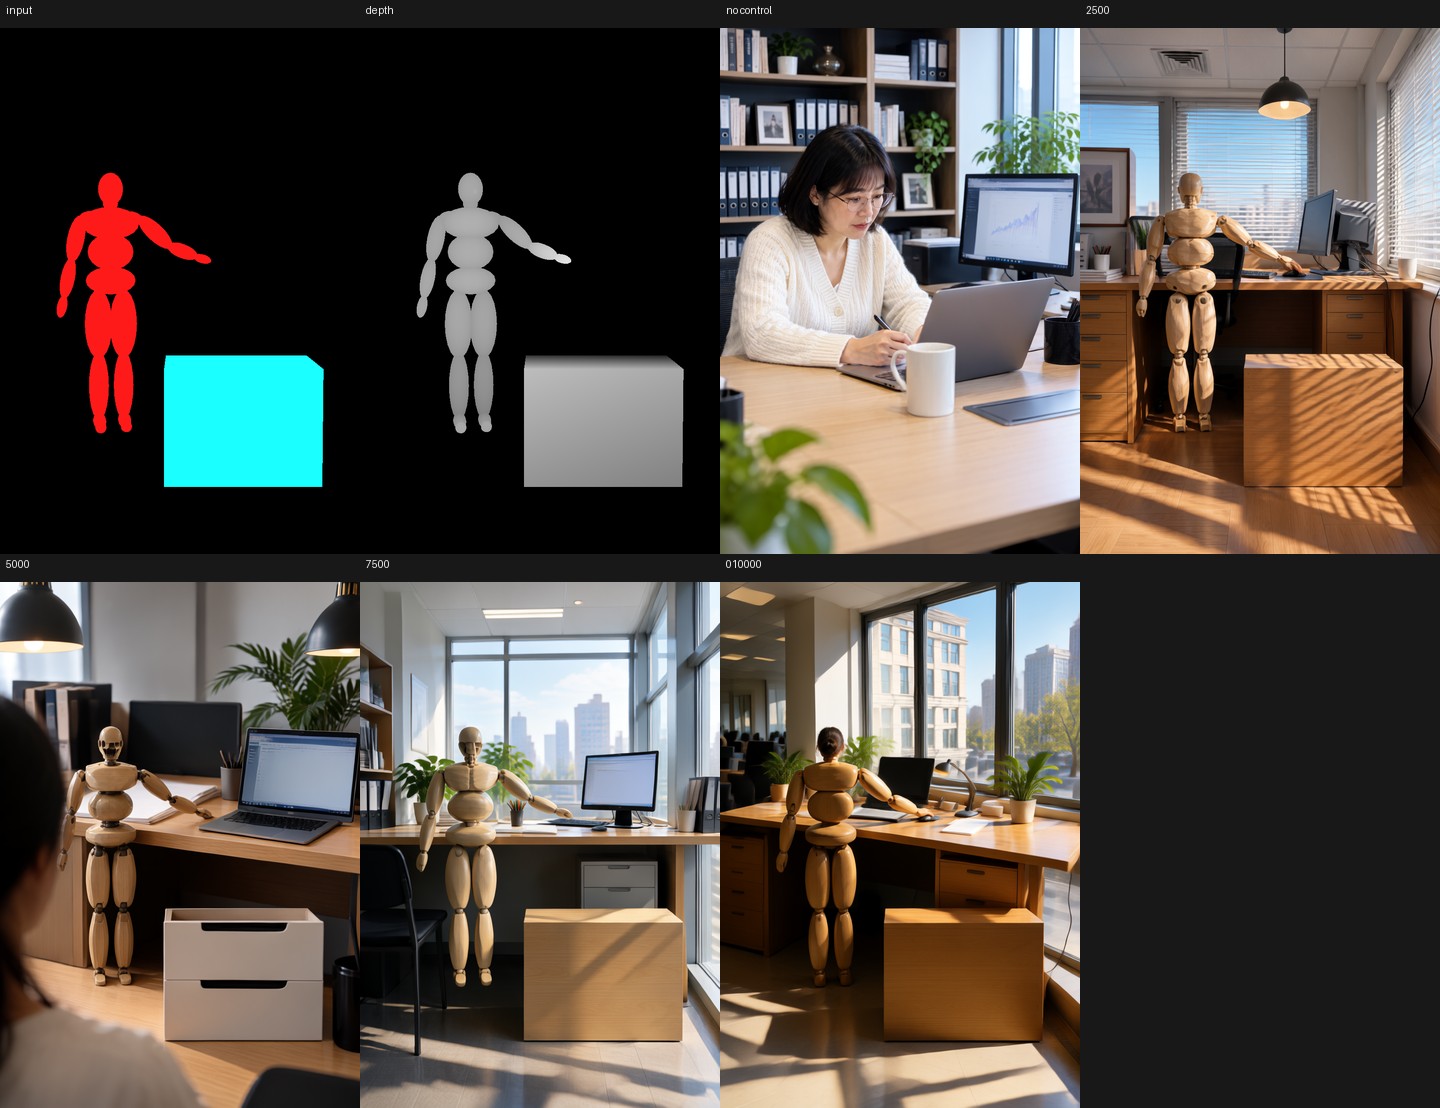
두 번째로 공개된 장면인 책상 앞 사람 역시 맵만 사용했습니다.
코어 ComfyUI 경로
Kijai의 PR #17206은 10월 19일 22:15 UTC에 병합되었으며, 노드 하나를 추가합니다: model/conditioning/moss_image 아래의 실험적 노드 MOSS-Image Color/Depth Control(MOSSImageControl)입니다. 이 노드는 포지티브 및 네거티브 조건화, VAE, 선택적 color_map, 선택적 depth_map, 그리고 strength, start_percent, end_percent를 입력으로 받아 두 조건화 스트림을 모두 반환합니다.
그래프는 일반적인 MOSS-Image 그래프에 두 가지를 더한 것입니다. 어댑터는 디퓨전 모델에 표준 LoRA 로더를 통해 로드되고, 제어 노드는 텍스트 인코드와 샘플러 사이에 위치합니다. start_percent와 end_percent는 카드의 color_end와 depth_end에 해당하는 코어 값이므로, 합성 입력에는 0.5, 실제 이미지에서 추적한 맵에는 1.0이라는 문서화된 값이 그대로 노드 값으로 옮겨집니다.
이 메커니즘은 파일 형식을 설명해 주므로 알아둘 가치가 있습니다. 어댑터는 모델의 video_embedder 입력을 128채널에서 384채널로 확장합니다. 처음 3분의 1에는 노이즈가 있는 FLUX.2 VAE 잠재, 두 번째에는 색상 맵 잠재, 세 번째에는 깊이 맵 잠재가 들어갑니다. PR은 MOSS-Image 모델 클래스에 concat_cond를 추가하여 노드가 전달하는 것을 업샘플링해 노이즈에 이어 붙이고, 맵이 누락되면 0 잠재로 대체합니다. 선형 임베더에서 0 입력은 정확히 "제어 없음"이기 때문입니다. 또한 lora_convert.py에 변환을 추가하여 확장된 video_embedder 키를 추가가 아닌 교체 패치로 바꿉니다. 임베더는 살짝 조정되는 것이 아니라 교체되기 때문입니다.
영역별 프롬프트는 이 PR보다 앞선 별도의 경로로 남아 있습니다: MOSS-Image Layout Prompt는 Create Bounding Boxes로 생성된 경계 상자에서 레이아웃 JSON을 만들고, 각 상자의 캡션이 해당 프롬프트가 됩니다. 어댑터 카드는 제어 맵을 이러한 영역별 프롬프트와 함께 사용할 것을 권장하며, 공개된 예시도 그렇게 샘플링되었습니다.
지원은 v0.42.1 태그 이후에 병합되었으므로, 릴리스된 설치에는 해당 태그보다 새로운 빌드가 필요합니다.
카드의 설정
| 설정 | 값 | 이유 |
|---|---|---|
| 어댑터 체크포인트 | moss-control.safetensors | 10,000 스텝, 권장 버전 |
strength | 1.0 | 학습된 강도이며, 0.0은 맵 없음과 동일 |
end_percent (3D 마네킹 맵) | 0.5 | 제어가 레이아웃과 포즈를 이끈 뒤 해제 |
end_percent (실제 사진에서 만든 맵) | 1.0 | 실행 내내 제어 유지 |
| 영역 프롬프트 | 색상당 하나 | 없으면 마네킹 모양 맵이 마네킹으로 그려짐 |
이전 체크포인트는 종료 비율의 대안입니다: 2,500 스텝은 맵을 덜 엄격하게 따르고 마네킹처럼 덜 보이며, 7,500과 10,000은 더 잘 따릅니다. 네 가지 모두 저장소에 있습니다.
속도를 위해서는 사이트가 10월 17일에 다룬 동일 작성자의 4스텝 rapid-moss 어댑터(darask0/MOSS-Image_4-step_adapter_lora)가 문서화된 조합입니다. 카드에 따르면 이를 사용하면 RTX PRO 6000에서 1024² 이미지당 약 1.8초가 걸립니다.
학습 방식
safetensors 헤더를 살펴보면 526개의 텐서가 있습니다: 42개 DiT 레이어 모두의 q, k, v, o, ffn_up_gate, ffn_down에 대한 rank 64, alpha 64 LoRA 쌍(252쌍), 두 개의 텍스트 임베더 블록에서 블록당 5개 프로젝션(10쌍), 그리고 교체된 video_embedder 가중치와 바이어스입니다.
학습은 FP8로 동결된 MOSS-Image Base 트랜스포머에서 진행되었으며, 임베더는 384개 입력으로 확장되고 제어 열은 0으로 초기화되었습니다. 데이터는 5가지 종횡비에 걸친 1024급 해상도의 Krea 2 Turbo 이미지 10,000장과 그 캡션입니다. 색상 맵은 COCO panoptic segmentation에 적용한 Mask2Former Swin-L에서, 깊이 맵은 Depth Anything V2 Large에서 얻었습니다. 최적화는 AdamW에 학습률 1e-4(임베더 제어 열은 10배 학습률), 배치 1, RTX PRO 6000 한 장에서 스텝당 0.8초로 10,000 스텝, MOSS의 logit-normal 타임스텝 분포, 10% 빈 캡션입니다. 설정과 학습 스크립트는 가중치와 함께 제공됩니다.
알아둘 만한 한계
카드는 작동하지 않는 것에 대해 이례적으로 솔직합니다:
- 마네킹 같은 겉모습. 3D 렌더에 전체 실행 제어를 적용하면 렌더의 나무 또는 금속 표면이 재현됩니다. 학습 깊이가 사진에서 왔기 때문입니다.
- 포즈 정밀도는 맵보다 거칩니다. 손가락과 얼굴은 투영되는 것이 아니라 생성됩니다.
- 레이아웃에는 제어만으로 충분하지 않습니다. 만화 색상 맵에서는 7,500 스텝부터 패널 구조를 잃고 텍스트가 깨집니다.
- 작성자의 Hayate 런타임에서는 조합이 제한됩니다. 모델 카드에 따르면 Hayate에서는 img2img나 인페인팅과 함께 쓸 수 없고 둘 중 하나만 가능합니다.
- 스타일 사전은 사진적입니다. 학습 데이터가 Krea 2 Turbo 출력이었습니다.
- 벤치마크 없음. 카드에 따르면 소수의 장면과 두 개의 시드로만 평가되었습니다.
이 어댑터는 공식 OpenMOSS 릴리스도 아닙니다: 가중치, 학습 코드, 참조 런타임은 한 작성자에게서 나왔고, 코어 지원은 ComfyUI 메인테이너가 검토한 부분입니다.
이용 가능성
- 어댑터: darask0/MOSS-Image-color-depth-control, 체크포인트 4개, 업로드 일주일 후 약 30개의 좋아요.
- ComfyUI 코어: PR #17206, 2026년 10월 19일 병합, v0.42.1 릴리스 이후.
- 속도 조합: darask0/MOSS-Image_4-step_adapter_lora.
- 베이스 모델: MOSS-Image-Base와 MOSS-Image-SFT, 단일 파일 ComfyUI 가중치는 Comfy-Org/MOSS-Image에 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.