MOSS-Image Edit HQ v5, 두 가지 ComfyUI LoRA 형식으로 공개
커뮤니티 MOSS-Image 편집 LoRA가 v5에 도달했습니다. 마스크 손실, 256 토큰 참조 예산, 두 가지 ComfyUI 형식을 갖추고 평가 그리드와 데모 Space, 전체 레시피를 제공합니다.
MOSS-Image는 OpenMOSS의 5B 텍스트 및 레이아웃 모델로, 출시 당시 다뤘으며, 2주 뒤 rank-64 커뮤니티 어댑터를 통해 명령 기반 편집 기능을 얻었습니다. 그 어댑터가 chinoll/Moss-Image-Edit였고, 남은 의문은 편집 동작 중 얼마나 많은 부분이 그 단일 학습 세트에서 비롯되었느냐는 것이었습니다. MOSS-Image-Edit-HQ는 다른 데이터로 그 기능을 다시 구축하고 원본과 비교 측정함으로써 이 질문에 답합니다.
v5에서 실제로 달라진 점
저장소는 하나의 릴리스가 아니라 다섯 개 학습 갈래의 기록입니다. 각 갈래는 이전 체크아웃에서 이어서 학습되었고, 각각의 샘플과 함께 디스크에 보관되어 있어 차이를 주장이 아닌 실제로 검증할 수 있습니다.
| 갈래 | 데이터 및 변경 사항 | 결과 |
|---|---|---|
| v1 | 웜 스타트 + 처음부터 학습, 다중 참조 데이터, 1024px | 평가 게이트 통과 실패, chinoll이 정체성 유지에서 더 우수 |
| v2 | OmniEdit 정밀 행, lr 1e-5, 300 스텝 | v3로 대체됨 |
| v3 | ConceptEdit-12M 정밀 행을 6,000개로 필터링, 700 스텝 | v4로 대체됨 |
| v4 | 제거, 얼굴 및 환경 데이터, 4,644행, inverted_mask_prior를 사용한 마스크 손실 | v5로 대체됨 |
| v5 | 전체 장면 캡션, 픽셀 차이 마스크, 마스크 손실, 256 토큰 참조 예산, 1,200 스텝의 5,644행 | 현재 체크포인트 |
v5에서 가장 중요한 변화는 참조 예산입니다. 베이스 MOSS-Image는 참조 이미지에 144 토큰을 할당하지만, 이 갈래는 이를 256으로 높였고, 정체성과 세부 디테일의 향상이 바로 여기서 나온다고 주장합니다. v5의 나머지는 데이터 작업입니다. 편집되지 않은 영역이 소스에 가깝게 유지되도록 픽셀 차이 마스크를 사용하고, ConceptEdit 메타데이터에서 전체 장면 캡션을 구성해 명령이 편집 부분만이 아니라 프레임 전체를 설명하도록 했습니다.
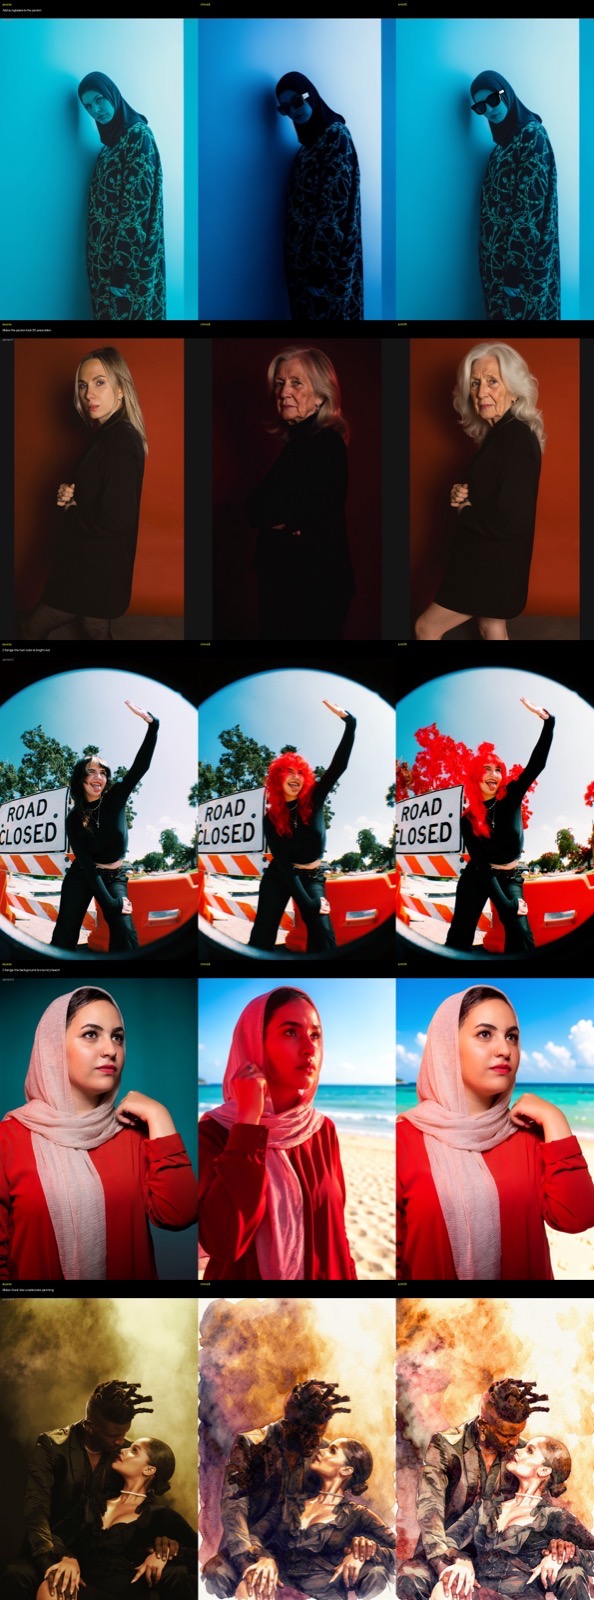
각 행은 소스 이미지에서 시작해 v5 출력으로 이어집니다. 출처: akhaliq/MOSS-Image-Edit-HQ
체크포인트는 peft 형식으로 각각 495 MB이며, 최종본과 스텝 250, 500, 750, 1000입니다. 학습은 커밋 14f8f95의 ai-toolkit에서 갈래당 단일 GPU로 진행되었고, 텍스트 인코더는 고정되었으며 1024px에서는 그래디언트 체크포인팅이 필수였습니다. 학습 데이터도 공개되었습니다. 필터링된 ConceptEdit-12M 6,000행이 TAR 샤드로 제공되며, 갈래별 설정은 저장소에 있습니다.
두 가지 ComfyUI 경로, 두 가지 LoRA 레이아웃
이 릴리스를 읽어볼 필요가 있는 이유는 동일한 가중치가 서로 다른 ComfyUI 메커니즘으로 로드되는 두 가지 레이아웃으로 제공되기 때문입니다.
네이티브 경로는 weights/armV5/armV5.safetensors를 일반 LoRA로 사용합니다. models/loras/에 넣고 확산 모델 로드 뒤에 LoRA 로더를 추가한 다음, 실험적 MOSS-Image 편집 텍스트 인코딩 노드에서 edit_format을 ai-toolkit으로 설정해 인코딩합니다. 참조 이미지는 텍스트 인코더가 보기 전에 최대 384x384로 축소됩니다.
플러그인 경로는 armV5-moss-edit-lora.safetensors를 사용하며, 이 파일은 대신 models/model_patches/에 넣고 Chenkin-x/ComfyUI-Moss-Image-Edit를 통해 로드합니다. 이전 어댑터가 사용하는 것과 같은 노드 팩입니다. 해당 팩은 ComfyUI 0.42.3 이상을 요구합니다.
네이티브 경로는 현재 master 빌드에서만 사용할 수 있습니다. Kijai의 PR #17296이 10월 22일 병합되어 편집 노드를 추가했지만, 10월 23일의 최신 태그 릴리스인 v0.42.5에는 여전히 해당 노드가 없는 이전 comfy_extras/nodes_moss_image.py가 포함되어 있어, 릴리스 설치본에서 edit_format = ai-toolkit을 사용하려면 최신 테스트 버전(nightly)으로 업데이트해야 합니다. 두 워크플로 모두 파일 이름과 설정이 채워진 상태로 제공되며, 참조 1개용과 최대 4개용이 있습니다.
| 설정 | 값 |
|---|---|
| 샘플러 | Euler, 플로우 매칭 |
| Shift | 5.0 |
| 스텝 | 50 (품질), DMD 속도 스택 사용 시 8 |
| CFG | 3.0, 편집이 약하면 3.5 또는 4.0으로 높임 |
| SLG 레이어 | 22 |
| 참조 크기 | 소스 해상도로 인코더에 입력, 최대 384x384 |
| 출력 | 최대 1024px |
ai-toolkit 레이아웃은 이전 어댑터가 사용하는 Moss-Image-Edit 레이아웃과 다르며, 모델 카드에서 이를 명확히 밝힙니다. chinoll의 어댑터는 q, k, v 키를 분리해 사용하지만 ai-toolkit은 이를 융합하므로, 한쪽에서 다른 쪽으로 웜 스타트하려면 정확한 rank-192 블록 대각 융합이 필요합니다. 저장소에는 변환기가 포함되어 있고, 변환 후 336개 중 336개 텐서가 일치한다고 보고합니다.
더 빠른 지점과 그렇지 않은 지점
편집 LoRA를 8스텝 DMD 속도 LoRA와 함께 쌓으면 샘플링이 8스텝, CFG 1로 줄어 약 6배 빠른 편집이 가능합니다. 모델 카드 자체의 판단은 50스텝 경로가 여전히 우수하다는 것입니다. 8스텝에서는 오브젝트 추가가 약해지고 색상 억제가 저하되므로, 빠른 경로는 초안용입니다.
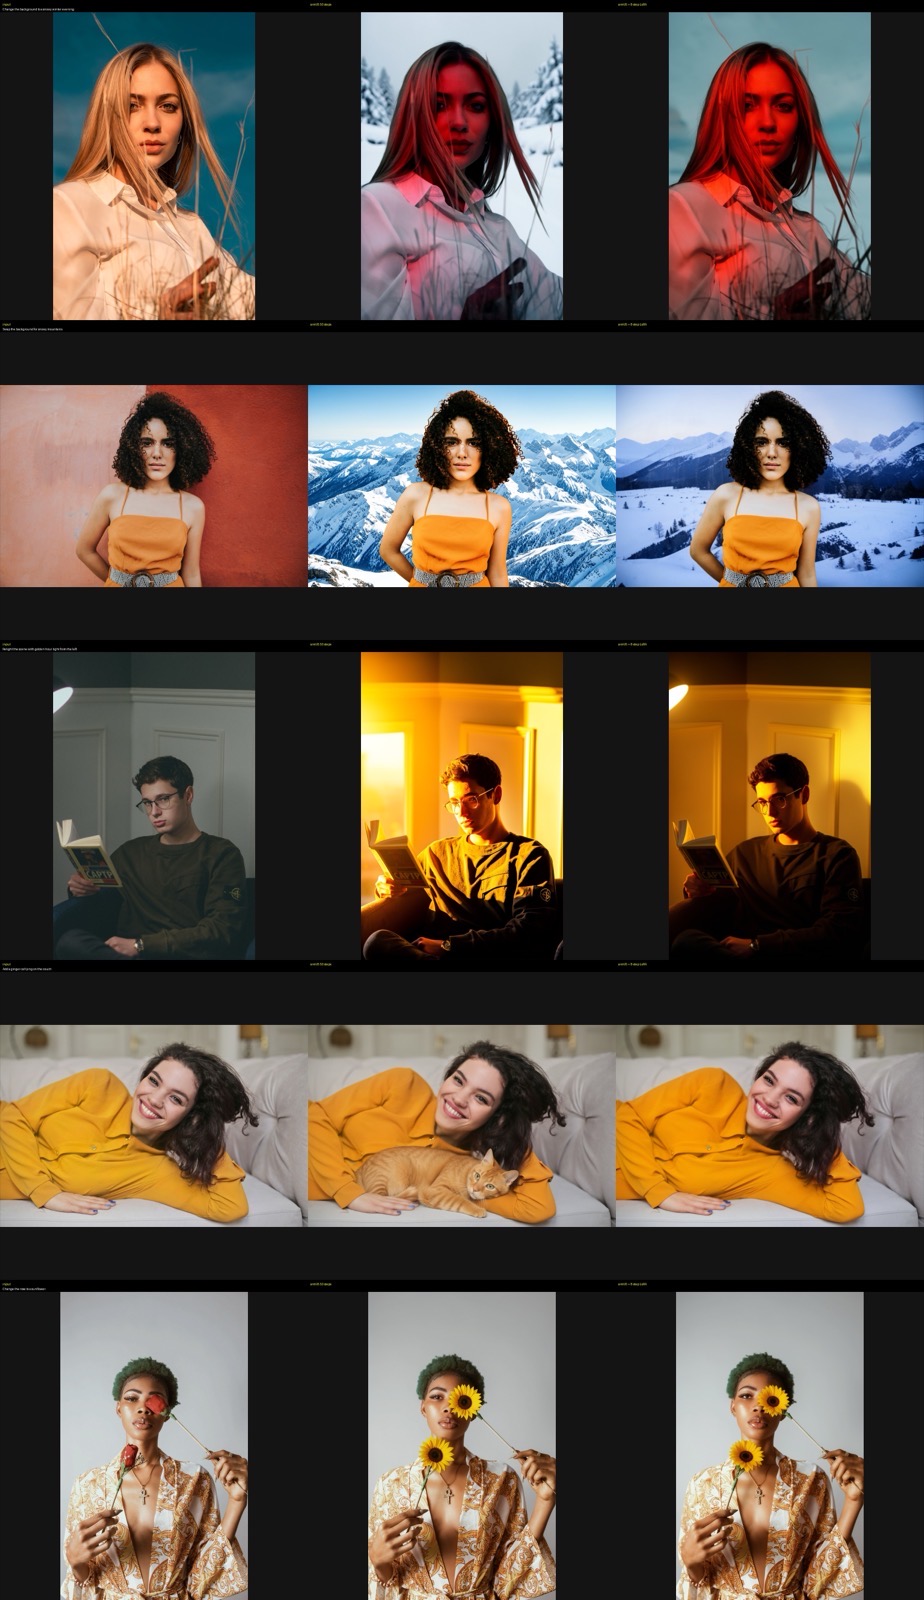
입력, 그다음 50스텝, 그다음 8스텝 DMD 스택. 출처: akhaliq/MOSS-Image-Edit-HQ
v5 쇼케이스. 편집마다 명령 하나씩이며, 데모의 설정인 50스텝과 CFG 3으로 렌더링했습니다.
같은 솔직함이 비교에도 적용됩니다. 이 프로젝트가 내세운 목표는 품질에서 chinoll/Moss-Image-Edit를 앞서는 것이며, v1 갈래는 이후 갈래들이 마스크 손실로 전환하기 전에 정체성 유지 측면에서 이 게이트를 통과하지 못했음을 공개적으로 인정합니다. 공개된 그리드는 v5를 이전 어댑터 및 Krea 2와 비교하지만, 이는 작성자 자신의 평가 세트와 데모 Space일 뿐 제3자 벤치마크가 아닙니다.
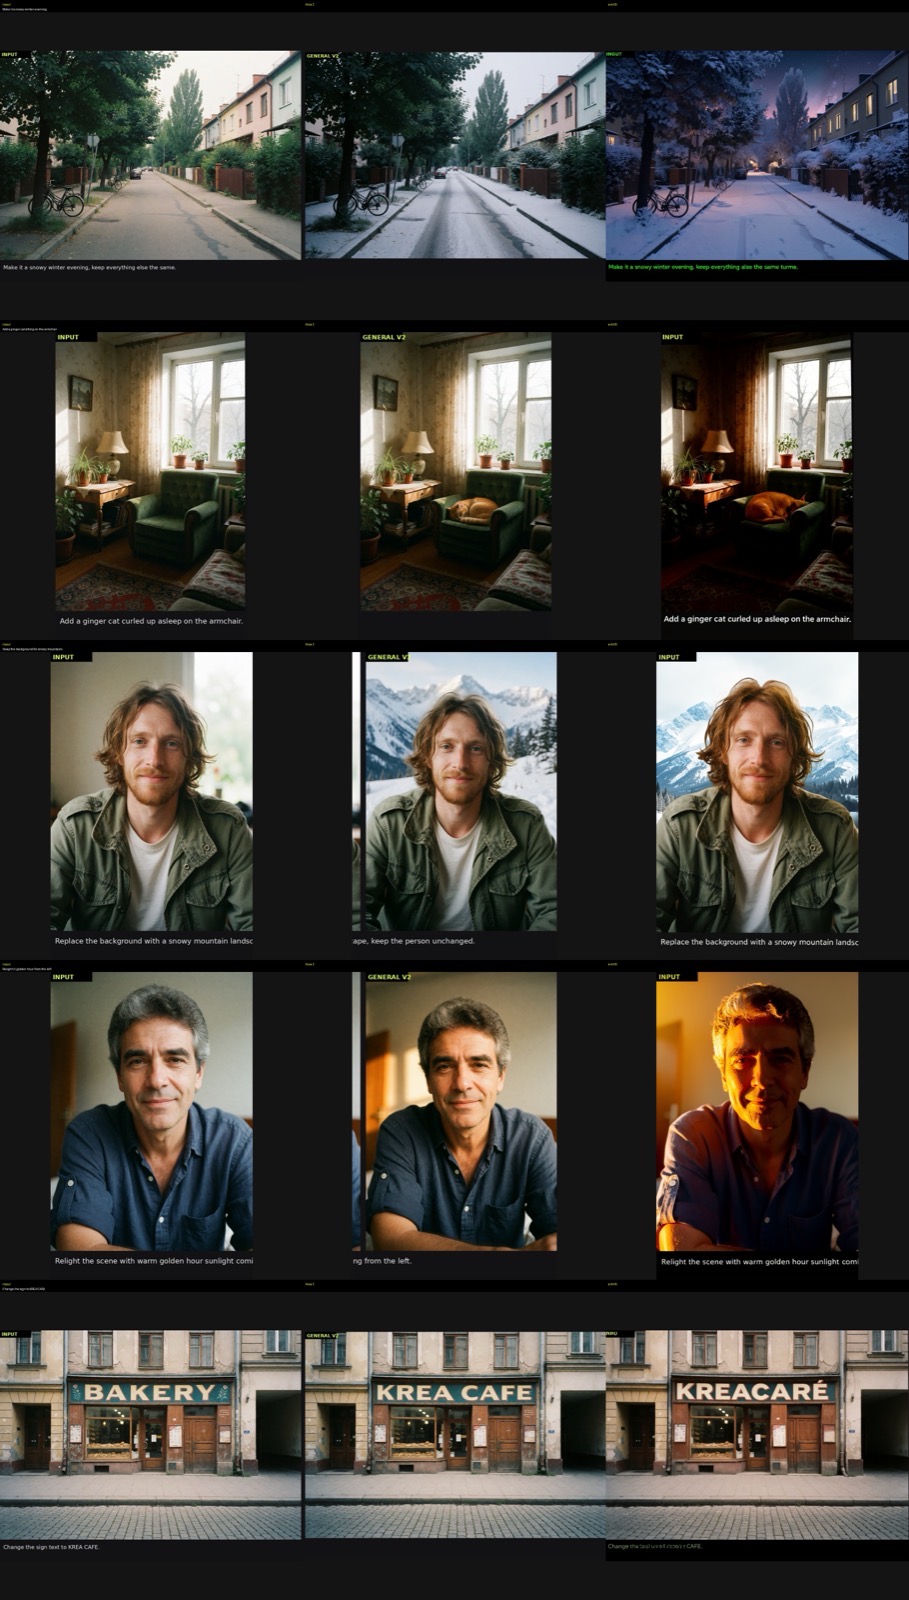
Krea 2 쇼케이스 프롬프트에 대한 v5 편집 결과와 Krea 2 참조 렌더링. 출처: akhaliq/MOSS-Image-Edit-HQ
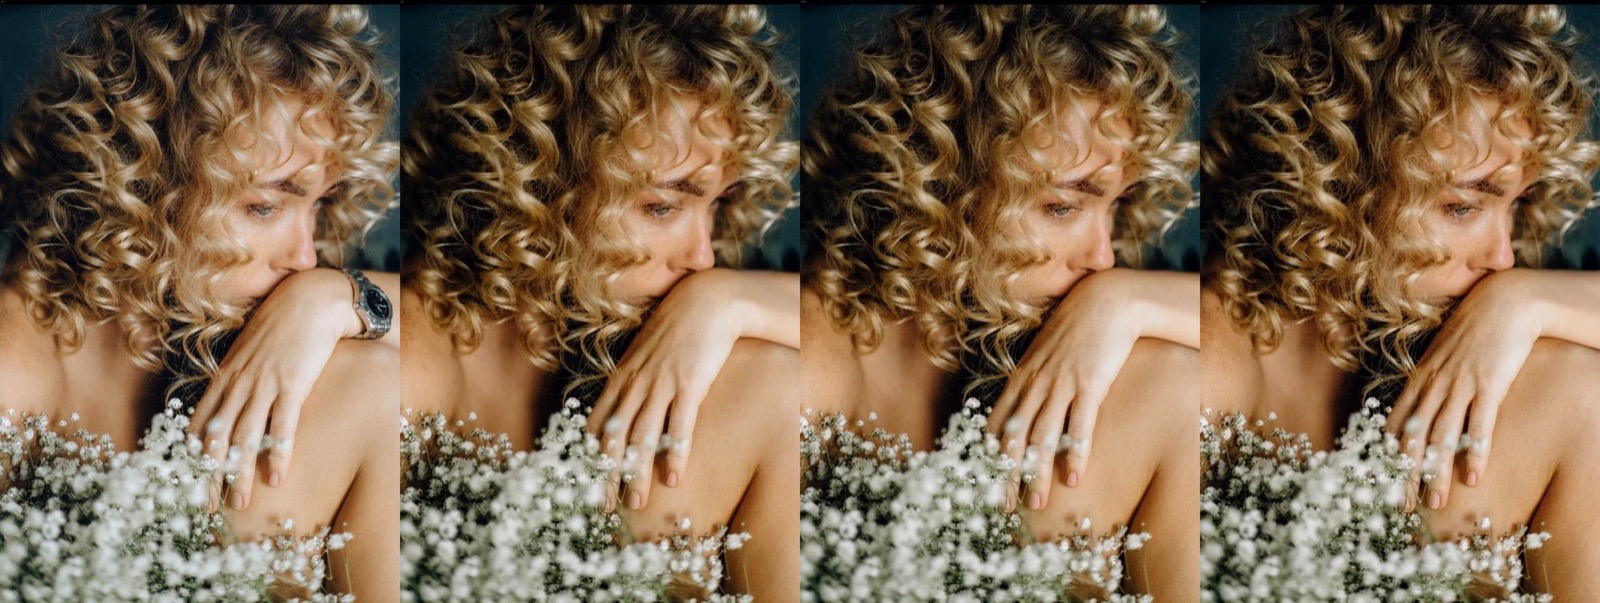
저장소의 오브젝트 제거 사례. 출처: akhaliq/MOSS-Image-Edit-HQ
사용 편의성을 위해 모델 카드에는 품질 모드와 8스텝 모드를 모두 실행하는 Gradio 데모 Space 링크도 있습니다. 495 MB를 다운로드하기 전에 이 트레이드오프를 확인할 수 있습니다.
알아두어야 할 한계
- VRAM: 파이프라인은 bf16에서 약 20 GB가 필요합니다. 모델 카드는 당연한 질문에 직접 답합니다. 아닙니다, 베이스 모델의 커뮤니티 int8 빌드를 사용해도 6 GB에서는 실행되지 않습니다.
- 베이스 모델: MOSS-Image-SFT로 학습되었습니다. 베이스 및 Kromoss 호환성은 미검증으로 표시되어 있으며, 네이티브 경로가 신뢰할 수 있는 경로로 설명됩니다.
- 단일 참조 학습: 아키텍처는 최대 4개의 참조를 허용하지만, 어댑터는 단일 참조 편집 쌍으로 학습되었습니다. 한 사진의 인물이나 오브젝트를 다른 사진에 합성하는 것은 명시적으로 학습 대상이 아닙니다.
- 색상: 소스보다 채도를 과도하게 높이는 v3의 알려진 특성이 사용자에 의해 모델 카드에 보고되었고, v4의 마스크 손실이 이를 겨냥했습니다.
- 범위: 속성, 제거, 조명, 얼굴 및 텍스트 편집입니다. 이 릴리스는 포즈 변경에 대해 아무것도 언급하지 않는데, 발표에 달린 첫 댓글이 요청한 것이 바로 그것입니다.
이 중 어느 것도 OpenMOSS의 릴리스가 아닙니다. 가중치, 데이터, 평가 그리드, 데모는 모두 한 작성자에게서 나왔으며, 모델 카드도 이를 분명히 밝힙니다.
사용 가능
- LoRA: akhaliq/MOSS-Image-Edit-HQ, v5는 2026년 10월 25일 공개.
- 워크플로:
armV5_workflow_single.json및armV5_workflow_multi.json. - 데모: Hugging Face Spaces의 moss-image-edit-hq-demo.
- ComfyUI 코어: PR #17296, 2026년 10월 22일 병합, master 및 nightly 전용.
- 노드 팩: Chenkin-x/ComfyUI-Moss-Image-Edit, ComfyUI 0.42.3 이상 필요.
- 학습 데이터 및 코드: moss-image-edit-conceptedit-packed 및 저장소의
training/디렉터리.
댓글
GitHub로 로그인하고 토론에 참여하세요.