MOSS-Image Edit LoRA: ComfyUI에 인스트럭션 기반 이미지 편집 추가
랭크 64 편집 LoRA가 1~4개의 참조 이미지로 MOSS-Image 인스트럭션 기반 편집을 가능하게 하며, 같은 날 ComfyUI 코어에 네이티브 편집 LoRA 지원이 병합되었습니다.
MOSS-Image는 OpenMOSS의 5B 텍스트 및 레이아웃 모델로, 본 사이트에서도 출시 당시 다뤘습니다. 읽을 수 있는 텍스트, JSON 레이아웃 박스, 그리고 같은 주에 배포된 ComfyUI 코어 구현이 특징입니다. 다만 기존 이미지를 가져와 바꾸는 방법은 없었습니다. 편집이라 해봤자 레이아웃 편집이나 컨트롤 어댑터 수준이었고, "이 사람에게 다른 재킷을 입혀줘" 같은 요청은 불가능했습니다.
새 어댑터가 바로 이 빈틈을 채웁니다. OpenMOSS가 아닌 커뮤니티 배포판이지만, ComfyUI 메인테이너들이 코어 지원을 연결한 대상이 바로 이 구현입니다.
LoRA가 바꾸는 것
모델 카드는 적용 범위를 명확히 밝힙니다. 색상, 의상, 조명, 계절, 시각적 스타일을 텍스트 인스트럭션과 최대 4개의 참조 이미지로 제어합니다. 인스트럭션은 무엇을 바꿀지 지시하고, 참조 이미지는 무엇을 유지할지 담고 있습니다.
LoRA와 함께 공개된 사례 모음. 출처: chinoll/Moss-Image-Edit
참조 이미지가 두 개 이상이면 어댑터 자체가 역할을 지정하지 않기 때문에, 각 이미지를 인스트럭션에서 지칭해야 합니다. 노드 팩의 예시 프롬프트는 Dress the person in image 1 in the outfit from image 2.입니다.
구조적으로 보면 이 어댑터는 작고 전형적입니다. safetensors 헤더를 들여다보면 42개 DiT 레이어 전체에 걸쳐 504개의 텐서가 있고, 레이어마다 6개의 프로젝션(q, k, v, o, ffn_up_gate, ffn_down)이 있으며, 랭크 64에 알파 64입니다. adapter_config.json에는 moss-edit-lora 포맷 버전 1이 선언되어 있고, 학습 계약은 ref-prefix-only-t0__target-text-original-moss-v1로 기록되어 있는데, 이것이 바로 ComfyUI가 Moss-Image-Edit라는 이름으로 구현한 레이아웃입니다.
같은 가중치는 MOSS-Image-Base와 MOSS-Image-SFT 어느 쪽과도 동작합니다. Base는 학습 신호를 더 많이 보존하고, SFT는 더 깔끔한 출발점입니다. 참조 카드의 예시는 SFT를 기준으로 학습하고 샘플링했습니다.
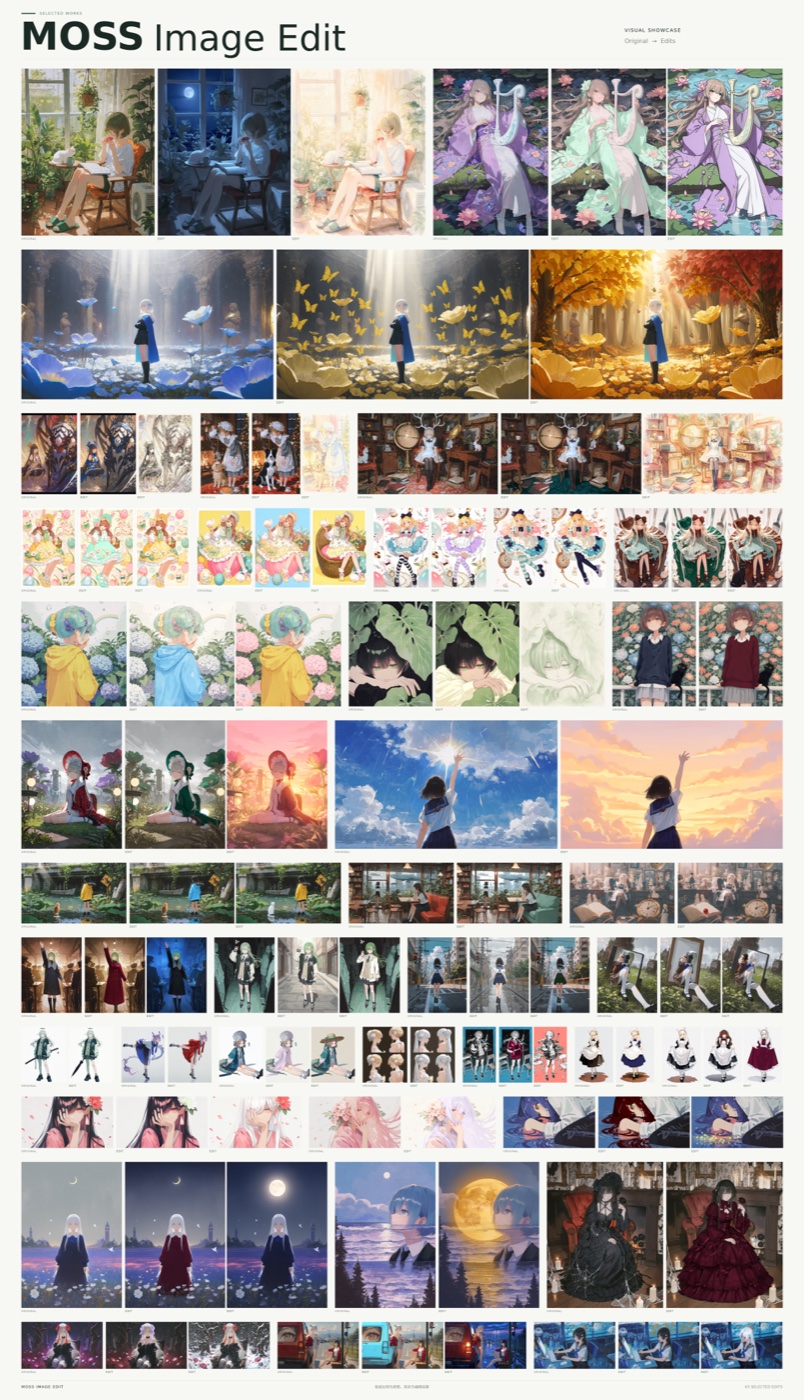
프로젝트 저장소의 편집 쇼케이스. 각 그룹은 원본 이미지로 시작해 그 편집 결과가 이어집니다.
ComfyUI 코어 경로
Kijai의 PR #17296은 model/conditioning/moss_image 아래에 Text Encode MOSS-Image Edit 노드를 추가합니다. 여전히 실험적 표시가 붙어 있습니다. 이 노드는 clip, prompt, vae, edit_format 선택지, 그리고 자동으로 늘어나는 이미지 집합을 입력받습니다. 흥미로운 부분은 edit_format 선택자로, 편집 LoRA끼리 서로 호환되지 않는다는 사실을 그대로 담고 있습니다:
| 옵션 | 참조 레이아웃 | 텍스트 인코더의 참조 노출 |
|---|---|---|
ai-toolkit | index_timestep_zero_isolated | 예, Picture N: 접두사로 |
ai-toolkit (kv_cache off) | index_timestep_zero | 예, 그리고 참조가 매 스텝 생성 이미지에 어텐션 |
Moss-Image-Edit | index_timestep_zero_text_start | 아니오 |
Moss-Image-Edit 레이아웃에서는 비전 타워가 참조 이미지를 전혀 받지 않습니다. 따라서 인스트럭션이 편집 내용을 스스로 설명해야 하며, 모양은 전적으로 DiT에 주입되는 참조 잠재 데이터에서 나옵니다. ai-toolkit으로 학습한 어댑터의 경우 참조 이미지는 최대 384×384로 축소되어 Picture N: 토큰으로 프롬프트 앞에 붙습니다.
어댑터는 표준 LoRA 로더로 불러옵니다. 이 PR이 해당 파일들이 사용하는 순수한 layers.N.proj.q 키 스타일에 대한 별칭을 추가했기 때문입니다. 즉 네이티브 경로는 Comfy-Org/MOSS-Image의 단일 파일 가중치를 쓰는 평범한 MOSS-Image 그래프에 LoRA 로더와 새 텍스트 인코드 노드를 더한 형태이며, 참조 이미지는 별도의 잠재 데이터 입력이 아니라 이미지로서 노드에 연결됩니다.
이 PR은 기능보다 속도 개선도 함께 보고합니다. 고립형 레이아웃에서 참조의 블록별 K/V를 매 스텝마다 계산하지 않고 extra_conds에서 한 번만 계산하도록 바꾼 것인데, 1 MP 참조를 사용하는 1024² 기준으로 스텝당 826 ms에서 457 ms로 줄어듭니다. 이 지원은 v0.42.1 태그 이후에 병합되었으므로, 릴리스된 설치본에서 사용하려면 해당 태그 이후로 업데이트해야 합니다.
노드 팩 경로
같은 작성자가 자체 완결형 노드 팩인 Chenkin-x/ComfyUI-Moss-Image-Edit도 배포합니다. 10월 22일에 등장했으며 MOSS Image Edit 카테고리 아래에 로더와 편집 노드를 모두 추가합니다. 코어 노드 대신 자체 MOSS 런타임 사본을 사용하며, 단일 파일 재패키징이 아니라 전체 Diffusers 스냅샷을 요구합니다:
ComfyUI/models/moss_image/
├── MOSS-Image-SFT/          # pipeline_moss_image.py, transformer/, text_encoder/, tokenizer/, vae/, scheduler/
└── Moss-Image-Edit/         # adapter_config.json, adapter_model.safetensors
로더의 snapshot_dir은 베이스 모델을, adapter_dir은 어댑터를 가리킵니다. 워크플로 두 개가 함께 제공되는데, 하나는 참조 이미지 1개용이고 다른 하나는 2개용입니다. 3개나 4개를 쓰려면 남아 있는 reference_3, reference_4 입력에 Load Image 노드를 추가하면 됩니다. 문서에 나온 기본값은 512×512 출력, 30 스텝, CFG 4.0, inference_shift 5.0, 참조 이미지의 긴 변 512에 자르기 없음입니다.
| 설정 | 기본값 | 비고 |
|---|---|---|
width / height | 512 / 512 | 16의 배수 |
reference_max_edge | 512 | 16에 정렬, 자르기 없음 |
steps | 30 | |
cfg | 4.0 | |
inference_shift | 5.0 | 샘플링 시간 분포 |
seed | 42 | 기본 고정 |
참조 이미지가 DiT에 도달하는 방식
두 경로 모두 같은 트릭 위에 서 있습니다. 참조 이미지는 VAE로 인코딩되어 잠재 토큰이 되고, 타임스텝 0에서 자체 RoPE 인덱스로 이미지 시퀀스 뒤에 덧붙으며, 서로에게만 어텐션합니다. 이 토큰들은 샘플링 루프 동안 변하지 않기 때문에 블록별 K/V를 한 번 캐시해 재사용할 수 있고, 그 덕분에 텍스트 인코더 학습이 전혀 없는 랭크 64 어댑터만으로도 인스트럭션이 나머지를 다시 쓰는 동안 정체성을 유지할 수 있습니다.
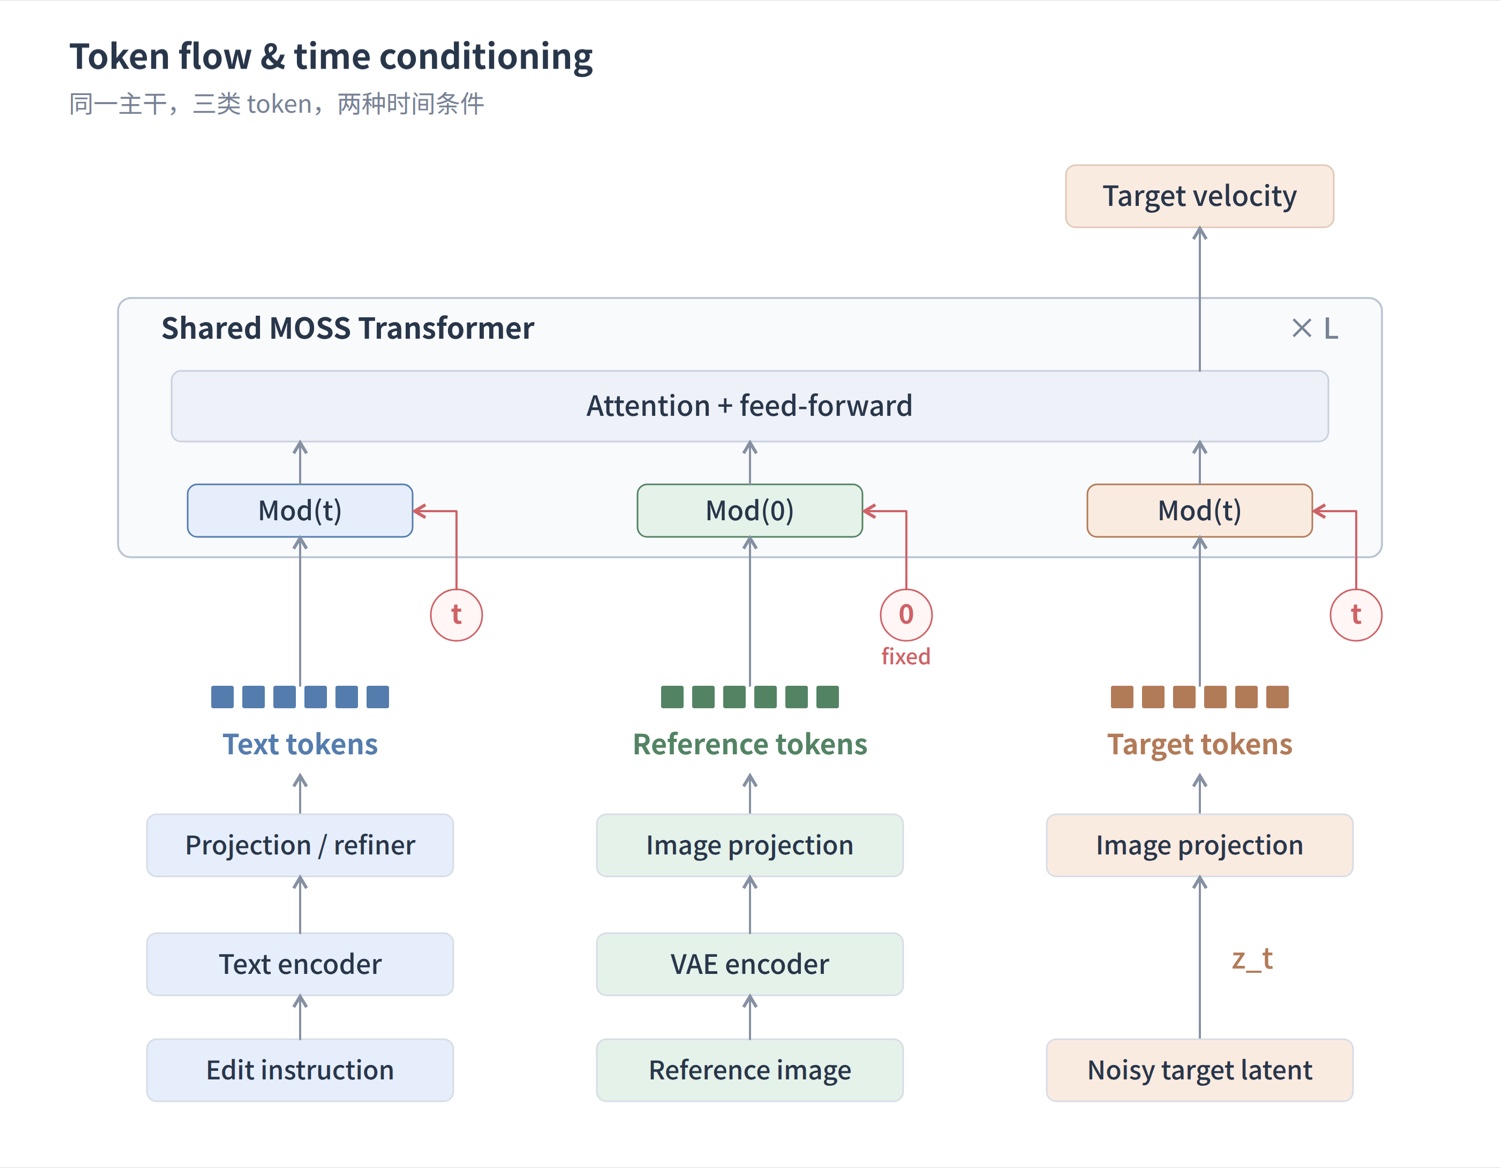
학습 저장소의 참조 KV 캐시 다이어그램. 생성된 토큰 옆에 캐시된 참조 블록이 표시되어 있습니다.
학습 저장소는 가중치만이 아니라 레시피 전체를 공개합니다. 데이터 준비, 설정 파일, 추론 스크립트까지 포함됩니다. 학습 데이터는 NOOB2 페어에 ConceptEdit-12M 세트를 더한 것이고, 인스트럭션은 instruction.detailed_en에서 가져오며, 원본과 편집 이미지는 VAE로 함께 인코딩되고, 두 이미지 모두 자르기나 패딩 없이 긴 변이 max_edge 이하가 되도록 스케일링됩니다. 가이드는 4개 프로세스 torchrun, 패치된 adjust_lr_fn을 통한 ZeRO-2 기반 DeepSpeed Muon, varlen 패킹을 사용하는 Flash Attention 4, 학습 중 int8로 양자화된 텍스트 인코더로 실행됩니다. 검증 샘플은 생성/원본/타깃 트리플과 함께 스텝마다 기록되므로, 저장소의 체크포인트를 재현하거나 확장할 수 있습니다.
알아둘 만한 한계
이 LoRA는 297 MB의 bf16 어댑터로 베이스 모델에 비하면 작지만, 범용 편집기는 아닙니다. 공개된 범위는 속성 및 장면 편집입니다. 색상, 의상, 조명, 계절과 스타일, 그리고 표정이 여기에 해당합니다. 카드에는 오브젝트 삽입이 문서화되어 있지 않고, 벤치마크도 공개되지 않았으며, 두 피사체를 하나의 장면으로 합성하는 것에 대한 주장도 없습니다. 위에서 언급했듯 다중 참조 편집은 프롬프트가 역할을 지정하는지에 달려 있습니다. 또한 공식 OpenMOSS 릴리스가 아닙니다. 가중치, 노드 팩, 학습 코드는 모두 한 작성자에게서 나왔고, ComfyUI 메인테이너가 검토한 부분은 코어 PR뿐입니다.
이용 가능 경로
- LoRA: chinoll/Moss-Image-Edit, 작성 시점 기준 업로드 하루 만에 좋아요 약 21개.
- ComfyUI 코어: PR #17296, 2026년 10월 22일 병합, v0.42.1 릴리스 이후.
- 노드 팩: Chenkin-x/ComfyUI-Moss-Image-Edit, 단일 및 다중 참조 워크플로 포함.
- 학습 및 추론 코드: Chenkin-x/Moss-Image-Edit,
prepare_data.py,configs/train.json,infer.py포함. - 베이스 모델: MOSS-Image-Base와 MOSS-Image-SFT, 단일 파일 ComfyUI 가중치는 Comfy-Org/MOSS-Image에 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.