Kromoss: ComfyUI용으로 배포된 MOSS-Image 전체 파인튜닝
Kromoss는 MOSS-Image-Base의 전체 파인튜닝으로, ComfyUI용 bf16 및 int8 ConvRot 단일 파일과 8단계 DMD LoRA, 변환 스크립트로 배포되었습니다.
Kromoss는 2026년 10월 19일 lodestones가 공개한 MOSS-Image-Base의 전체 파인튜닝 모델입니다. lodestones는 Chroma 체크포인트 라인과 MOSS-Image SFT 8스텝 증류 가중치를 만든 작성자입니다. 이 모델은 MOSS-Image-SFT의 아키텍처와 Qwen3.5-9B 텍스트 인코더, FLUX.2 small VAE를 그대로 유지하므로 기존 MOSS-Image 워크플로에 바로 투입할 수 있으며, 결과물은 ComfyUI가 이미 로드하는 단일 파일 레이아웃 그대로 패키징되어 있습니다.
업로드 몇 시간 만에 Hugging Face에서 좋아요 96개를 받았고, Banodoco의 MOSS-Image 채널에서는 동일한 시드로 int8 지도 파인튜닝 모델과 비교했습니다.
파인튜닝으로 달라진 점
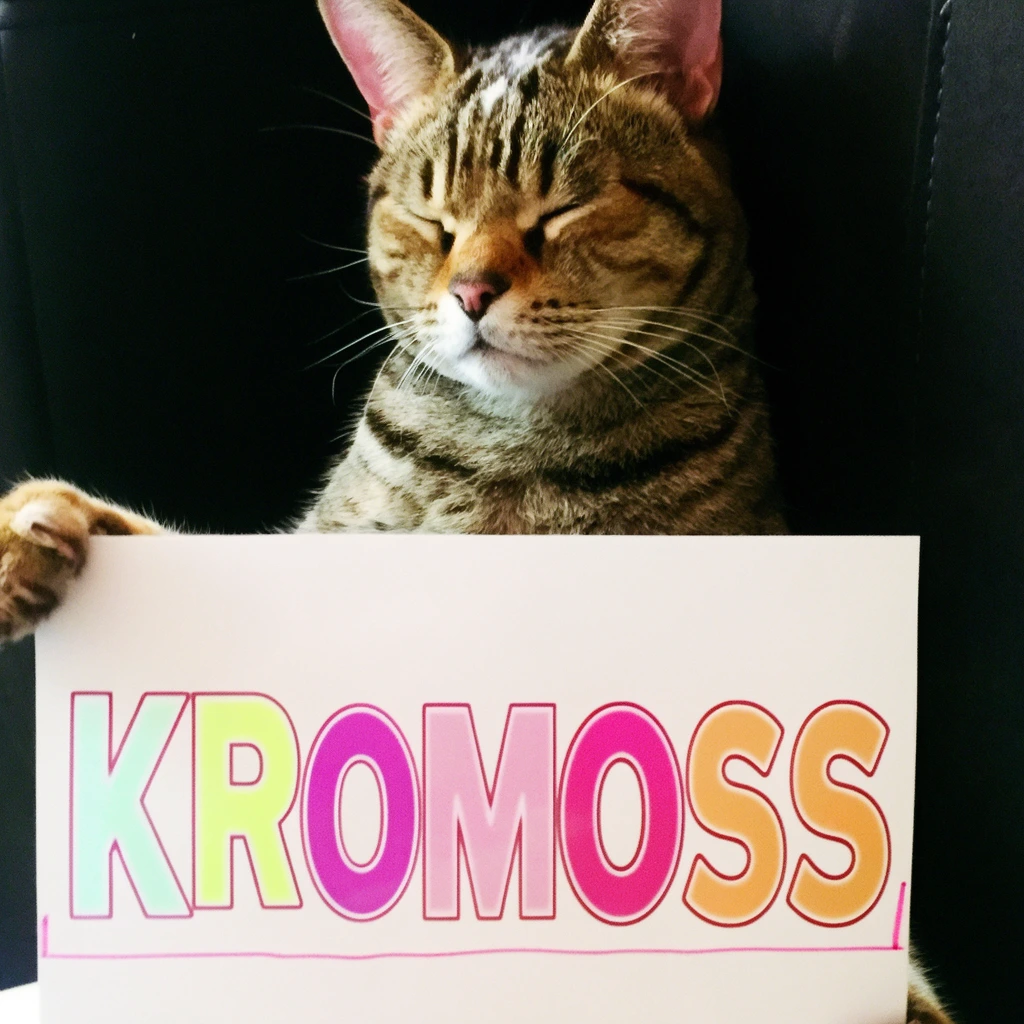
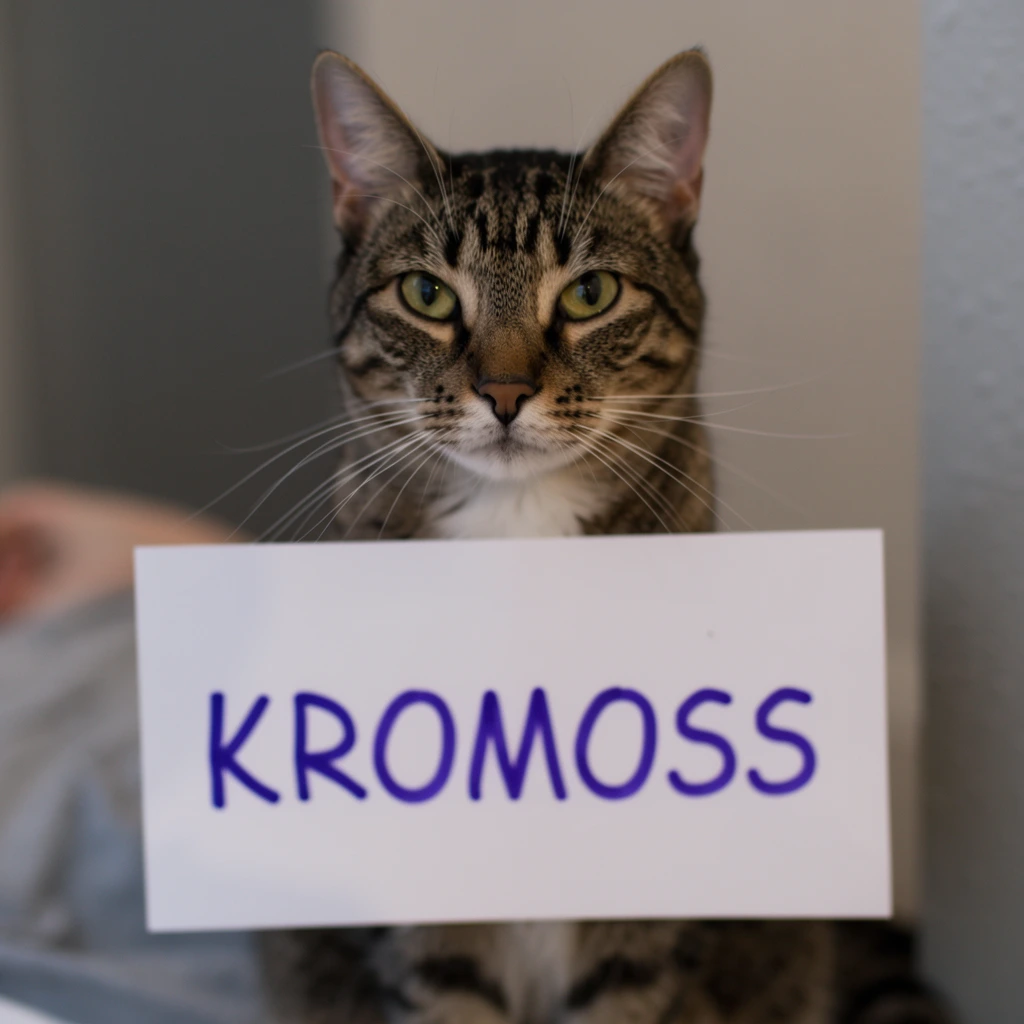
모델 카드는 목표를 좁게 밝히고 있습니다. 전체 파인튜닝은 주로 베이스 모델의 흐릿함을 개선하는 것이며, 나머지는 그대로 이어받았습니다. 학습은 MOSS-Image 리포트의 최종 단계 레시피를 따라 업데이트당 64개 이미지로 확장해 진행했습니다. 학습률 9e-6의 하이브리드 Muon-AdamW와 200스텝 워밍업, 절단된 로짓-노멀 타임스텝, 최종 블록의 q/k 노름을 1로 감쇠, 공개 가중치에 대한 EMA 0.999를 사용했습니다. 체크포인트는 해당 학습의 업데이트 9000 시점이며, 1024px 기준 576k 학습 이미지를 사용했고 896² 미만 이미지는 데이터셋에서 제외했습니다. 학습이 계속되는 동안 저장소는 몇 시간마다 EMA 체크포인트를 다시 업로드합니다. 업로드 첫날에만 업데이트 2000, 4000, 5000, 7000, 9000이 차례로 공개되었기 때문에 구체적인 업데이트 번호와 이미지 수는 앞으로도 계속 바뀝니다.
 |  |
|---|---|
| 50스텝, CFG 3 | 8스텝, CFG 1, 내장 DMD LoRA 사용 |
diffusers뿐 아니라 ComfyUI용으로 패키징
이 저장소는 첫 렌더링 전에 아무것도 변환할 필요가 없도록 구성되어 있습니다. 다섯 개 파일을 ComfyUI 디렉터리에 넣으면 됩니다:
diffusion_models/kromoss_bf16.safetensors(10.2 GB)를models/diffusion_models/에 넣고 확산 모델 로드로 로드합니다. Comfy-Org 워크플로에서moss_image_sft_bf16.safetensors를 일대일로 대체합니다.diffusion_models/kromoss_int8_convrot.safetensors(5.4 GB)는 int8 경로용이며, Comfy-Org의moss_image_sft_int8_convrot.safetensors와 동일한 ConvRot W8A8 형식입니다.text_encoders/qwen3.5_9b_bf16.safetensors(19.3 GB)를models/text_encoders/에 넣고 CLIP 로드에서 typemoss_image로 로드합니다. 다른 MOSS-Image 빌드가 사용하는 것과 동일한 인코더이므로, 이미 설치한 경우 중복으로 받을 필요가 없습니다.vae/flux2-vae_small.safetensors를models/vae/에 넣습니다.8-steps-dmd-lora.safetensors(1.19 GB)를models/loras/에 넣고 LoraLoaderModelOnly에 강도 1로 적용합니다.
int8 파일은 다른 체크포인트를 다시 양자화한 복사본이 아닙니다. 168개 블록 선형 레이어(proj.{qkv,o,ffn_up_gate,ffn_down})는 입력 차원에 256폭 정규 Hadamard 회전을 적용한 뒤 행별 스케일과 함께 int8로 저장되며, ComfyUI는 행렬을 저장하는 대신 로드 시점에 회전을 재구성하고, 각 블록은 ComfyUI의 int8 어텐션을 선택합니다. 또한 저장소에는 임의의 bf16 단일 파일에서 해당 형식을 생성하는 quantize_convrot.py와, diffusers transformer/ 폴더를 융합된 proj.qkv 레이아웃으로 변환하는 convert_to_comfy.py도 포함되어 있습니다.
두 스크립트에는 이들을 계속 쓸 만하게 만드는 자체 검증 기능이 있습니다. MOSS-Image-SFT의 transformer/에서 실행하면 Comfy-Org가 공개한 moss_image_sft_bf16.safetensors와 moss_image_sft_int8_convrot.safetensors를 바이트 단위로 재현하며, --compare FILE은 참조 파일과 키, 형태, dtype을 비교합니다. 즉 누구나 같은 두 명령으로 자신의 MOSS-Image 파인튜닝 모델을 변환할 수 있습니다.
8스텝 LoRA
내장된 8-steps-dmd-lora.safetensors는 MOSS-Image-Base를 데이터 공간에서 DMD 증류한 것으로, fp32, rank 128에 알파 128을 모든 블록의 proj.{q,k,v,o,ffn_up_gate,ffn_down}에 적용하고 kohya 키 형식으로 저장했습니다. 생태계 관례대로 q, k, v 프로젝션을 분리했으며, ComfyUI는 로드할 때 이를 MOSS-Image 단일 파일의 융합된 qkv 슬라이스에 매핑합니다.
모델 카드는 LoRA를 bf16 가중치에 병합해서는 안 된다고 명시합니다. 델타가 bf16의 반올림 단위에 가까워, 병합하지 않은 상태로 강도 1에서 적용합니다.
| 설정 | 전체 모델 | 8-steps-dmd-lora 사용 시 |
|---|---|---|
| 샘플러 | 플로우 매칭 Euler | 플로우 매칭 Euler |
| 스텝 | 50 | 8 |
| CFG | 3 | 1 |
| 시프트 | 5 | 5 |
| 레이어 스킵 | 네거티브 브랜치, 블록 22 | 없음, 네거티브 브랜치 없음 |
측정된 프롬프트 반영도
저장소는 PartiPrompts의 100개 프롬프트에 대한 CLIP ViT-L/14 점수를 보고하며, Kromoss 행은 현재 공개된 체크포인트가 아닌 업데이트 2000 시점에서 측정한 값입니다.
| 모델 | CLIP ViT-L/14 |
|---|---|
| MOSS-Image-Base, 50스텝, CFG 3 | 27.19 |
| MOSS-Image-Base + 8스텝 LoRA | 27.53 |
| Kromoss, 50스텝, CFG 3 | 26.88 |
| Kromoss + 8스텝 LoRA, 8스텝, CFG 1 | 27.82 |
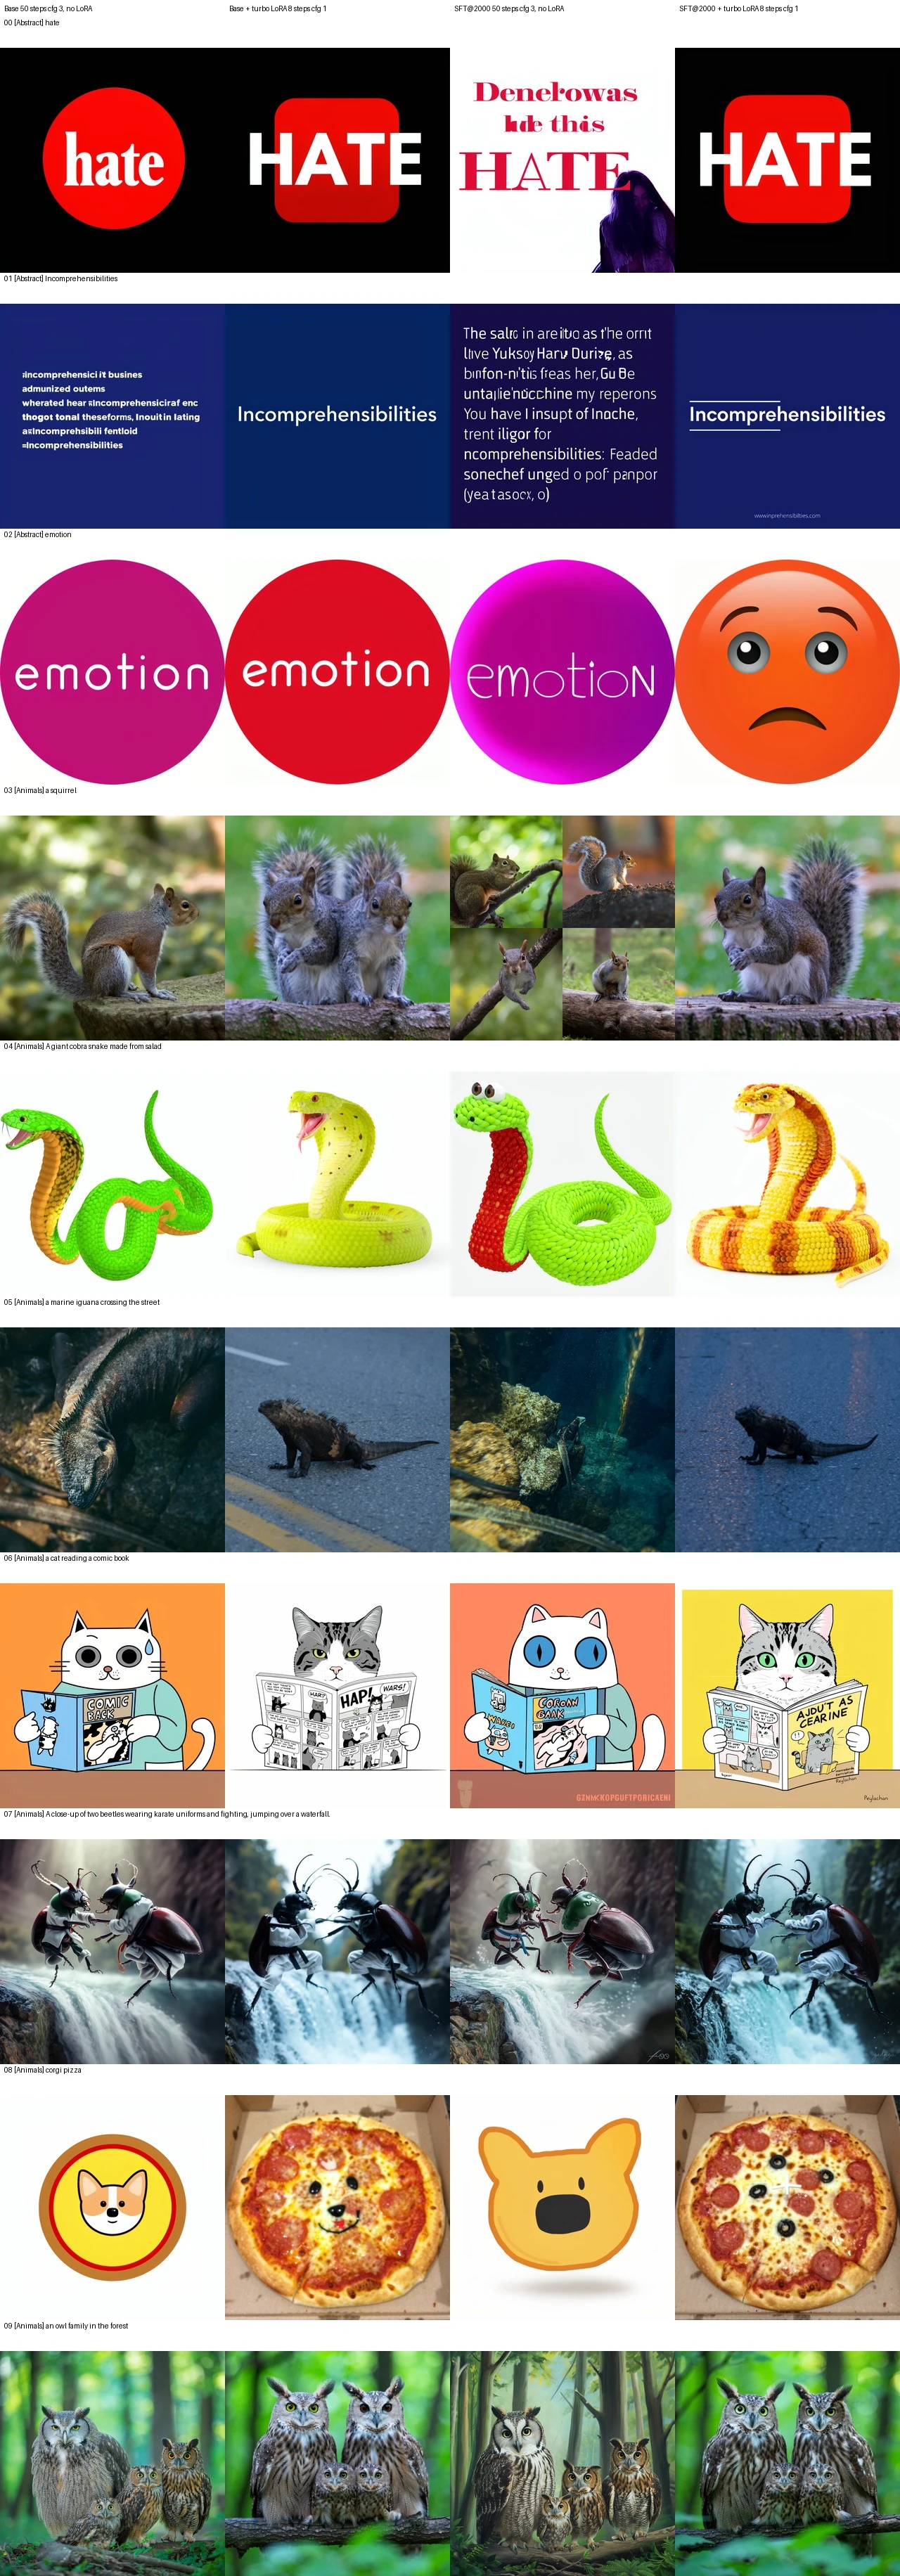
그대로 읽으면, 이 표는 전체 파인튜닝만 사용하면 선명도를 얻는 대신 프롬프트 반영도가 약간 낮아지고, 그 위에 증류 LoRA를 얹으면 베이스 점수를 회복해 약간 웃도는 것을 보여줍니다. 수치는 작성자가 직접 측정한 값이며 학습 중간 체크포인트에서 나온 것입니다.
다운로드 및 사용
Kromoss는 Hugging Face의 lodestones/Kromoss에서 받을 수 있으며 Civitai에도 미러링되어 있습니다. MOSS-Image 지원은 현재 ComfyUI master에 포함되어 있어 체크포인트와 LoRA 모두 커스텀 노드가 필요 없습니다. 베이스 모델과 공식 가중치는 MOSS-Image 릴리스 소식과 4스텝 및 8스텝 커뮤니티 어댑터를 참고하세요.
댓글
GitHub로 로그인하고 토론에 참여하세요.