KohakuMoss: MOSS-Image LoRA 학습과 ComfyUI 내보내기
KohakuMoss 0.1.0은 MOSS-Image-Base와 SFT에서 LoRA, LyCORIS, 전체 파인튜닝을 학습하고, 6GB 그래픽카드에서 실행되며, ComfyUI 키 레이아웃으로 어댑터를 내보냅니다.
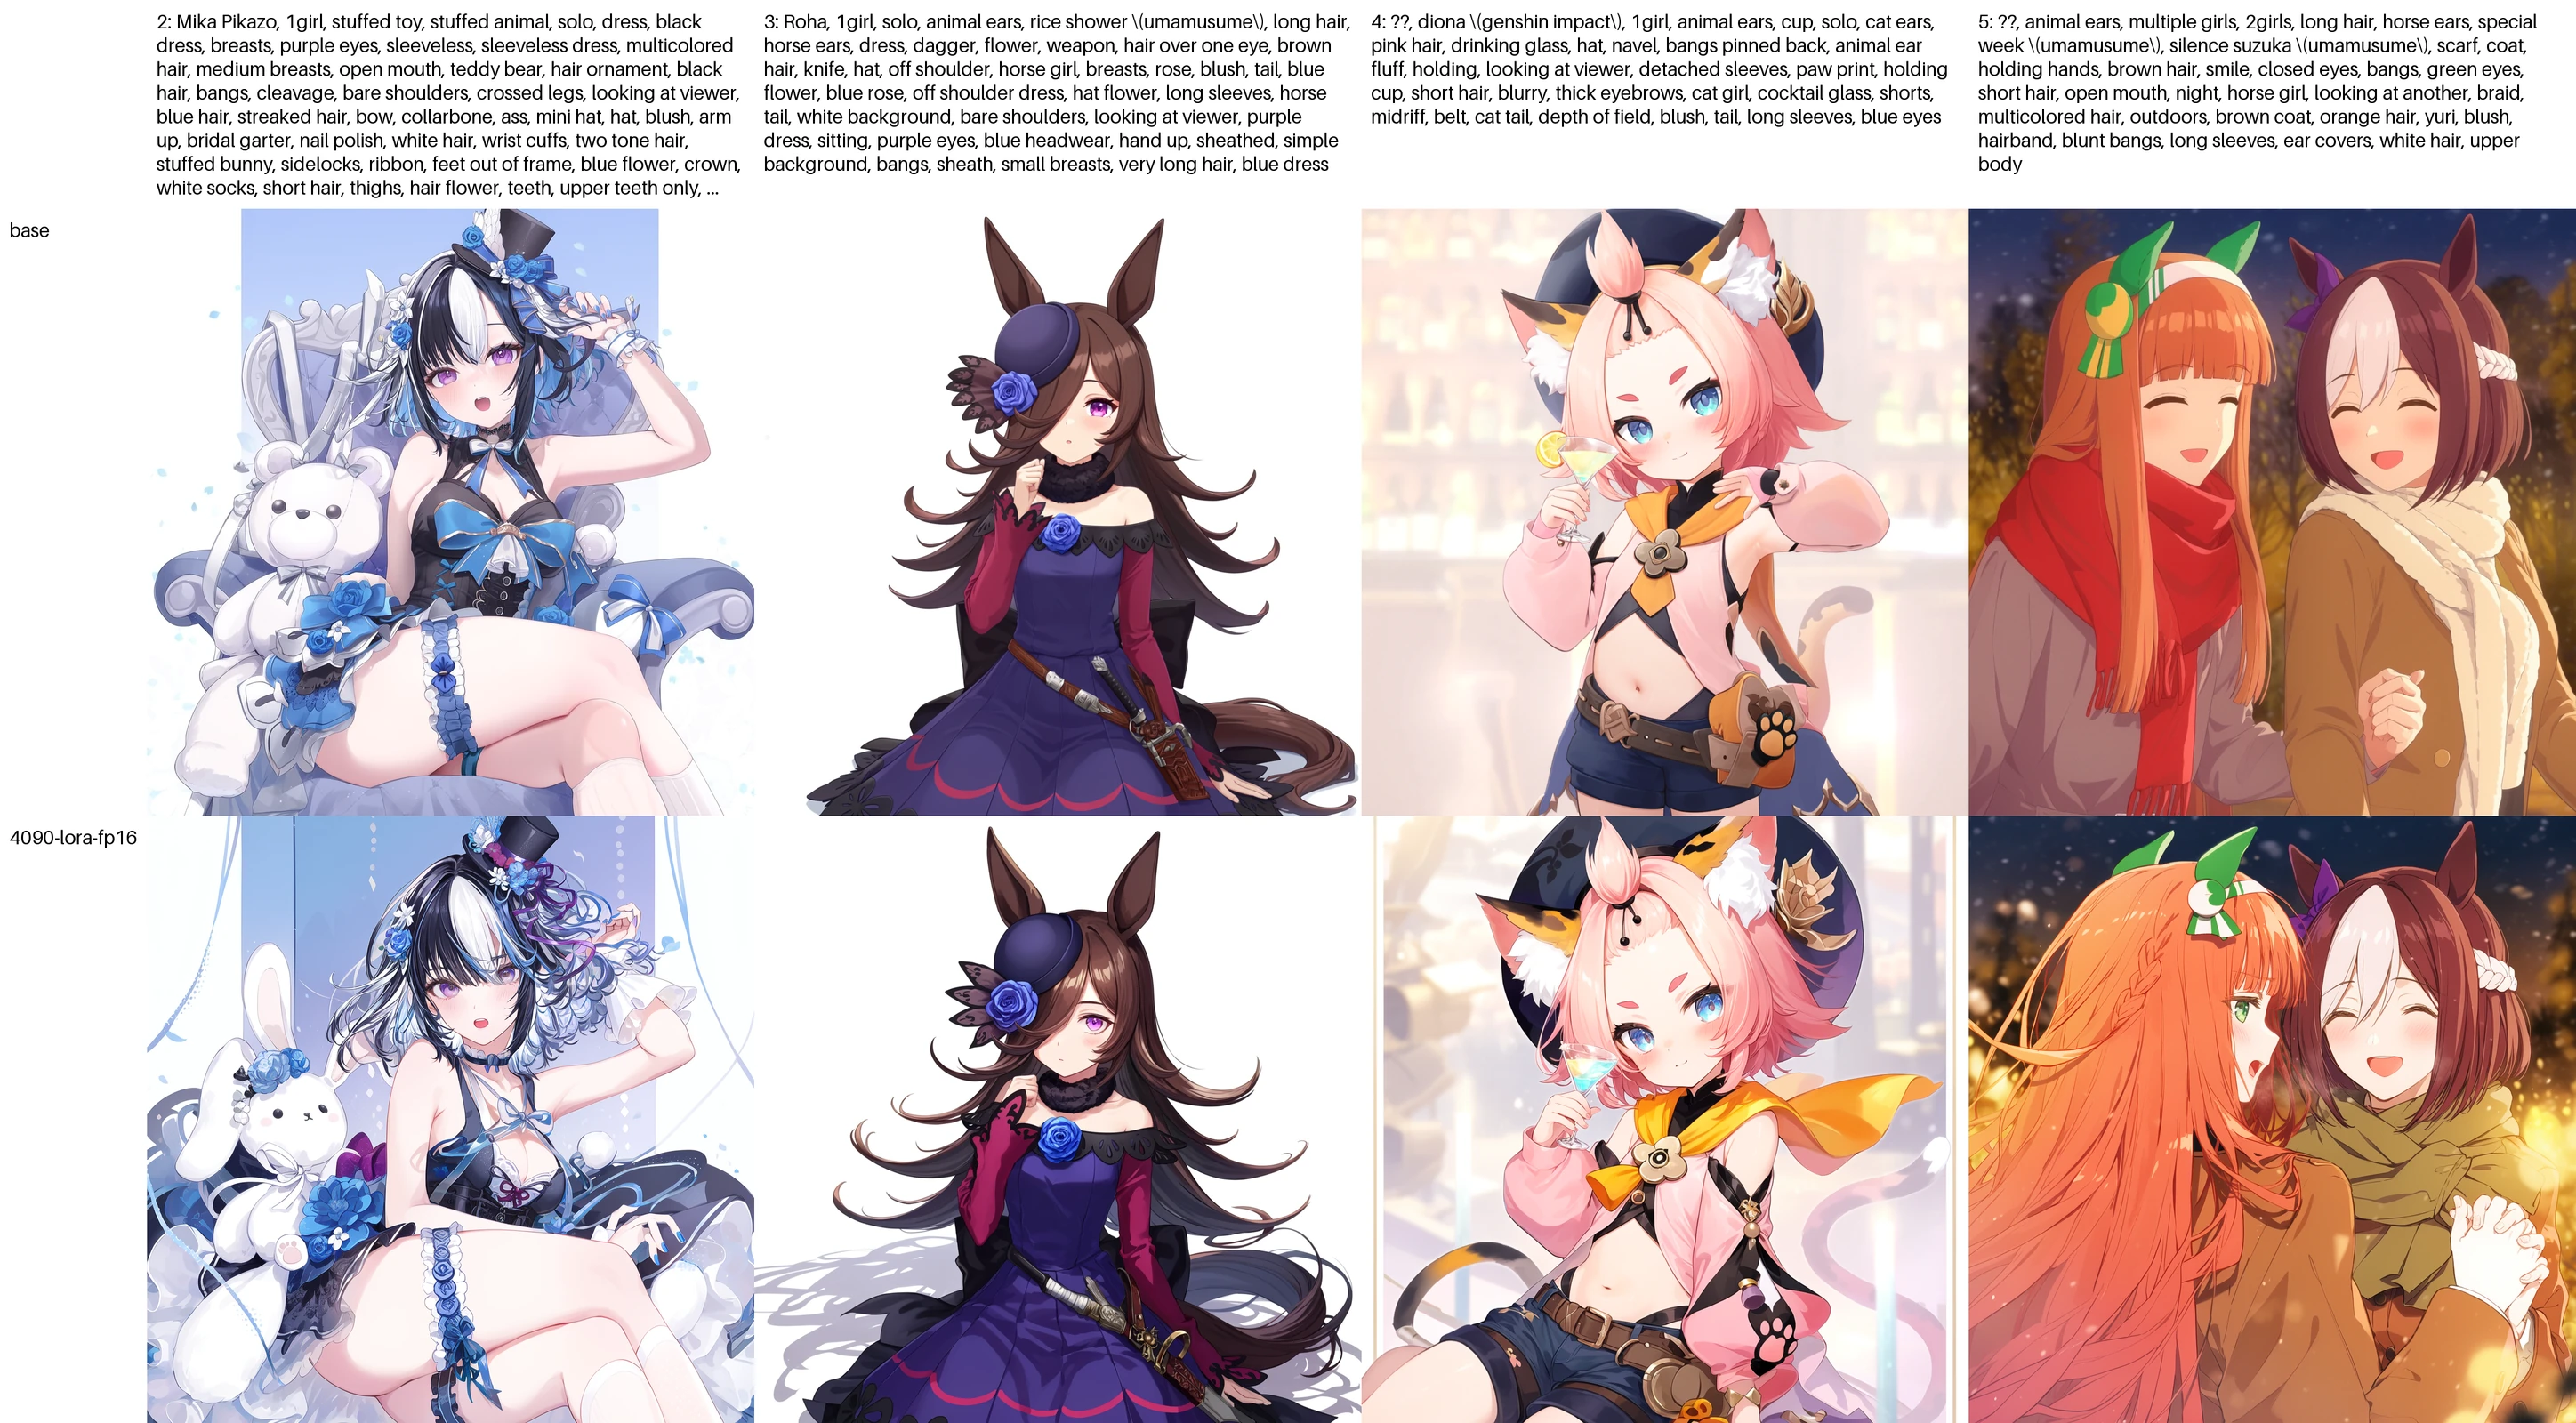
KohakuMoss는 MOSS-Image-Base와 MOSS-Image-SFT를 위한 파인튜닝 프레임워크로, 2026년 10월 18일 PyPI에 버전 0.1.0으로 공개되었습니다. LyCORIS의 작성자인 KohakuBlueleaf가 만들었으며, 모델 공개와 커뮤니티의 소수 스텝 어댑터가 다루지 못한 MOSS-Image 툴체인의 빈 부분을 채웁니다. 즉, 자체 이미지를 원본 해상도로 학습한 뒤 변환 단계 없이 ComfyUI가 불러올 수 있는 형태로 내보내는 것입니다.
메우는 빈틈
MOSS-Image는 10월 16일 두 개의 체크포인트, 레이아웃 제어, 당일 ComfyUI 지원과 함께 등장했고, 커뮤니티의 4단계 및 8단계 LoRA가 하루 만에 뒤따랐습니다. 그러나 어느 쪽도 이 특정 5B 디퓨전 트랜스포머와 그 Qwen3.5-9B 텍스트 인코더를 겨냥한 학습기를 내놓지 않았습니다. 범용 디퓨전 학습기는 UNet이나 Flux 형태의 스택을 가정하지만, MOSS-Image는 자체적인 패킹된 어텐션과 고유한 키 이름을 필요로 합니다. KohakuMoss는 두 가지를 모두 제공합니다. 독립적인 MOSS-Image 구현, LyCORIS 어댑터 세트, 데이터 파이프라인, 그리고 이를 카드 한 장에서 실행하기 위한 메모리 계획입니다.
어댑터와 전체 파인튜닝
어댑터 학습은 LoRA와 LoCon, LoHa, LoKr, DoRA, OFT, BOFT, GLoRA, IA3, DyLoRA, T-LoRA를 모두 LyCORIS를 통해 다루므로, 그 알고리즘과 저장 형식, 융합 커널이 그대로 따라옵니다. 드롭아웃, LoRA+, 바이패스 또는 병합 포워드, 타깃 프리셋은 별도 스크립트가 아니라 설정입니다.
전체 파인튜닝도 지원되며, MOSS 기술 보고서를 따라 Muon과 AdamW, EMA를 사용합니다. 마스터 가중치를 호스트 메모리에 두면 24GB 카드 한 장에 들어가므로, 대가는 추가 GPU가 아니라 시스템 RAM입니다.
6GB에서 실행하기
메모리는 단일 전환이 아니라 여러 레이어의 조합으로 처리됩니다. 블록 체크포인팅, 가중치 스트리밍, 활성값 오프로드, 그래디언트 오프로드, 그리고 호스트에 두는 옵티마이저 상태입니다. 네 가지 이름 붙은 프로필이 speed부터 minimal까지 걸쳐 있고, kohakumoss-config는 감지된 카드에 맞춰 하나를 고르며, 그 아래에는 수동 튜닝을 위한 240개 항목의 카탈로그가 있습니다. 어댑터 학습은 8GB 카드까지 도달하며, 잠재 데이터와 텍스트 캐시를 모두 오프라인으로 구축하면 6GB 레이어에도 들어갑니다. 24GB 카드는 여전히 전체 파인튜닝 사례를 커버합니다.
정밀도는 하드웨어를 따릅니다. 지원되는 곳에서는 bf16, 잔차 보정을 적용한 구형 카드에서는 fp16, sm89 이상에서는 DiT와 텍스트 인코더 모두 학습과 추론에서 fp8 및 MXFP8 연산, 그리고 고정된 베이스에는 int8 또는 fp8 가중치 전용 양자화를 사용합니다.
아키텍처별 커널
이 프로젝트는 하나의 스택에 의존하는 대신 자체 커널을 제공합니다. sm70과 sm75에는 TileLang, sm80 이상과 Intel Arc에는 Triton을 사용하며, 두 경우 모두 뒤에 torch.compile과 eager 모드가 있습니다. Varlen 어텐션, 블록 연산, 융합 리니어는 각각 아키텍처와 dtype, 형상에 따라 백엔드를 선택하며, 카드에서 한 번 측정되어 튜닝 테이블에 저장됩니다. 따라서 동일한 설치라도 V100과 RTX 5090에서 서로 다르게 튜닝됩니다.
모델 구현은 패킹된 가변 길이 배치를 실행합니다. 하나의 평탄한 토큰 축을 사용하고, 어텐션은 각 샘플 내부에 유지됩니다. 공식 코드와 비교해 이 프로젝트가 보고하는 fp32 포워드 상대 오차는 4.7e-6이고, 50스텝 샘플링 LPIPS는 2.3e-6입니다.
데이터와 이어서 학습하기
입력 형식은 kohya 스타일 폴더, jsonl, parquet, webdataset, 네이티브 샤드를 포함하며, 첫 스캔 이후 캐시되는 증분 카탈로그를 사용합니다. 크기 조정, 버킷, 크롭 플래너가 원본 해상도 이미지를 처리하고, 토큰 배칭이 스텝을 균등하게 유지하며, 잠재 데이터와 텍스트 캐시는 오프라인으로 구축하거나 학습 중에 채울 수 있습니다. 샘플링 계획은 데이터와 시드, 설정에 대한 순수 함수이므로, 재개된 실행은 근사치가 아니라 동일한 순서를 그대로 재생합니다.
멀티 GPU는 Linux 전용입니다. 가중치 스트리밍을 포함한 모든 메모리 프로필에서의 DDP, FSDP2, 파이프라인, 스레드 파이프라인을 지원합니다.
ComfyUI로 내보내기
내보내기 단계가 이 프로젝트를 또 하나의 학습기 이상으로 만듭니다. 한 번의 실행으로 LyCORIS 파일, 병합된 모델, diffusers 트랜스포머, 또는 ComfyUI 자체의 MOSS-Image 키 레이아웃에 맞춰 작성된 ComfyUI 형식 어댑터를 만들 수 있으며, 융합된 q/k/v 프로젝션을 위한 재패킹도 포함됩니다. 이 파일은 models/loras에 넣으면 일반적인 ComfyUI 워크플로에서 로드되므로, 여기서 학습한 LoRA에는 서드파티 노드나 변환 노트북이 필요하지 않습니다. 내보내기는 마지막 스텝뿐 아니라 저장된 모든 체크포인트에서도 작동합니다.
측정된 속도
공개된 표는 balanced 프로필에서 rank 32 LoRA로 MOSS-Image-Base를 1 MP 학습한 결과를 보고합니다. RTX 5090에서는 캐시 없이 초당 1.01 샘플, 잠재 데이터와 텍스트 캐시를 모두 사용하면 1.14 샘플에 도달하며, RTX 4090은 0.49에서 0.73으로, RTX 3090은 0.31에서 0.39로 올라갑니다. 대부분의 행에서 스텝 피크는 torch 할당 메모리 약 6.6 GiB에 머물며, 5090 수치에는 상주하는 15.6 GiB 텍스트 인코더가 포함되어 있어 캐시 없는 수치가 더 빠른 것입니다.
README 예시는 실제 첫 프로젝트에 더 가깝습니다. fp8 베이스 위에 rank 8 fp16 스타일 LoRA를 얹고, 스텝당 약 20k 토큰으로 100스텝을 돌리며, 공격적인 ckpt-ring4-actoff 프로필을 사용하고 매 스텝 텍스트 인코더와 VAE 인코딩을 온라인으로 수행합니다. RTX 4090 한 장에서 12~13GB를 유지하며 초당 약 0.85 이미지를 생성합니다.
구성
모든 스크립트는 KohakuEngine 스크립트이므로, 설정은 모듈 수준의 노브이고 구성은 프리셋을 서로 겹쳐 쌓을 수 있습니다. kohakumoss-config는 감지된 GPU와 데이터셋에 맞춰 검증된 구성을 작성하고, kohakumoss-config wizard는 플래그를 받는 대신 GPU, 알고리즘, 데이터, 가중치를 물어보며, lora_24g_bf16 같은 고정 레시피에는 나열된 모든 노브를 덧붙일 수 있습니다.
제공 및 라이선스
KohakuMoss는 github.com/KohakuBlueleaf/KohakuMossTrainer에 있으며, PyPI에서 kohakumoss로 설치합니다. 설치 도우미는 드라이버를 감지하고, 일치하는 torch 인덱스를 고른 뒤 kohakumoss-doctor를 실행하며, 이 도구는 누락된 항목을 이를 해결하는 명령과 함께 보고합니다. Python 3.10 이상이 필요하고, CUDA 12.6 이상 또는 Intel Arc 드라이버가 있어야 합니다. Windows에서는 Visual Studio Build Tools가 필요하고, sm70 및 sm75 카드는 nvcc를 위해 CUDA 툴킷이 필요합니다.
라이선스는 KohakuMoss License 1.0입니다. Apache 2.0에 한 가지 조건이 더해져, KohakuMoss를 기반으로 만든 파생 저작물, 패키지, 제품 또는 서비스는 이름에 "Kohaku"를 포함해야 합니다. 프레임워크로 학습하거나 생성한 모델, 어댑터, 이미지는 명시적으로 이 조건의 적용 대상이 아니므로, 이를 통해 만든 LoRA나 체크포인트는 작성자가 원하는 대로 이름을 붙이고 라이선스를 정할 수 있습니다.
체크포인트 자체에 대해서는 MOSS-Image 공개 소식과 빠른 샘플링을 실용적으로 만든 4단계 및 8단계 어댑터를 참고하세요.
댓글
GitHub로 로그인하고 토론에 참여하세요.