 音声合成
ベースモデル
YuE2-3B ComfyUI ワークフロー:MAPのオープン音楽生成モデルYuE2-3B ComfyUI ワークフロー:MAPチームのオープン音楽生成モデル。歌詞から編集可能なスコア付きの楽曲を生成し、WildSongBenchでSuno v5を上回ります。重みはmasterにマージ済み。
CC-BY-NC-4.0
ComfyUI エコシステムの最新情報:オープンソースモデルのリリース、カスタムノード、ワークフロー、ツールのアップデート。
音声合成YuE2-3B ComfyUI ワークフロー:MAPチームのオープン音楽生成モデル。歌詞から編集可能なスコア付きの楽曲を生成し、WildSongBenchでSuno v5を上回ります。重みはmasterにマージ済み。
CC-BY-NC-4.0

drbaph が VDN-H3 Turbo アダプターを MiniMax H3 用のスタンドアロン 8 ステップ LoRA に抽出し、pruned fl2va/ref2va バリアントと Comfy Kitchen 向けの INT8 ConvRot VDN checkpoint を追加しました。
minimax-h3-community-license-agreement
 エコシステム
WAS Node Suite v3は定番のComfyUIノードパックを再構築: 463ノード、自動pipインストールなし、torchネイティブ処理、Three.js 3Dシーン、ノード内ビデオ比較に対応。
 テキスト→画像
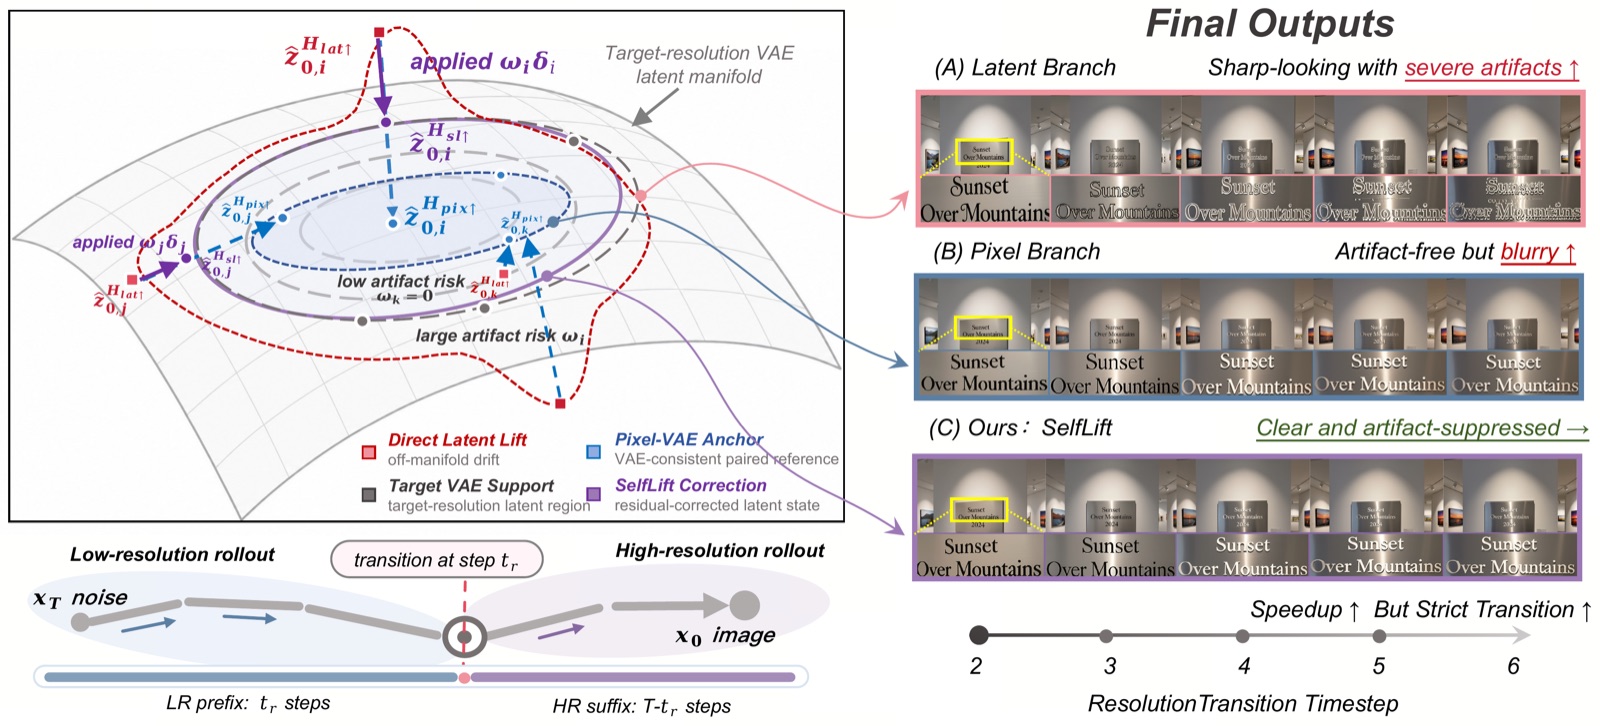
comfyui-SelfLiftは低解像度で初期のデノイズを実行し、フル解像度で完了します。Z-Image、FLUX.2-Klein、MiniMax H3向けのTST補正付きトレーニング不要な高速化です。
 テキスト→動画
AlibabaのTaoLive AIGCチームが、音声とビデオをチャンク単位で同期ストリーミングし、MiniMax H3で35 FPSの長尺生成を実現する3ステップLoRAランタイム、TaoMate-H3をオープンソース化しました。
minimax-h3-community-license-agreement
 テキスト→動画
AI Movie Studio 2 は、3D ストーリーボード、連続性システム、ロングテイクモード、タイムラインエクスポートを備え、ローカル ComfyUI を駆動するオープンソースの AI 映画制作ワークステーションです。
 音声合成
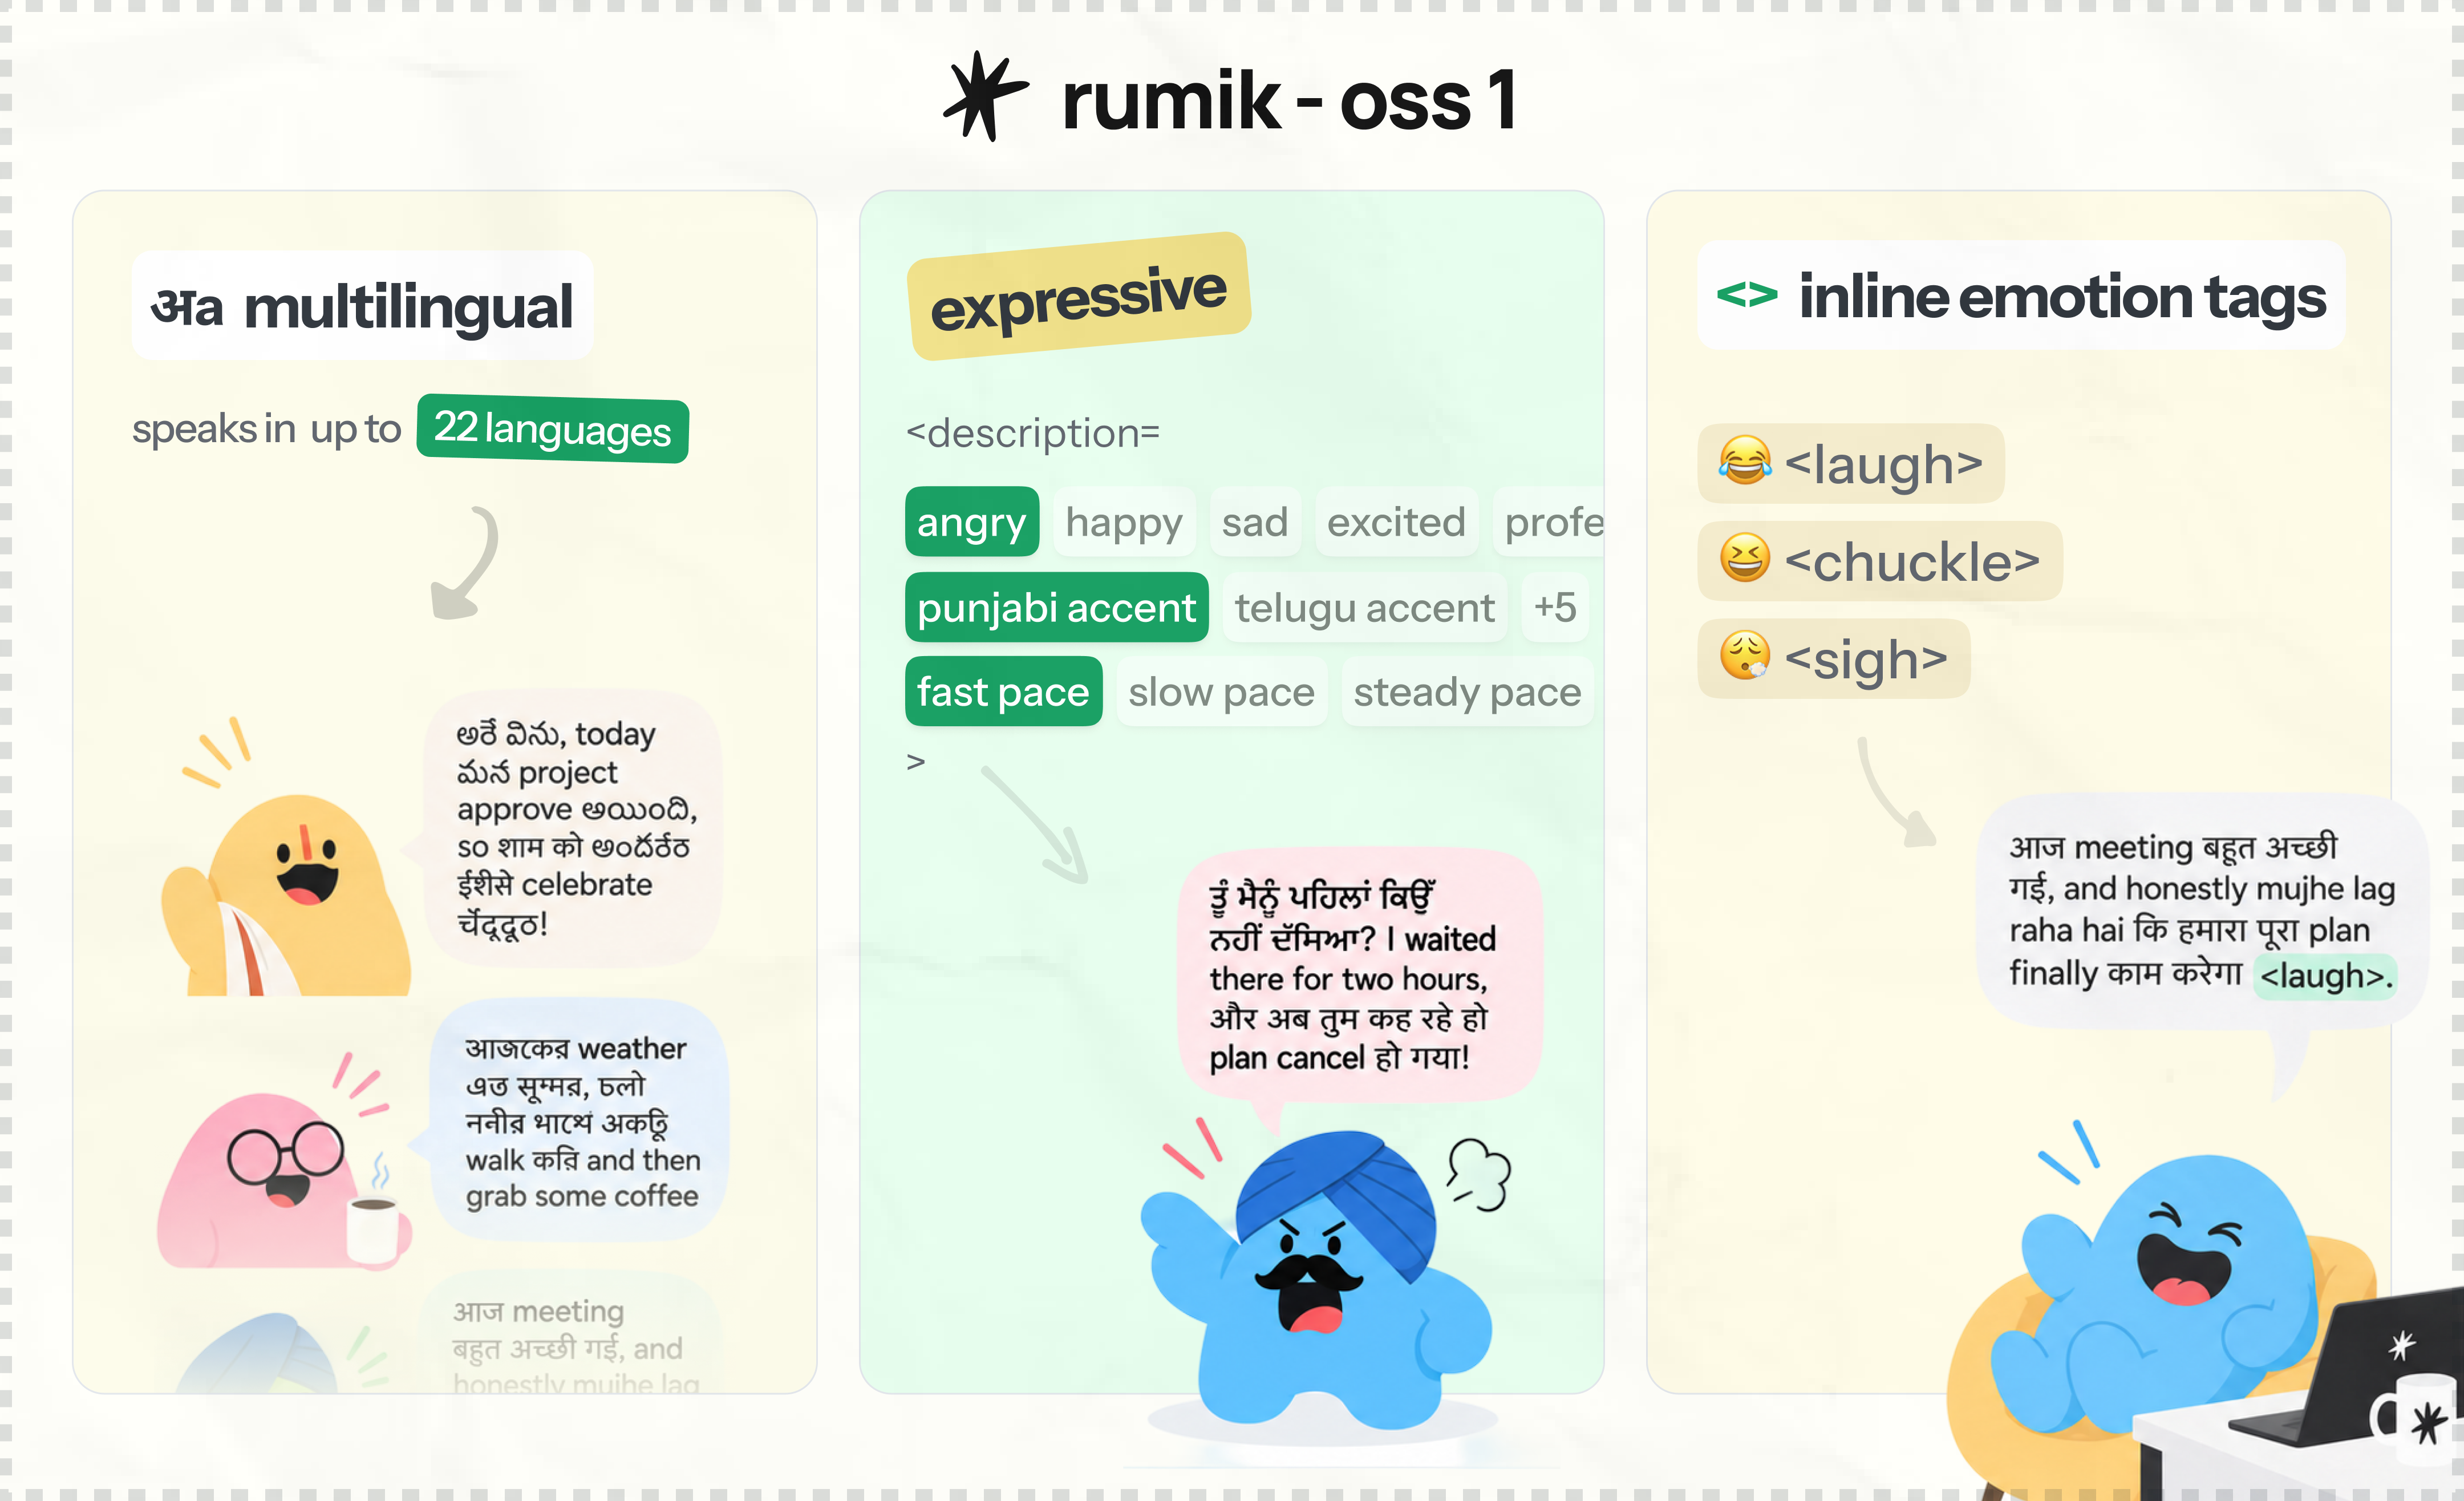
Rumik AIがrumik-oss 1をオープンソース化。22のインド系言語と英語に対応した3Bのテキスト読み上げモデルで、コードスイッチング合成、話し方の条件付け、インラインの笑いタグを備えています。
cc-by-nc-4.0
 動画編集
Alissonerdx氏のH3 sharpness LoRAは、同一解像度のv2vパスで鮮明なディテールを復元します。ガイド潜在による条件付け、1.2 GBの単一ファイル、ネイティブComfyUIワークフロー付き。
Apache-2.0
 テキスト→動画
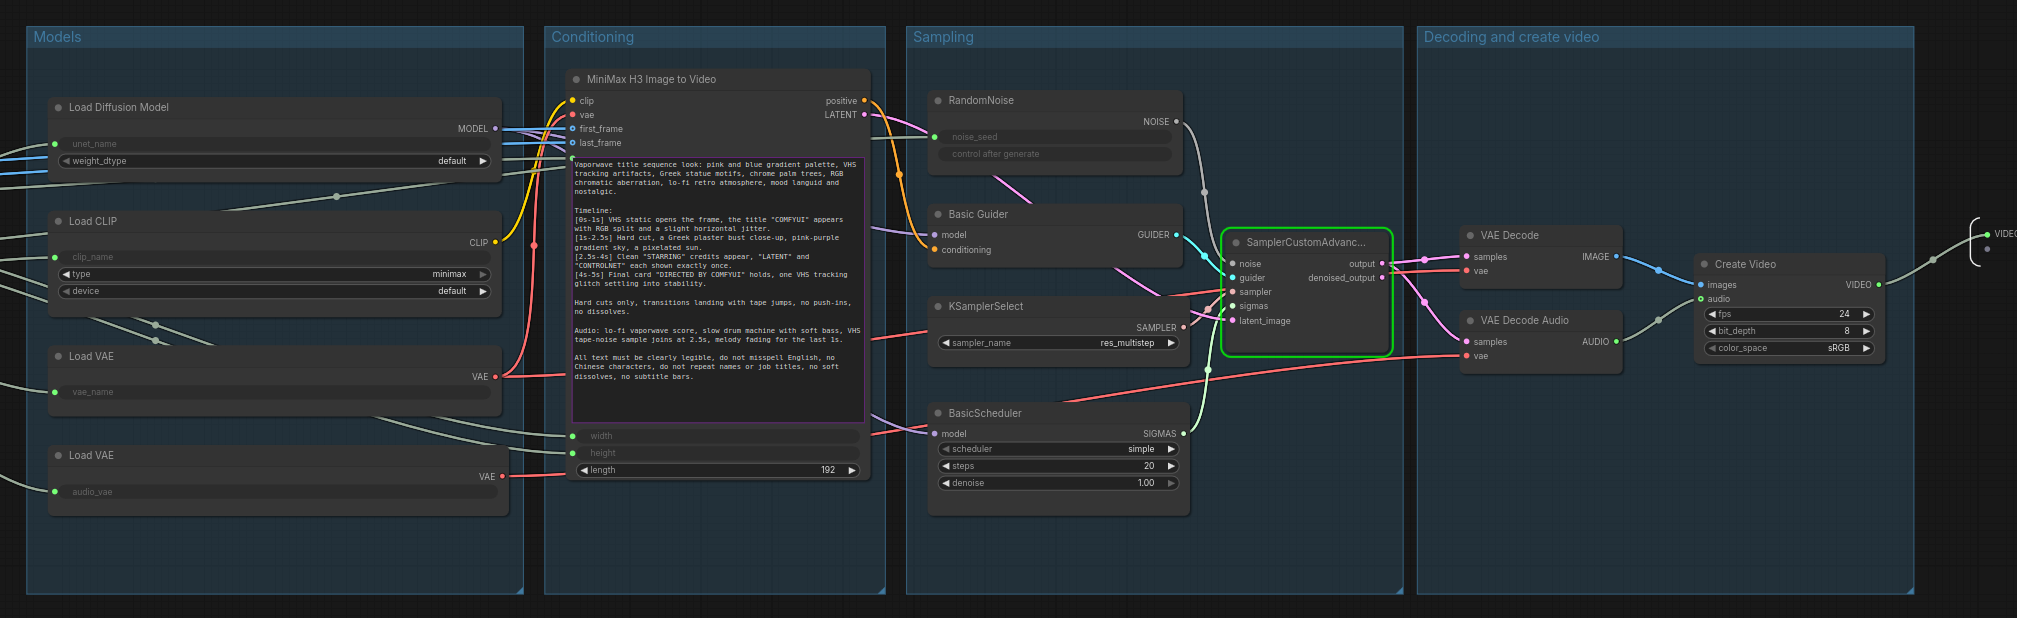
Kijai のブロックスパースアテンションが ComfyUI コアに搭載され、MiniMax H3 用の 3 つのバックエンドを搭載。VRAM の無駄を削減し、長い H3 ランを高速化する新しいメモリコンパイラーも追加されました。
 画像→動画
ComfyUIノードでFastH3 VSAゲートをMiniMax H3 Ref2VAに移植し、参照トークンは密のまま動画タイルをプルーニングして、4ステップの高速なキャラクター動画を実現します。
WarmBloodAban の Minimax-h3_Singularity_ref2va_v1.3_int8.safetensors と Pruned 版をダウンロード。ComfyUI 向け MiniMax H3 HDR 融合ファインチューンで、アクションと VFX を強化。
apache-2.0
 画像→画像
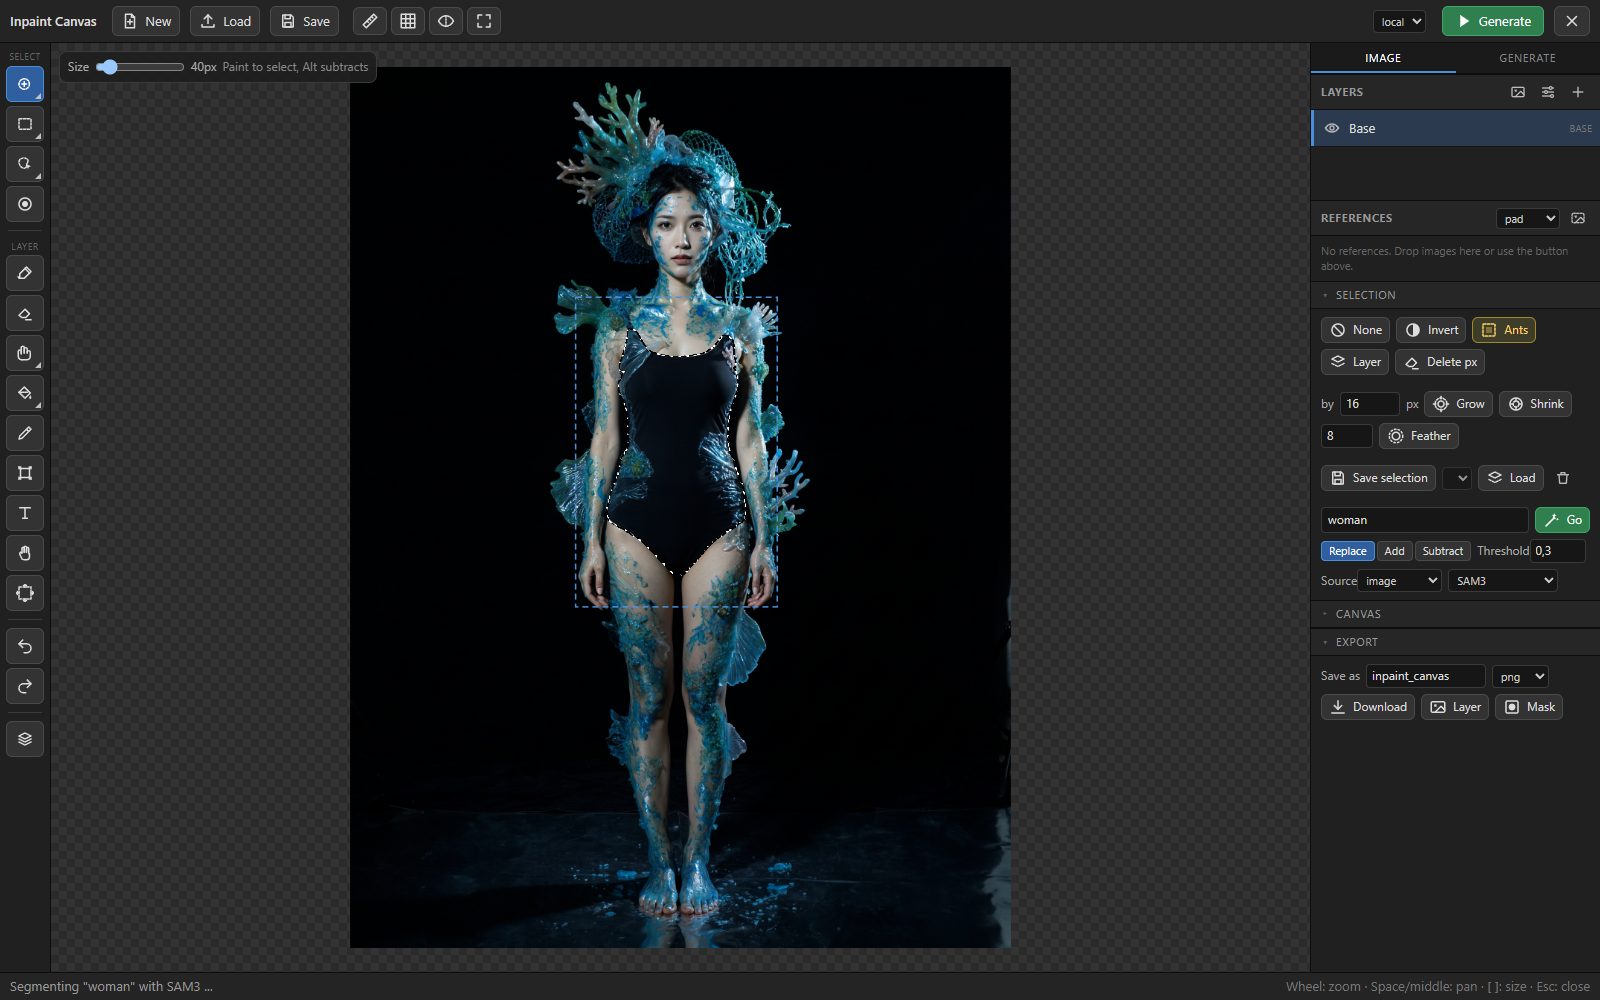
新しいカスタムノードがComfyUIをレイヤー型ペイントソフトに変えます。選択、SAMによるオブジェクト選択、インペイントの往復処理、フィルタレイヤー、PSDエクスポートを1つのエディタで実現。
 画像→動画
RefModsはMiniMax H3向けの約1MBの条件付けアダプターです。キャラクターを一度エンコードすれば、ComfyUIでLoRAのように読み込んで、何度でも生成に再利用できます。
Apache-2.0
 テキスト→動画
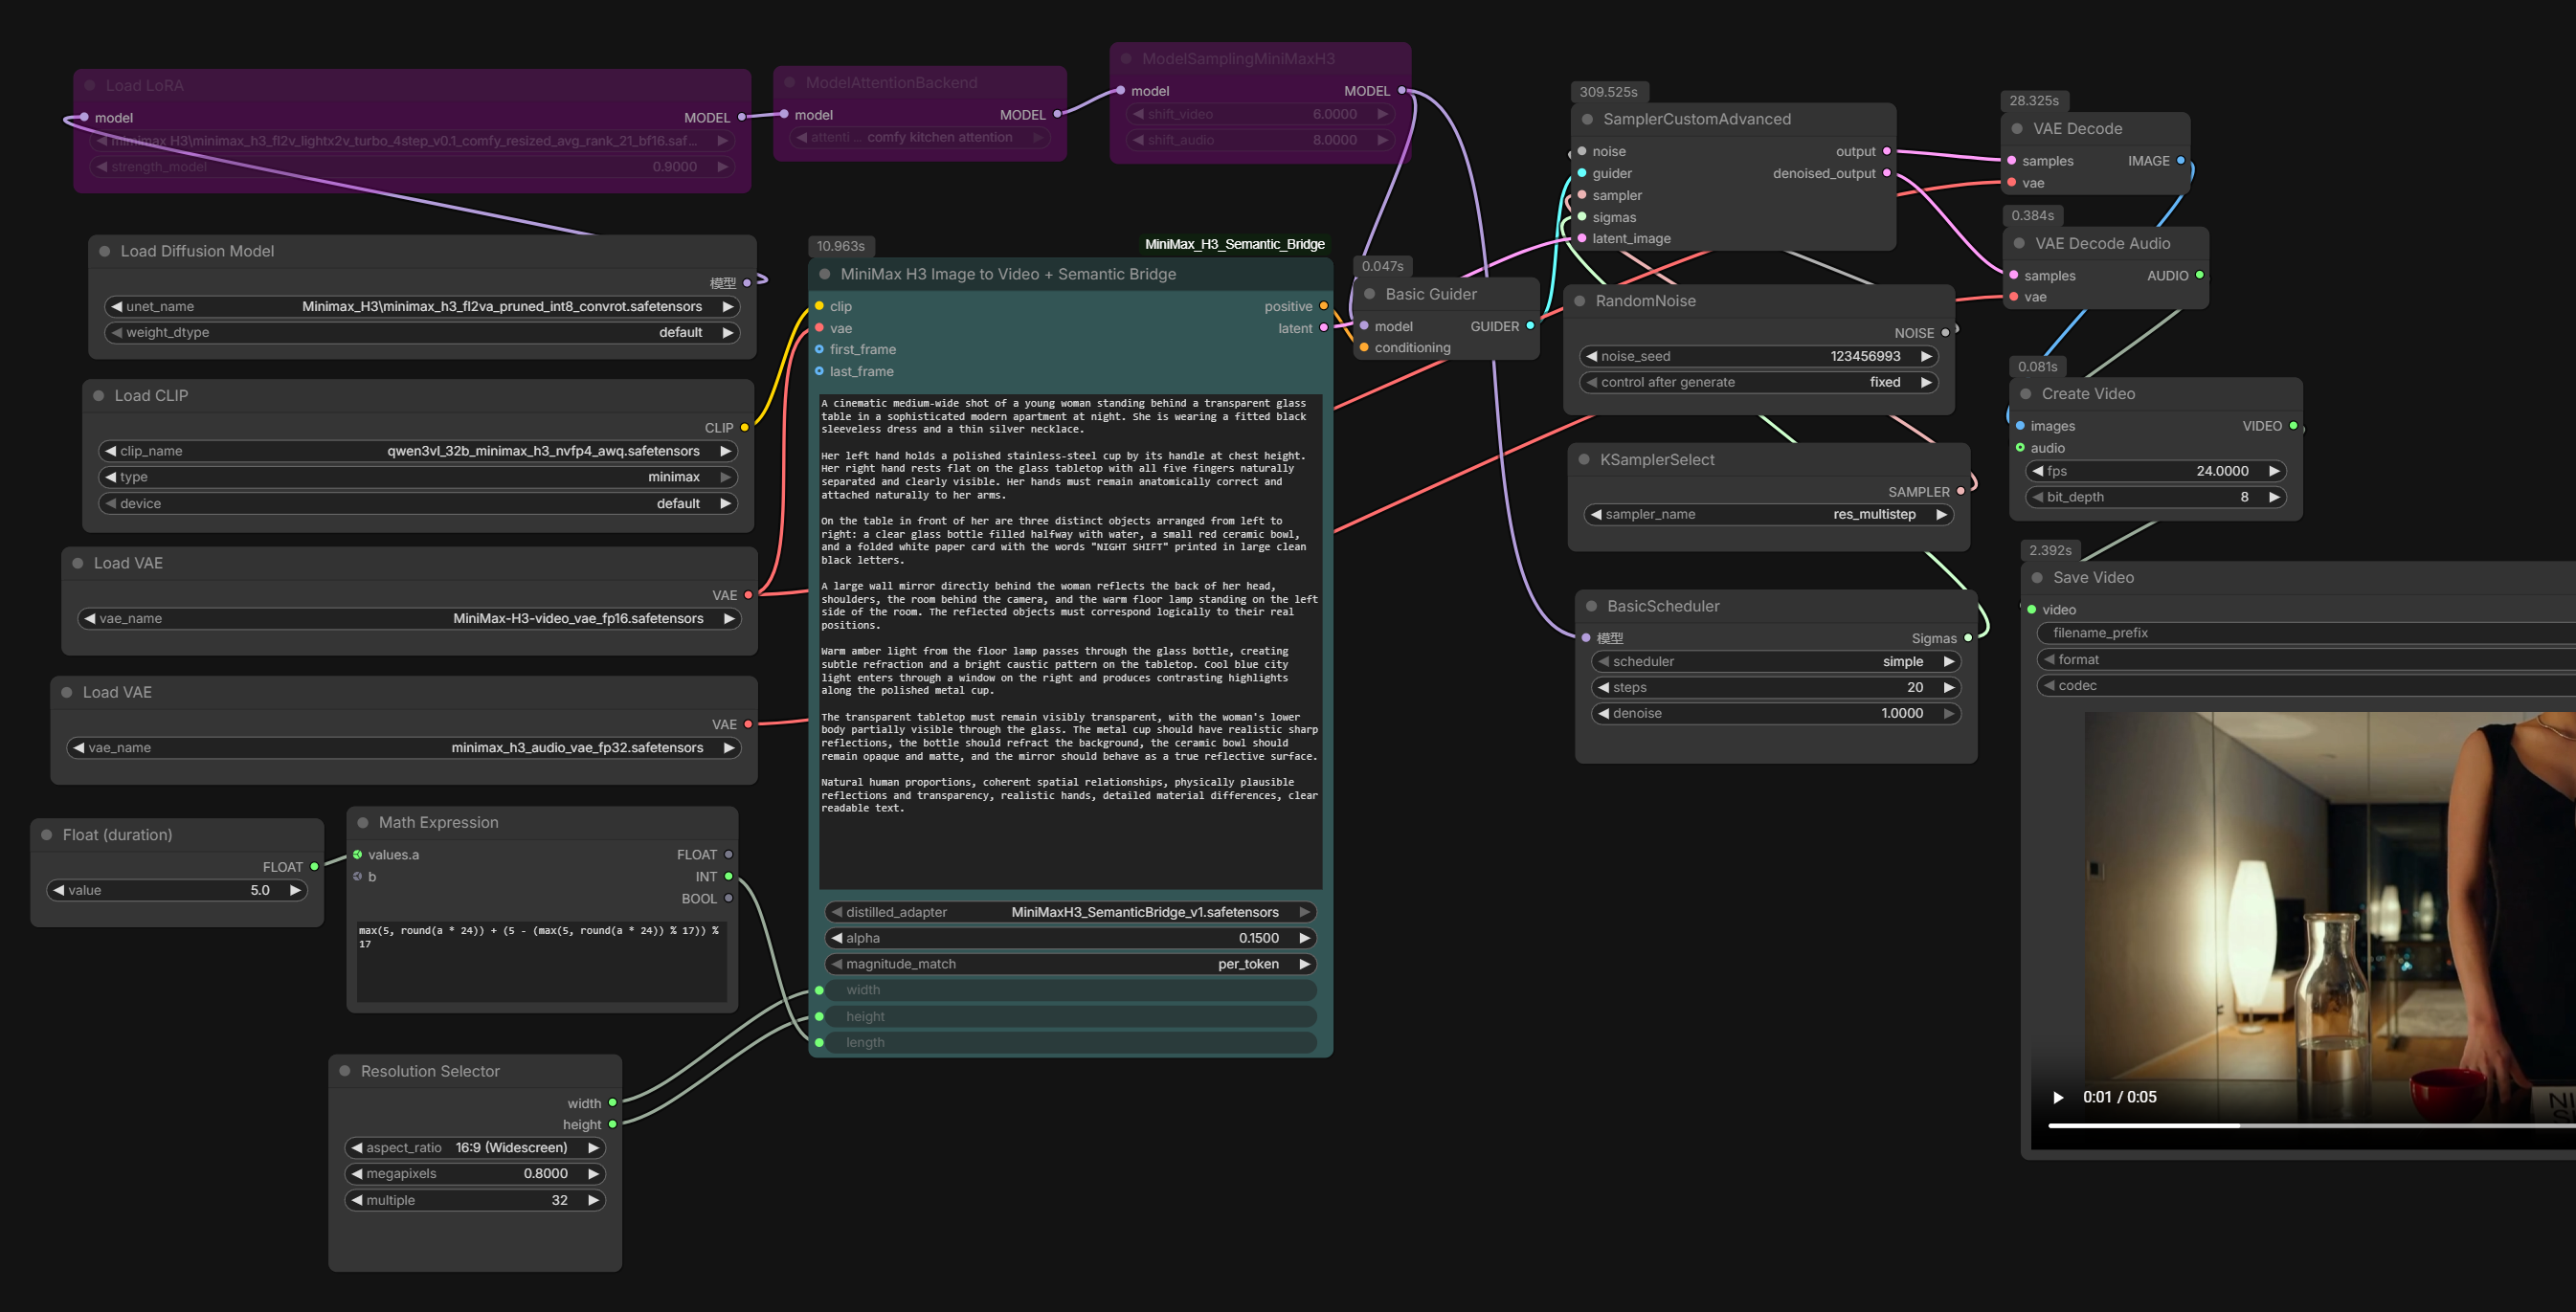
独立した蒸留プロジェクトが、SenseNova U1.5 のセマンティクスを MiniMax H3 の条件付け空間に転送し、ComfyUI ノードと例付きワークフローを含む 11MB のスタンドアロンアダプターを提供します。
minimax-h3-community-license-agreement
 テキスト→動画
minimax_h3_fl2v_turbo_4step_v1.2_768p_comfyui_bf16.safetensors のダウンロード:LightX2V の 4 ステップ MiniMax H3 Turbo 更新。よりクリーンで安定した音声生成を実現。
 テキスト→画像
InclusionAI が 6B 統合型生成・編集モデル「LLaDA-Image」をリリース。4 ステップの Turbo バリアントと、INT8/GGUF 重みを持つコミュニティ製 ComfyUI ノードパック付き。
 画像→動画
minimax_h3_ref2v_turbo_8step_v1.0_comfyui_bf16.safetensors のダウンロード:Lightx2v の MiniMax H3 向け 8 ステップ 768p 参照から動画(Ref2VA)蒸留、音声付き、更新済みの例ワークフロー付き。
 テキスト→画像
ComfyUI に 2 つの公式 Meta Muse Image API ノードが追加されました:テキストから画像へ生成と画像編集。最大 10 枚の入力画像、14 アスペクト比、推論強度制御に対応。
 テキスト→画像
ComfyUI の Recraft ノードが Create Style ノードに V4 Styles および Styles プロモデルを追加し、カスタムトレーニング済みスタイルをスタイル参照ワークフローと組み合わせて、一貫したブランディングを実現します。
 テキスト→画像
capitan01R の Krea2T Enhancer は、Krea 2 の DiT アテンション内で個々のプロンプトフレーズの強化または抑制を可能にする新しいアテンション重み付きフレーズノードを追加しました。