SnapRef: ComfyUI の Anima 向けキャッシュKV参照アダプター
SnapRef v1a は、アテンションのキーとバリューをキャッシュすることで、1枚の参照画像から Anima のキャラクターを維持し、1画像あたり8.9秒で生成します。ComfyUI ノードと FP8 ウェイトも含まれます。
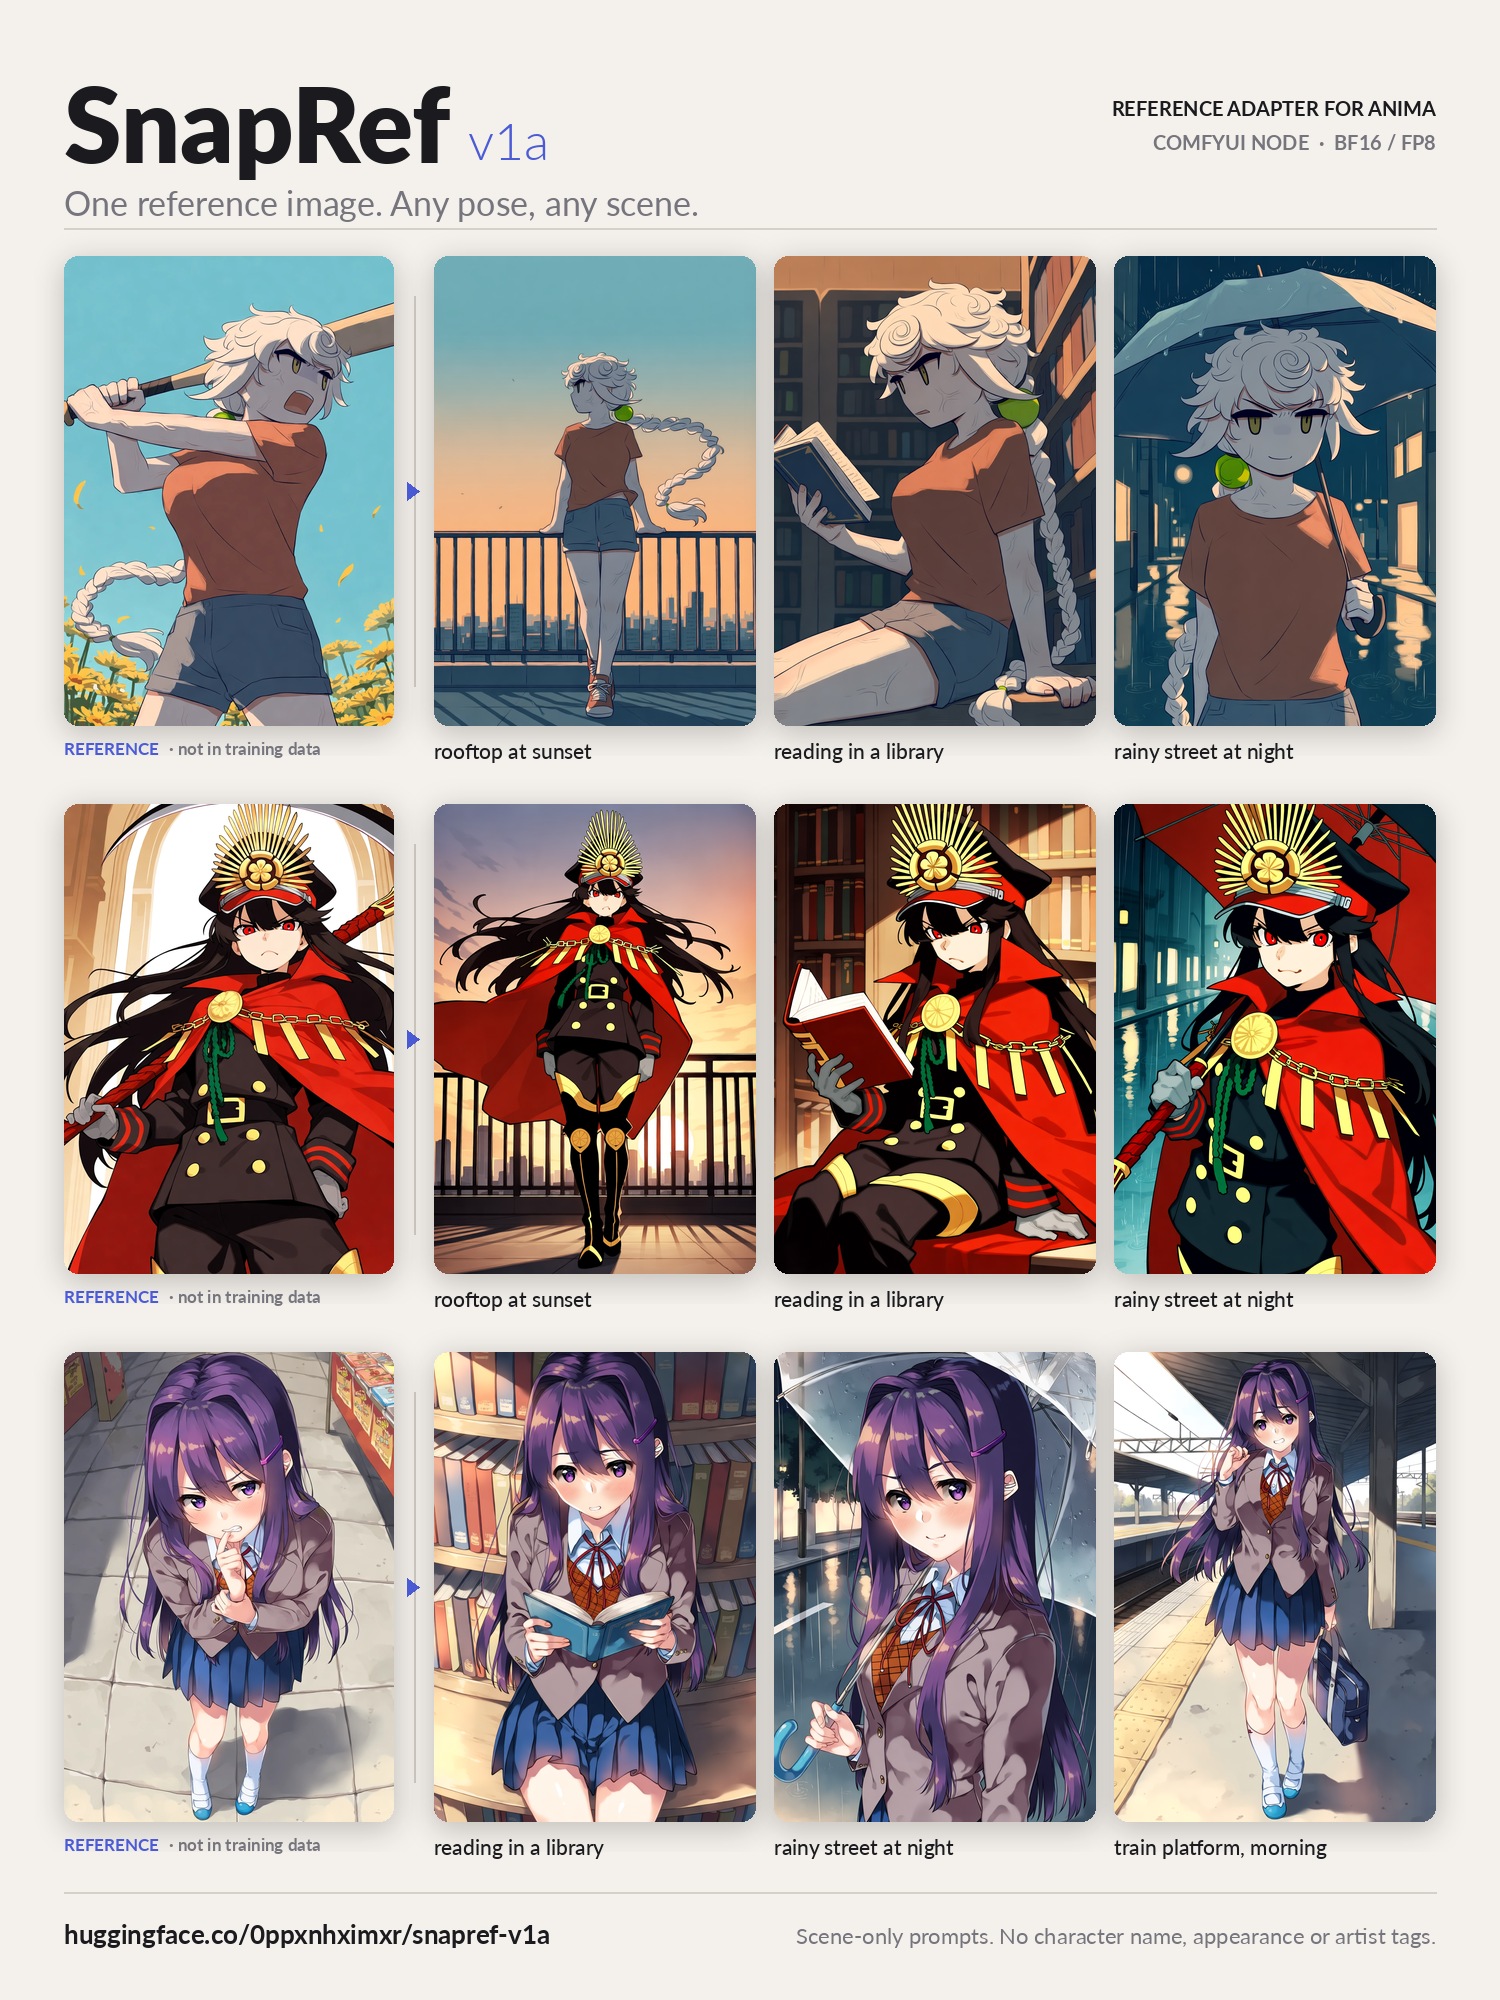
参照画像は1枚、プロンプトはシーンだけを指定。
Anima はタグプロンプトで動くモデルなので、通常キャラクターを再現するには髪、目、衣装をプロンプトに書き並べる必要があり、しかもモデルがすでに知っているキャラクターに限られます。参照アダプターはその役割を画像に移します。テキストがポーズ、構図、場所を扱い、参照が誰を描くかを扱います。
このアイデアは Anima で新しいものではありません。Anima Reference Adapter は10月27日に、参照をオフセットした2番目の潜在フレームとして追加することで実現し、動画風の事前分布がそれを1ショットとして続けないようにしました。SnapRef は別の道を取ります。参照をモデルに一度通し、各レイヤーが出力するものをキャッシュし、そのキャッシュをサンプリングの各ステップで読み直します。
参照がキャッシュされる仕組み
アダプターファイルは、1つのキー anima_ref_kv/1 の下にまとめられた2つの LoRA 分岐です。全28ブロックの self-attention、cross-attention、両方の MLP レイヤーに適用される rank-128 の参照分岐と、ターゲット側の self-attention に適用される rank-64 の分岐です。合計すると190.8M パラメータで、bf16 では382 MB になります。
参照は一度エンコードされ、固定されたトークン群として保持されます。モデルの座標空間上で独自の位置を持つため、モデルはレイアウトをコピーするのではなく外観を読み取る形になります。サンプリング中、各レイヤーは自身のトークンとキャッシュされた参照にアテンションを向けます。ターゲット側の LoRA はすべてのターゲット順伝播で有効なままで、デフォルトではポジティブ CFG 分岐のみが参照を読み取ります。ref_guidance を指定すると両方の分岐に送られます。参照はステップごとに再エンコードされないため、モデルカードでは参照なし生成に対して約15%のコスト増とされています。
2つのモードが用意されています。cs はキャラクターとスタイルをまとめてコピーし、char はキャラクターのみをコピーするため、アーティストタグでスタイルを設定できます。別の ref_guidance 経路は、約1.4倍の時間でより強く参照へ寄せます。色の彩度が上がりすぎるのを防ぐため APG または CFG rescale を使用し、これは以前のアダプターでも必要だった同じ補正です。
他の手法と比べたコスト
リポジトリには comparison_summary.json が含まれています。A100、832×1216、28ステップ、各アダプターをそれぞれのデフォルト設定で同一ケースを計測した時間表です。
| 手法 | 1画像あたりの秒数 |
|---|---|
| SnapRef v1a | 8.95 |
| ElectronGirl v2 | 14.36 |
| Role-Ref-KV | 12.53 |
| Anima Base、参照なし | 7.72 |
同一性については、モデルカードによると、トレーニングから外したキャラクターにおいて、アダプターは正しい参照を使った方が誤った参照よりもうまくターゲットを予測し、ホールドアウトのデノイズ損失で0.0041の同一性ギャップがあるとのことです。ケースごとの数値は heldout_loss.json にあります。
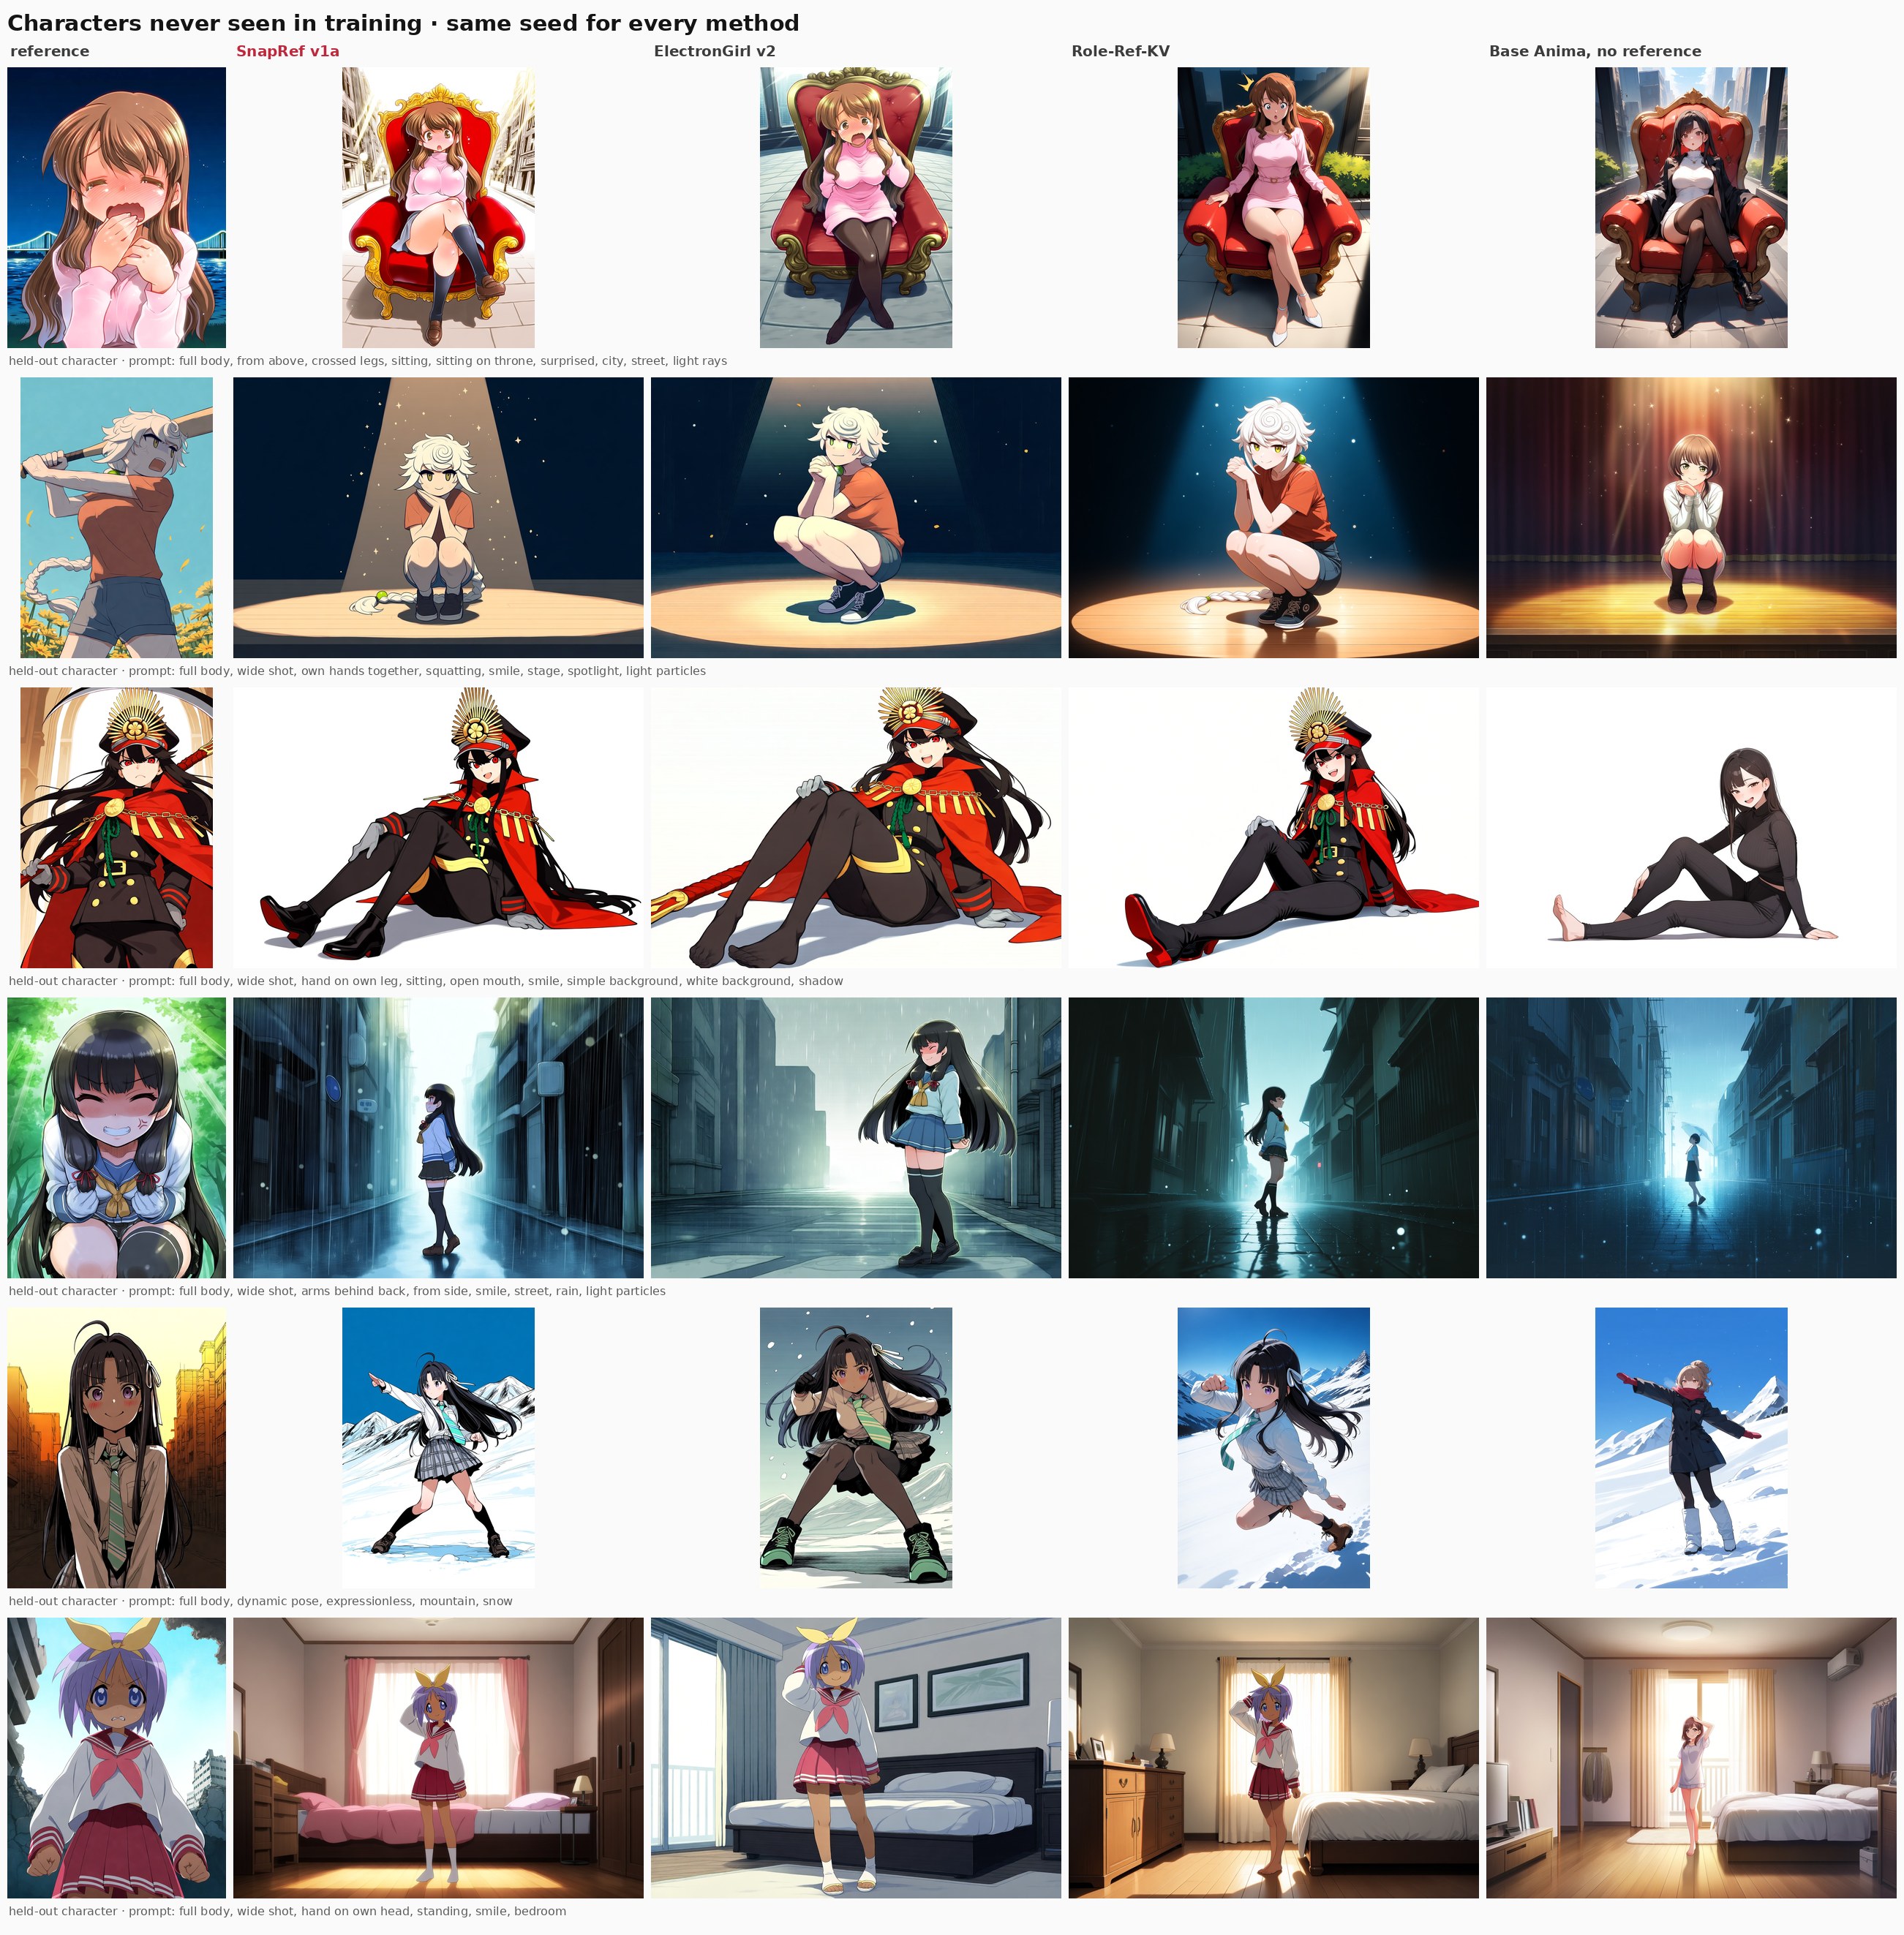
トレーニングに含まれないキャラクター。プロンプトはシーンだけを指定し、髪、目、衣装は参照から取得されます。
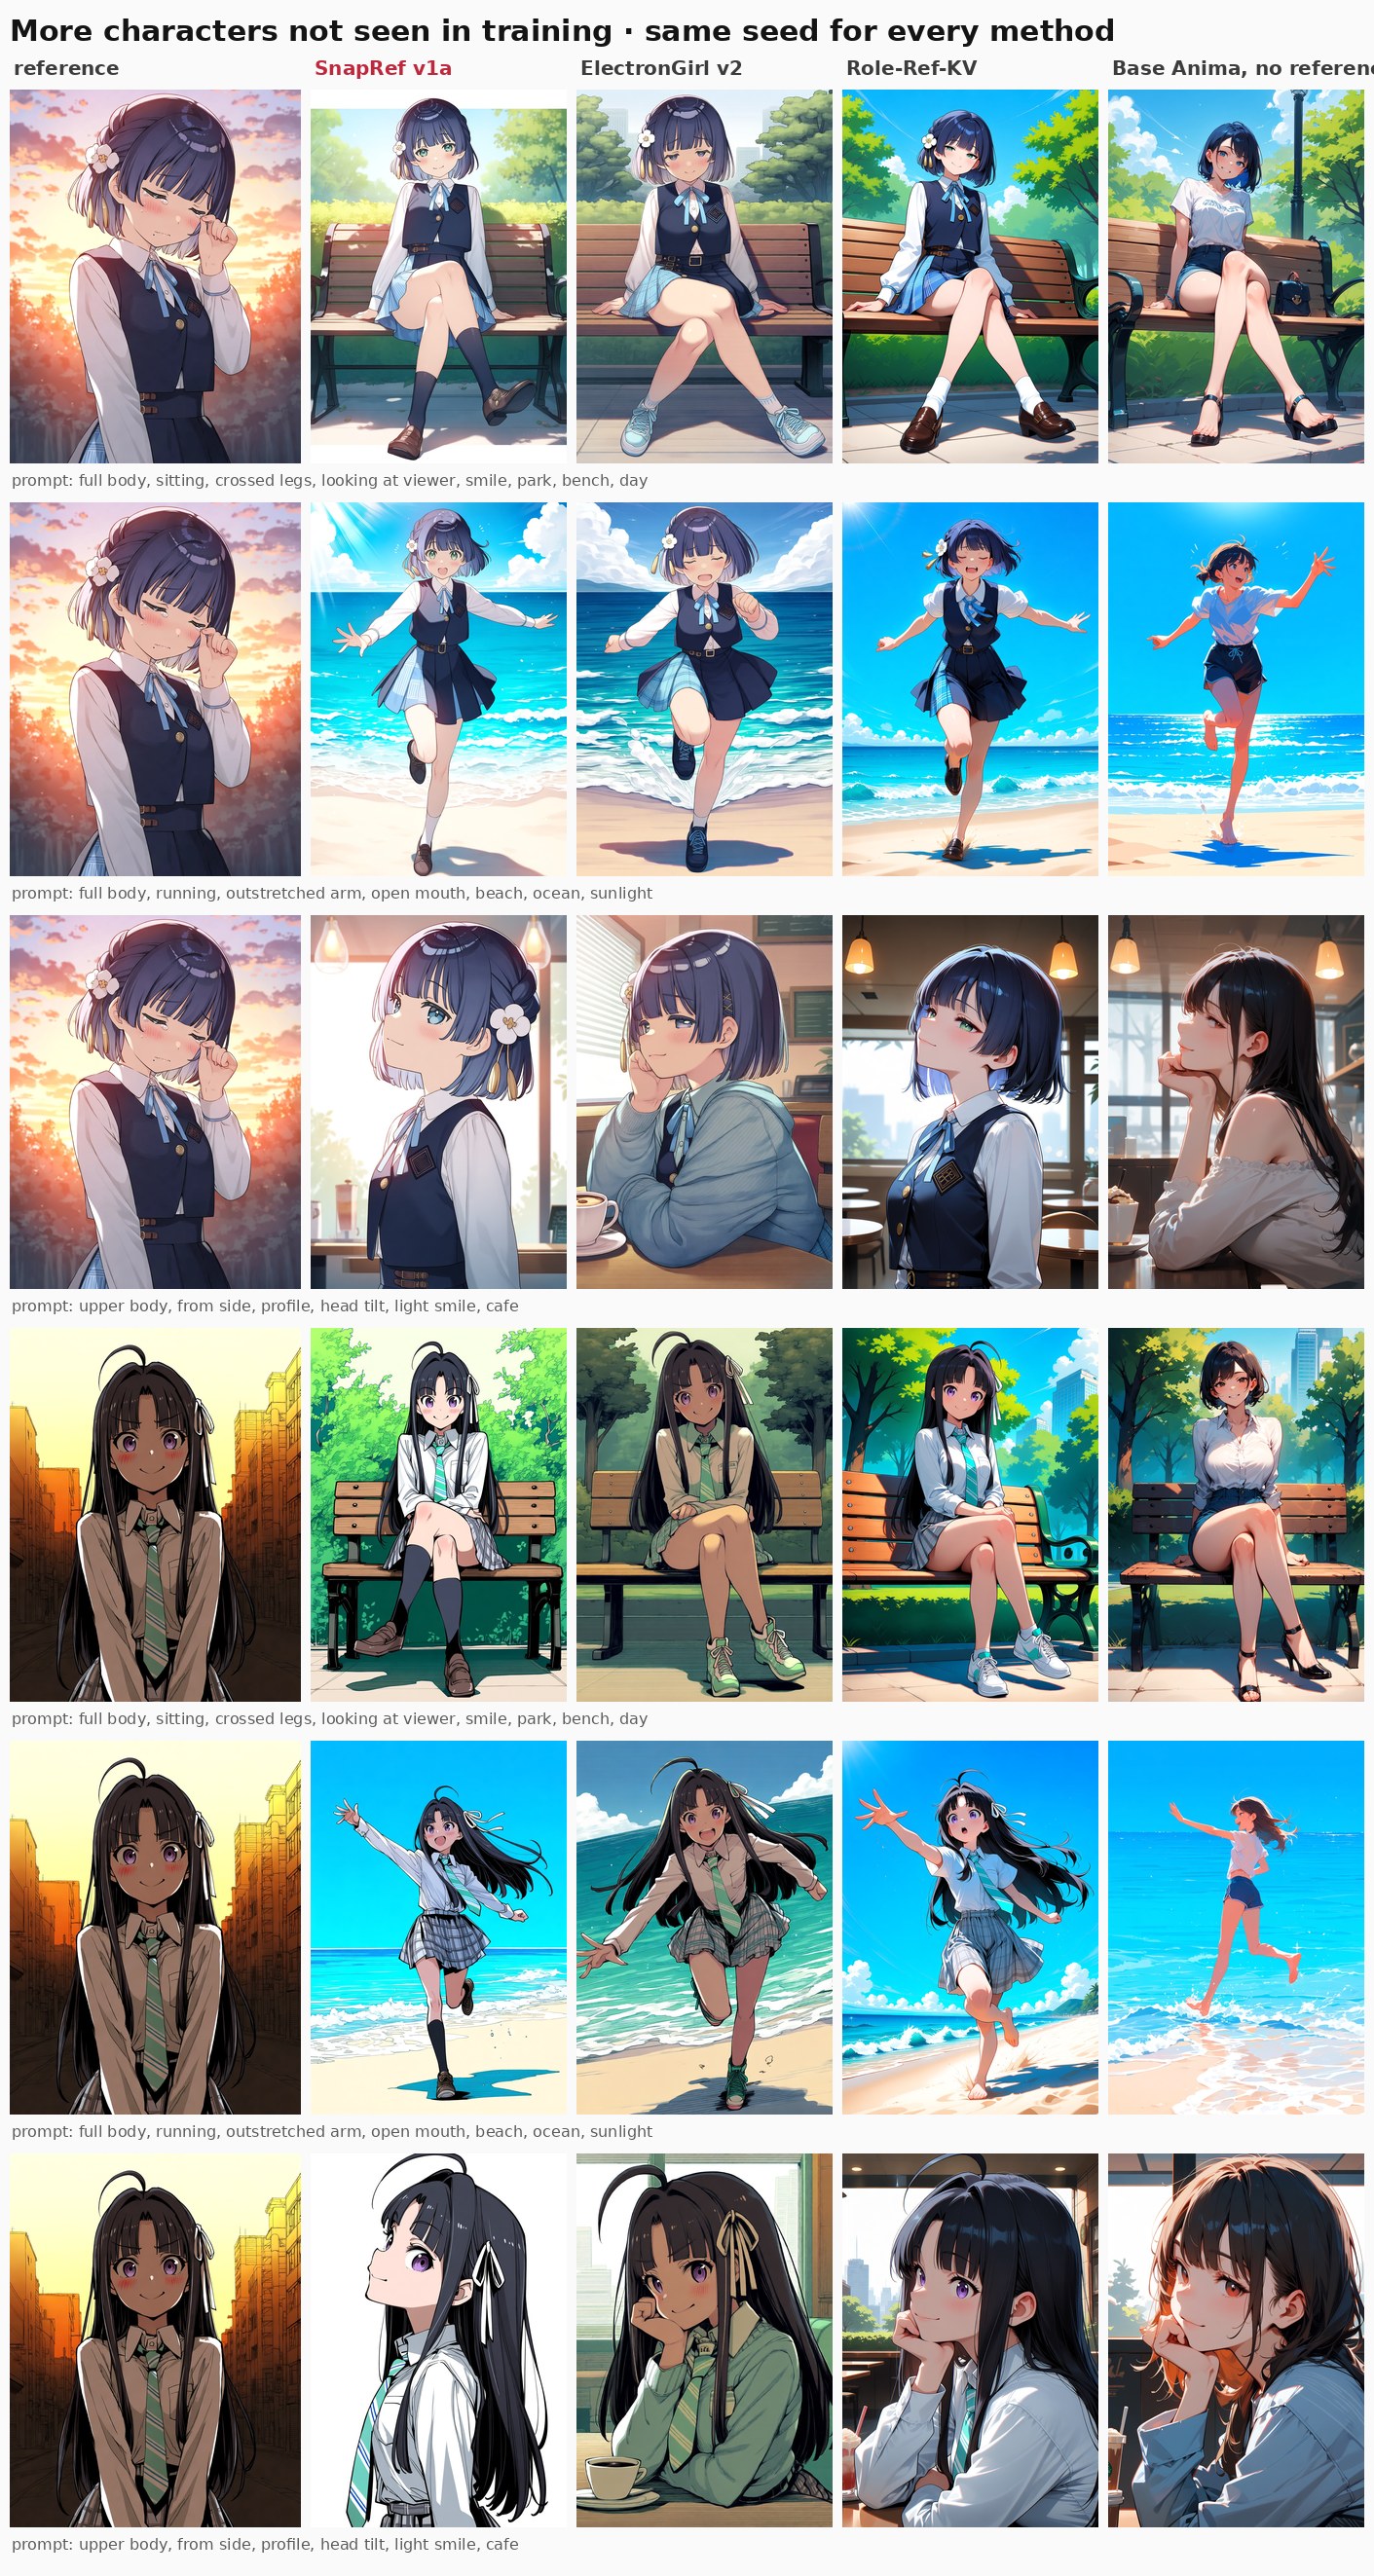
トレーニングセット外の参照をアダプターに通した結果。
トレーニングデータは Anima 自身が生成したものです。2,367キャラクターにわたる58,300枚の画像で、各キャラクターは1つのアーティストスタイルでさまざまなシーンとポーズに描かれ、その後およそ120 H100 GPU 時間の実行が行われました。2つ目のチェックポイント SnapRef v1b は LoRA の rank を2倍にし、プロンプトへの追従性を高めつつ、キャラクターの保持性能はほぼ同程度です。
ComfyUI 側
ノードパックはリポジトリ内の comfyui/snapref/ にあります。custom_nodes/ にコピーし、アダプターを models/loras/ に置き、LoRA ローダーではなく SnapRef ノードで読み込みます。2つの分岐は通常の LoRA ではないためです。シンプルなノードは画像を1枚または2枚、モード、strength、fidelity を受け取ります。高度な機能のノードはそれ以外のすべてを公開し、ref_in_uncond、ref_megapixels、ref_caption なども指定できます。
5つのワークフローが含まれています。単一キャラクター、2キャラクター、1キャラクターの複数参照、他のアダプターとの並列比較、そして以下の最小構成です。2キャラクターの場合は、中核の Image Stitch ノードで2つの参照を結合し、プロンプトでどちらが左でどちらが右かを記述するよう指示されています。推奨サンプリングは euler または er_sde に simple を組み合わせ、28〜30ステップ、CFG 4.5です。
FP8 アダプターは382 MB ではなく195 MB で、FP8 の Anima ベース上でも含め、実用上ほぼ同じ画像が得られると報告されています。このノードは10月31日に更新され、参照のエンコードを fp32 で保持するようになりました。fp16 チェックポイント、--fp16-unet、または fp16 累積を伴う --fast を使用すると、以前のバージョンでは NaN と黒い画像が発生していました。
うまくいかない場合
モデルカードは失敗モードを隠さずに列挙しています。イヤリング、細かい模様、傷跡のような非常に小さな詳細は簡略化されることがあり、肌の暗い参照は明るく出力されることがあり、一部の屋外全身プロンプトでは地面を指定しない限りフレーム下部が単調な白い床になることがあります。シーンが参照の衣装を上書きすることがあり、ビーチのプロンプトでは水着が返ります。strength を上げるか衣装を指定すれば維持されます。2キャラクターの場合、参照が明確に示していない属性、たとえば閉じた目などは、両者の間で混ざることがあります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。