Anima Reference Adapter: 1枚の画像から新しいシーンを生成するComfyUIガイド
Anima Reference Adapterは1枚の画像からキャラクターとその画風を保ち、ポーズと背景はプロンプトで指定します。rank-32 LoRAと3つのComfyUIノードで構成されます。
タグプロンプトで動かすアニメモデルは、プロンプトにすべての特徴を書き出した場合にのみ、指定したキャラクターを描けます。しかもモデルがすでに知っているキャラクターに限られます。参照アダプターはその役割をテキストから取り上げます。画像を1枚指定すれば、プロンプトはポーズ、構図、場所の記述に専念できます。
動画モデルから流用された参照条件付けのほとんどは、そのような役割分担を実現しません。ComfyUI-Cosmos-Reference は参照潜在をクリップの追加フレームとして付加します。これは編集には有効ですが、ビデオプライアがそのフレームを前のショットとして解釈するため、参照のポーズやレイアウトもコピーしてしまいます。Anima Reference Adapterが求めるのは逆です。誰を、どのように描くかは保ち、どこで、どんなポーズでは捨てます。
参照の組み込み方
AnimaはCosmos-Predict2 MiniTrainDIT上で動作します。28ブロック、幅2048、16ヘッド、16チャンネルのWan 2.1 VAE潜在に対する2×2空間パッチを持ち、Qwen3-0.6Bテキストエンコーダとshift 3のフローマッチングを備えます。これにより(t, h, w)に対する3D回転位置埋め込みが得られ、アダプターはこれをてことして利用します。
参照画像は出力解像度にレターボックスされ、一度だけVAEエンコードされ、2番目の潜在フレームとして付加されます。単純な動画スタイルの参照との違いは3点です。
- クリーンな参照フレーム。 参照フレームはタイムステップ0で、ターゲットフレームはσで入力されます。参照側には一切ノイズが加えられません。
- オフセットRoPE。 参照フレームの高さ座標はターゲットのグリッドを越えるようにシフトされます(ターゲットの高さ1つ分に、トレーニング中の小さなジッターを加えた値)。これによりピクセル単位の対応関係は残らず、モデルが参照をショットの続きとして扱うことはできません。
- 学習済みの読み取り機構。 各ブロックのセルフアテンション、クロスアテンション、両方のMLPレイヤーにα = 32で適用されたrank-32 LoRA(280モジュール、45.9Mパラメータ)が、そのずらされたフレームを読み取ることを学習します。フォワードフック経由で、参照を伴うモデル呼び出しの間だけ適用されるため、読み込まれたベースモデルは参照なしのパスも実行できます。
ガイダンスも分離されています。参照が両方のCFGブランチに入ると、増幅されるのはテキストだけになります。そこでガイダーはテキストと参照のスケールを別々に使い、ref_guidance が cfg に触れずに結果を参照へ近づけられるようにします。参照ガイダンスが高いと彩度が飽和するため、ノードは適応的投影ガイダンスまたはCFGリスケールのいずれかを上乗せで適用します。
ホールドアウトしたキャラクターが示すもの
トレーニングデータは合成データで、Anima自身によって生成されています。1キャラクター1スタイルの600グループについて、それぞれ6枚のレンダーを、構図、カメラ、ポーズ、表情、背景、ライティングを独立にサンプリングして作成しました。合計3,600枚、300キャラクター・427アーティスト分を、1台のRTX PRO 6000 Max-Qで4.25時間かけて生成しています。12キャラクターは完全にホールドアウトされました。残り576グループから17,280組の順序付き参照-ターゲットペアが作られ、その70%ではターゲットプロンプトから外観と衣装のタグがすべて削除されました。
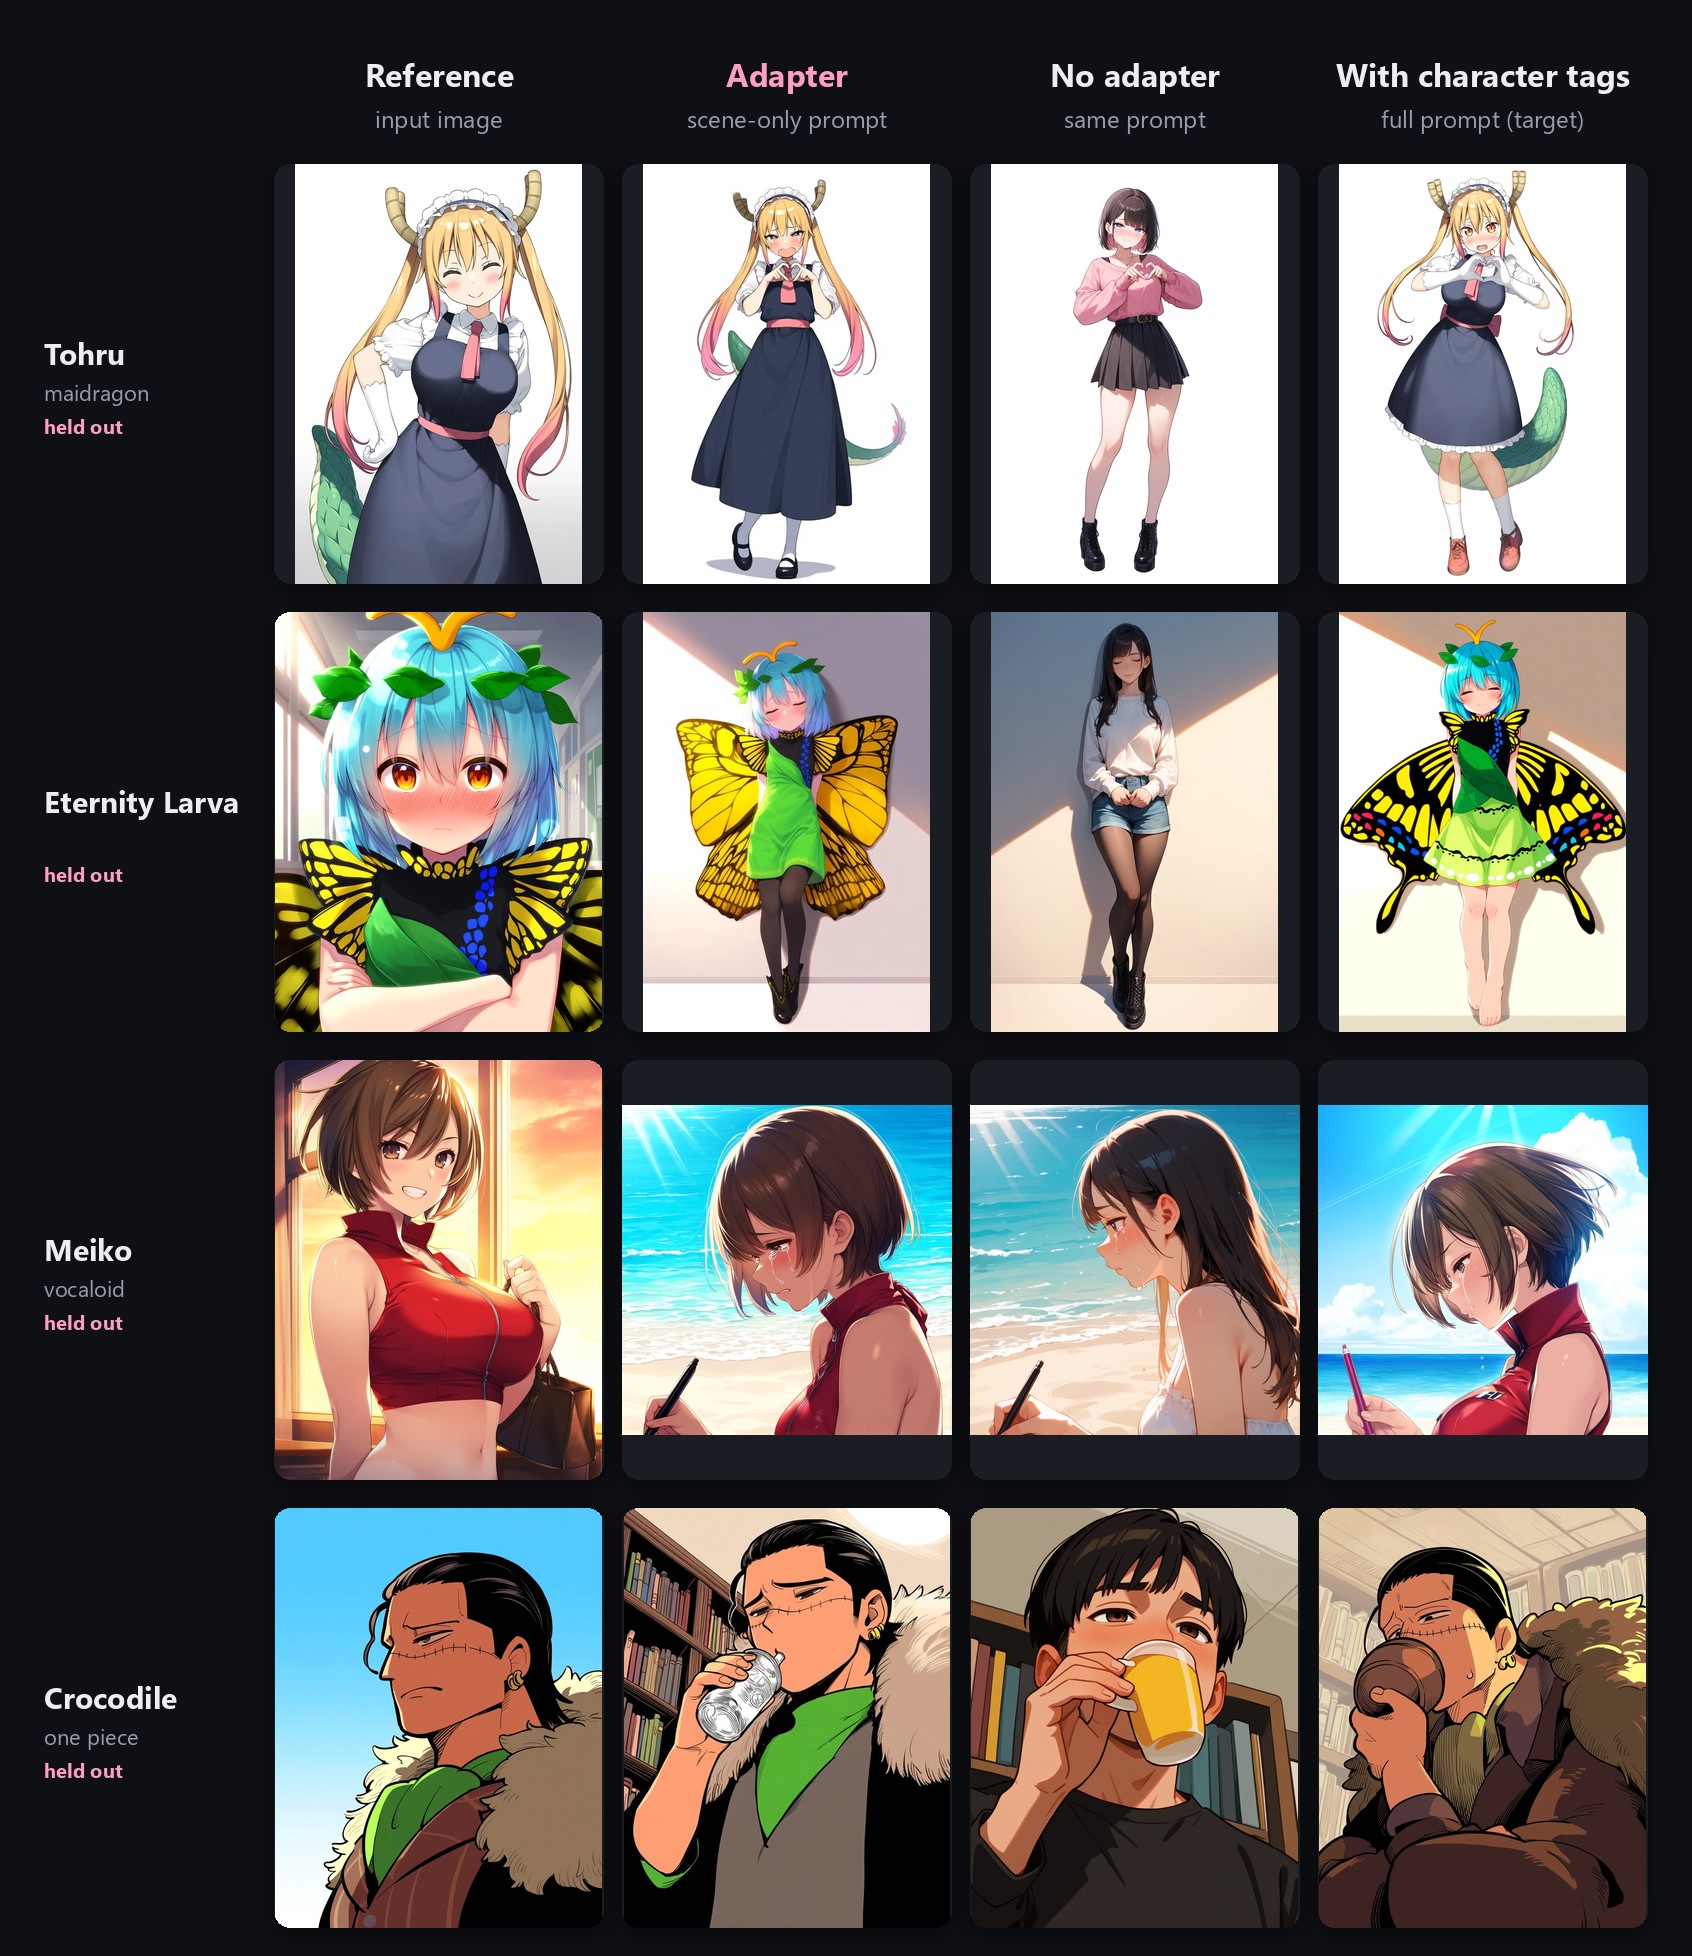
トレーニングで一切見ていないホールドアウトキャラクター。各行:参照、シーンのみのプロンプトでのアダプター、アダプターなしの同じプロンプト、外観タグをすべて付けてキャラクター名を指定したベースモデル。
18件の評価ケース全体で、アダプターは髪色と髪型、瞳の色、衣装、そして角や尻尾、天使の輪、蝶の羽、メイドのヘッドドレスといったトレードマークの小物を再現しました。一方、素のベースモデルに同じシーンのみのプロンプトを与えると、汎用的なキャラクターが返ってきました。ポーズ、構図、背景はすべてのケースでプロンプトに従い、ポーズのコピーは見られませんでした。
ホールドアウトセット以外でも、2つの一般的な参照が同じ役割分担を示しています。
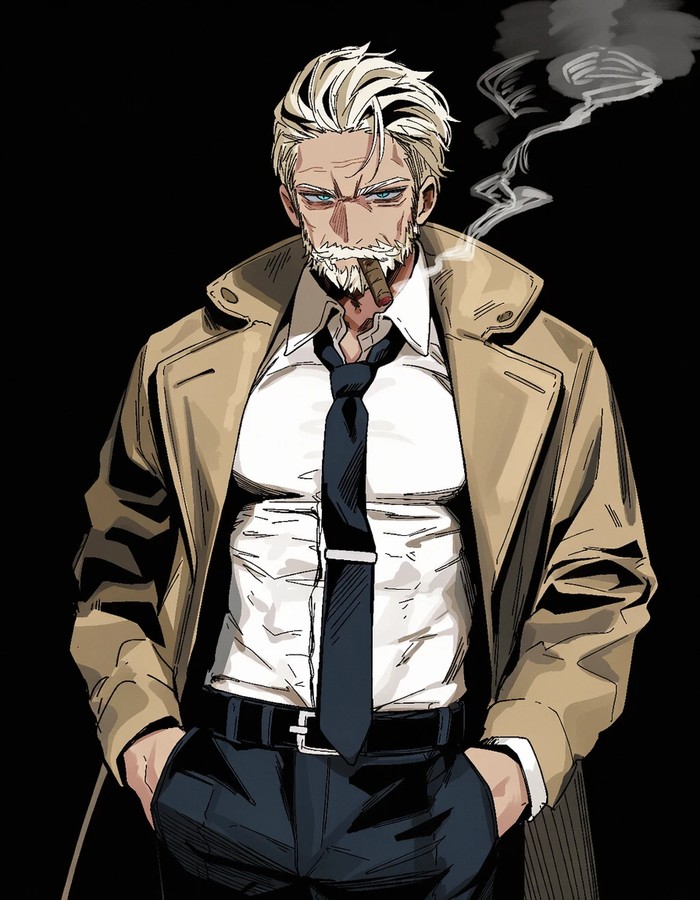 | 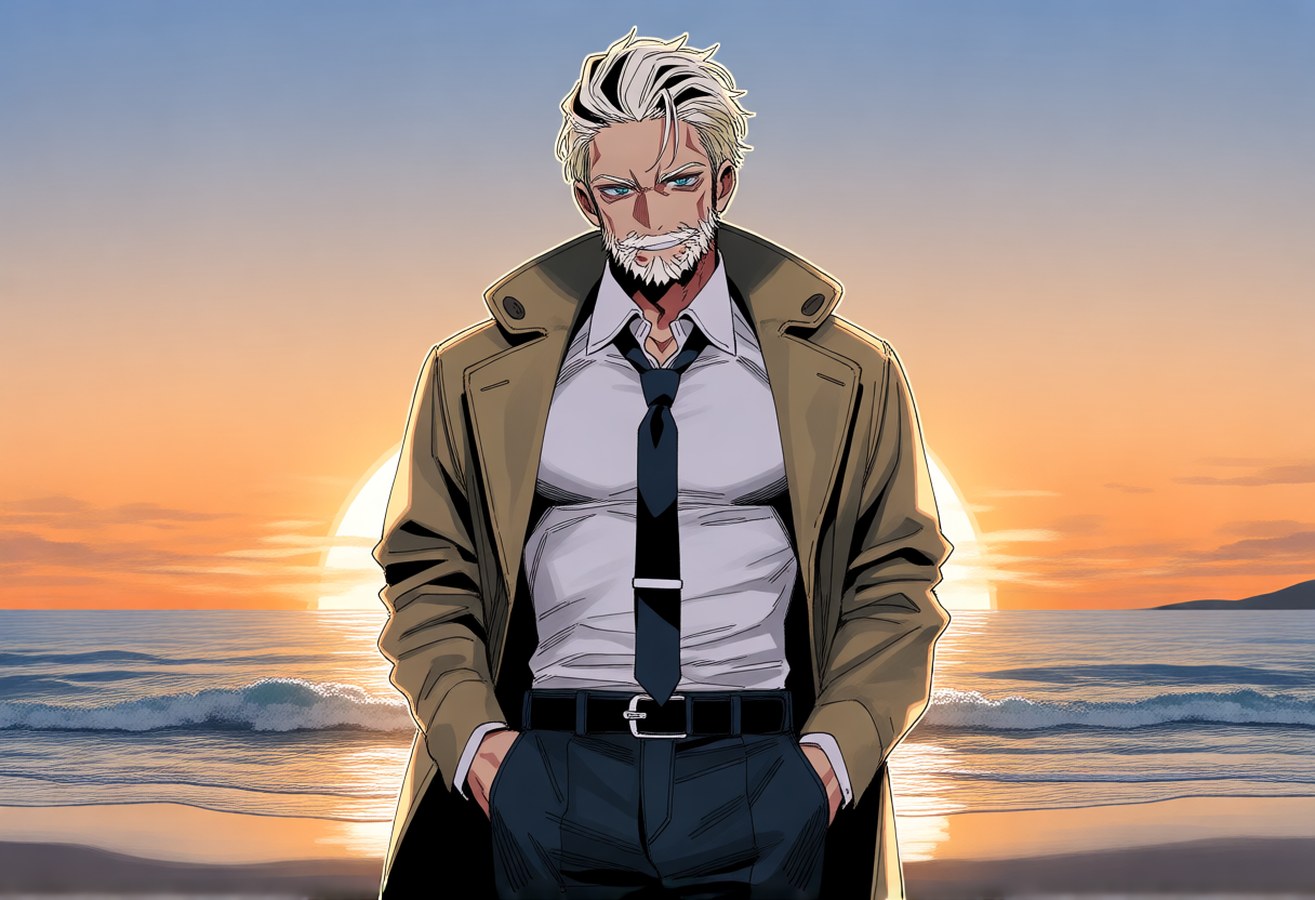 |
|---|---|
| 参照A:アダプターに与えた唯一の画像 | cowboy shot, looking at viewer, smile, beach, ocean, sunset |
プロンプトにはキャラクター名、アーティストタグ、外観タグは含まれていません。推奨設定はEuler、28〜30ステップ、simple、テキストCFG 4.5、参照ガイダンス4.5〜6とAPG、bf16計算です(Animaはfp16でオーバーフローします)。
スタイルは弱い側面
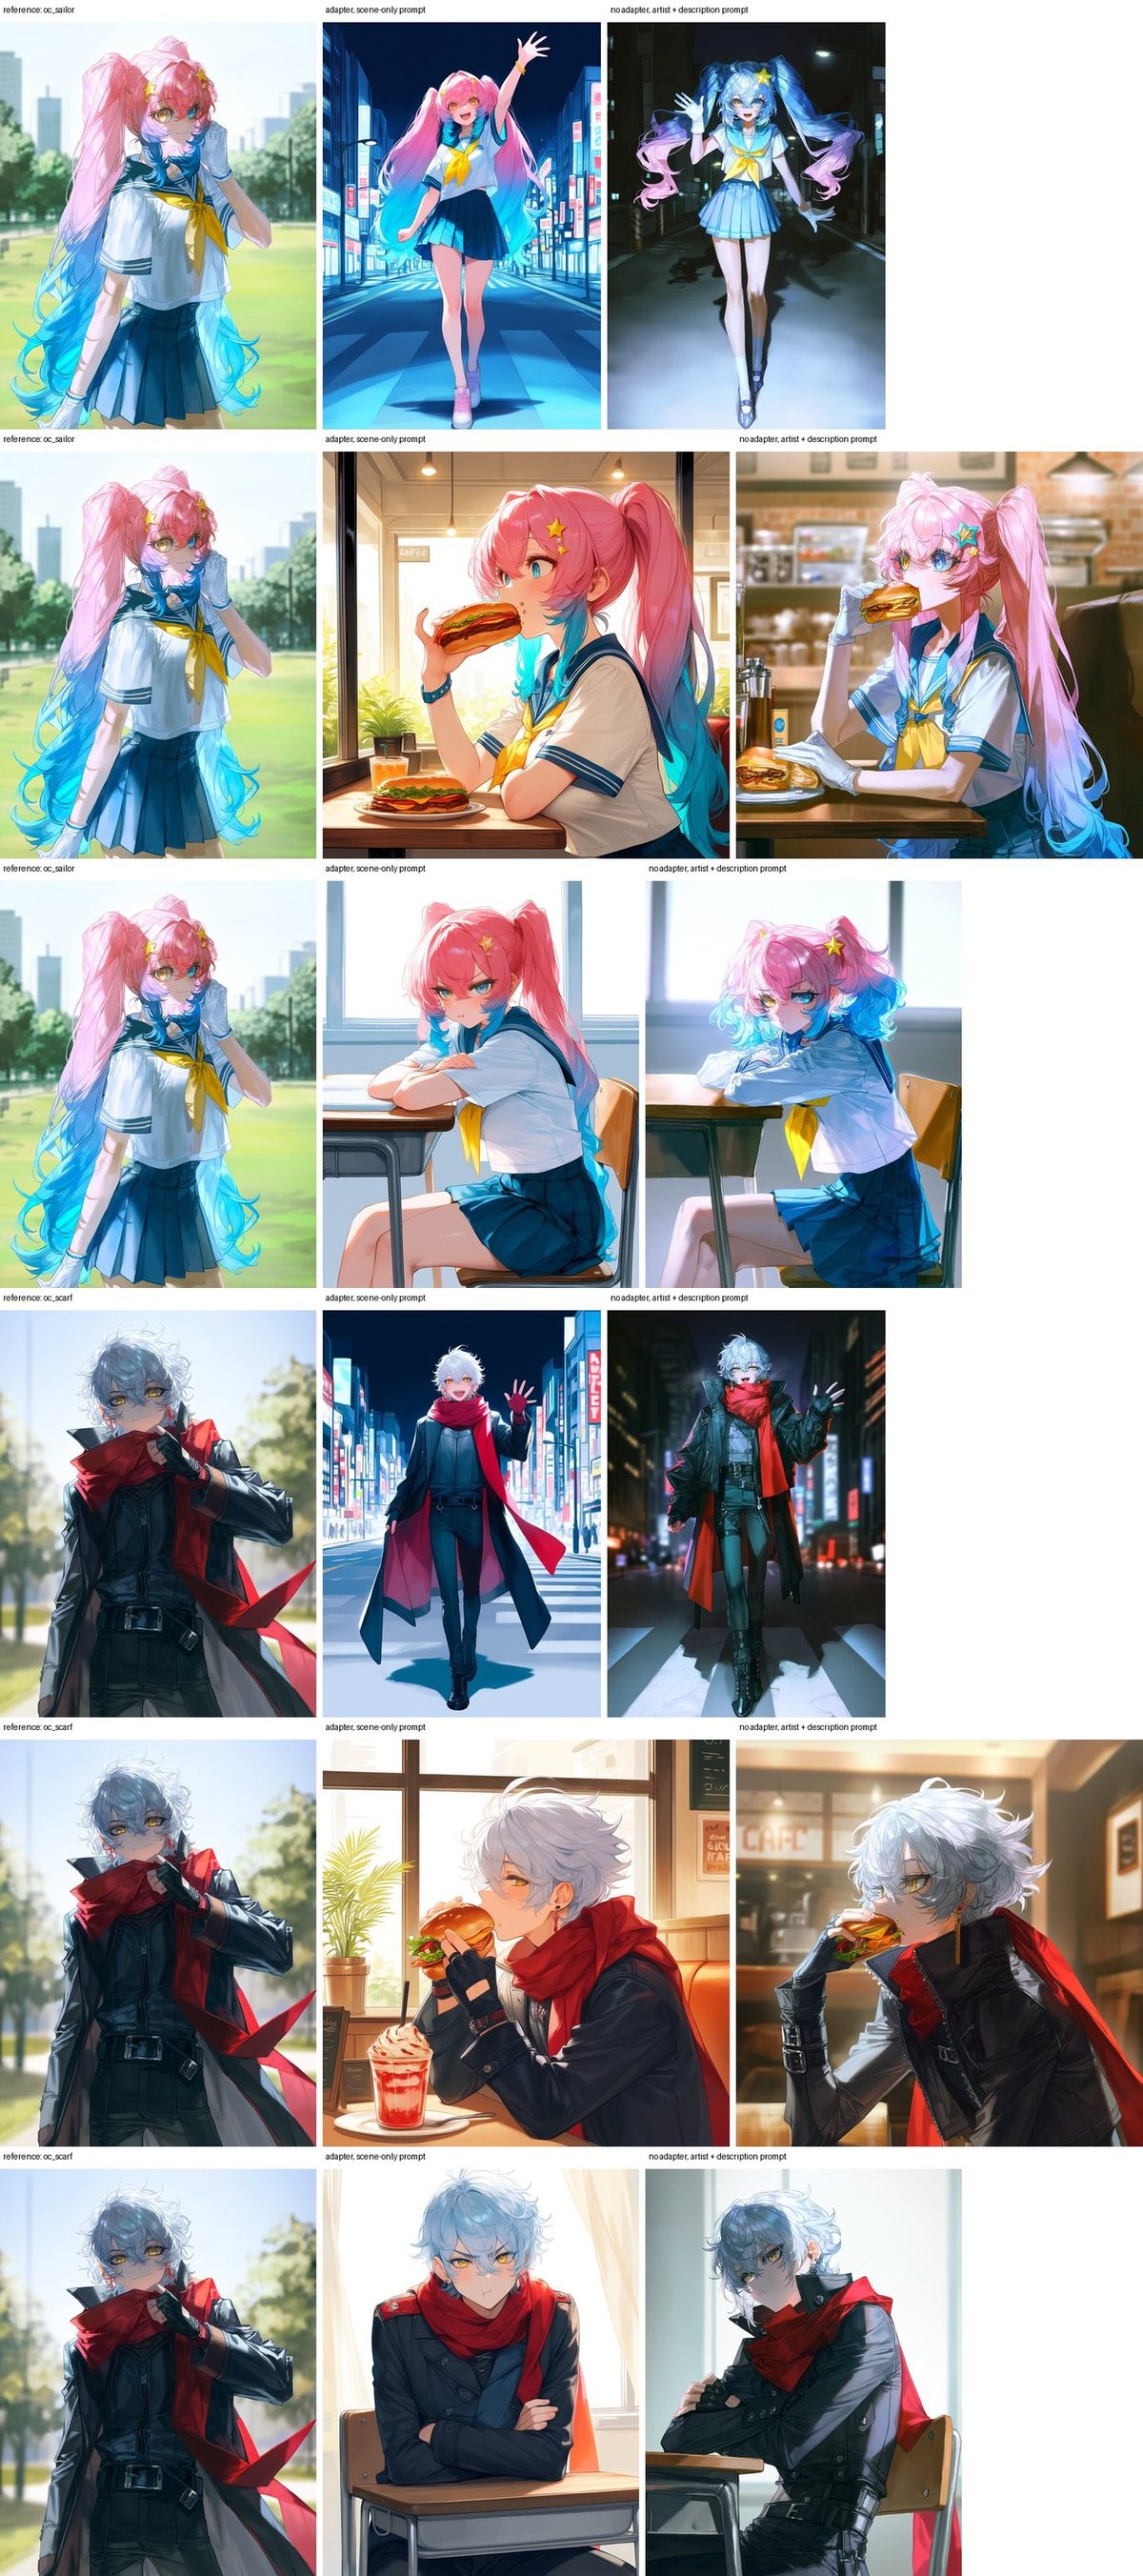
トレーニングに一切登場しなかったアーティストタグを使ってベースモデルが描いたオリジナルキャラクター。各行:参照、シーンのみのプロンプトでのアダプター、アーティストタグと説明タグを付けたベースモデル。
キャラクターデザインはよく転写されます。グラデーションのツインテール、星の髪飾り、ネッカチーフ、赤いマフラーと手袋を合わせた銀髪などです。一方、アーティストの絵画的な描き込み、柔らかなライティング、落ち着いた配色は参照ガイダンス1では伝わらず、出力はよりくっきりした既定のAnimaの見た目に戻ってしまいます。
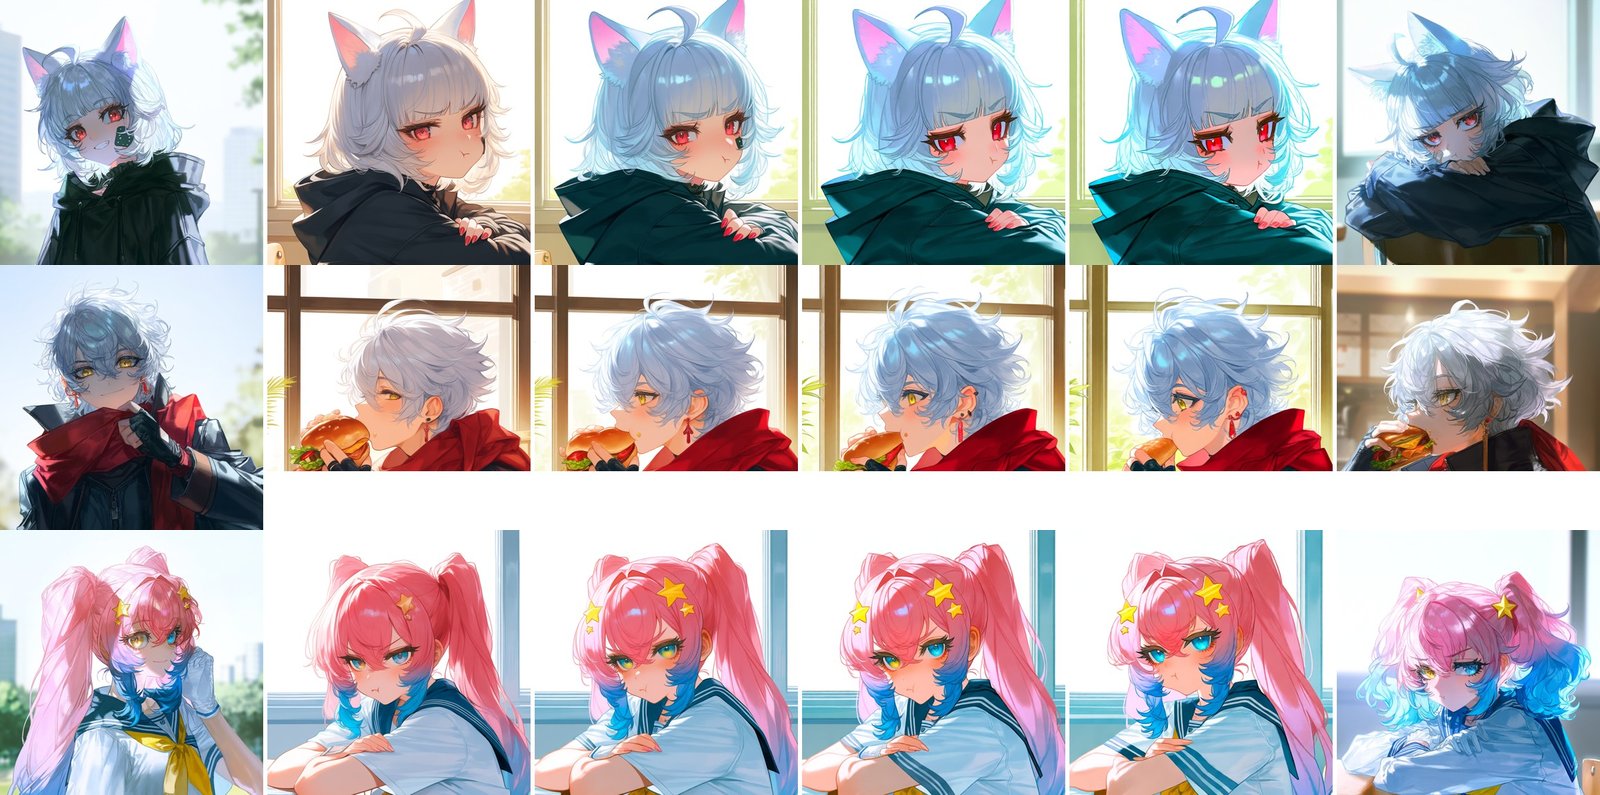
参照ガイダンス1、2.5、4.5、6のクロップを参照と並べ、右端にフルタグ付きのベースモデルを置いたもの。
参照ガイダンスを上げると、髪の質感とハイライト、瞳の描き込み、クールな配色、そしてガイダンス1では失われる絆創膏やオッドアイといった小さな小物が戻ってきます。約4.5を超えると色が飽和し、既存のドリフトが増幅されます。APGやリスケールの補正はそのためのものです。絵画的な描き込みは依然として現れず、報告ではこれを増幅不足ではなく、LoRAがそれをほとんど学習していないためとしています。作者は3つのアーティストスタイルで2,000キャラクターのより大きなセットを生成中で、キャラクター用とスタイル用の参照を分けることを計画しています。
ノード
| ノード | 機能 |
|---|---|
| Anima Ref Adapter Loader | アダプターLoRAをAnimaの MODEL に適用します。ref_offset_h はトレーニング時の値である1.0のままです。 |
| Anima Ref Latent | 参照を白パディングで出力サイズに合わせてエンコードし、その解像度の空の潜在も返します。 |
| Anima Ref Guider | SamplerCustomAdvanced 用の GUIDER で、テキスト cfg、ref_guidance、APGまたはリスケール補正、PAGなどのCFG後パッチを備えます。 |
残りはComfyUI本体が提供します。anima_baseV10.safetensors 用の UNETLoader、Qwen3-0.6Bエンコーダ用の CLIPLoader、Qwen-Image VAE用の VAELoader です。基本グラフは1つの SamplerCustomAdvanced 上で19ノードで動作し、2番目のワークフローではAnima Safe PAGを追加します。ref_guidance が1のときは参照が両方のCFGブランチに入り、各ステップのコストは通常のCFGステップと同じです。1を超えると各ステップでモデルが3回実行され、通常のCFGステップの約1.5倍になります。サンプルワークフローではComfyUI-KJNodesのPatch Sage Attentionも使いますが、これはバイパスできます。
制限事項
このパイロット版は300キャラクターで2,000ステップ、rank 32でトレーニングされており、作者はその代償を挙げています。すなわち、スタイルよりも同一性の方がはるかに良く転写される、絵画的なスタイルはほとんど転写されない、小さな模様、傷、イヤリング、珍しい肌の色はしばしば失われる、大きな衣装は色がずれることがある、参照キャラクターがシーン内のオブジェクトとして時折再登場する、といった点です。トレーニングペアはすべてAnimaのレンダーであるため、アダプターはベースモデルのバイアスを引き継いでおり、これまでの評価は定性的なもので、同一性やスタイルの類似度指標はありません。
入手方法
アダプターの重みはHugging Faceで anima_ref_adapter_pilot_r32.safetensors(約92 MB)として公開されており、ComfyUI/models/loras/ に配置します。ノードパックは ComfyUI/custom_nodes 内で git clone https://github.com/ElectronGirl/ComfyUI-Anima-Ref-Adapter.git を実行してインストールし、Anima base v1.0とそのQwen3-0.6Bテキストエンコーダ、Qwen-Image VAEが必要です。アダプターはベースモデルでトレーニングされているため、Anima turbo LoRAも通常のステップ数とCFGを使ってアダプターローダーの手前に読み込めます。
コメント
GitHubでサインインしてディスカッションに参加しましょう。