Prunaの6ステップQwen-Image 2.1 LoRA、公式ComfyUIパックを公開
PrunaAIのv0.2は6ステップのQwen-Image 2.1アダプタを2種類追加しました。うち1つはプロンプトアップサンプリングをLoRAに統合したもので、6つのワークフローを含む公式ComfyUIエクスポートも提供されます。
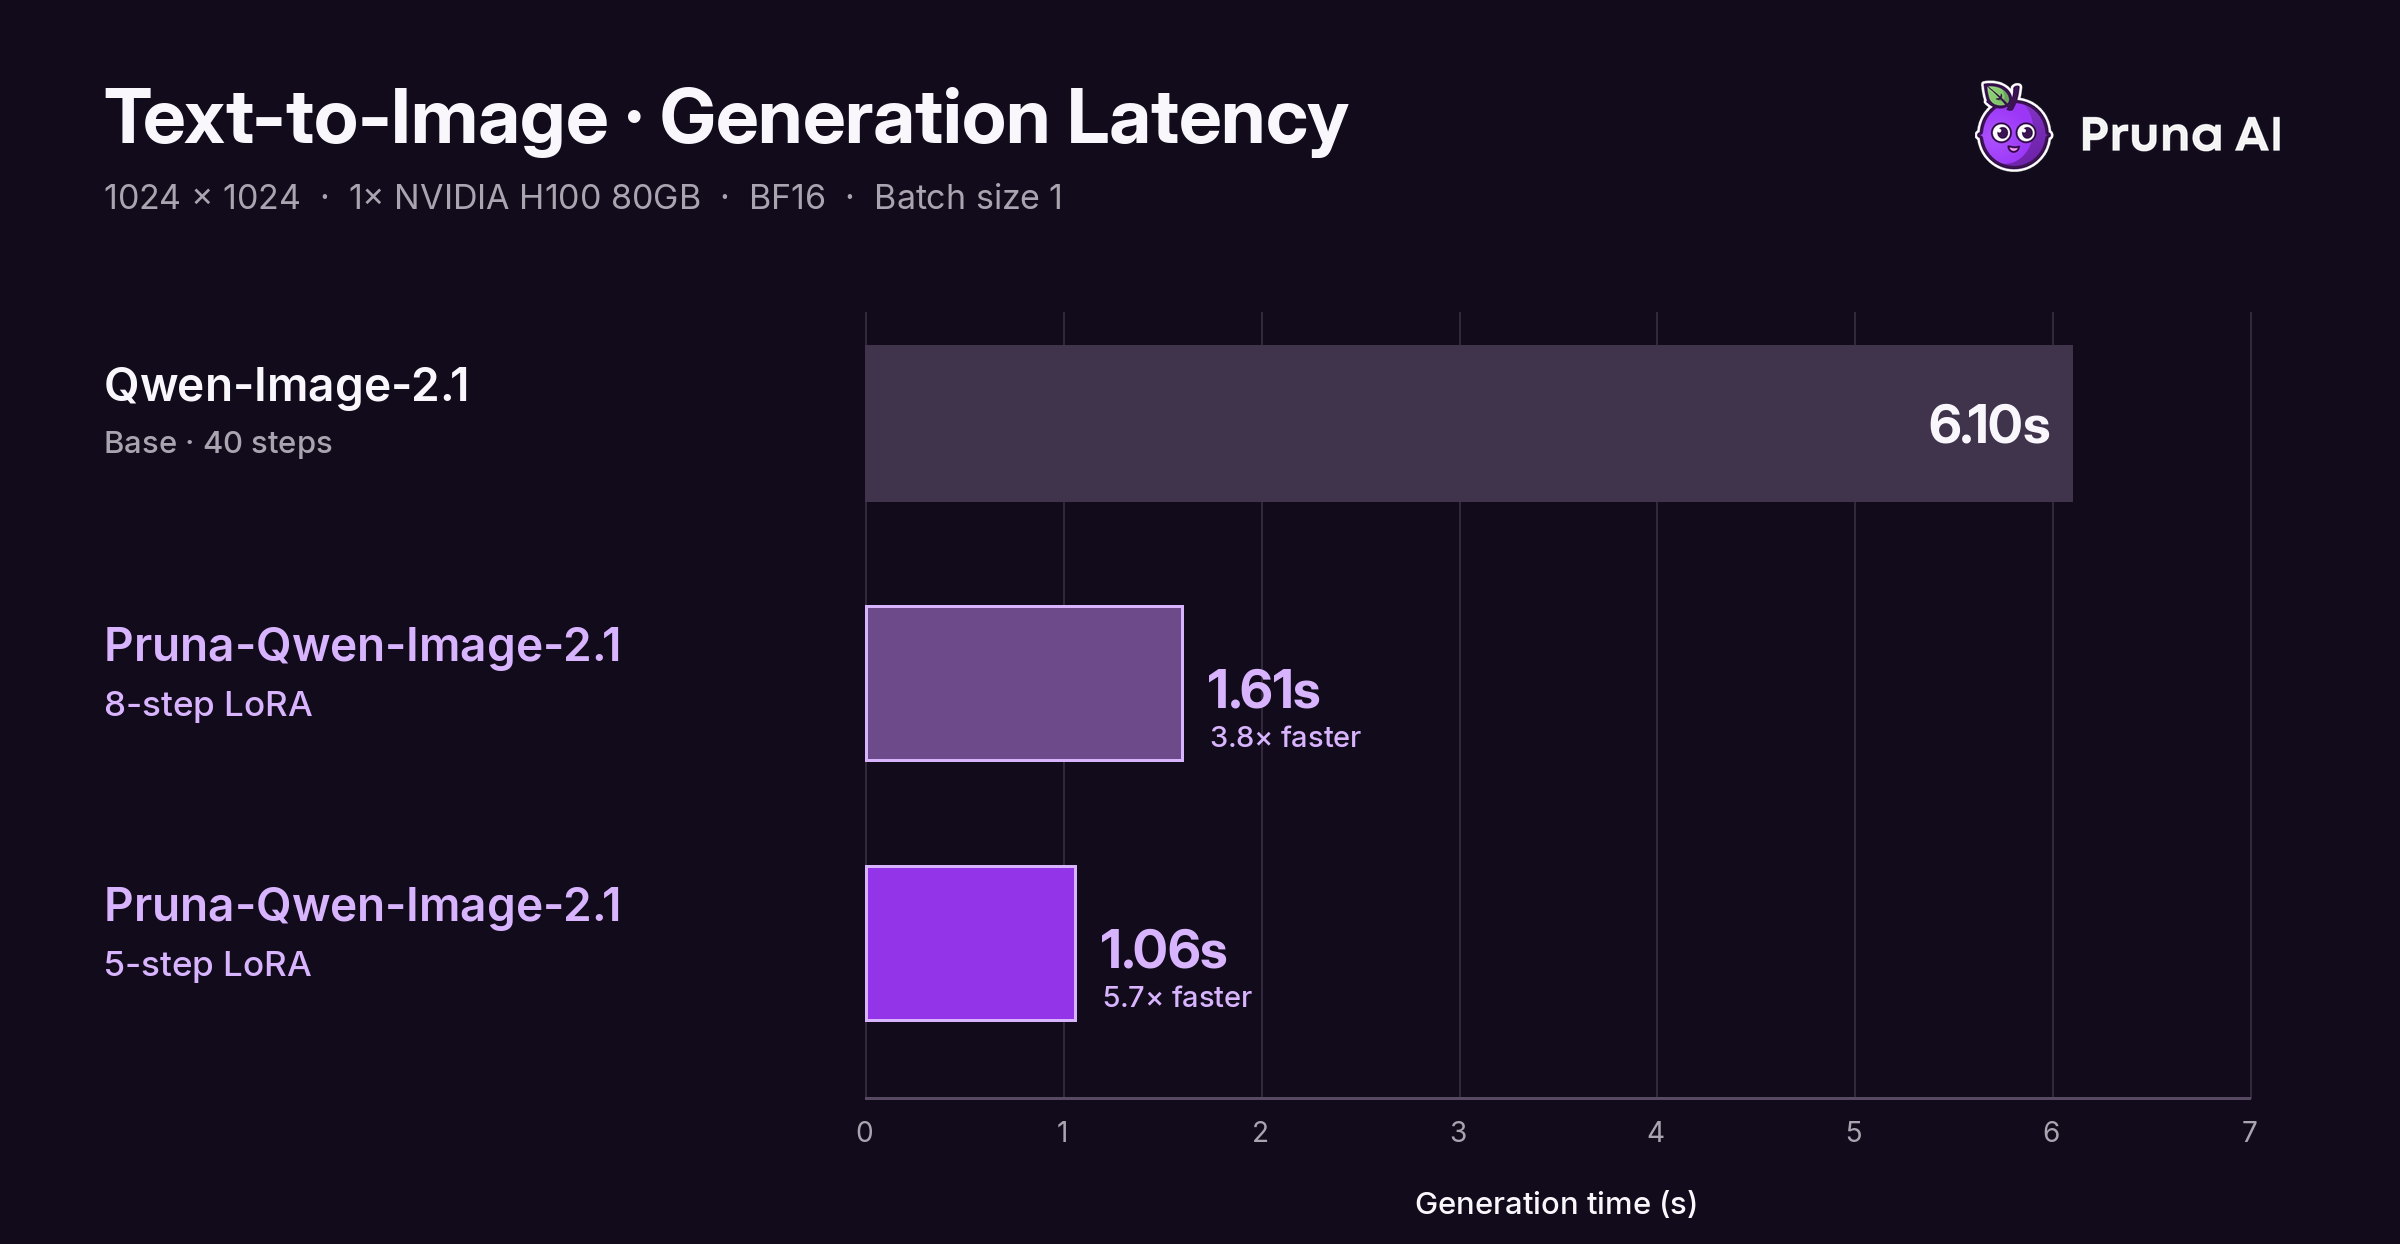
公式モデルカードの1024でのサンプル。
PrunaAIが9月にこれらのアダプタを最初にリリースしたとき、ファイルはdiffusers/PEFT形式で、アルファ値はsafetensorsのメタデータに保存されていましたが、ComfyUIのLoRAローダーはこれを読み取りません。またモデルカードには公式のComfyUIパッケージは存在しないと書かれていました。この両方の記述が今回変わります。アダプタは意図されたスケールで動作するネイティブのComfyUIファイルとして提供され、ワークフローはコミュニティによる変換ではなく作者自身によるものです。
2種類の6ステップアダプタ
v0.2はv0.1のセット全体(5ステップと8ステップ)を維持したうえで、異なる方法でトレーニングされた6ステップの生徒モデルを2つ追加しています。
| アダプタ | ステップ数 | 用途 |
|---|---|---|
p_q_image_2.1_6_steps_v0.2.safetensors | 6 | 高度な蒸留。ベースモデルにそのまま差し替え可能。入力画像を保持する必要がある編集で最適。 |
p_q_image_2.1_6_steps_upsampled_v0.2.safetensors | 6 | 推奨プロンプトアップサンプラをLoRAに蒸留。別途アップサンプリングを呼び出さずに、短いプロンプトからより高品質な出力が得られる。 |
PrunaAIによると、通常の6ステップアダプタはほぼすべてのカテゴリでv0.1のペアを上回ります。重要なのは、2つのスケジュールに互換性がないという点です。v0.2のアダプタは独自のシグマスケジュールでトレーニングされており、モデルカードではv0.1の数値を再利用しないよう明記されています。
プロンプトアップサンプリングをLoRAに統合
Qwen-Image 2.1の公式レシピでは、生成前にプロンプトエンハンサーを実行します。6-steps-upsampledアダプタはこのステップを吸収するため、短いプロンプトをそのままサンプリングに渡すことができ、エンドツーエンドの時間は別途エンハンサーを呼び出す分だけ短縮されます。
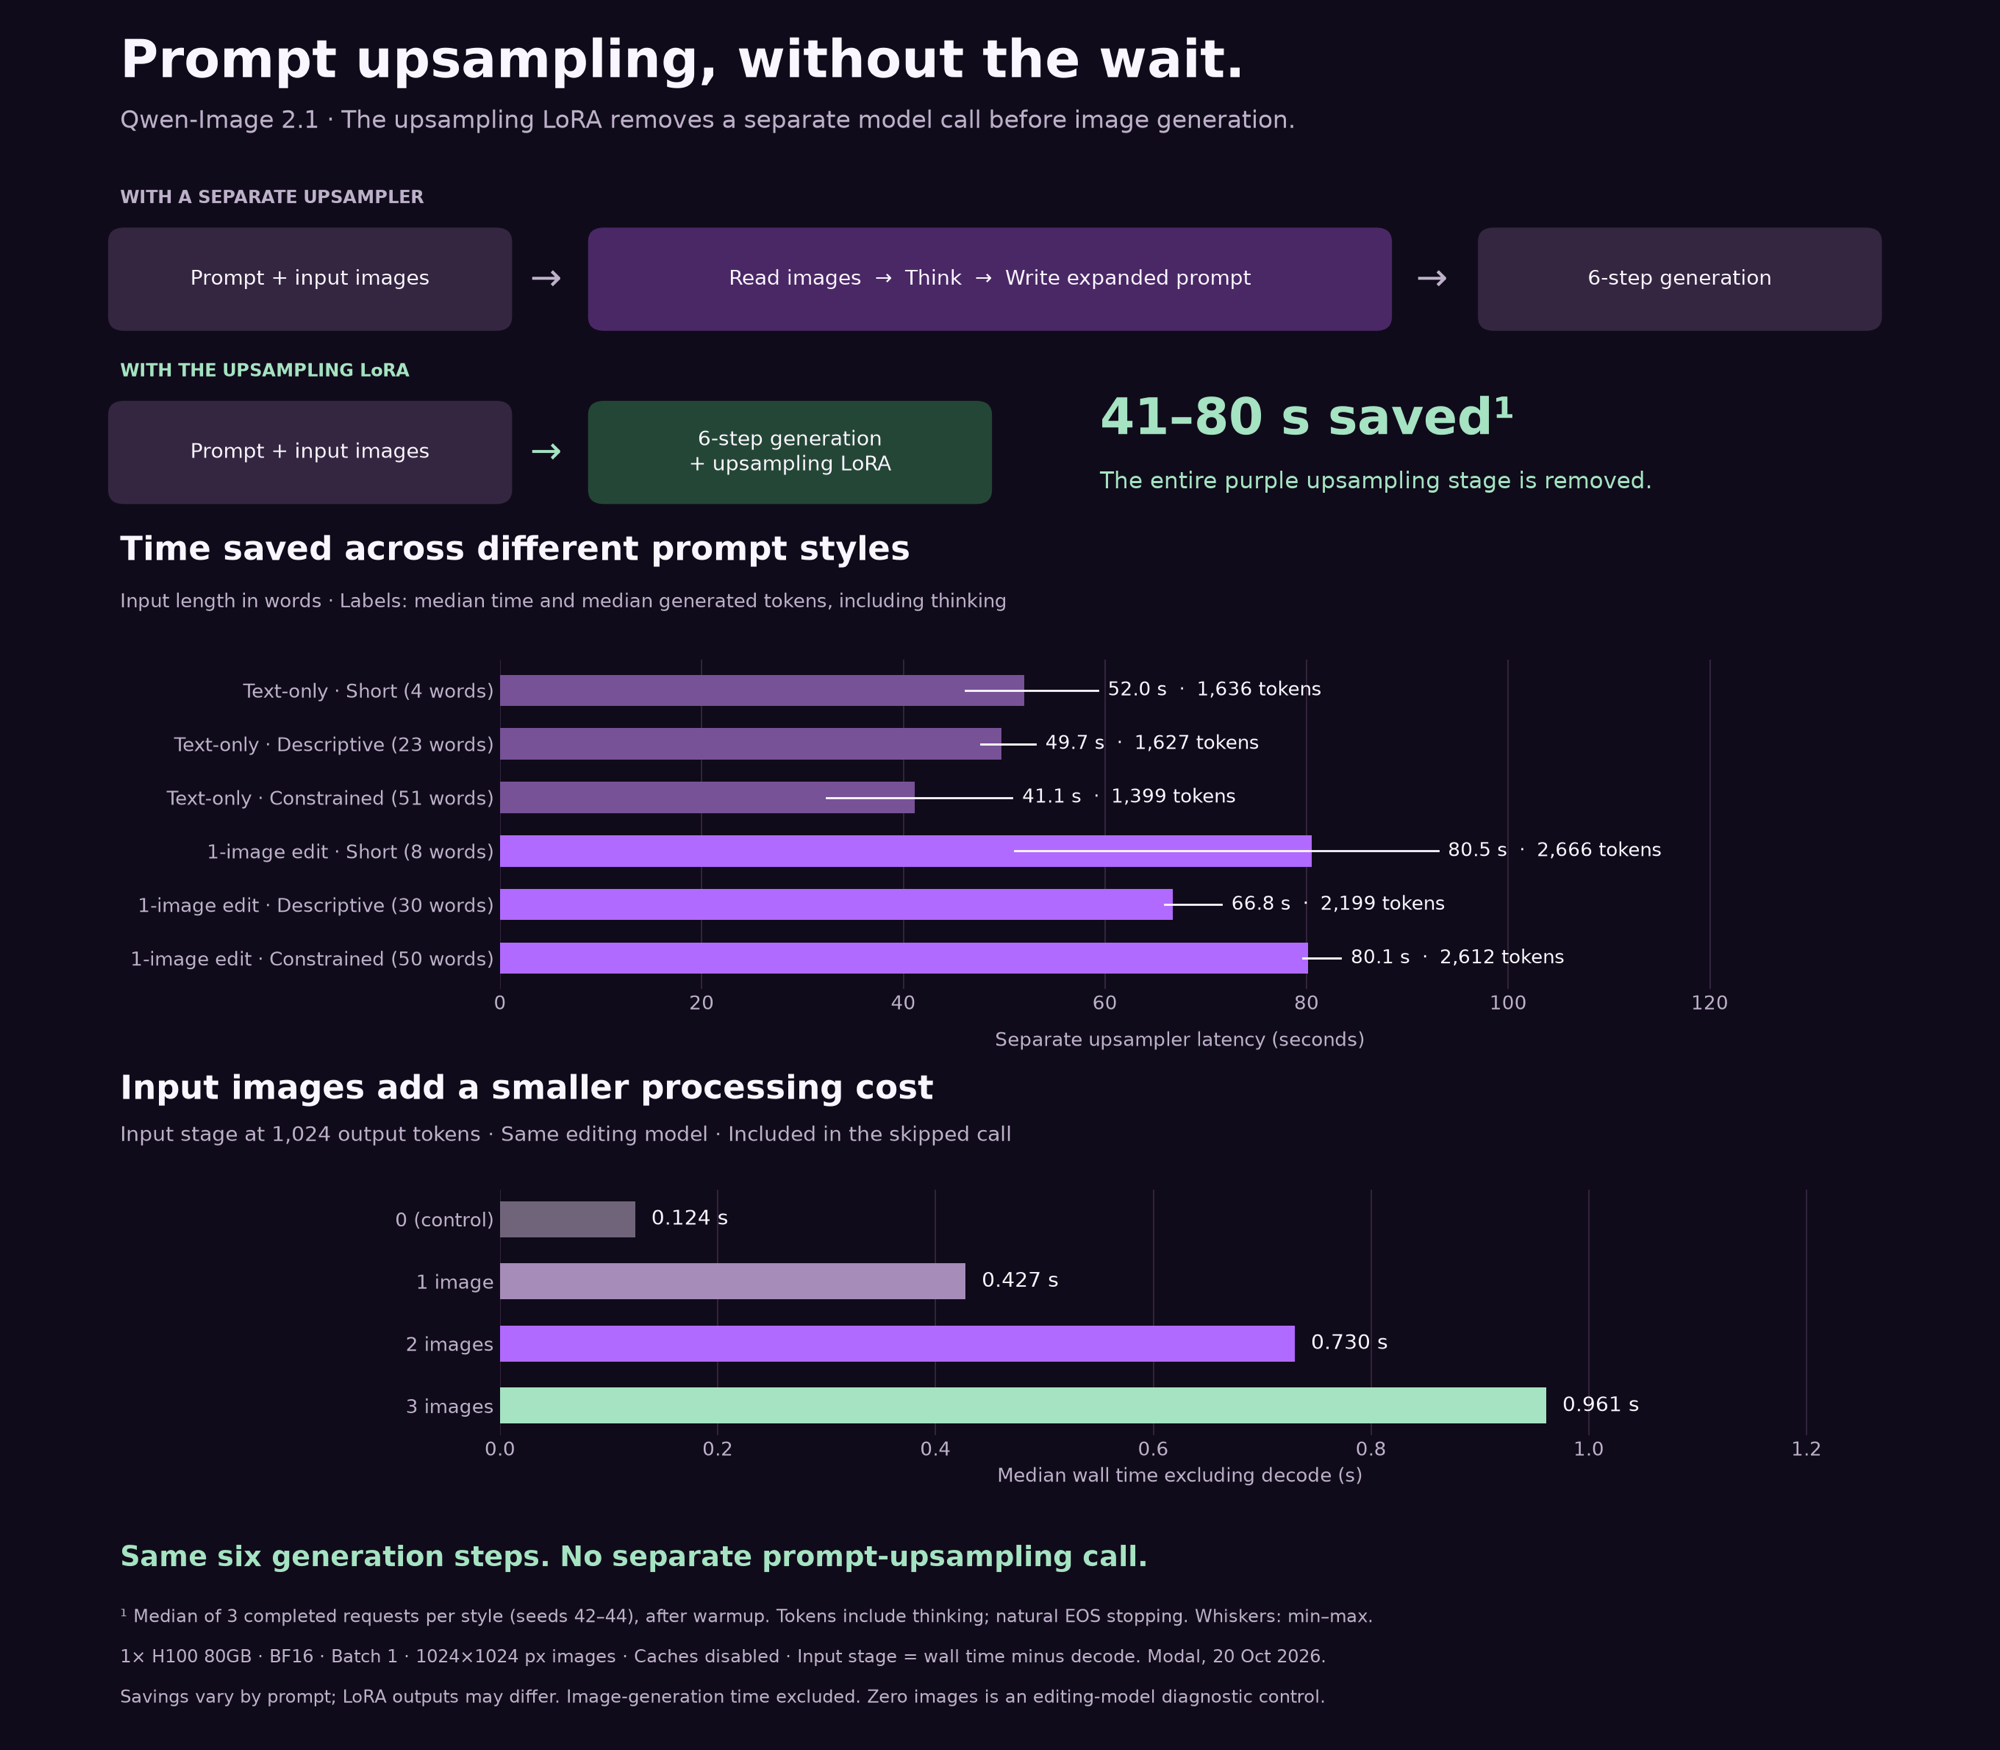
v0.2アダプタが置き換えることを想定しているアップサンプリングステップについて、カードに別途記載された計測値。
カードの記述は慎重です。別途プロンプトアップサンプリングのパスを不要にする初の蒸留であると述べたうえで、アダプタが実際のアップサンプラの動作を正確に再現しない可能性があるとし、今後の改善を約束しています。Prunaは公式のQwen-Image-2.1-PE-T2IおよびPE-I2Iエンハンサーを使ってアップサンプラ単体の計測も行っており、2つの中央値を足し合わせてもエンドツーエンドの数値にはならないと警告しています。
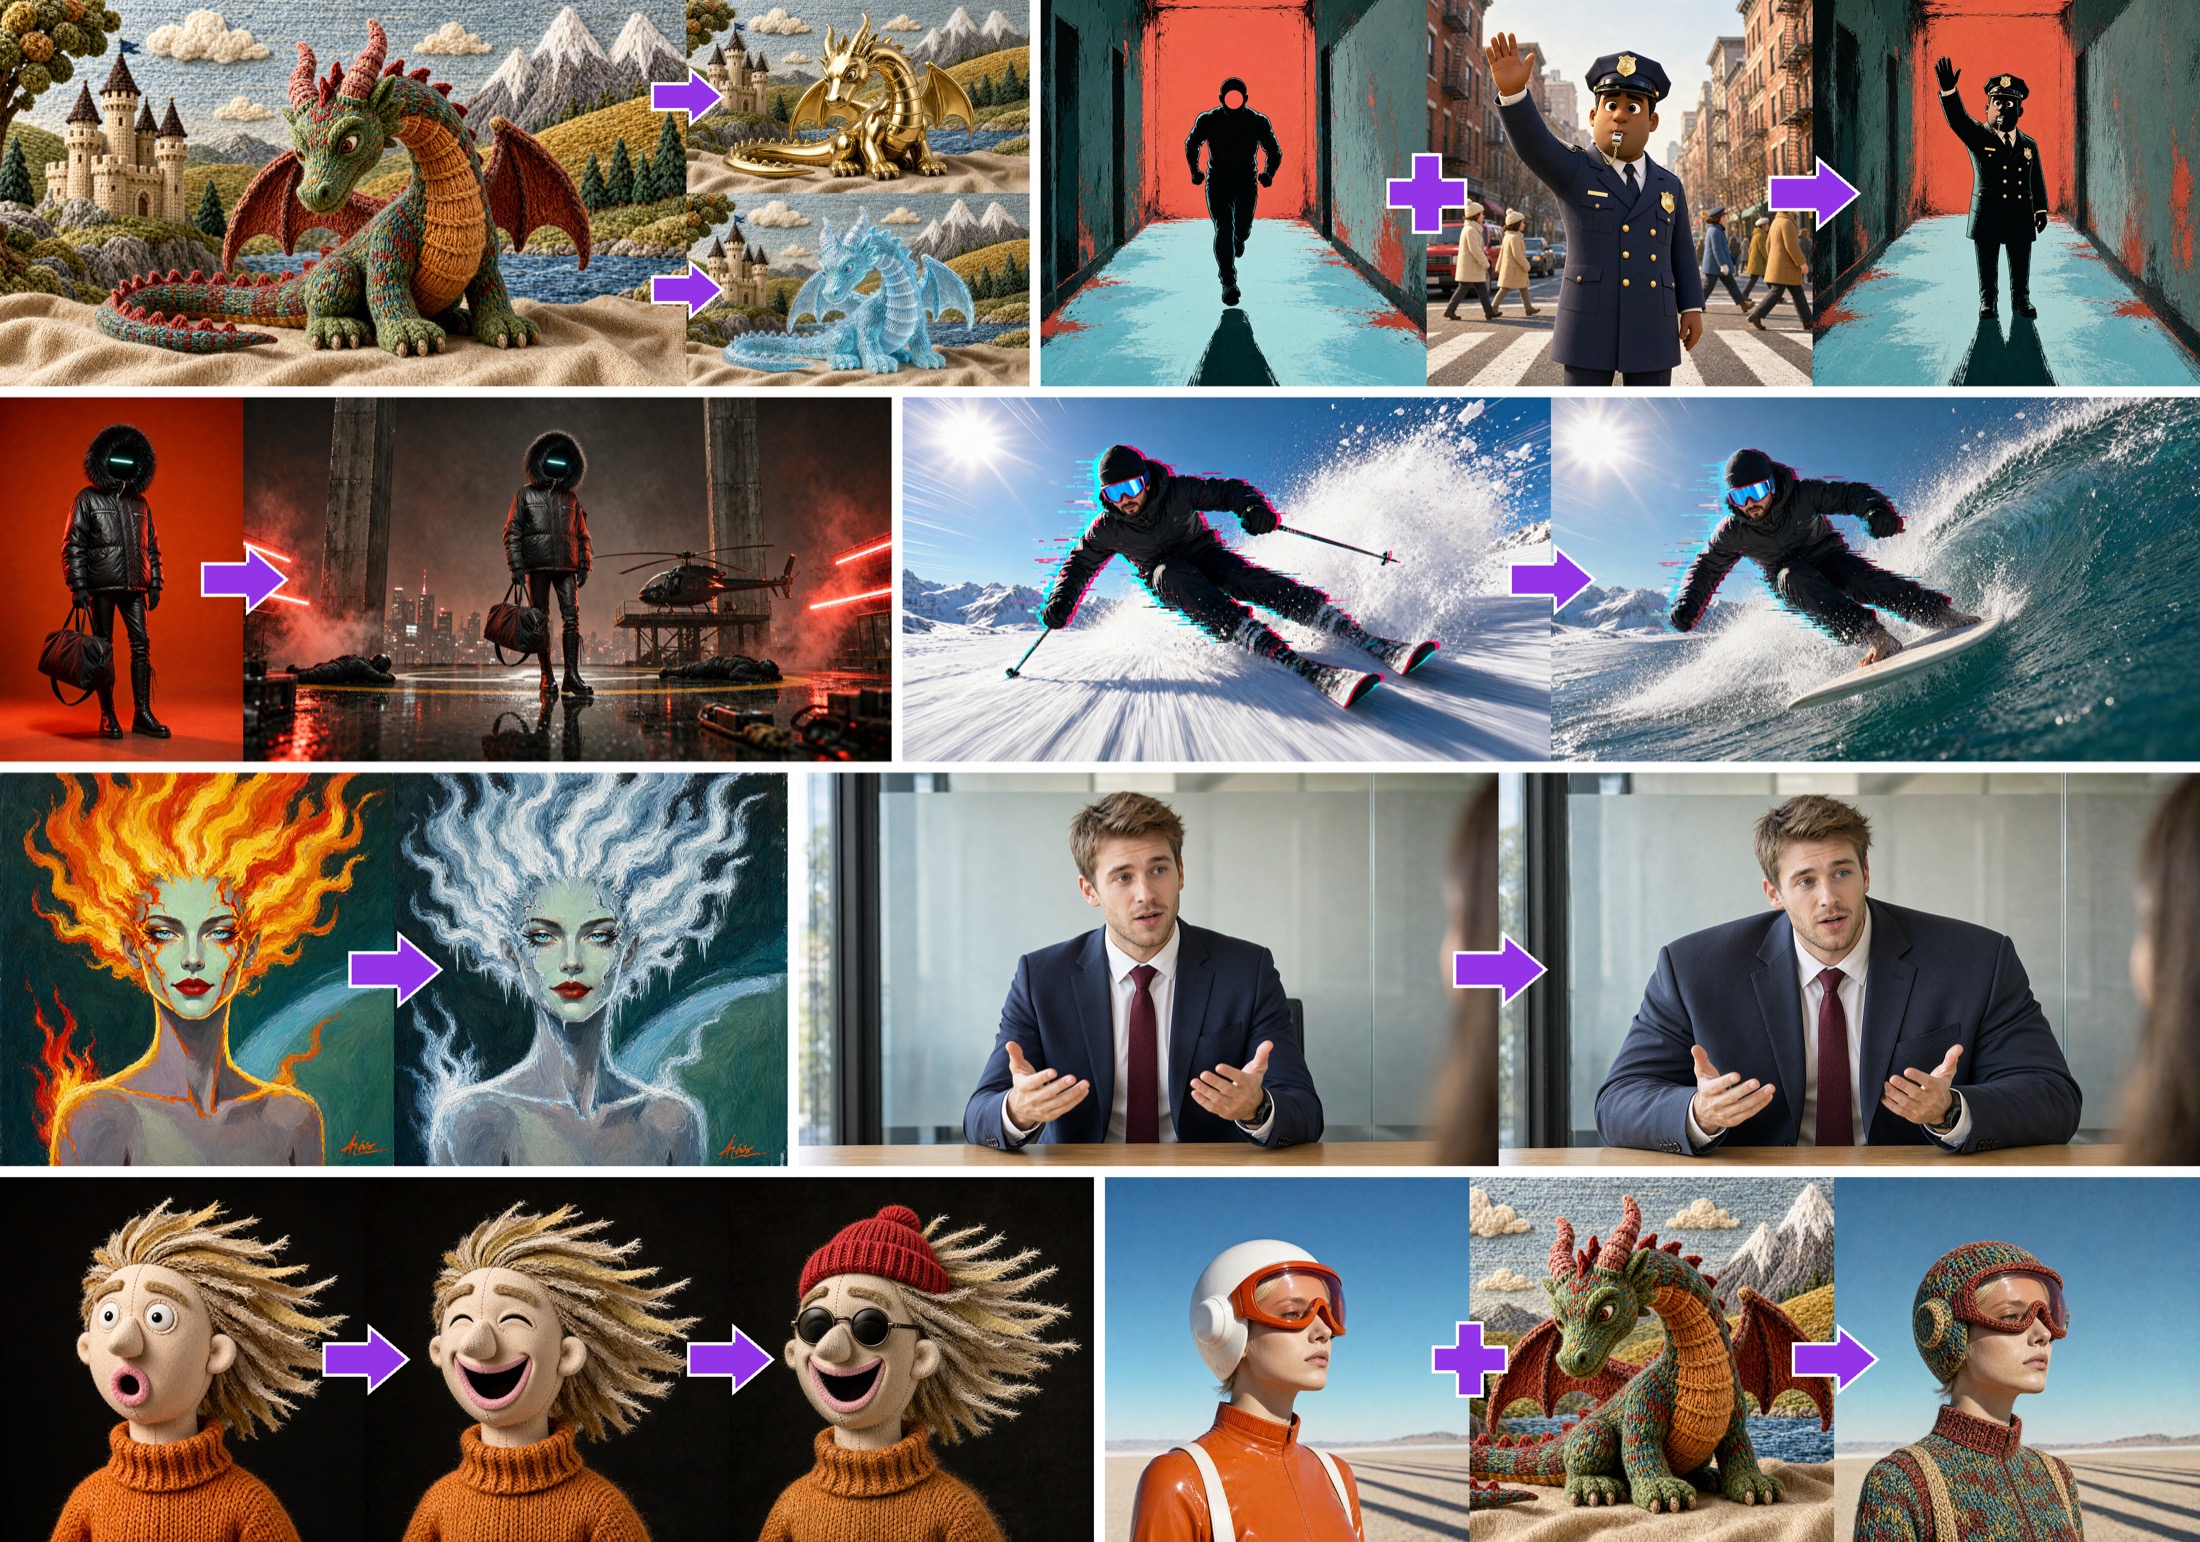
公式カードの編集結果。通常の6ステップアダプタが調整されているタスク。
公式ComfyUIエクスポート
ComfyUIリポジトリには、各バリアントにつき1つ、計4つのbf16アダプタが収録されており、ワークフローは6つあります。v0.2の6ステップ、v0.1の8ステップ、v0.1の5ステップそれぞれのテキストから画像へと画像編集です。各ワークフローはネイティブのLoraLoaderModelOnlyノードで1つのアダプタを強度1.0で読み込み、CFG 1でeulerによりサンプリングし、ManualSigmasスケジュールを使用します。カスタムノードは不要です。
レイアウトはQwen-Image 2.1でComfyUIユーザーが既に使っているものと同じで、ベースチェックポイントはComfy-Org/Qwen-Image-2.1から取得します。
ComfyUI/
└── models/
    ├── diffusion_models/
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── loras/
    │   └── p_q_image_2.1_6_steps_v0.2_comfyui_bf16.safetensors
    ├── text_encoders/
    │   └── qwen3vl_8b_int8_convrot.safetensors
    └── vae/
└── qwen_image_2.1_vae_bf16.safetensorsカードではTurboではなくベースチェックポイントを指定しており、スケジュールはアダプタごとに1つです。
| アダプタ | ManualSigmas |
|---|---|
| v0.2、6ステップ | 1.0, 0.961054, 0.918949, 0.769302, 0.545554, 0.222292, 0 |
| v0.1、8ステップ | 1.0, 0.933333, 0.857143, 0.769231, 0.666667, 0.545455, 0.4, 0.222222, 0 |
| v0.1、5ステップ | 1.0, 0.94, 0.857143, 0.666667, 0.4, 0 |
同じスケジュールが2つの6ステップバリアントの両方に使えます。v0.2のワークフローでlora_nameを6-stepsから6-steps-upsampledに切り替えることが、ComfyUIにおける両者の違いのすべてです。
変わっていない点
- トレーニングのカバレッジは依然1K。 アダプタは1024でトレーニングされ、編集では最大3枚の参照画像を使用します。Prunaは1024x1024から始めることを推奨しており、2Kやそれ以上の参照画像はカバレッジ外として扱い、品質が変動する可能性があるとしています。
- 最大6.3倍高速が依然として主要な数値で、CFGなし、ネガティブプロンプトなしです。v0.2のグラフは新しい計測値であり、v0.1のグラフとは条件を揃えていないとカードに記載されています。
- 232個のリニアターゲット全体でランク64。
proj_outを含み、アルファ128でトレーニングされ、2倍のスケールはエクスポートされたB行列に折り込まれています。そのため強度は1.0のままにする必要があります。 - v0.1もそのまま。 5ステップと8ステップのアダプタは変更されていないため、コミュニティ変換を使っている既存のワークフローは、スケジュールを変えずに公式ファイルへ移行できます。
コメント
GitHubでサインインしてディスカッションに参加しましょう。