MOSS-Image カラー/深度制御が ComfyUI コアに登場
コミュニティ製アダプターが、フラットなカラー領域マップと深度マップで MOSS-Image を純粋なノイズから制御。ComfyUI コアも同日中にサポートをマージしました。
MOSS-Image は OpenMOSS の 5B テキスト・レイアウトモデルで、同じ週に ComfyUI コア実装とともに提供されました。既存の構図制御手段は、ボックスの JSON レイアウトと、参照画像による変更のための編集 LoRA です。どちらも、もっと単純な問いには答えません。この人物をここに、この大きさで、あの机の前に立たせるにはどうするか、という問いです。
新しいアダプターは、画像ではなく 2 枚のマップでそれに答えます。色は各領域がどこにあるかを表し、深度は各面がどれだけ遠いかを表し、生成は依然として純粋なノイズから始まります。参照画像からコピーされるものは何もないため、背景はマップの元になったレンダーではなくプロンプトから生成されます。
条件付けとしての 2 枚のマップ
カードは入力を厳密に定義しており、それがこのアダプターを使いやすくしています。
- カラーマップ: 出力サイズの RGB 画像で、各オブジェクトや領域に 1 つのフラットな色が割り当てられます。色は塗るための色ではなく領域 ID であり、黒は未指定を意味します。
- 深度マップ: 出力サイズのグレースケール画像で、近いほど白です。
- どちらのマップも省略できます。アダプターは 35% がカラーのみ、35% が深度のみ、20% が両方、10% がどちらもなしという制御ドロップアウトでトレーニングされているため、単一マップでの実行もトレーニング分布の内側に収まります。
各シーンは three.js のマネキンエディターで作成され、シェーディング済みレンダー、カラーパス、深度パスをまとめてエクスポートします。
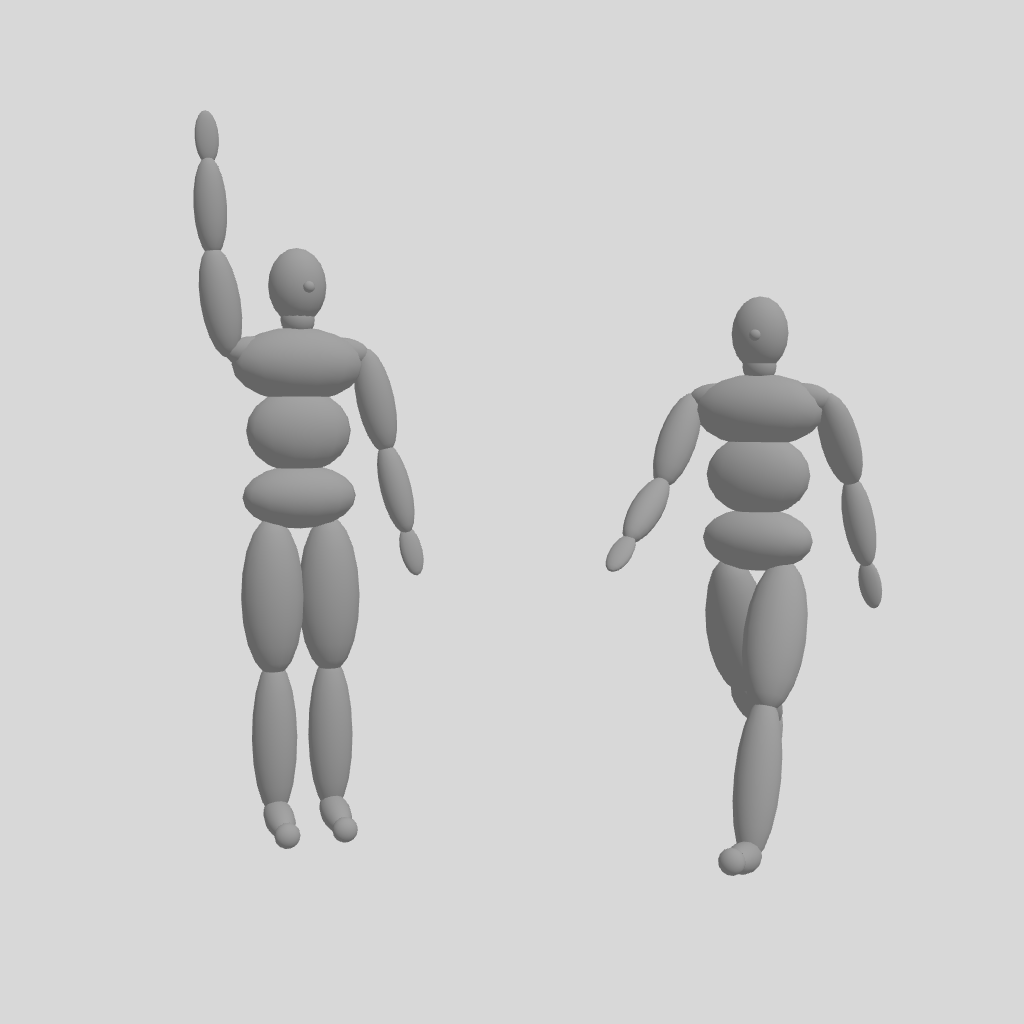 | 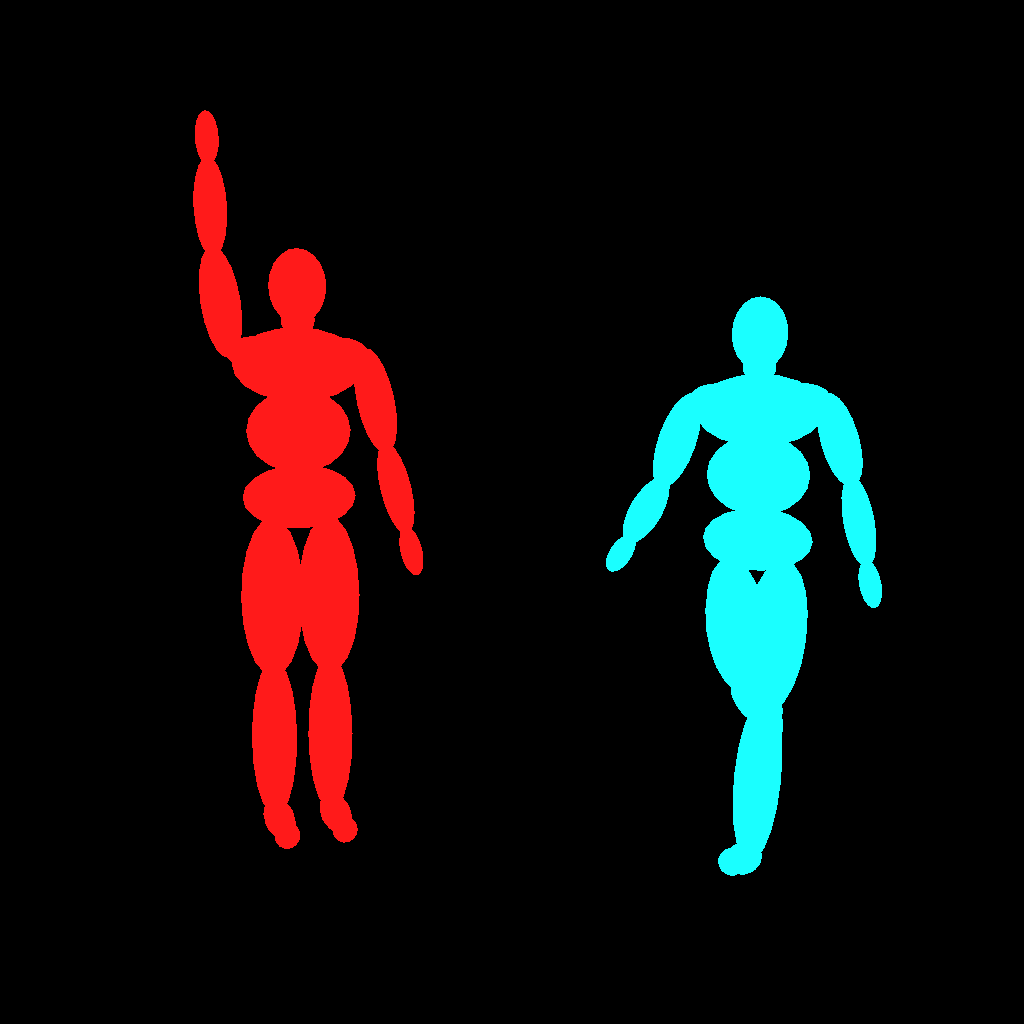 | 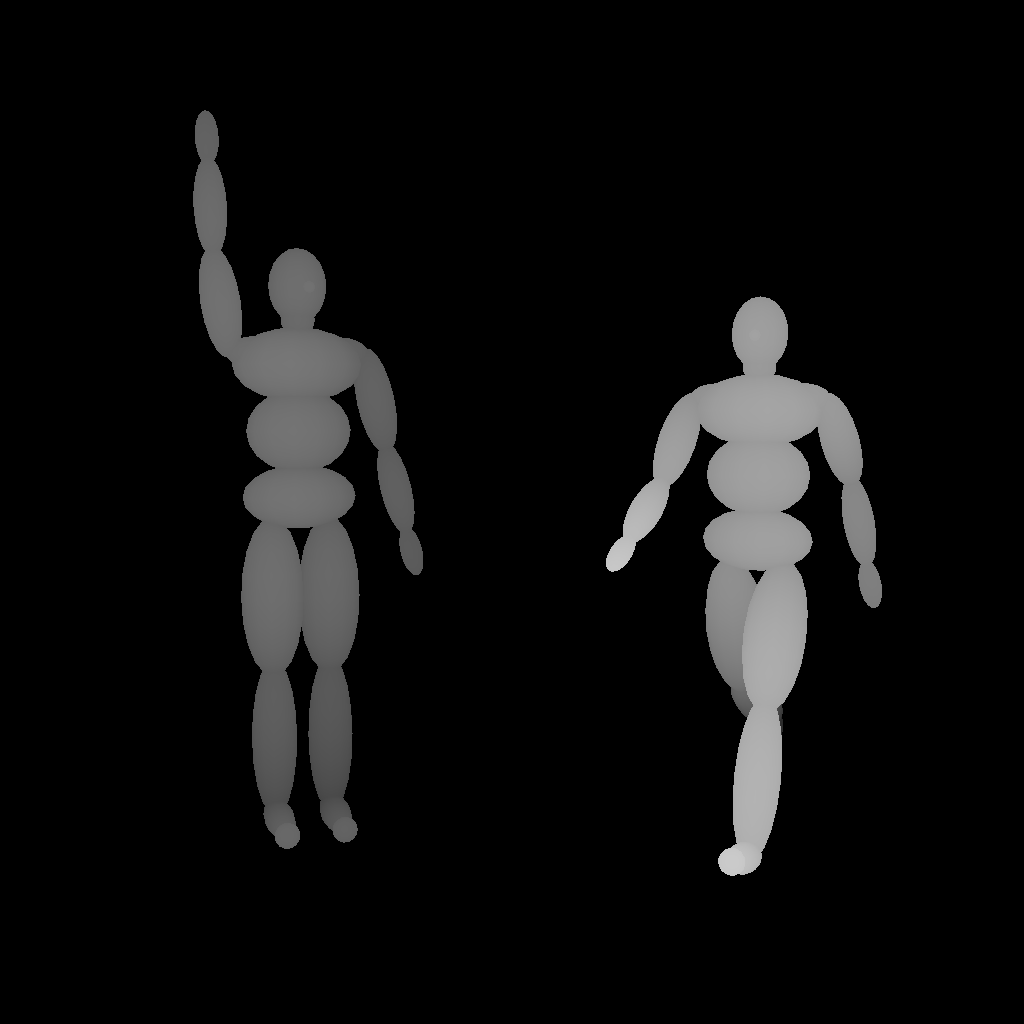 |
|---|---|---|
| ソースレンダー | カラー領域マップ | 深度マップ、近いほど白 |
重要な比較対象は画像から画像への変換です。3D レンダーを img2img パスに渡すと、レイアウトは保たれますが、レンダーの平坦な背景や灰色の表面もそのまま残ります。アダプターを使えば、配置・スケール・ポーズはマップに従い、マテリアルとライティングは生成されます。公開されているシーンが写真ではなく 3D マネキンなのはそのためです。
出力はどのようなものか
カードのメイン図は、同じ 2 人のマネキンシーンを並べたグリッドで、制御を全行程で保持した場合と途中でオフにした場合を比較しています。
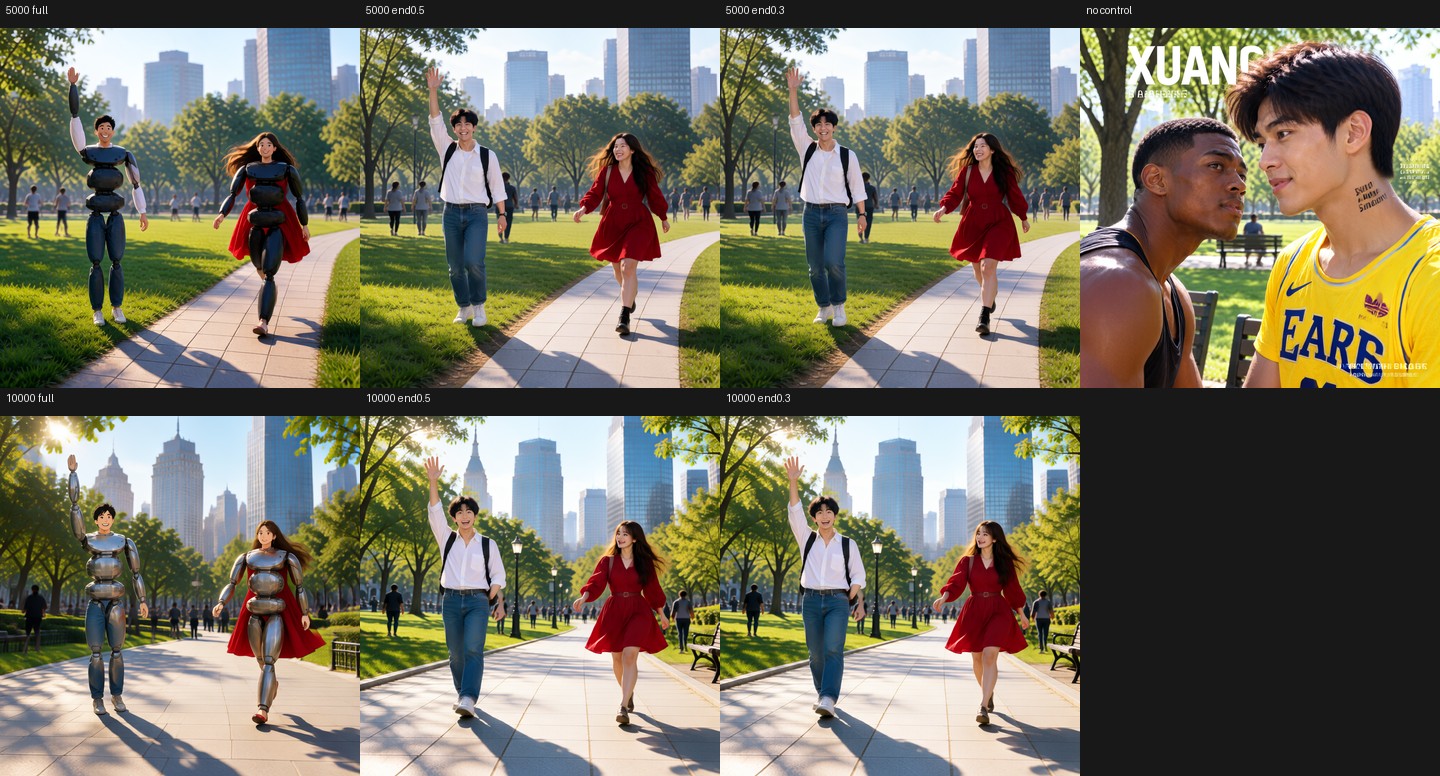
アダプターとともに公開: 上段は 5,000 ステップ、下段は 10,000 ステップで、制御を最後まで保持、0.5 で終了、0.3 で終了、制御なしのベースモデルを比較。最後まで保持するとマネキンの表面が透けて見え、0.5 で終了するとマップが示す位置に実在の人物が配置されます。
このグリッドは、アダプターの主な弱点を正直に示してもいます。全行程で制御すると、マネキンがそのまま再現されます。トレーニングの深度マップは実写真由来で、マップには「木であることをやめよ」と伝える情報がないからです。制御をステップの半分で終了させると、レイアウトは保たれ、残りのステップで肌・衣服・背景が解決されます。
同じアダプターをマップのみで、領域ごとのプロンプトなしで使うと、カードが記録している別の失敗モードが現れます。マンガ風のカラーマップでは、パネルレイアウトがずれ、後半のチェックポイントでテキストが劣化します。
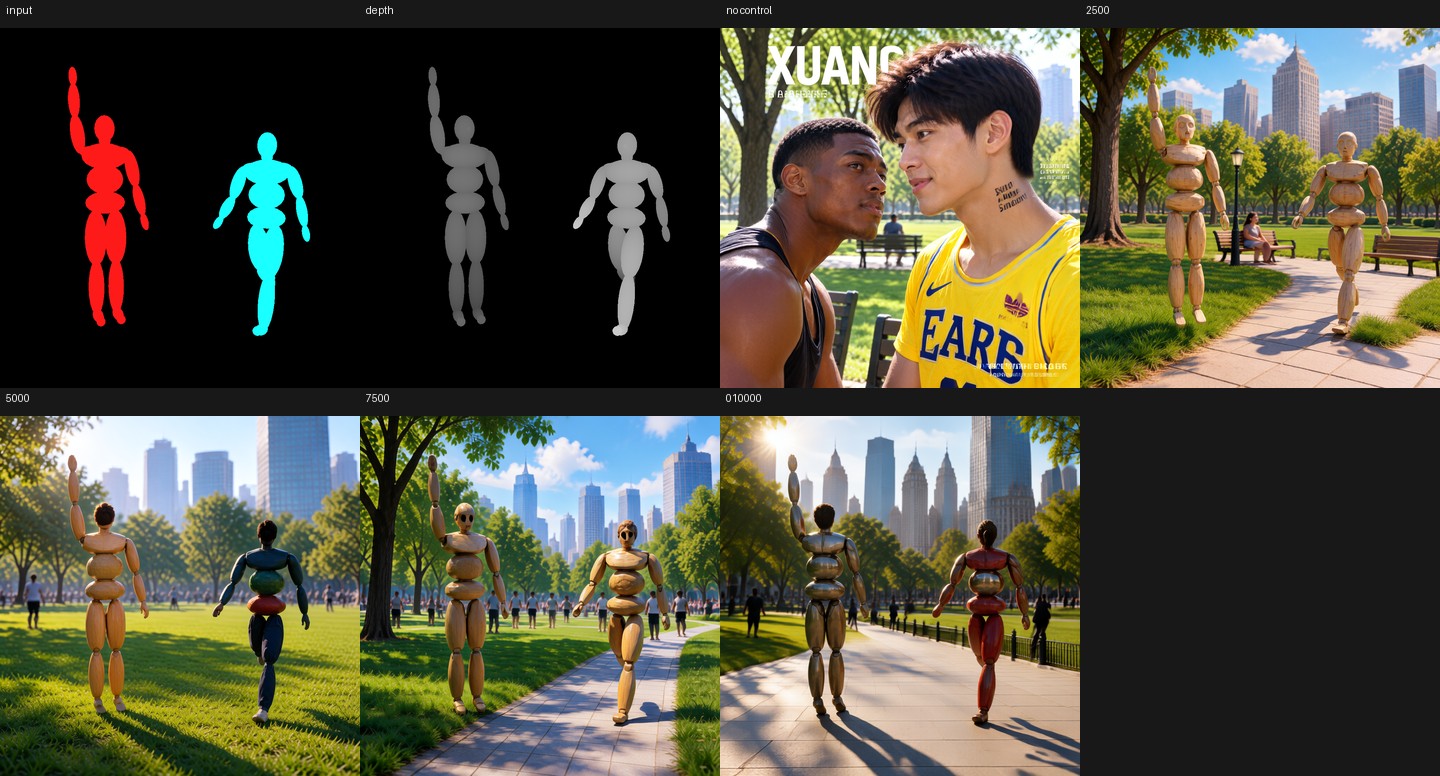
領域ごとのプロンプトなしでマップのみを使った 2 人シーン。出典: darask0/MOSS-Image-color-depth-control
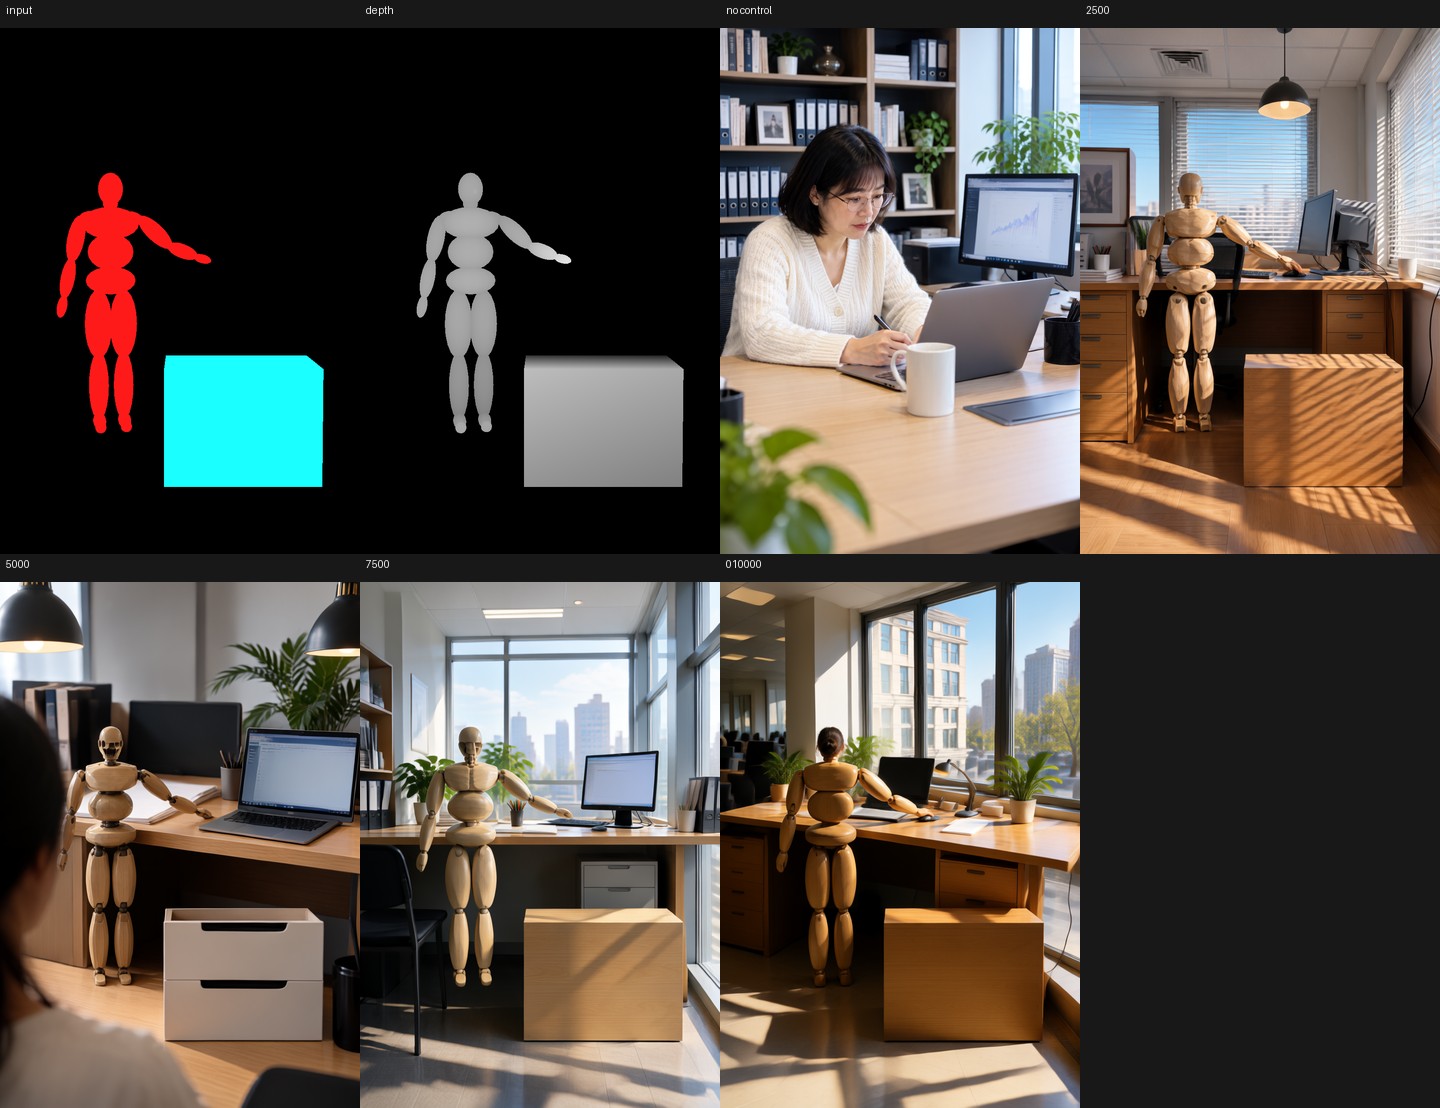
公開されている 2 つ目のシーン、机に向かう人物。これもマップのみを使用。
ComfyUI コアでの手順
Kijai による PR #17206 は 10月19日 22:15 UTC にマージされ、1 つのノードを追加します。model/conditioning/moss_image 配下の実験的ノード MOSS-Image Color/Depth Control(MOSSImageControl)です。ポジティブとネガティブの条件付け、VAE、オプションの color_map、オプションの depth_map、さらに strength、start_percent、end_percent を受け取り、両方の条件付けストリームを返します。
グラフは通常の MOSS-Image のものに 2 点を追加した形です。アダプターは拡散モデル上の標準的な LoRA ローダーで読み込まれ、制御ノードはテキストエンコードとサンプラーの間に置かれます。start_percent と end_percent はカードの color_end と depth_end に相当するコア側の値なので、合成入力向けの 0.5、実写真からトレースしたマップ向けの 1.0 というドキュメントの値は、そのままノードの値に対応します。
この仕組みはファイル形式を説明するものなので知っておく価値があります。アダプターはモデルの video_embedder 入力を 128 チャンネルから 384 チャンネルに拡張します。最初の 3 分の 1 にノイズ入りの FLUX.2 VAE 潜在、次の 3 分の 1 にカラーマップの潜在、最後の 3 分の 1 に深度マップの潜在が入ります。PR は MOSS-Image モデルクラスに concat_cond を追加し、ノードが渡したものをアップサンプルしてノイズに付加し、マップが不足している場合はゼロの潜在で置き換えます。線形エンベダーにとってゼロ入力はまさに「制御なし」だからです。また lora_convert.py に変換処理を追加し、拡張された video_embedder のキーを加算ではなく置き換えパッチに変換します。エンベダーは微調整されるのではなく置き換えられるためです。
領域ごとのプロンプトは、この PR より前からある別の経路です。MOSS-Image Layout Prompt は Create Bounding Boxes で作成したボックスからレイアウト JSON を構築し、各ボックスのキャプションをそのプロンプトとして使います。アダプターのカードは制御マップとこれらの領域ごとのプロンプトを組み合わせることを推奨しており、公開されている例はその方法でサンプリングされています。
サポートは v0.42.1 タグの後にマージされたため、リリース版をインストールするにはそのタグより新しいビルドが必要です。
カードの設定
| 設定 | 値 | 理由 |
|---|---|---|
| アダプターのチェックポイント | moss-control.safetensors | 10,000 ステップの推奨版 |
strength | 1.0 | トレーニング時の強度。0.0 はマップなしと同じ |
end_percent(3D マネキンのマップ) | 0.5 | 制御がレイアウトとポーズを駆動し、その後解放される |
end_percent(実写真由来のマップ) | 1.0 | 生成の最後まで制御を保持 |
| 領域プロンプト | 色ごとに 1 つ | ないと、マネキン形状のマップがマネキンとして描画される |
以前のチェックポイントは終了割合の代わりになります。2,500 ステップはマップへの追従が緩く、マネキンらしさも弱くなり、7,500 と 10,000 はより強く追従します。4 つすべてがリポジトリにあります。
速度面では、同じ作者による 4 ステップの rapid-moss アダプター(darask0/MOSS-Image_4-step_adapter_lora、本サイトでは 10月17日に取り上げました)がドキュメント上の組み合わせです。カードによれば、RTX PRO 6000 で 1024² あたり約 1.8 秒と報告されています。
トレーニング方法
safetensors のヘッダーを調べると 526 個のテンソルがあります。全 42 DiT レイヤーの q、k、v、o、ffn_up_gate、ffn_down に対する rank 64、alpha 64 の LoRA ペア(252 ペア)、2 つのテキストエンベダーブロック上の各ブロック 5 つの射影(10 ペア)、そして置き換え用の video_embedder の重みとバイアスです。
トレーニングは MOSS-Image Base transformer 上で、FP8 で凍結した状態で行われ、エンベダーは 384 入力に拡張され、その制御列はゼロで初期化されました。データは 5 つのアスペクト比にわたる 1024 クラス解像度の Krea 2 Turbo 画像 10,000 枚とそのキャプションです。カラーマップは COCO パノプティックセグメンテーション上の Mask2Former Swin-L から、深度マップは Depth Anything V2 Large から取得しました。最適化は AdamW、学習率 1e-4(エンベダーの制御列は 10 倍)、バッチ 1、10,000 ステップ、RTX PRO 6000 1 台で 1 ステップ 0.8 秒、MOSS のロジット正規タイムステップ分布、10% の空キャプションです。設定とトレーニングスクリプトは重みとともに配布されています。
知っておくべき制限
カードは、うまくいかない点について異例なほど率直です。
- マネキンらしさ。 3D レンダーで全行程制御すると、レンダーの木や金属の表面が再現されます。トレーニングの深度が写真由来だからです。
- ポーズの精度はマップより粗い。 指や顔は投影されるのではなく生成されます。
- レイアウトには制御だけでは不十分。 マンガのカラーマップではパネル構造が失われ、7,500 ステップ以降はテキストが乱れます。
- 作者の Hayate ランタイムでは組み合わせに制限がある。 モデルカードによれば、Hayate では img2img やインペイントと併用できず、どちらか一方のみです。
- スタイルの事前分布は写真的。 トレーニングデータは Krea 2 Turbo の出力でした。
- ベンチマークはなし。 カードによれば、評価は少数のシーンと 2 つのシードで行われました。
また、このアダプターは OpenMOSS の公式リリースではありません。重み、トレーニングコード、参照ランタイムは 1 人の作者によるもので、ComfyUI メンテナーがレビューしたのはコア側のサポート部分です。
入手方法
- アダプター: darask0/MOSS-Image-color-depth-control、チェックポイント 4 種、アップロードから 1 週間で約 30 いいね。
- ComfyUI コア: PR #17206、v0.42.1 リリース後に 2026年10月19日にマージ。
- 速度向けの組み合わせ: darask0/MOSS-Image_4-step_adapter_lora。
- ベースモデル: MOSS-Image-Base と MOSS-Image-SFT、ComfyUI 用の単一ファイル重みは Comfy-Org/MOSS-Image にあります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。