MOSS-Image Edit HQ v5が登場、2つのComfyUI LoRAフォーマットに対応
コミュニティ製MOSS-Image編集LoRAがv5に到達。マスク損失、256トークンの参照予算、2つのComfyUIフォーマットに加え、評価グリッド、デモSpace、完全なレシピを公開しています。
MOSS-ImageはOpenMOSSの5Bテキスト・レイアウトモデルで、リリース時にも取り上げましたが、2週間後にrank 64のコミュニティ製アダプターによって指示ベースの編集機能を獲得しました。そのアダプターがchinoll/Moss-Image-Editであり、そこに残された疑問は、編集挙動のどれだけがその単一のトレーニングデータセットに由来するのかという点でした。MOSS-Image-Edit-HQは、別のデータからその能力を再構築し、オリジナルと比較測定することでこの疑問に答えます。
v5が実際に変えたもの
このリポジトリは1つのリリースではなく、5つのトレーニングアームの記録です。各アームは前のチェックアウトから継続され、それぞれがサンプルとともにディスク上に保持されているため、差異は主張ではなく検証可能な形で残されています。
| アーム | データと変更 | 結果 |
|---|---|---|
| v1 | ウォームスタート+ゼロからのトレーニング、マルチ参照データ、1024px | 評価ゲートを通過できず、同一性の保持はchinollが優位 |
| v2 | OmniEditのsurgical行、lr 1e-5、300ステップ | v3に置き換え |
| v3 | ConceptEdit-12Mのsurgical行を6,000件にフィルタ、700ステップ | v4に置き換え |
| v4 | 除去・顔・環境データ、4,644行、inverted_mask_priorを用いたマスク損失 | v5に置き換え |
| v5 | シーン全体のキャプション付き5,644行、ピクセル差分マスク、マスク損失、256トークンの参照予算、1,200ステップ | 現在のチェックポイント |
v5で最も重要な変更は参照予算です。ベースのMOSS-Imageは参照画像に144トークンを与えますが、このアームはそれを256に引き上げており、同一性と細部の向上はここに由来するとされています。v5の残りはデータ作業です。ピクセル差分マスクによって未編集領域がソースに近いまま保たれ、ConceptEditのメタデータから折り込んだシーン全体のキャプションによって、指示が編集部分だけでなくフレーム全体を記述するようになっています。
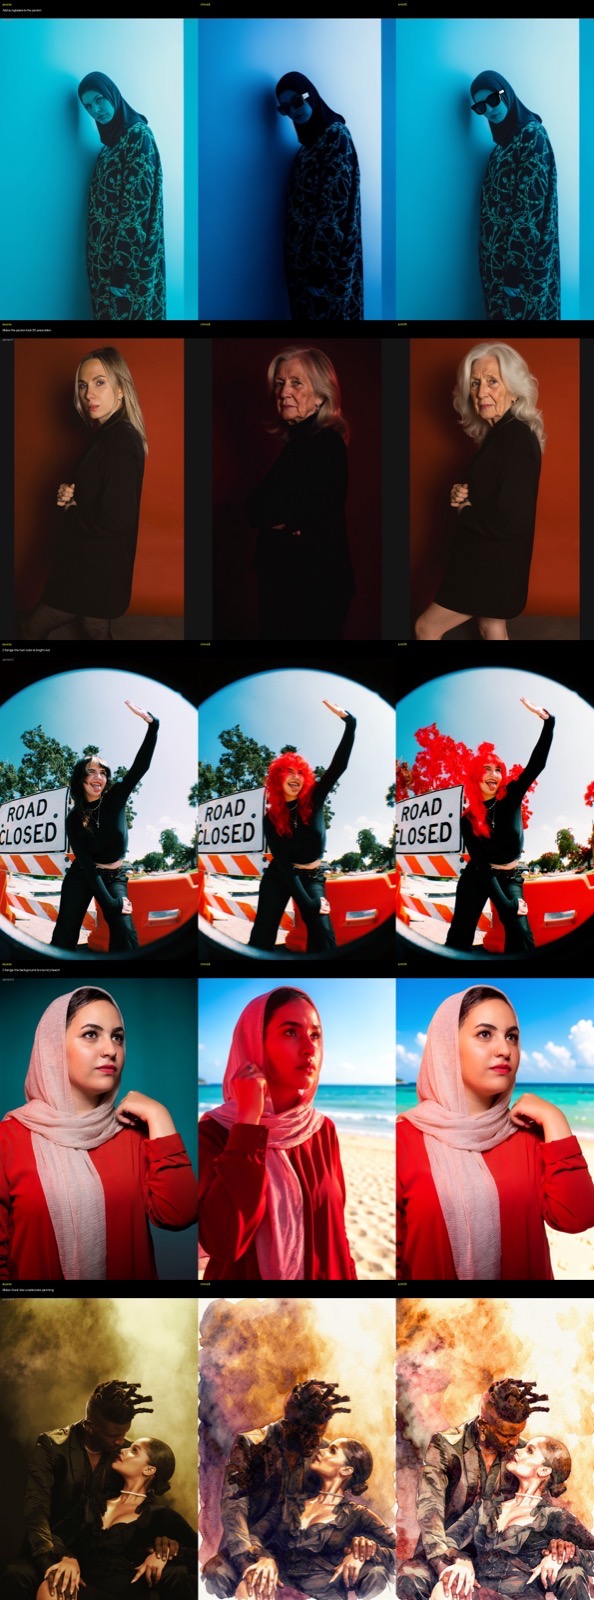
各行はソース画像から始まり、v5の出力へと続きます。出典: akhaliq/MOSS-Image-Edit-HQ
チェックポイントはpeft形式で各495 MBで、finalに加えてステップ250、500、750、1000があります。トレーニングはai-toolkitのコミット14f8f95で、アームごとに単一GPU、テキストエンコーダを凍結し、1024pxではgradient checkpointingを必須として実行されました。トレーニングデータも公開されています。フィルタ済みConceptEdit-12Mの6,000行がTARシャードとして提供され、各アームの設定はリポジトリ内にあります。
2つのComfyUI経路、2つのLoRAレイアウト
このリリースに少し読み込みが必要なのは、同じ重みが異なるComfyUIの仕組みで読み込まれる2つのレイアウトで提供されているからです。
ネイティブ経路ではweights/armV5/armV5.safetensorsを通常のLoRAとして使用します。models/loras/に置き、Load Diffusion Modelの後にLoRAローダーを追加し、実験的なText Encode MOSS-Image Editノードでedit_formatをai-toolkitに設定してエンコードします。参照はテキストエンコーダに入る前に最大384x384に縮小されます。
プラグイン経路ではarmV5-moss-edit-lora.safetensorsを使用し、これは代わりにmodels/model_patches/に置き、以前のアダプターと同じノードパックであるChenkin-x/ComfyUI-Moss-Image-Edit経由で読み込みます。このノードパックはComfyUI 0.42.3以降が必要です。
ネイティブ経路は現在のmasterビルドでのみ利用可能です。KijaiによるPR #17296は10月22日にマージされて編集ノードを追加しましたが、最新のタグ付きリリースである10月23日のv0.42.5には依然としてそれが含まれない古いcomfy_extras/nodes_moss_image.pyが同梱されているため、リリース版をインストールしている場合はedit_format = ai-toolkitを使うにはナイトリーに更新する必要があります。両方のワークフローはファイル名と設定が入力済みで提供され、1参照用と最大4参照用があります。
| 設定 | 値 |
|---|---|
| サンプラー | Euler、flow matching |
| Shift | 5.0 |
| ステップ | 50(品質重視)、DMDスピードスタック使用時は8 |
| CFG | 3.0、編集が弱い場合は3.5や4.0に上げる |
| SLGレイヤー | 22 |
| 参照サイズ | エンコーダに入るソース解像度、最大384x384 |
| 出力 | 最大1024px |
ai-toolkitレイアウトは以前のアダプターが使うMoss-Image-Editレイアウトとは同じではなく、モデルカードでも明言されています。chinollのアダプターはq、k、vのキーを分割して使うのに対し、ai-toolkitはそれらを融合するため、一方から他方へウォームスタートするには正確なrank 192のブロック対角融合が必要です。リポジトリには変換スクリプトが同梱されており、変換後に336/336のテンソルが一致したと報告されています。
高速になる場面とそうでない場面
編集LoRAを8ステップDMDスピードLoRAと重ねると、サンプリングが8ステップ、CFG 1になり、編集が約6倍高速になります。モデルカード自身の判断では、50ステップのパスが依然として優れています。8ステップではオブジェクトの追加が弱まり、色の保持が劣化するため、高速経路は下書き向けです。
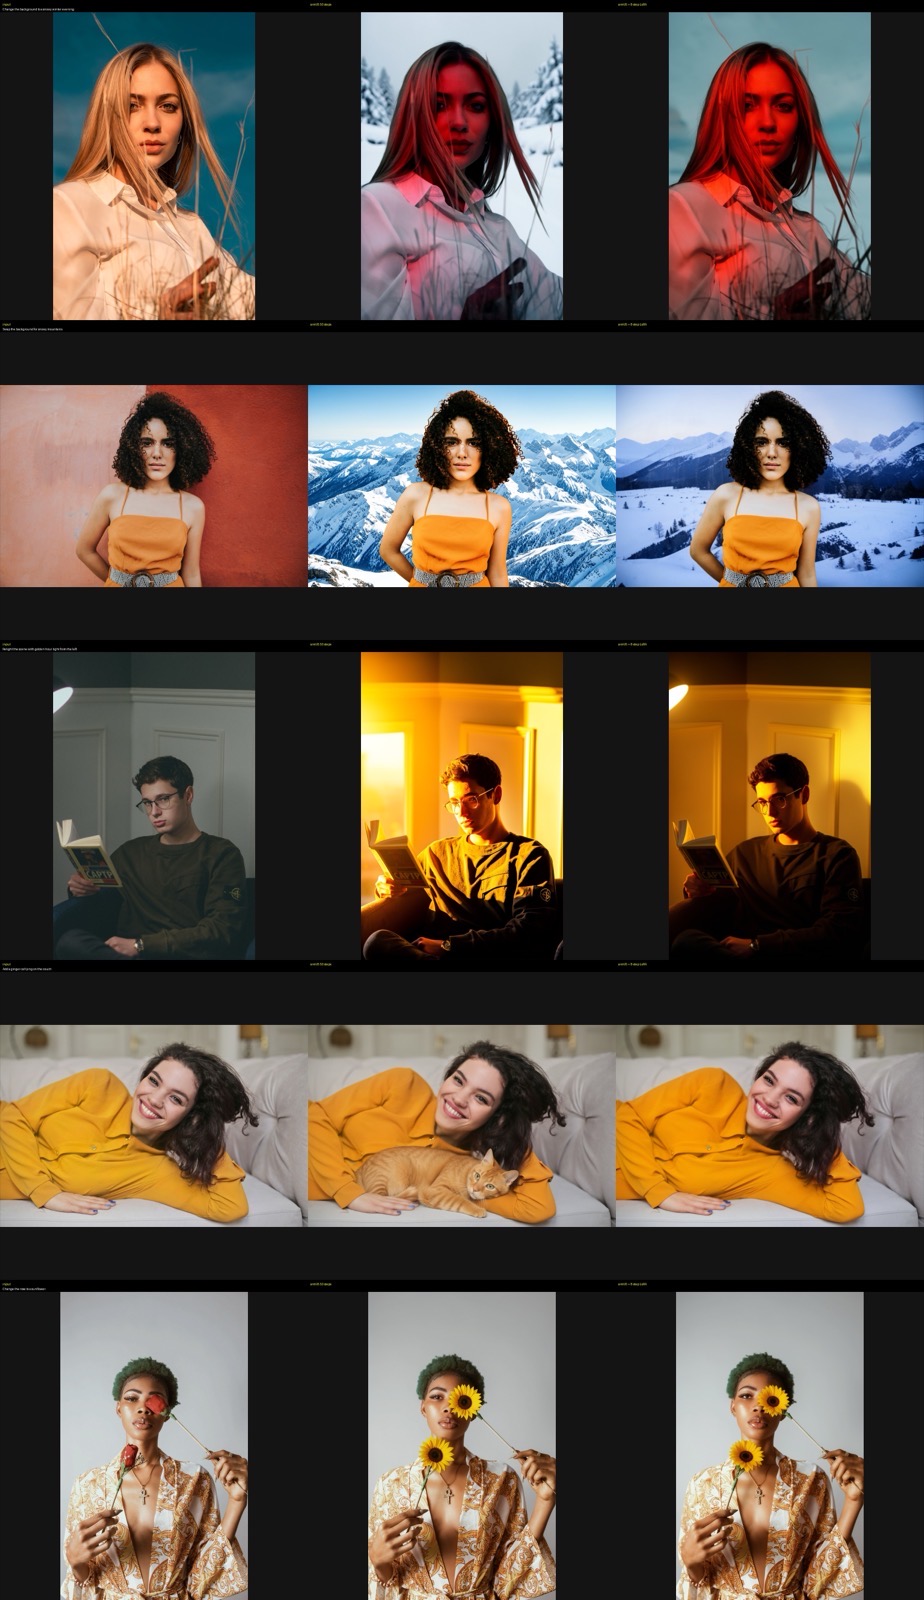
入力、50ステップ、8ステップDMDスタックの順。出典: akhaliq/MOSS-Image-Edit-HQ
v5のショーケース。編集ごとに1つの指示で、デモの設定である50ステップ、CFG 3でレンダリングされています。
比較についても同じ誠実さが保たれています。プロジェクトが掲げる目標は品質でchinoll/Moss-Image-Editを上回ることですが、v1アームは同一性の保持に関してこのゲートに公然と失敗しており、その後、後のアームがマスク損失に移行しました。公開されているグリッドはv5を以前のアダプターとKrea 2の両方と比較していますが、それらは作者自身の評価セットとデモSpaceであり、第三者によるベンチマークではありません。
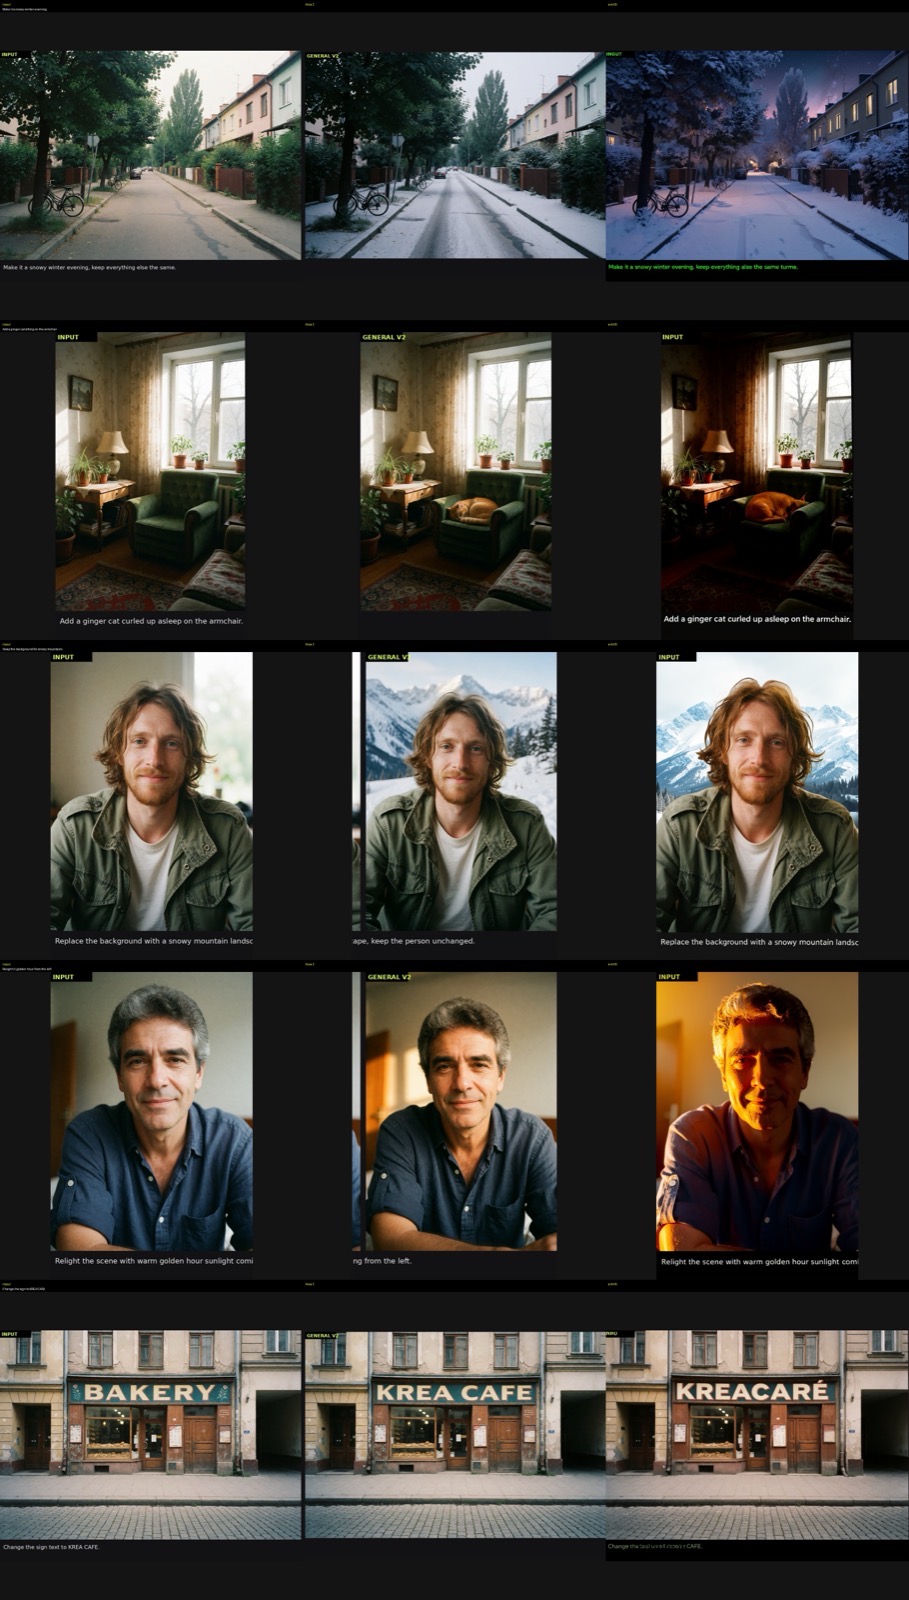
Krea 2のショーケースプロンプトに対するv5の編集結果を、Krea 2の参照レンダリングと並べたもの。出典: akhaliq/MOSS-Image-Edit-HQ
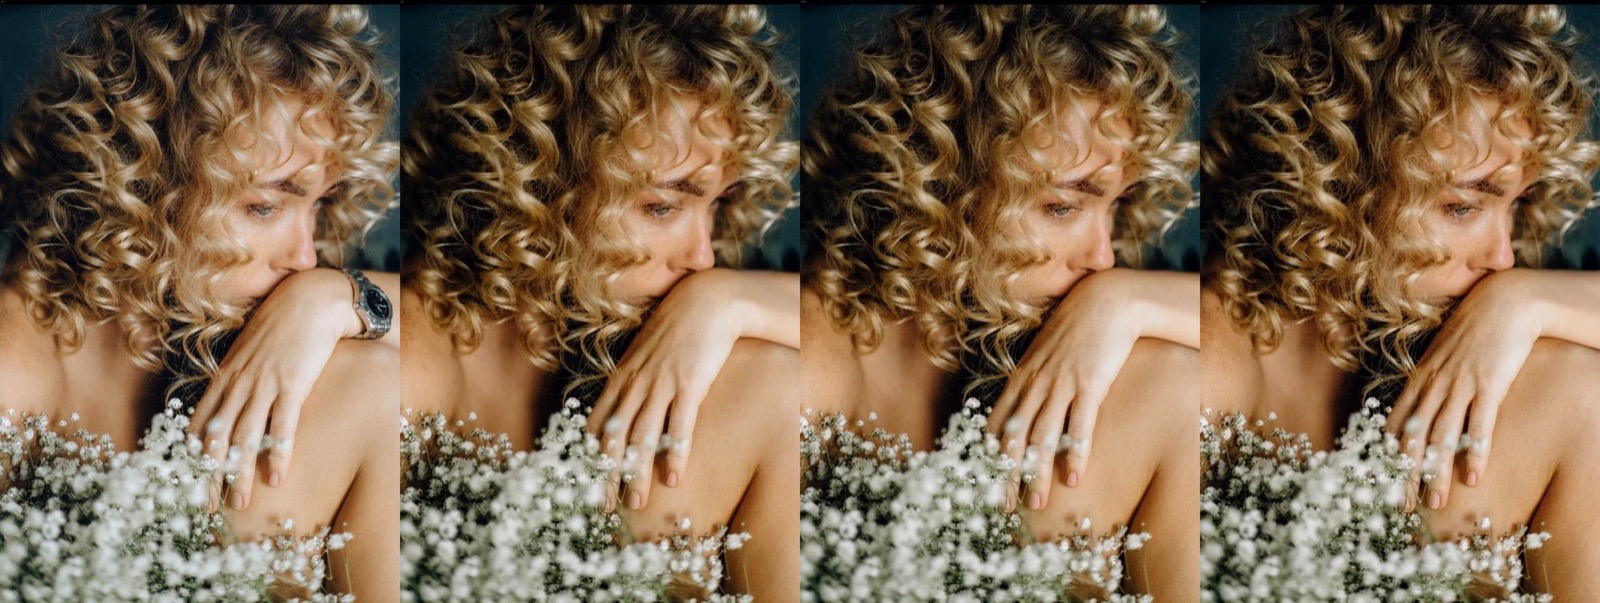
リポジトリからのオブジェクト除去事例。出典: akhaliq/MOSS-Image-Edit-HQ
使い勝手の面では、モデルカードにGradioデモSpaceへのリンクもあり、品質モードと8ステップモードの両方が実行できるので、495 MBをダウンロードする前にトレードオフを確認できます。
知っておくべき制限
- VRAM: パイプラインはbf16で約20 GBを必要とします。カードは当然の疑問に直接答えています。いいえ、ベースモデルのint8コミュニティビルドでも6 GBでは動作しません。
- ベースモデル: MOSS-Image-SFTでトレーニングされています。BaseおよびKromossとの互換性は未検証と記載されており、ネイティブ経路が信頼できる方法とされています。
- 単一参照トレーニング: アーキテクチャは最大4つの参照を受け付けますが、アダプターは単一参照の編集ペアでトレーニングされています。ある写真の人物やオブジェクトを別の写真に合成することは、明示的にトレーニング対象外とされています。
- 色: 彩度をソース以上に押し上げるというv3の既知の傾向がユーザーによってモデルカード上で報告され、v4のマスク損失で対処されました。
- 範囲: 属性、除去、照明、顔、テキストの編集。ポーズ変更については何も述べられておらず、これは発表時の最初のコメントで求められたものです。
これはいずれもOpenMOSSのリリースではありません。重み、データ、評価グリッド、デモはすべて1人の作者によるもので、カードにもその旨が明記されています。
利用可能性
- LoRA: akhaliq/MOSS-Image-Edit-HQ、v5は2026年10月25日公開。
- ワークフロー:
armV5_workflow_single.jsonとarmV5_workflow_multi.json。 - デモ: Hugging Face Spaces上のmoss-image-edit-hq-demo。
- ComfyUI本体: PR #17296、2026年10月22日マージ、masterとナイトリーのみ。
- ノードパック: Chenkin-x/ComfyUI-Moss-Image-Edit、ComfyUI 0.42.3以降が必要。
- トレーニングデータとコード: moss-image-edit-conceptedit-packedとリポジトリの
training/ディレクトリ。
コメント
GitHubでサインインしてディスカッションに参加しましょう。