MOSS-Image MAX ULTRA LoHa: ComfyUIで4MP高解像度出力を実現
Comfyanonymous氏がMOSS-Image-Baseを4MP以上のキャンバス向けにトレーニングしたLoHaを公開。4096x2304の比較サンプル付きで4つのcheckpointバージョンをリリース。
MOSS-ImageはOpenMOSSによる5Bのテキスト・レイアウトモデルで、当サイトではリリース時に、few-step蒸留やいくつかのコミュニティ製ファインチューンとあわせて取り上げました。標準のサンプルワークフローは1024×1024で動作します。このアダプターは同じモデルをそのキャンバスのはるか上まで押し上げるものであり、これまでこのモデルに集まってきた低ステップ向けアダプターとは別種の問題です。
アダプターがターゲットとするもの
モデルカードは1段落だけで、目標を直接述べています。Comfy-Org/MOSS-Image向けのLoHaアダプターで、「4MP以上の解像度での生成を改善するためにトレーニングされた」ものです。トレーニングの構成は「おそらくアニメが多すぎる、写真との混合」で、3.5MPから10MPの範囲だと説明されています。
公開されている範囲はこれで全部です。カードには推奨の強度、ステップ数、サンプラー設定、サンプルレンダリング以外のベンチマーク数値は記載されていません。リポジトリ名は今も_testで終わっており、アダプターが完了したことや安定版に昇格したことを示す記述はありません。
4つのバージョン、1つのファイル構成
| バージョン | ファイルサイズ | 比較サンプル |
|---|---|---|
| v0.1 | 132,218,960 B | あり |
| v0.2 | 182,195,248 B | あり |
| v0.3 | 182,195,248 B | あり |
| v0.4 | 182,195,248 B | まだなし |
2つのサイズは、v0.2からv0.4がバイト単位で同一サイズであることから、新しいトレーニング実行ではなくv0.1とv0.2の間のレイアウト変更を示しています。リポジトリに変更履歴はありません。コミットは素のアップロードのみで、READMEが最新の図解付きバージョンとして示しているのは今もv0.3です。
サンプルから分かること
カードでは同じ比較を1セットとして公開しています。アダプターなし、v0.1、v0.2、v0.3です。AVIFファイルは4096×2304(9.4MP)、PNGのフォールバックは2736×1536(4.2MP)です。
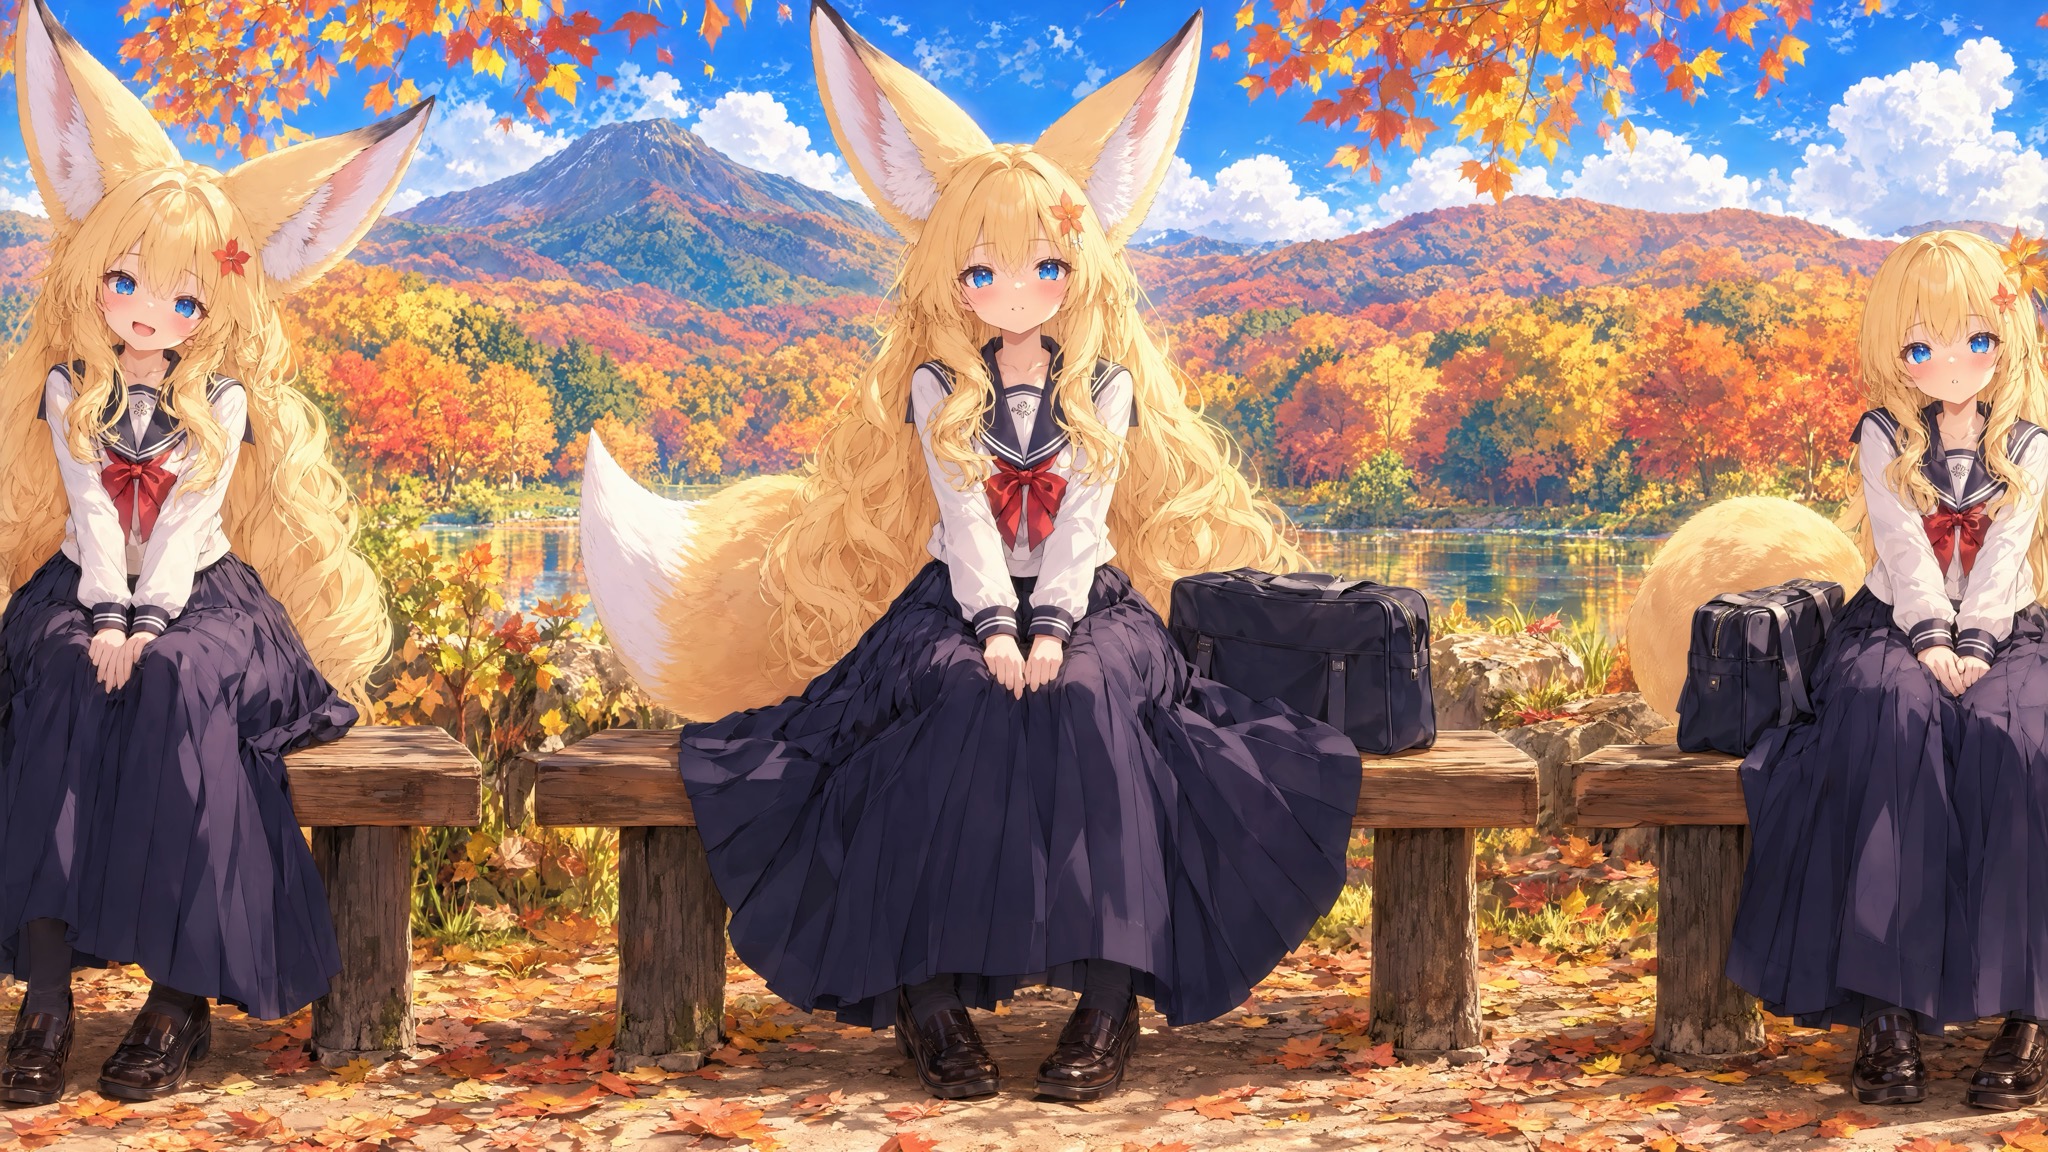 | 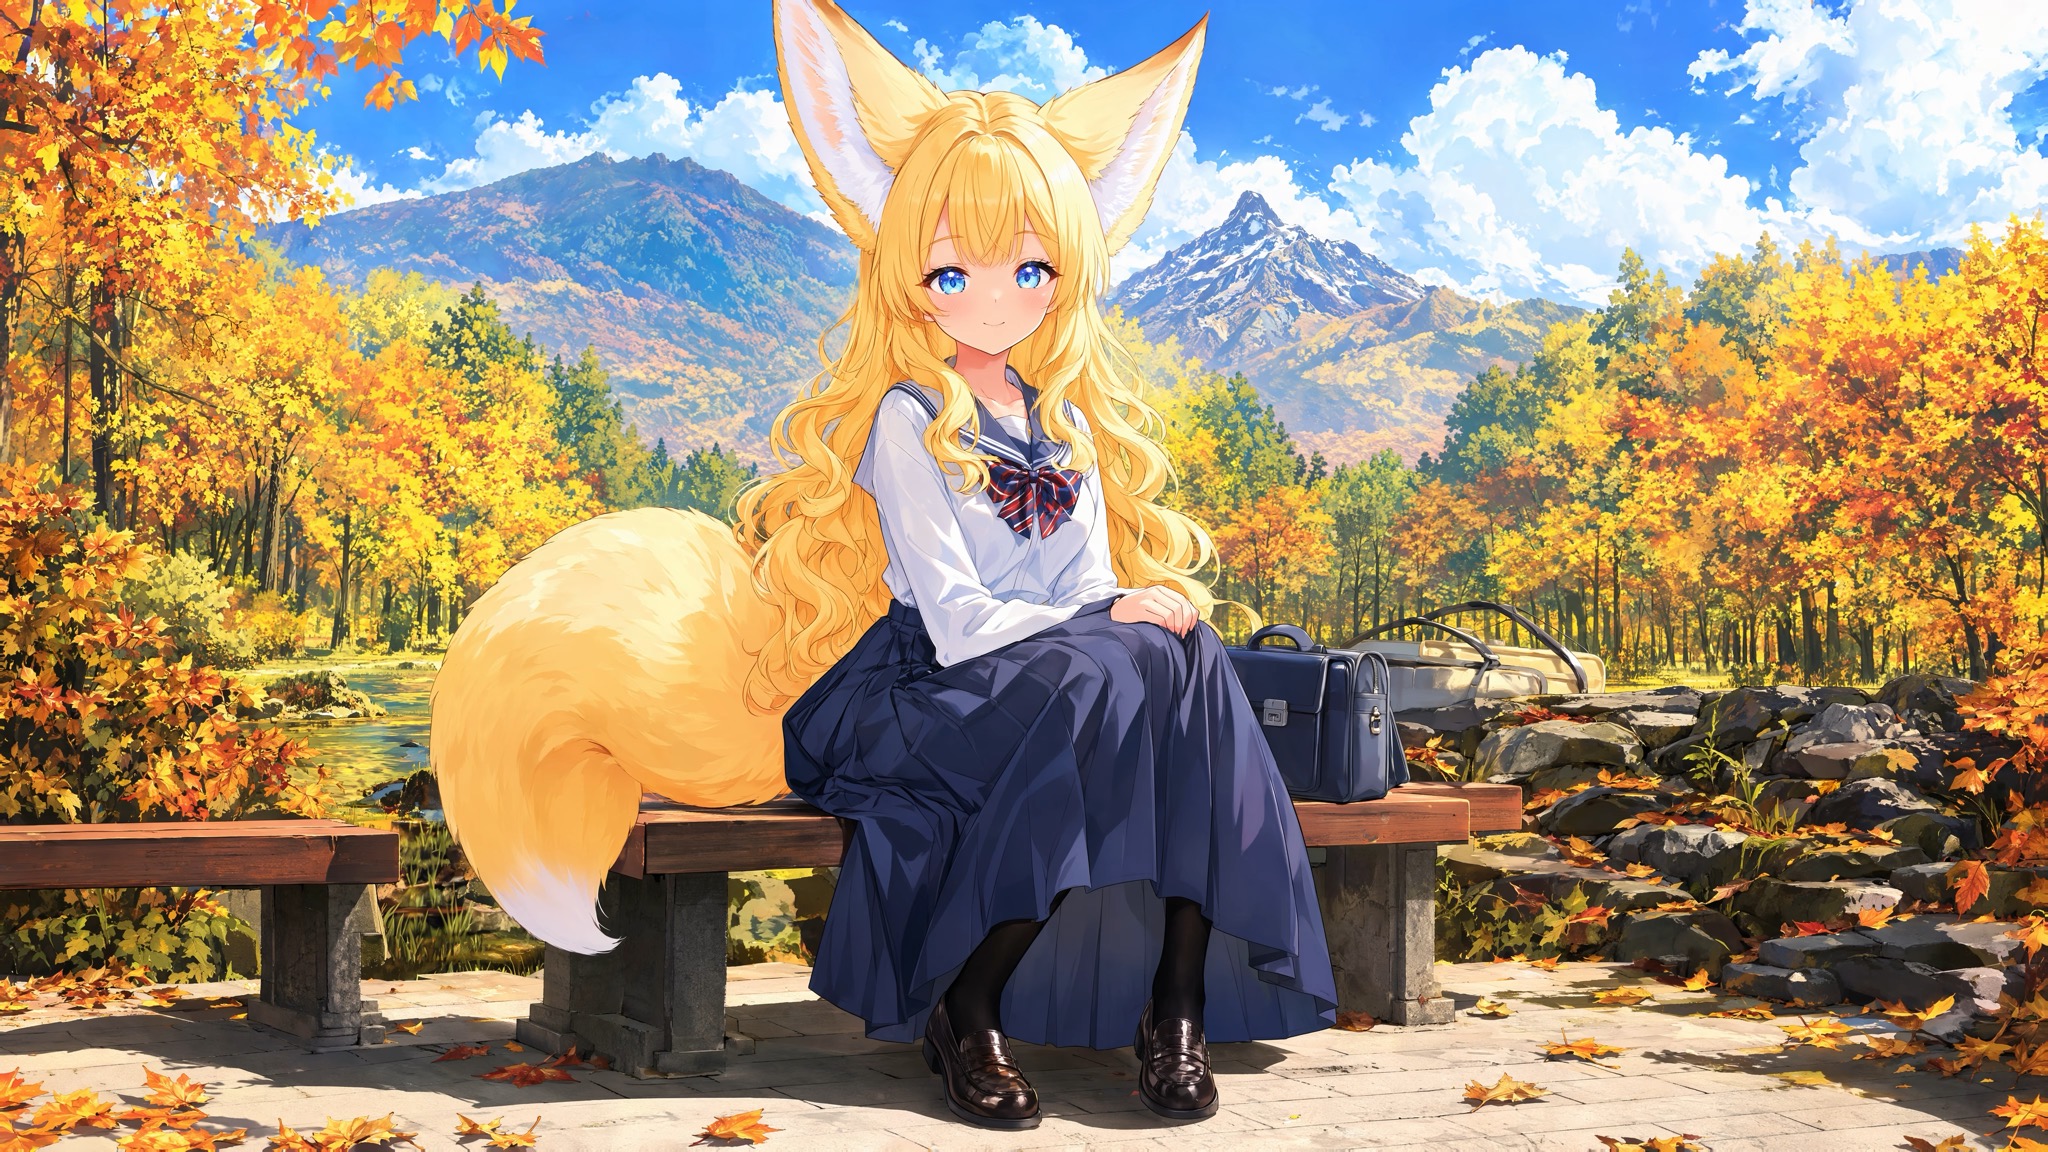 |
|---|---|
| アダプターなしの4096×2304レンダリング | 4096×2304でのLoHa v0.1 |
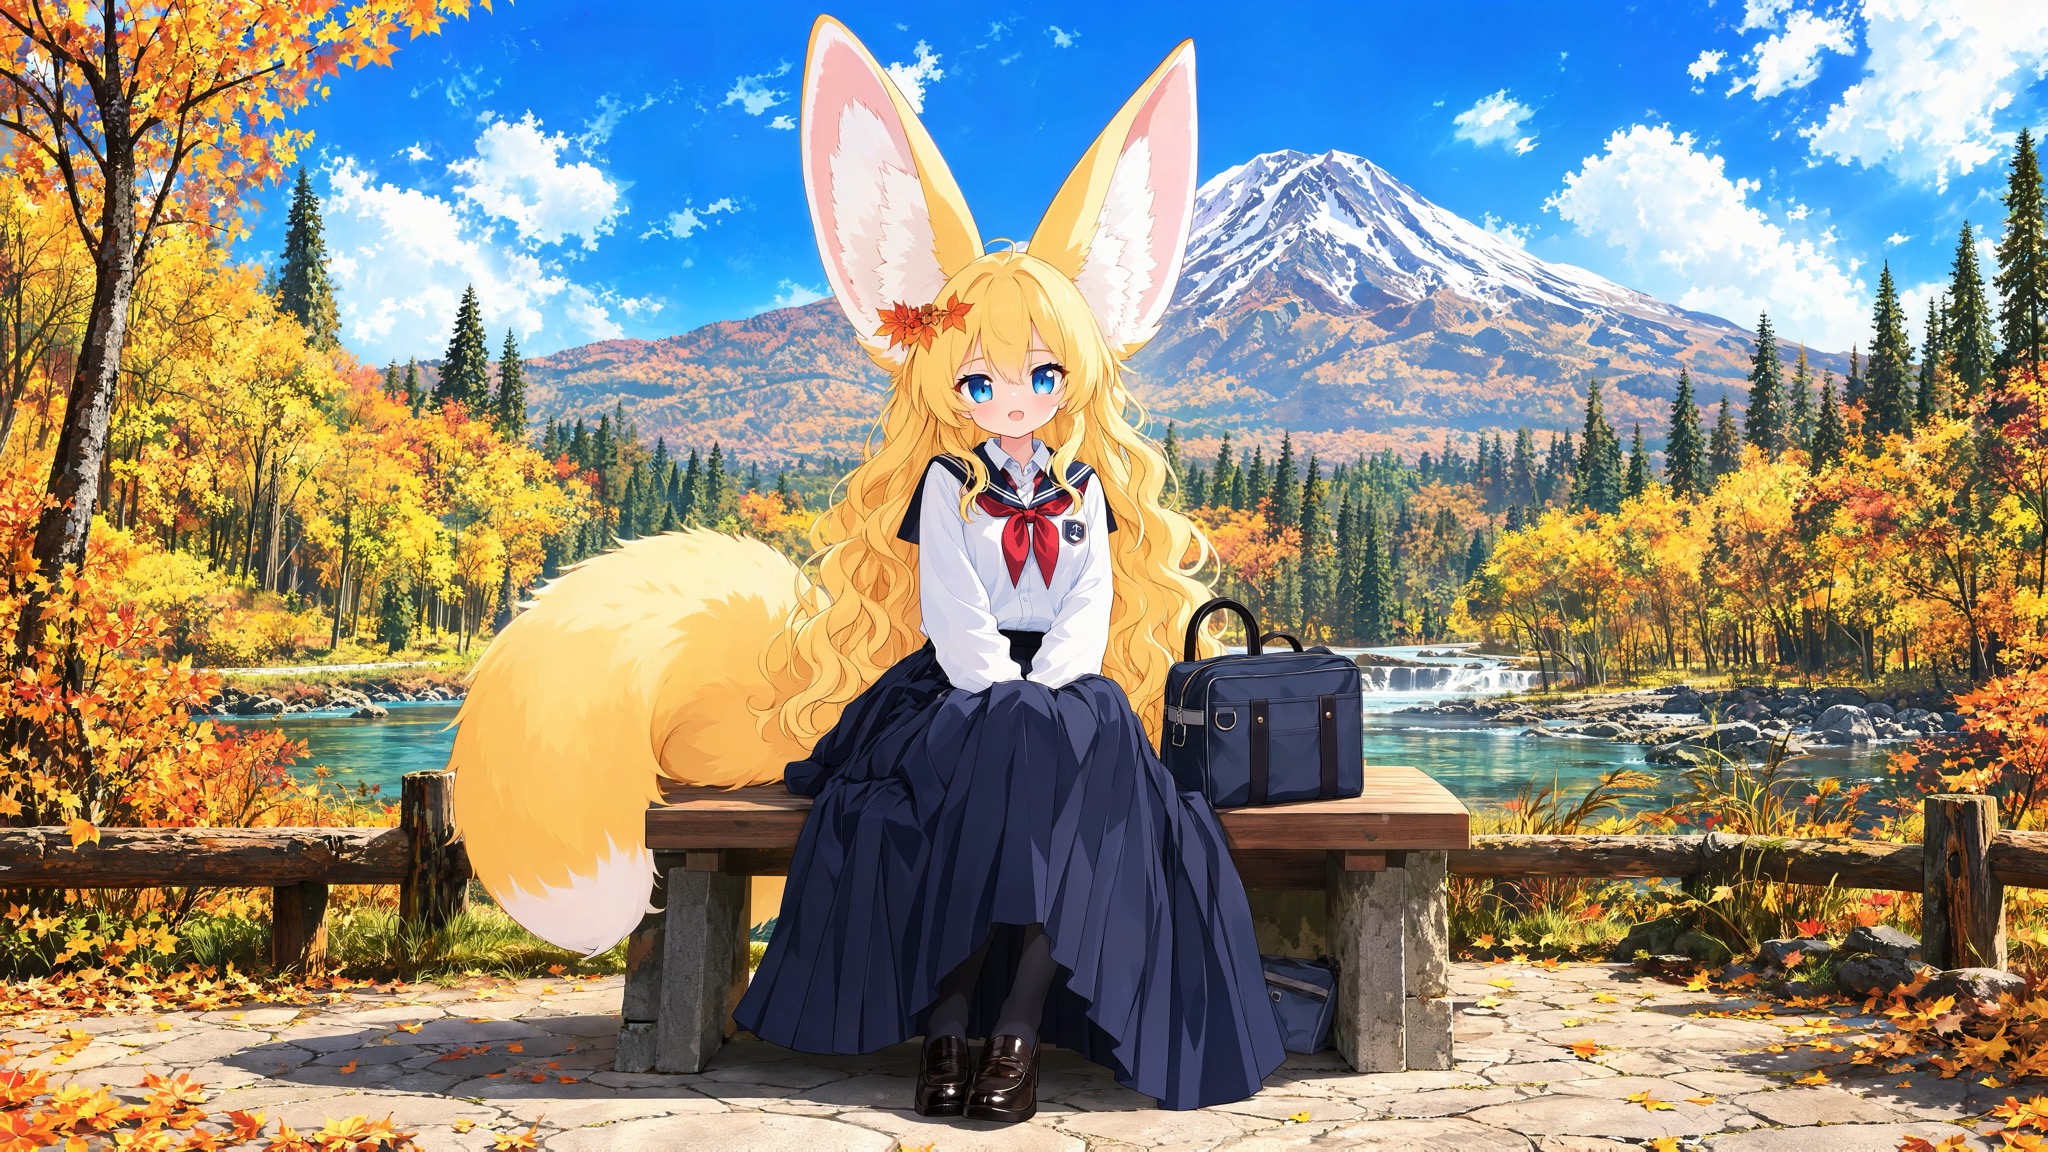 | 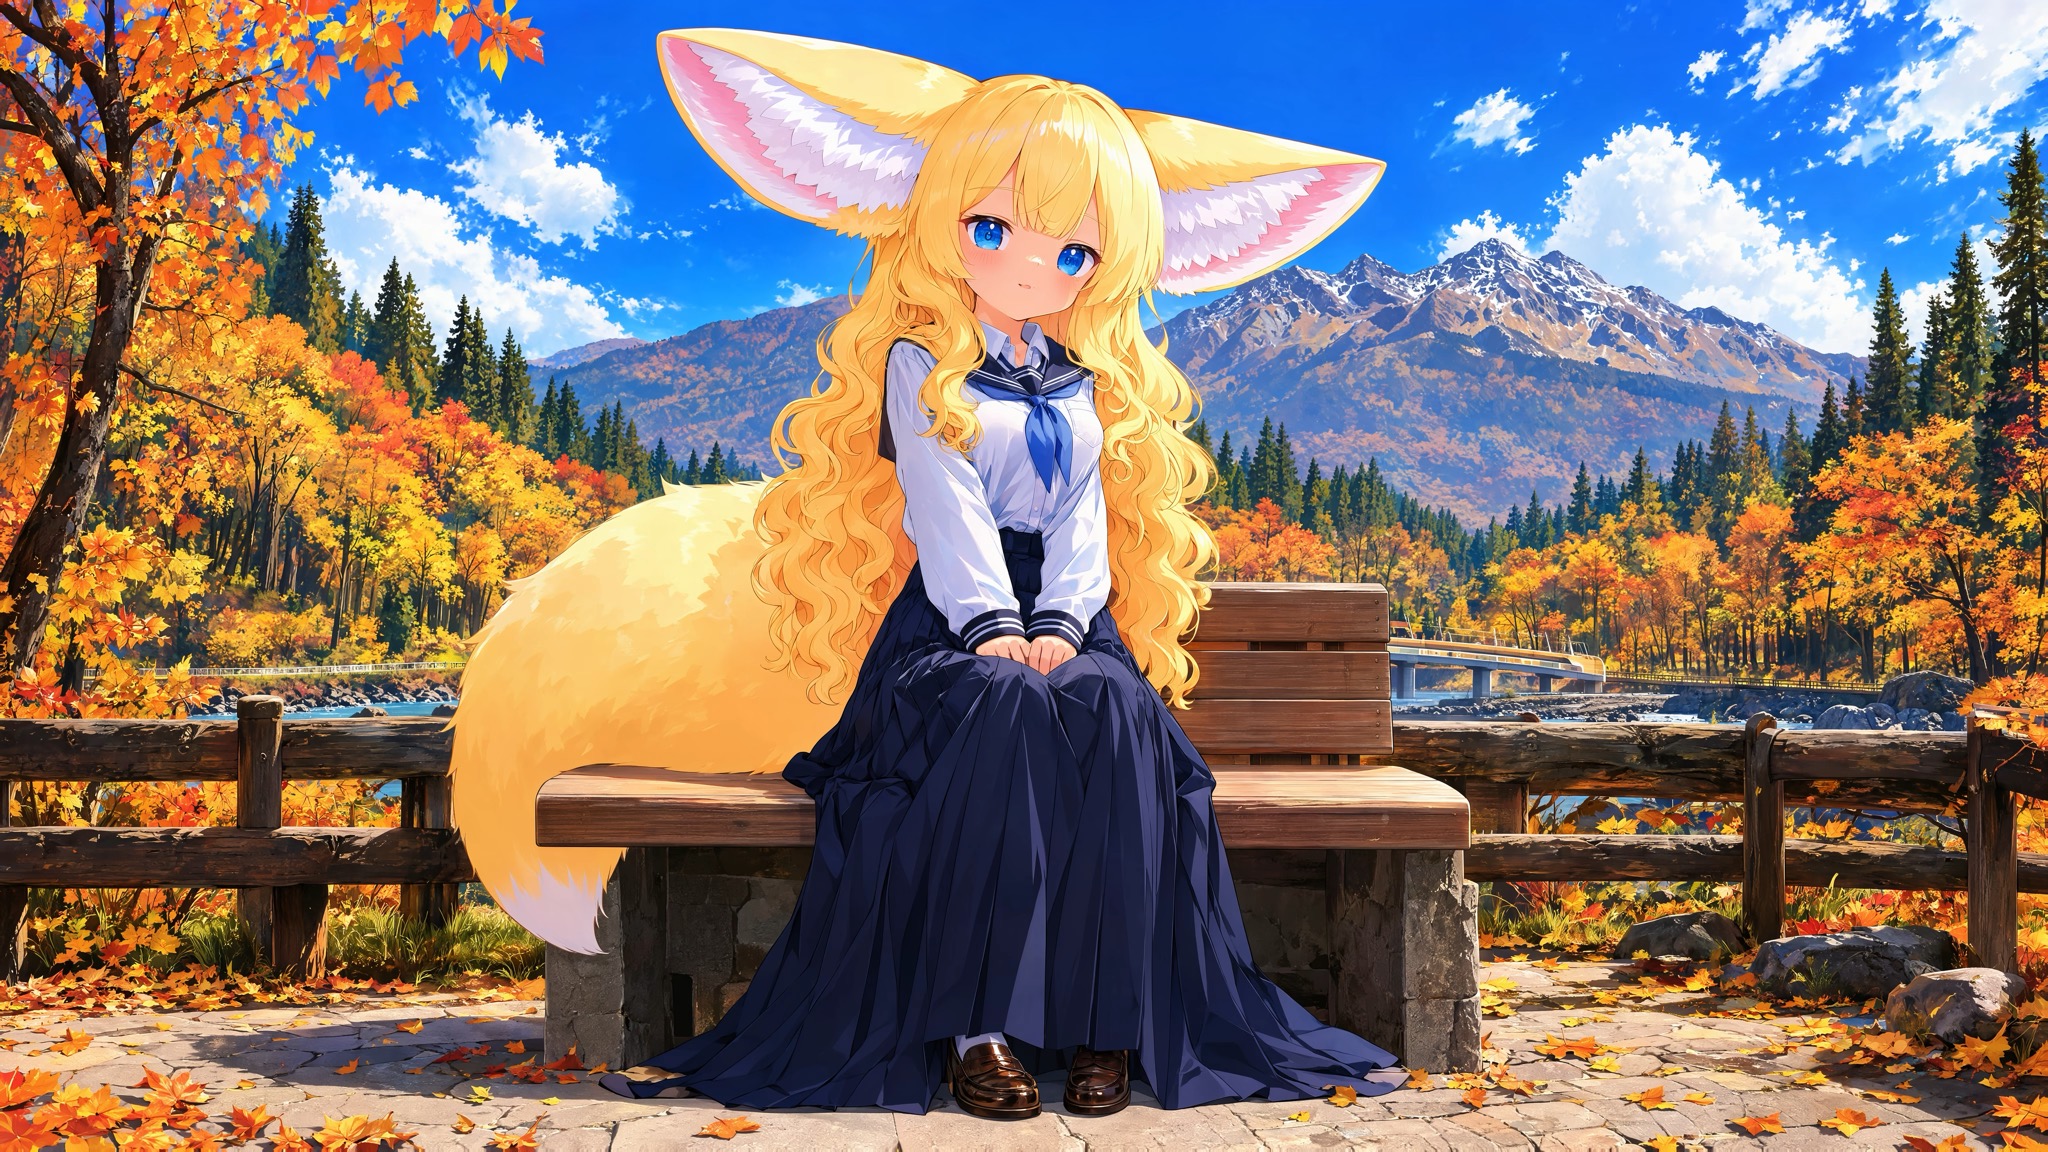 |
|---|---|
| LoHa v0.2 | LoHa v0.3 |
アダプターとともに公開されたサンプルセット。ソース: comfyanonymous/MOSS_image_MAX_ULTRA_hires_lora_test
ファイルの中身
ファイル名はloraですが、重みはLoHa、すなわちアダマール積分解です。safetensorsのヘッダーを読むと、モジュールごとにhada_w1_a、hada_w1_b、hada_w2_a、hada_w2_bとalphaからなる600個のテンソルがあり、通常のLoRAのlora_down/lora_upのペアではありません。
42レイヤーのDiT全体でカバレッジは均一ではありません。120個の適用モジュールの内訳は、全42レイヤーのqkv、全42のffn_up_gate、21のo、15のffn_downで、ランク16、32、64が混在しています。キーにはdiffusion_model.のプレフィックスが付いており、ファイルはすでにComfyUIの命名になっています。
ComfyUIでの読み込み
新しいノードもノードパックもありません。ComfyUIのコアにはLoHaの重みアダプター(comfy/weight_adapter/loha.py)が同梱されており、標準のLoRAローダーがhada_*キーを見つけると自動的にこれを選択します。グラフは通常のMOSS-Imageのものです。
Load Diffusion ModelにComfy-Org/MOSS-Imageの単一ファイル重みを指定。カードがベースとしてMOSS-Image-Baseを挙げているため、moss_image_base_bf16.safetensorsまたはそのint8 ConvRot版のいずれかになります。LoraLoaderModelOnlyにmoss_hires_lora_test_v0.*.safetensorsのいずれかを指定。- 空の潜在をターゲットのキャンバスに設定。公開サンプルは4096×2304で、リポジトリ内のすべてのサイズは16の倍数です。
アダプターにトリガーワードはなく、カードには条件付けの変更についての記述も一切ありません。
コミュニティの反応
このアダプターを世に広めたRedditスレッドは、u/Crazy-Repeat-2006が「MOSS Image - MAX ULTRA hires by ComfyUI Team」というタイトルで投稿したもので、いつも通りの賛否両論を呼びました。あるコメント投稿者はキャンバスの大きさは認めつつ結果は認めず(「解像度は大きくなったが、耳は小さくなった。納得していない」)、別のサブスレッドではLoHaとは何かが説明され、アダマール積のアダプターは品質よりも主にメモリを節約するものだと論じられています。スレッド内で比較対照実験を報告するコメントはなく、カード自体もそれを主張していません。
これが証拠の正直な現状です。信頼できる作者によるアダプターで、実在するギャップを狙ったものですが、サンプルレンダリングはあるもののベンチマークも安定版もありません。
入手方法
- アダプター: comfyanonymous/MOSS_image_MAX_ULTRA_hires_lora_test、4バージョン、132MBから182MB。
- ベース重み: Comfy-Org/MOSS-Image、
moss_image_baseとmoss_image_sftをbf16とint8 ConvRotで収録し、さらにQwen3.5-9BのテキストエンコーダーとFLUX.2 VAEを含みます。 - 上流モデル: MOSS-Image-BaseとMOSS-Image-SFT。
コメント
GitHubでサインインしてディスカッションに参加しましょう。