MOSS-Image Edit LoRAがComfyUIに指示ベース編集を追加
rank-64の編集LoRAにより、1〜4枚の参照画像を使ったMOSS-Imageの指示ベース編集が可能になり、同日にComfyUI本体へネイティブなedit-LoRAサポートがマージされました。
MOSS-Imageは、当サイトがリリース時に取り上げたOpenMOSSの5Bテキスト・レイアウトモデルです。読みやすいテキスト、JSONレイアウトボックス、そして同じ週にリリースされたComfyUI本体実装を備えています。しかし欠けていたのは、既存の画像を受け取って変更する方法でした。編集といえばレイアウト編集やcontrol adapterであり、「この人物に別のジャケットを着せる」ことではありませんでした。
新しいアダプタはその隙間を埋めます。OpenMOSSではなくコミュニティによるリリースですが、ComfyUIのメンテナが本体サポートを接続する際の実装となっています。
LoRAが変えるもの
モデルカードは範囲を率直に説明しています。色、服装、照明、季節、視覚スタイルを、テキスト指示と最大4枚の参照画像で制御します。指示が「何を変えるか」を伝え、参照画像が「何を残すか」を担います。
LoRAとともに公開された事例グリッド。出典: chinoll/Moss-Image-Edit
参照画像が複数ある場合、アダプタ自体は役割を割り当てないため、指示の中で各画像を指定する必要があります。ノードパックのプロンプト例は Dress the person in image 1 in the outfit from image 2. です。
仕組みとしては、このアダプタは小さくオーソドックスです。safetensorsヘッダーを調べると、42層すべてのDiTレイヤーにわたり504個のテンソルがあり、各レイヤーに6つの射影(q、k、v、o、ffn_up_gate、ffn_down)がrank 64、alpha 64で存在します。adapter_config.json は moss-edit-lora フォーマットのバージョン1を宣言し、トレーニング契約として ref-prefix-only-t0__target-text-original-moss-v1 を記録しています。これはComfyUIが現在 Moss-Image-Edit という名前で実装しているレイアウトです。
同じ重みはMOSS-Image-BaseとMOSS-Image-SFTのどちらでも動作します。Baseはトレーニング信号をより多く保持し、SFTはより整った出発点です。参照カードの事例はSFTに対してトレーニングおよびサンプリングされています。
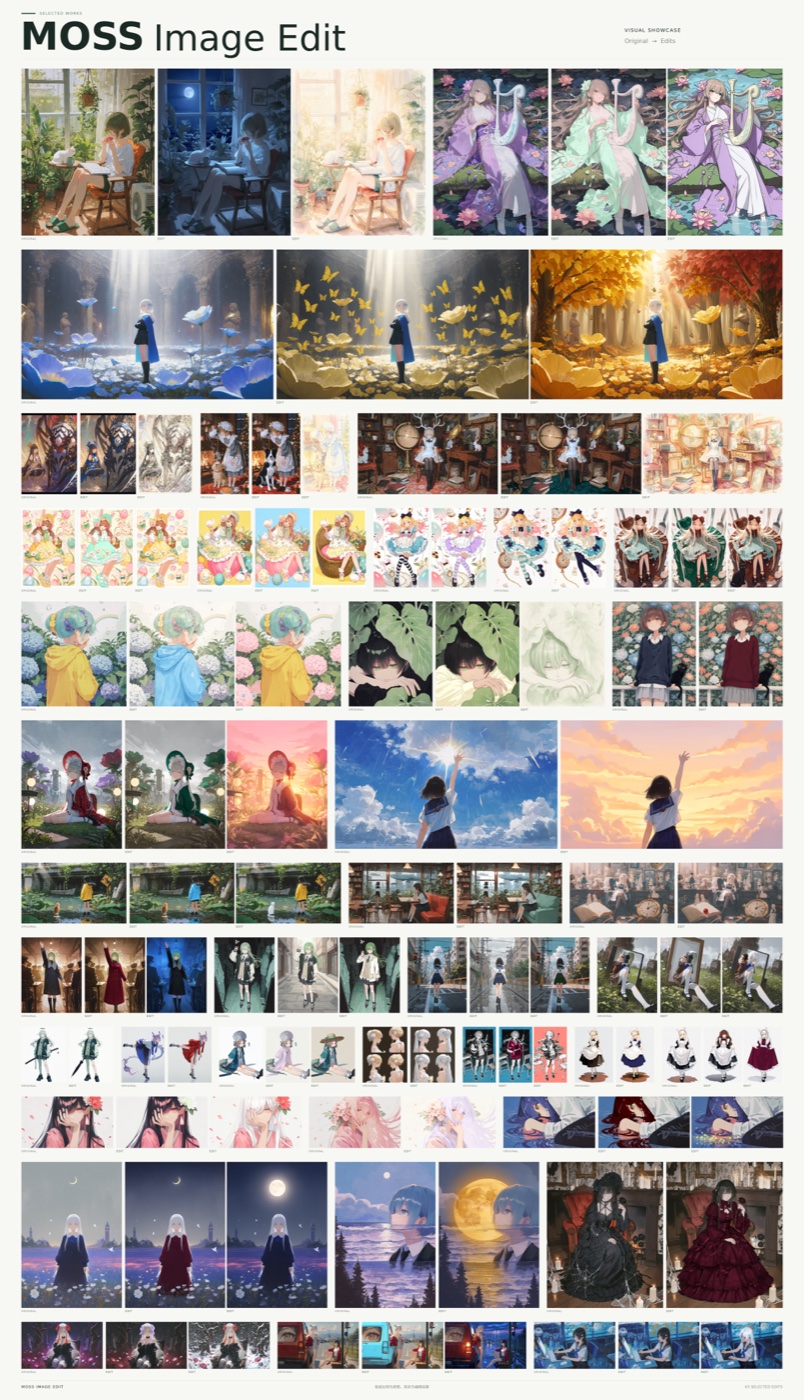
プロジェクトリポジトリの編集ショーケース。各グループは元画像から始まり、その編集結果が続きます。
ComfyUI本体のパス
KijaiによるPR #17296は、model/conditioning/moss_image 配下に Text Encode MOSS-Image Edit ノードを追加します(依然として実験的フラグ付き)。clip、prompt、vae、edit_format の選択肢、そして自動拡張される画像セットを入力に取ります。興味深いのは edit_format セレクタで、編集LoRAが相互互換ではないという事実をエンコードしています。
| オプション | 参照レイアウト | テキストエンコーダが参照を認識 |
|---|---|---|
ai-toolkit | index_timestep_zero_isolated | はい、Picture N: としてプレフィックス |
ai-toolkit (kv_cache off) | index_timestep_zero | はい、参照が毎ステップ生成画像にアテンション |
Moss-Image-Edit | index_timestep_zero_text_start | いいえ |
Moss-Image-Edit レイアウトでは、ビジョンタワーが参照画像を一切受け取らないため、指示だけで編集内容を記述する必要があります。外観はすべてDiTに注入される参照latentから来ます。ai-toolkitでトレーニングされたアダプタでは、参照画像は最大384×384に縮小され、Picture N: トークンとしてプロンプトの先頭に追加されます。
アダプタは標準のLoRAローダーで読み込めます。PRがこれらのファイルで使われる素の layers.N.proj.q キー形式のエイリアスを追加したためです。つまりネイティブルートは、Comfy-Org/MOSS-Imageの単一ファイル重みを使った通常のMOSS-Imageグラフに、LoRAローダーと新しいテキストエンコードノードを加えたものです。参照画像は別個のlatent入力ではなく、画像としてノードに接続します。
PRは新機能ではなく速度改善も報告しています。分離レイアウトでは参照のブロックごとのK/Vが毎ステップではなく extra_conds で一度だけ計算され、1MPの参照を使った1024²の場合、1ステップあたり826 msから457 msになります。このサポートはv0.42.1タグの後にマージされたため、リリース版のインストールではそのタグより後のバージョンに更新する必要があります。
ノードパックのパス
同じ作者は自己完結型のノードパック、Chenkin-x/ComfyUI-Moss-Image-Editも公開しています。10月22日に登場し、MOSS Image Edit カテゴリの下にローダーと編集ノードの両方を追加します。コアノードではなく独自のMOSSランタイムのコピーを実行し、単一ファイルの再パックではなく完全なDiffusersスナップショットを要求します。
ComfyUI/models/moss_image/
├── MOSS-Image-SFT/          # pipeline_moss_image.py, transformer/, text_encoder/, tokenizer/, vae/, scheduler/
└── Moss-Image-Edit/         # adapter_config.json, adapter_model.safetensors
ローダーの snapshot_dir はベースモデルを、adapter_dir はアダプタを指します。2つのワークフローが同梱され、1つは単一参照用、もう1つは2参照用です。3枚または4枚にするには、空いている reference_3 と reference_4 入力に Load Image ノードを追加します。ドキュメント記載のデフォルトは、出力512×512、30ステップ、CFG 4.0、inference_shift 5.0、参照の長辺512でクロップなしです。
| 設定 | デフォルト | 備考 |
|---|---|---|
width / height | 512 / 512 | 16の倍数 |
reference_max_edge | 512 | 16に整列、クロップなし |
steps | 30 | |
cfg | 4.0 | |
inference_shift | 5.0 | サンプリング時間分布 |
seed | 42 | デフォルトで固定 |
参照画像がDiTに届く仕組み
どちらのルートも同じ仕掛けに依拠しています。参照画像はVAEでlatentトークンにエンコードされ、独自のRoPEインデックスで、タイムステップ0において画像シーケンスに追加され、互いにのみアテンションします。これらのトークンはサンプリングループ中に変化しないため、ブロックごとのK/Vを一度キャッシュして再利用でき、これによりテキストエンコーダのトレーニングなしのrank-64アダプタでも、指示が残りを書き換える間アイデンティティを保持できます。
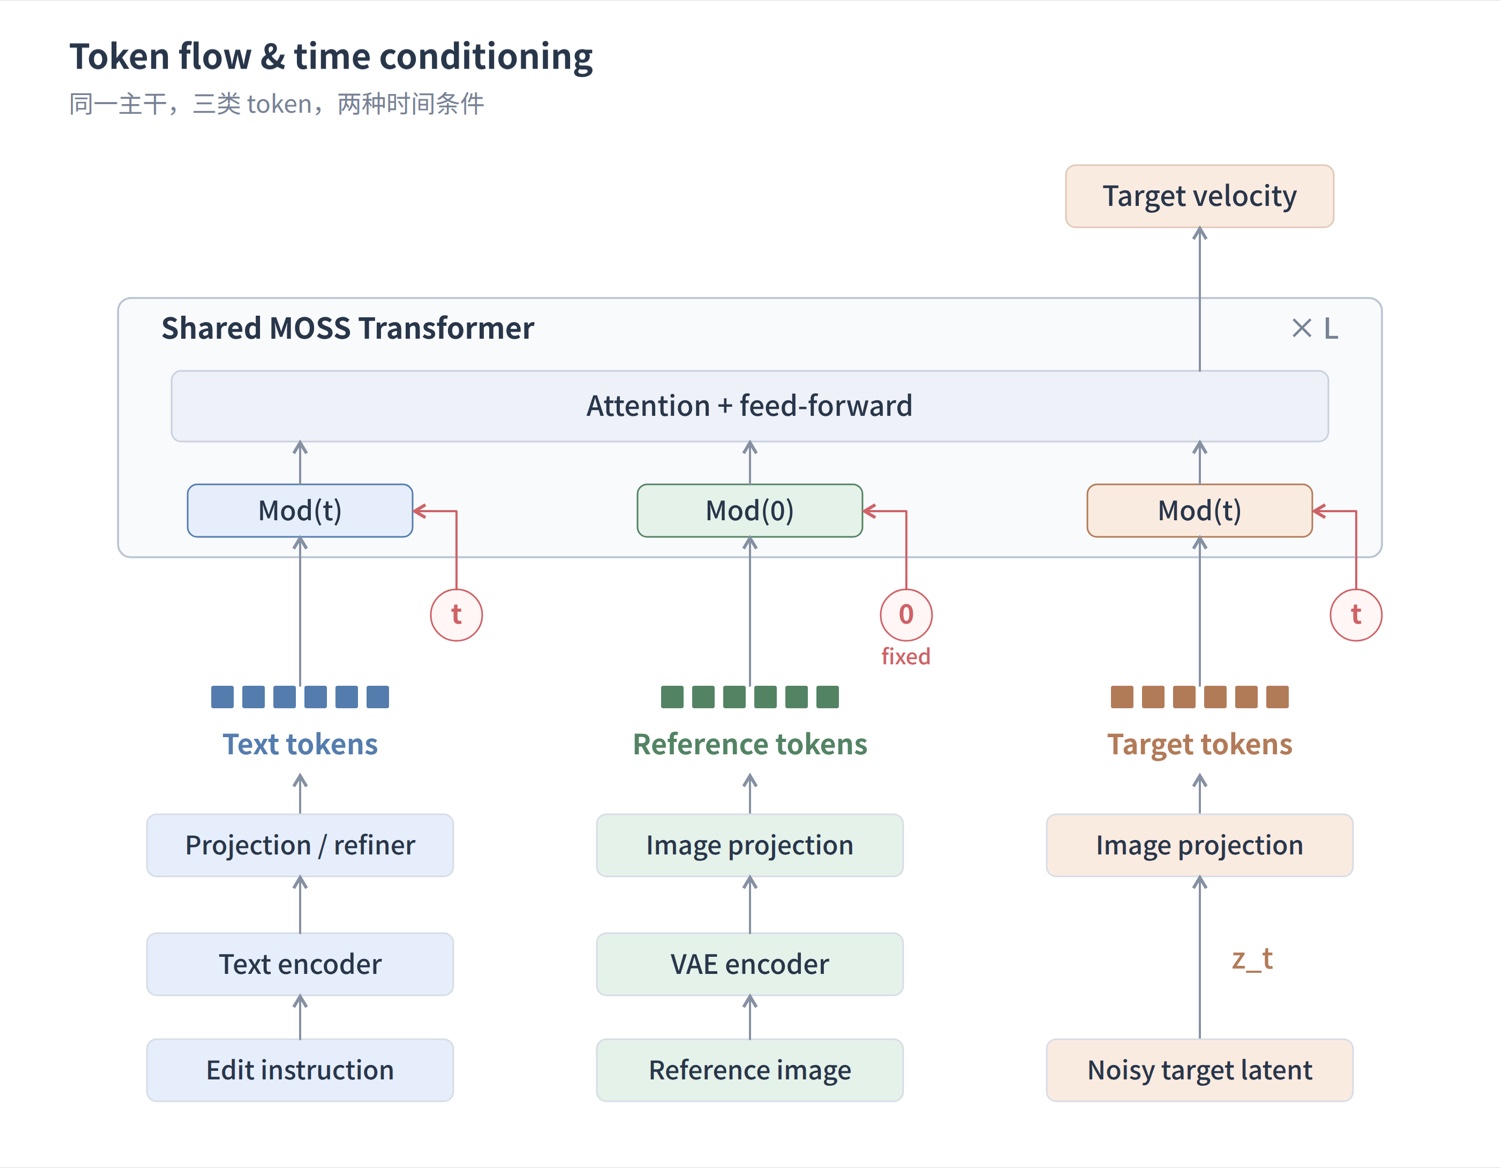
トレーニングリポジトリの参照KVキャッシュ図。生成済みトークンの隣にキャッシュされた参照ブロックが示されています。
トレーニングリポジトリは重みだけでなくレシピ全体を公開しています。データ準備、設定、推論スクリプトです。トレーニングデータはNOOB2のペアにConceptEdit-12Mセットを加えたもので、指示は instruction.detailed_en から取得し、元画像と編集画像はVAEで一緒にエンコードされ、両画像とも長辺が max_edge 未満に収まるようクロップやパディングなしでスケーリングされます。ガイドでは4プロセスの torchrun、パッチを当てた adjust_lr_fn 経由のZeRO-2上のDeepSpeed Muon、varlenパッキング付きFlash Attention 4、トレーニング中にint8へ量子化されたテキストエンコーダで起動します。検証サンプルは生成/ソース/ターゲットのトリプレットとともにステップごとに書き出されるため、リポジトリ内のチェックポイントは再現または拡張できます。
知っておくべき制限
このLoRAは297 MBのbf16アダプタで、ベースモデルに比べれば小さいものの、汎用エディタではありません。公開されている範囲は属性とシーンの編集です。色、服装、照明、季節、スタイル、さらに表情です。カードにはオブジェクトの挿入は記載されておらず、ベンチマークも公開されておらず、2つの被写体を1つのシーンに合成することについても言及がありません。前述のとおり、複数参照の編集はプロンプトが役割を割り当てることに依存します。またこれはOpenMOSSの公式リリースではありません。重み、ノードパック、トレーニングコードはすべて1人の作者によるもので、ComfyUIのメンテナがレビューしたのはコアPRのみです。
入手方法
- LoRA: chinoll/Moss-Image-Edit、執筆時点で約21のいいね、アップロードから1日後。
- ComfyUI本体: PR #17296、2026年10月22日にv0.42.1リリース後にマージ。
- ノードパック: Chenkin-x/ComfyUI-Moss-Image-Edit、単一参照および複数参照のワークフロー付き。
- トレーニングと推論のコード: Chenkin-x/Moss-Image-Edit、
prepare_data.py、configs/train.json、infer.pyを含みます。 - ベースモデル: MOSS-Image-BaseとMOSS-Image-SFT、単一ファイルのComfyUI重みはComfy-Org/MOSS-Imageにあります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。