MOSS-Image SFT Destripe LoRAがComfyUIで垂直ストライプを削除
1.9 MBのLoRAが、MOSS-Image SFTが空や平坦な背景に描く淡い垂直のカラーストライプを削除します。標準のComfyUI LoRAローダーで読み込めます。
MOSS-Image SFT は、空、霧、無地の壁、スタジオ背景といった滑らかな領域に、淡い垂直カラーストライプの規則的なパターンを描画します。10月18日、nynxz は 1.9 MB の LoRA SFT Destripe を公開しました。これはストライプを削除しつつ、SFTモデルのほぼ他のすべてをそのまま保ちます。再学習ではなく重みのパッチであり、カスタムノードも新しいチェックポイントも不要で、本サイトがリリース時に取り上げたモデルの後に LoraLoaderModelOnly を1つ置くだけです。
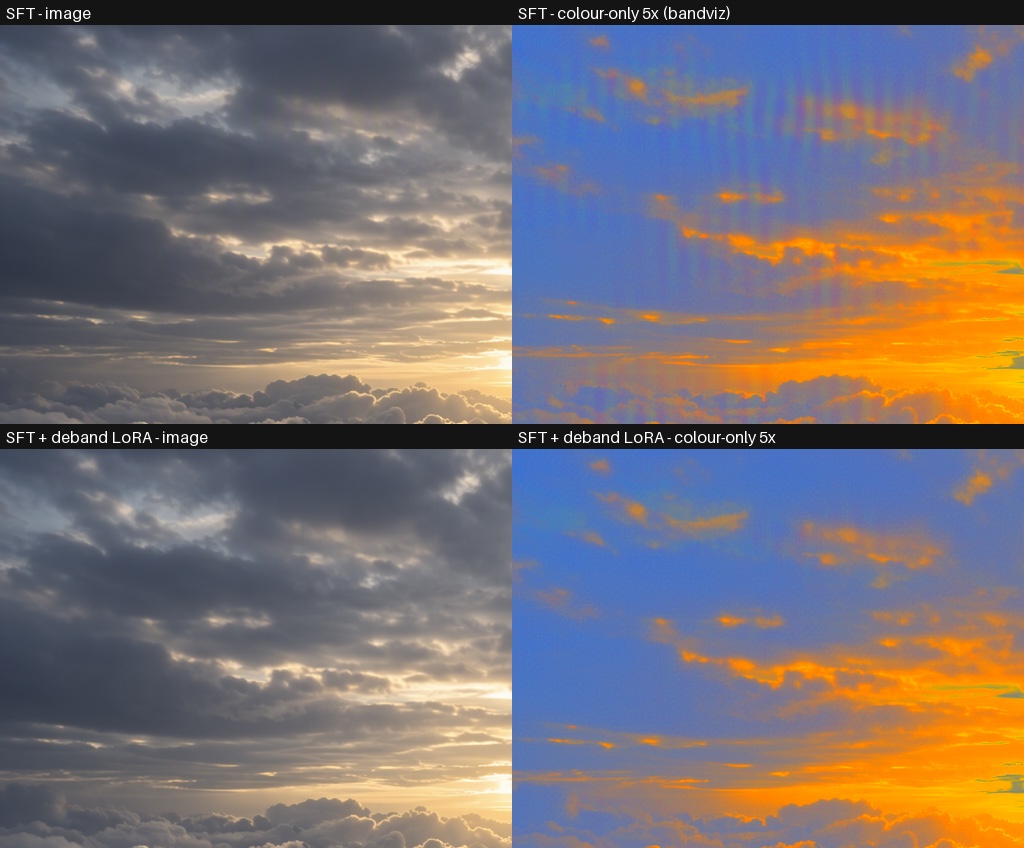
上段: SFTの出力。そのままの画像と、輝度を除去して彩度を5倍に強調した画像。下段: 同じプロンプトとシードで Destripe LoRA を強度1.5で適用した画像。ストライプは輝度のずれではなく色のずれであるため、そのままの画像でも残ります。ソース: nynxz/MOSS-Image
ストライプの正体
このアーティファクトは通常の表示では見落としやすく、色を強調すると一度見たら忘れられなくなります。固定の周期を持ち、幅768 pxでは約16 px、幅1024 pxでは21.3 pxとなります。どちらの場合も画像幅全体で48周期になります。周期が幅に比例するため、センサーノイズやタイルの継ぎ目には見えません。モデルが描くことを学習したパターンのように振る舞います。
ユーザーはリリースから数日のうちにSFTリポジトリで報告しました。最初の報告スレッドは10月16日にサンプル画像とともに投稿され、そこでの推測はVAEの誤りから蒸留教師モデルのアーティファクトまで多岐にわたりました。いずれも確認されていません。スレッドは現在もオープンで、OpenMOSSは説明を公開していません。
1.9 MBのLoRAがストライプを削除する仕組み
このLoRAは学習されたものではなく、BaseとSFTの差から抽出されています。概要は次のとおりです:
- SFTの252個のリニアレイヤーそれぞれについて、Baseからの重みの差分を取り、SVDでランク1の方向に分解します。各方向は、ファインチューニングが追加した「入力パターンから出力パターンへの」ルール1つに相当します。
- 各方向がストライプにどれだけ寄与するかでスコアを付けます。ストライプは、モデル自身の予測における48周期の列パターンのエネルギーとして、それが形成されるサンプリング初期ステップで測定されます(ファイルのヘッダーには25ステップ実行の4〜13ステップ、ER-SDE、CFG 2.5、768 px、2シードが記録されています)。1回の逆伝播で、各方向を加えたときにそのストライプエネルギーがどれだけ速く増えるかが得られます。
- スコアの高い64個の方向を減算します。それらはレイヤー24〜41の25個の行列に存在し、11個がMLPの
ffn_up_gate、残りはffn_down、q、k、v、o にあります。ランクは1〜7で、ファイルが1.9 MBなのはそのためです: 保存される数値は945,152個です。MATLOWAIの重み分析によれば、これはSFTのBaseからの総変化のエネルギーの約0.09パーセントに相当します。
方向のスコアリングにより、ファイルを小さくしつつ効果を鈍らせずに済んでいます。以前の2つの修正はレイヤー全体をBaseに戻し、その代償としてドリフトが生じました。このLoRAは、それらのレイヤー内でストライプを担う方向だけを削除します。因果関係の確認として、同じ方向を逆符号で適用するとストライプは約22倍強くなります。
ComfyUIでの使用方法
moss_sft_destripe_top64_bf16.safetensors を ComfyUI/models/loras/ に置き、MOSS-Image SFT(Comfy-Org/MOSS-Image の moss_image_sft_bf16 または moss_image_sft_int8_convrot)を読み込み、LoraLoaderModelOnly を追加して、幅に応じて強度を設定します:
- 768 px では 1.0
- 1024 px では 1.5
1024 pxでは、強度1.0で12枚のテスト画像のうち6枚のストライプが消え、残りには淡い痕跡が残ります。強度1.5では12枚中1枚まで減り、2.0は1.5より良くはならず、SFTからさらに離れます。このLoRAはSFT自身の変化から作られているため、Baseでは有用な効果がありません。キーは diffusion_model. プレフィックスを使用しており、標準のローダーがそのままマッピングします。
ローダーに関する注意点が同じリポジトリから出ています。Load LoRA (Bypass) を使用すると、融合されたComfy-Orgチェックポイントではq/k/vアダプターが破棄されますが、このLoRAはいくつかのレイヤーでq、k、vに作用します。融合ファイルでは通常のパッチ適用は問題ありません。
作者の数値が示すもの
ブラインドテストでは、大きな滑らかな領域を持つ4つのプロンプト(砂丘、無地の壁、開けた水面、ぼかした背景のポートレート)を各3シードで使用し、いずれも修正の構築には使われていません。スコアはMATLOWAIの bandviz 指標で、低いほどバンディングが少なく、約16以下ならクリーンと見なされます。
| モデル | bandviz, 768 px | ストライプが依然として最大ピーク | SFTとのSSIM |
|---|---|---|---|
| SFT | 9.8 | 12枚中9枚 | 1.000 |
| SFT + Destripe @ 1.0 | 4.2 | 12枚中1枚 | 0.995 |
| Base(参照用) | 4.2 | 12枚中5枚 | 0.876 |
1024 pxでは、素のSFTはスコア24.0で12枚中11枚においてストライプが最大ピークです。LoRAを1.5で適用するとスコア5.9、12枚中1枚となり、Baseの4.0と対比されます。画像はSFTが生成したものと99パーセント以上類似したままです。
平坦な色は、アーティファクトが最も見えやすく、最も削除しにくい領域です。単色の領域ではストライプが隠れる場所がないためです:
 |  |
|---|---|
| 単色のベージュ背景、素のSFT | 同じプロンプトとシード、LoRAを1.5で適用 |
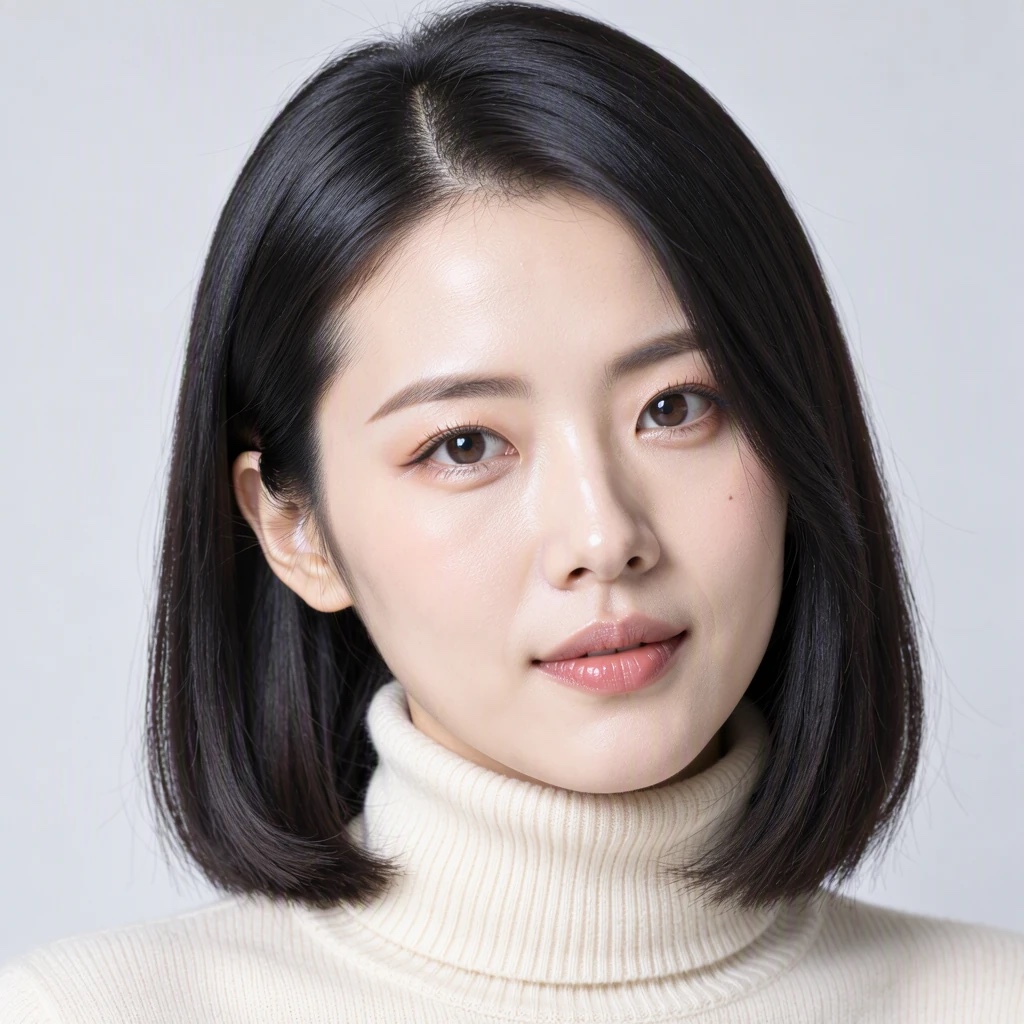
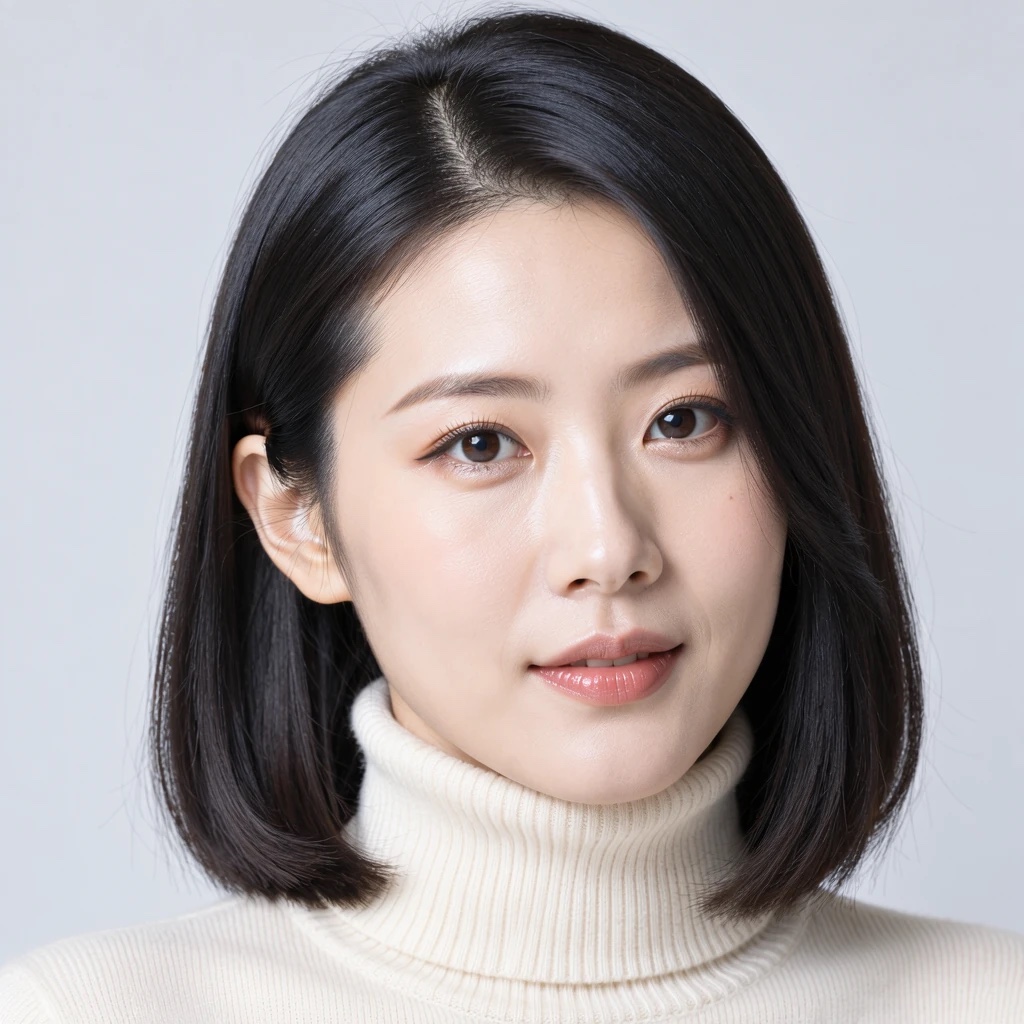
顔はこのトレードオフのもう一方の端で、強引な修正が柔らかくしがちな画像の部位です:
 |  |
|---|---|
| ポートレート、素のSFT | 同じプロンプトとシード、LoRAを1.5で適用 |
MATLOWAIのベンチマークによる第三者製のレンダリング。ArcFaceで同一性を測定しており、スタンダードプリセット設定で0.94、LoRA独自のサンプラー設定で0.96です。ソース: MOSS-Image-SFT-DeBand
第三者による検証
最も強力な外部の証拠はMATLOWAIによるものです。MATLOWAIはこのLoRAが存在する前に、同じストライプの調査とレイヤーを戻す一連の修正をすでに公開していました。そのベンチマークには今回Destripe LoRAが他の選択肢と直接比較する形で加わり、トレードオフの穏やかな側として報告されています:
| 修正 | 単色領域、中央値 dB | 最悪ケース | 顔の類似度 |
|---|---|---|---|
| Destripe @ 1.0 | −3.2 | −1.9 | 0.94 |
| Destripe @ 1.5 | −3.9 | −1.8 | 0.94 |
| Destripe @ 1.5、独自のサンプラー設定 | −4.6 | −3.0 | 0.96 |
| Baseモデル(参照用) | −16.6 | −10.4 | 0.45 |
同じ記事はトレードオフを率直に述べています。このLoRAは平坦な色の領域を部分的にしかきれいにせず、およそ−4 dBであるため、ストライプは淡くなるものの、彩度を強調した表示では依然として見える可能性があります。レイヤーを戻す修正はそこまで到達しますが、画像全体が動くという代償を伴います。READMEでは現在、可能な限り小さな変化を望む人にはこのLoRAを、最もクリーンな平坦背景を必要とする人にはより重い修正を案内しています。
制限
- 測定はER-SDE、25ステップ、CFG 2.5での768 pxと1024 pxを対象としています。他のサンプラー、ステップ数、解像度は未検証であり、バンディングはシードごとに大きく変動します。
- この修正は設計上部分的です。64個の方向を、1つの解像度での一次推定でスコアリングしています。より広い画像(1536 px以上)では別の、より波打ったストライプが描かれ、このLoRAはそれに対してスコアリングされていません。
- OpenMOSSからの公式な発表はありません。作者が19日にSFTリポジトリに投稿した記事では、SFTのデータパイプラインが位置スケーリング、バケッティング、画像のリサイズを使用したかどうかを尋ね、方向ごとのスコアを提供していますが、執筆時点で返信はありません。
リポジトリのその他の内容
同じリポジトリには、両方のMOSS-Imageチェックポイントのq/k/v分割版も含まれています。各アテンションレイヤーのq、k、vは、1つの融合された qkv ではなく、個別のテンソルとして保存されています。重みは同じ数値でレイアウトが異なり、379個ではなく463個のテンソルになります。これらはアダプター作業のために存在します。AI Toolkitのような学習ツールはq、k、vレイヤーを個別に書き出し、融合ファイルではそれらのアダプターをスライスにマッピングする必要があります。Comfy-Orgのファイルの代わりに Load Diffusion Model で読み込めます。
入手方法
両方のアーティファクトはHugging Faceにあります。テキストエンコーダーとVAEは変更されておらず、Comfy-Org/MOSS-Imageから入手します。バンディング分析と、スコアリングの基盤となる bandviz 指標はMATLOWAIのもので、MOSS-Image-SFT-DeBandに、同じプロンプトとシードでの各修正のインタラクティブな比較とともに掲載されています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。