MiniMax-H3-Image en 2 pasos con una LoRA pDMD
Una LoRA pDMD de 2 pasos lleva MiniMax-H3-Image de 6 pasos a 2 a 16 MP nativos: de 25,1 s a 17,4 s por imagen, con flujos de trabajo de ComfyUI listos para usar.
 |  |
|---|---|
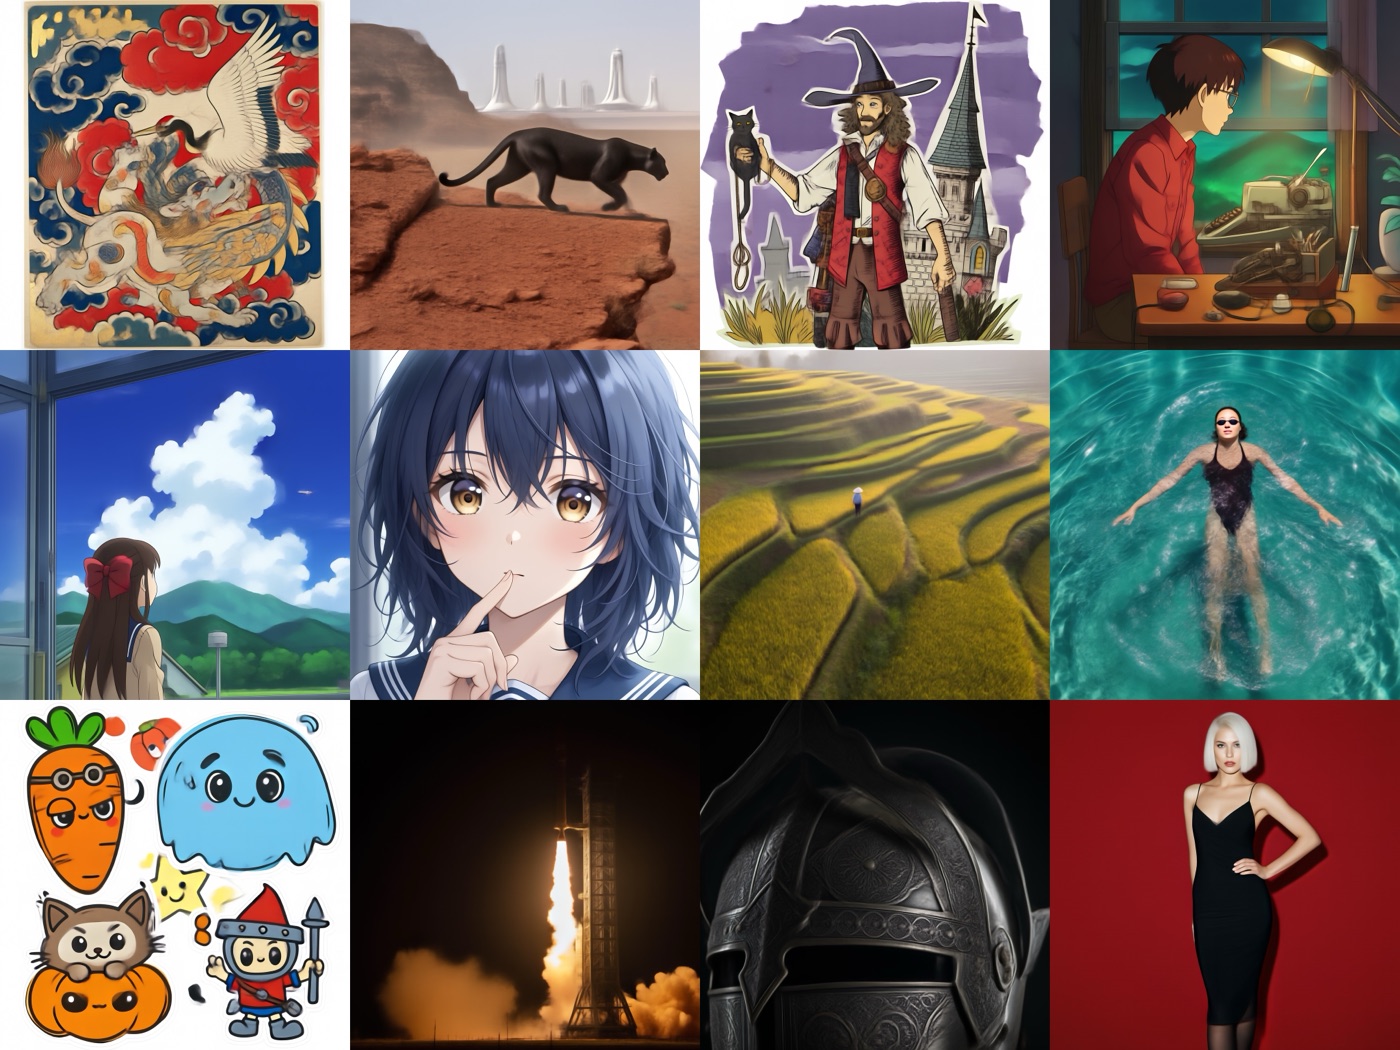
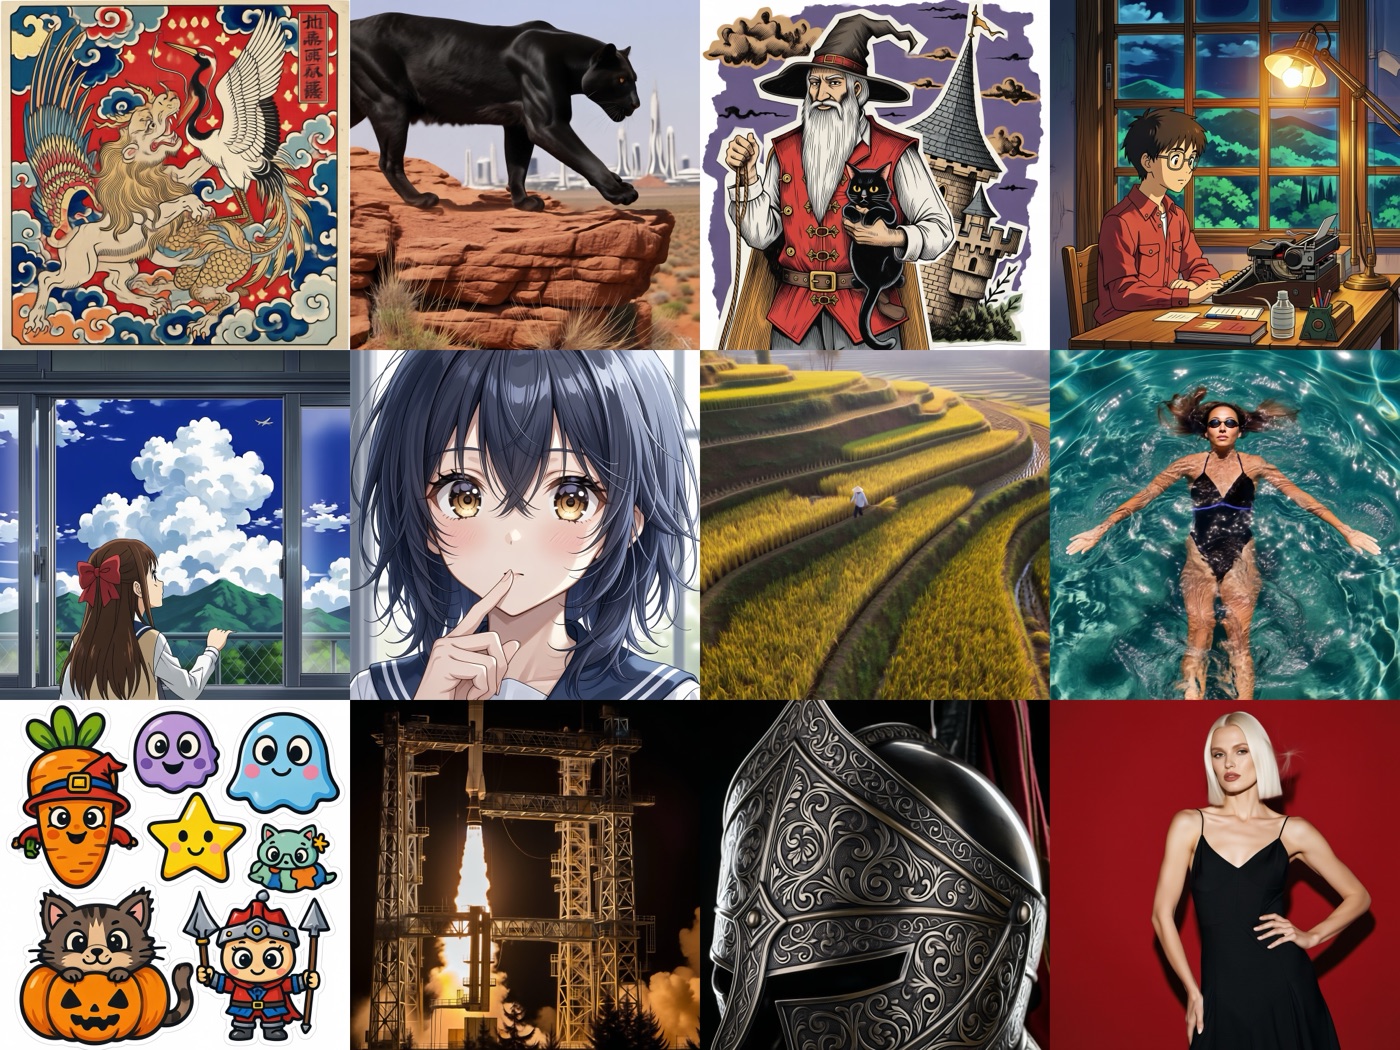
| Checkpoint estándar, 2 pasos | Con la LoRA pDMD, 2 pasos |
Doce prompts, 4096x4096, dos pasos, flow shift 12, semilla 3. El modelo estándar no puede bajar de su programación fija de 6 pasos, así que a 2 pasos sigue a mitad de la eliminación de ruido.
Ejecutarlo
Dos formas de cargarlo, el mismo gráfico.
- Un solo archivo: descarga el
minimax_h3_image_pdmd_2step_bf16.safetensorsde 40 GB enComfyUI/models/diffusion_models/, junto con un codificador de texto Qwen3-VL-32B y el VAE de imagen de Comfy-Org/MiniMax-H3-Image. La LoRA ya está fusionada, así que no necesitas nodo LoRA ni ajustar ninguna fuerza. - Base más LoRA: conserva tu checkpoint actual de Comfy-Org y añade el
minimax_h3_pdmd_2nfe_comfyui.safetensorsde 2 GB aComfyUI/models/loras/, con LoraLoaderModelOnly a fuerza 1.0 entre Cargar modelo de difusión y MiniMaxH3SigmaShift. Esta es la única ruta para los repacksint8_convrotyw4a8, ya que los pesos pre-fusionados no se pueden construir sobre tensores rotados o cuantizados.
Luego muestrea 2 pasos, euler, scheduler simple, denoise 1.0, shift_video 12, sin CFG. El latente proviene de EmptyHunyuanLatentVideo porque el latente de imagen de H3 es un solo fotograma.
Qué te aporta la velocidad
| Configuración | 4096x4096, una H200 |
|---|---|
| Estándar, 6 pasos | ~25,1 s |
| LoRA pDMD, 2 pasos | ~17,4 s |
| 2 pasos más pasada de refinado IC | ~50 s |
Por imagen la ganancia es de aproximadamente 1,4x, no 3x: 2 pasos en lugar de 6, pero cada paso a 16 MP arrastra el mismo transformer de 33B. La mayor ventaja es la velocidad de iteración en el Space de demostración, que renderiza 2048x2048 en unos 4,6 s con su pasada de detalle, frente a unos 7 s del Space oficial de 6 pasos al mismo tamaño.
Dos pasos funciona para la mayoría de prompts. Los prompts gráficos pueden inventar pseudo-texto y la composición puede desviarse del resultado estándar; 3 pasos es el punto medio seguro, y 4 pasos es lo más cercano a la salida de 6 pasos. Lo mismo para las ediciones.
Pasada de detalle
Borrador a media resolución en 2 pasos, escalado en píxeles con lanczos, codificación VAE y luego una segunda muestra a 3 pasos con denoise = sigma_0. El sigma inicial es el ajuste clave: 0,4 a 0,55 pule mientras conserva el borrador, 0,7 añade más detalle pero puede generar moteado en zonas planas y desviar los rostros. Para ediciones, mantente en 0,55 o por debajo.
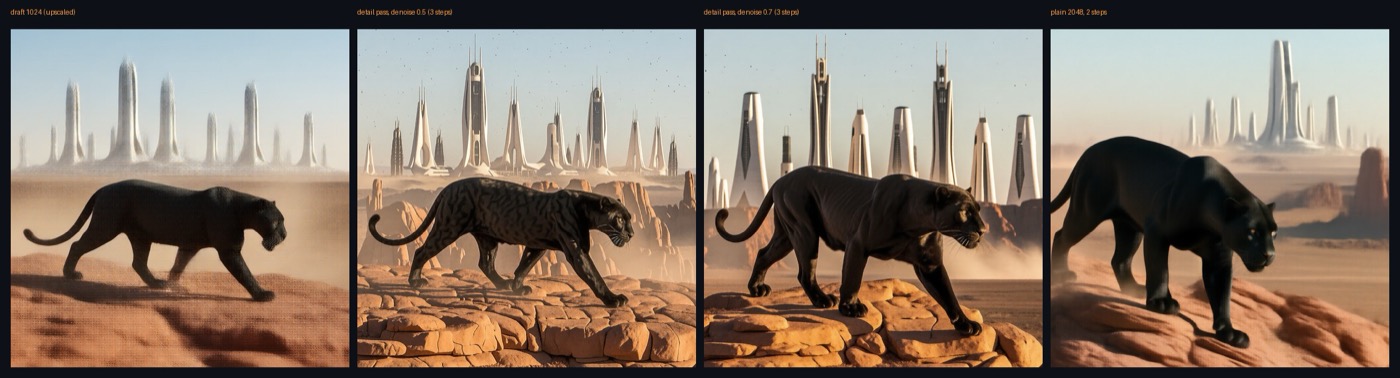
Borrador a media resolución (izquierda), la pasada a 0,5 y 0,7 (centro), render estándar a tamaño completo de 2 pasos (derecha). La pasada añade de 1 a 2 s a 4 MP.
Vistas previas en tiempo real
Como un fotograma de 2 pasos es barato, el Space de demostración renderiza alrededor de 1 MP mientras escribes, aproximadamente 0,9 s por fotograma en su compilación FP8, y pule cuando haces una pausa. Eso es lo que desbloquea la LoRA: la programación estándar está fijada en 6 pasos.
Edición de prompts en vivo sobre una fuente de la Mona Lisa, un fotograma de 2 pasos por fragmento.
Disponibilidad
- LoRA, flujos de trabajo y cuadrículas: akhaliq/minimax-h3-image-pdmd-2step
- Space de demostración: akhaliq/minimax-h3-image-2step
- Modelo base: MiniMaxAI/MiniMax-H3-Image, repack de ComfyUI en Comfy-Org/MiniMax-H3-Image
- LoRA original: pdmd2026/pdmd_2NFE_lora, método en arXiv 2609.35768
Comentarios
Inicia sesión con GitHub para unirte a la conversación.