SnapRef v2a da peso a cada foto de referencia para Anima en ComfyUI
La versión estable de SnapRef v2a añade un peso por foto de referencia y dos preajustes de modo para Anima, además de seis flujos de trabajo de ComfyUI y una opción FP8 de 195 MB.
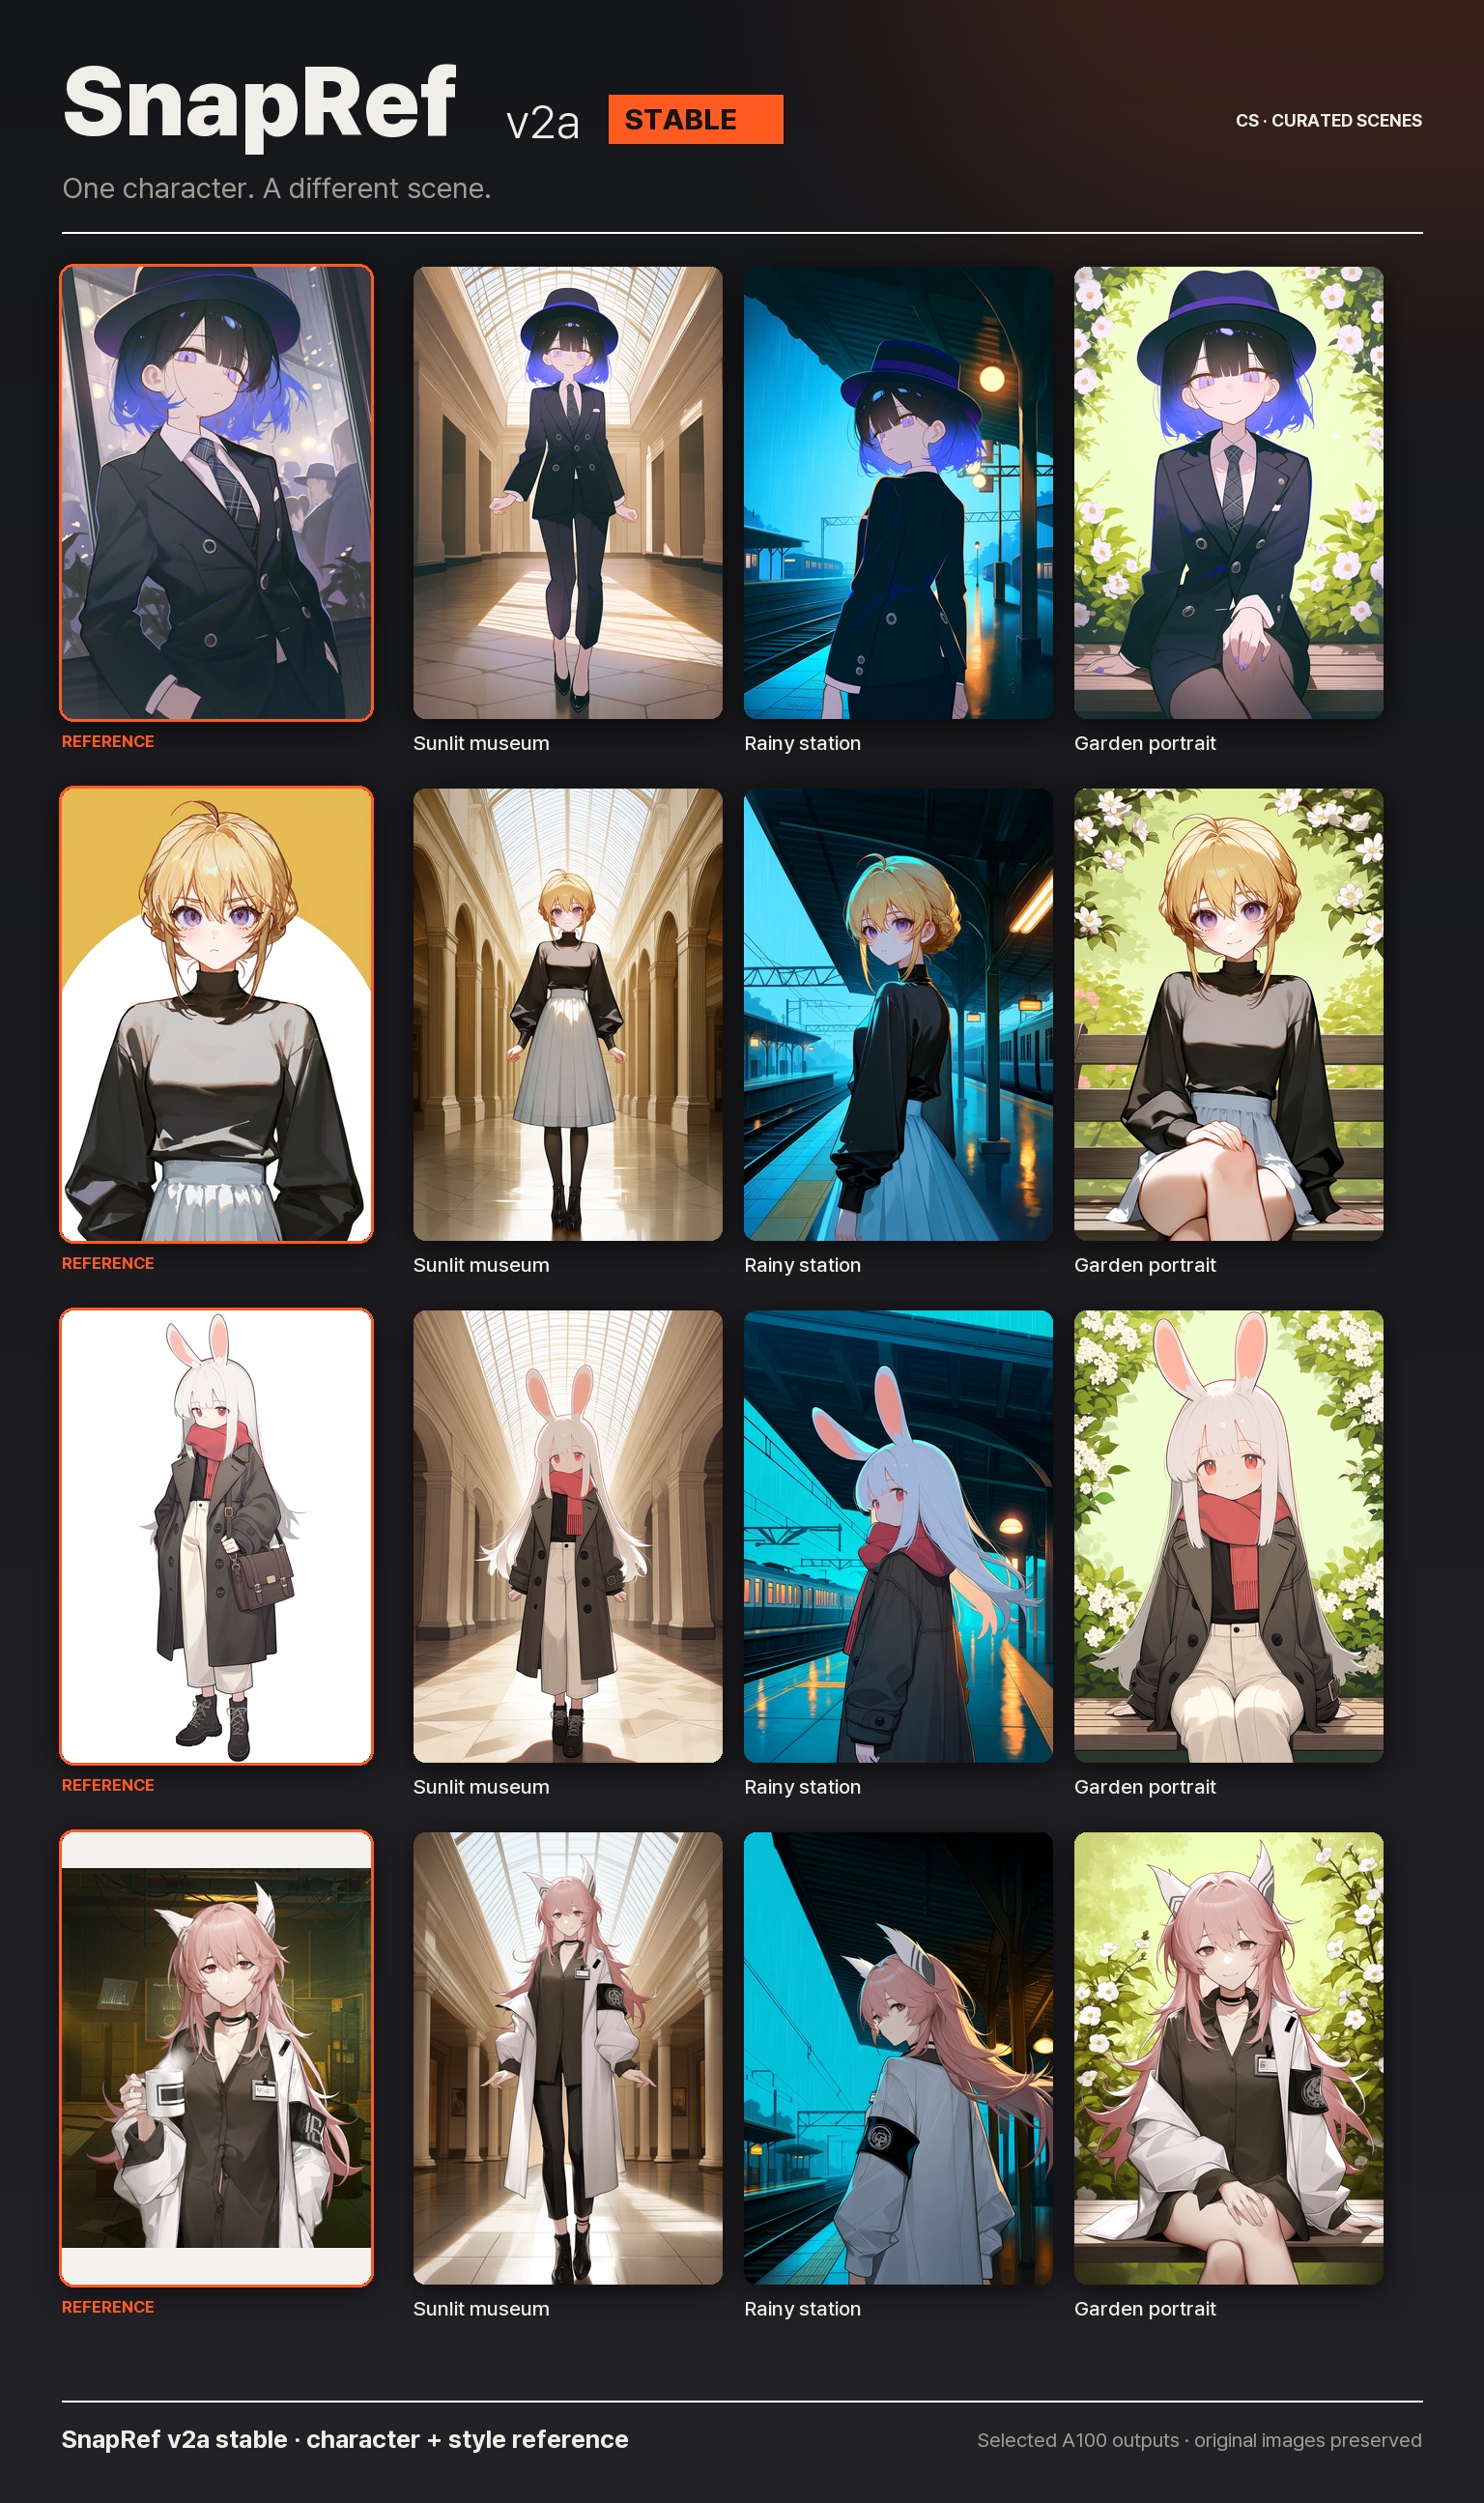
Cuatro referencias, tres prompts de escena. Los contornos naranjas marcan las entradas; los prompts no nombran ningún personaje ni etiquetas de apariencia.
Qué cambió respecto a v1a
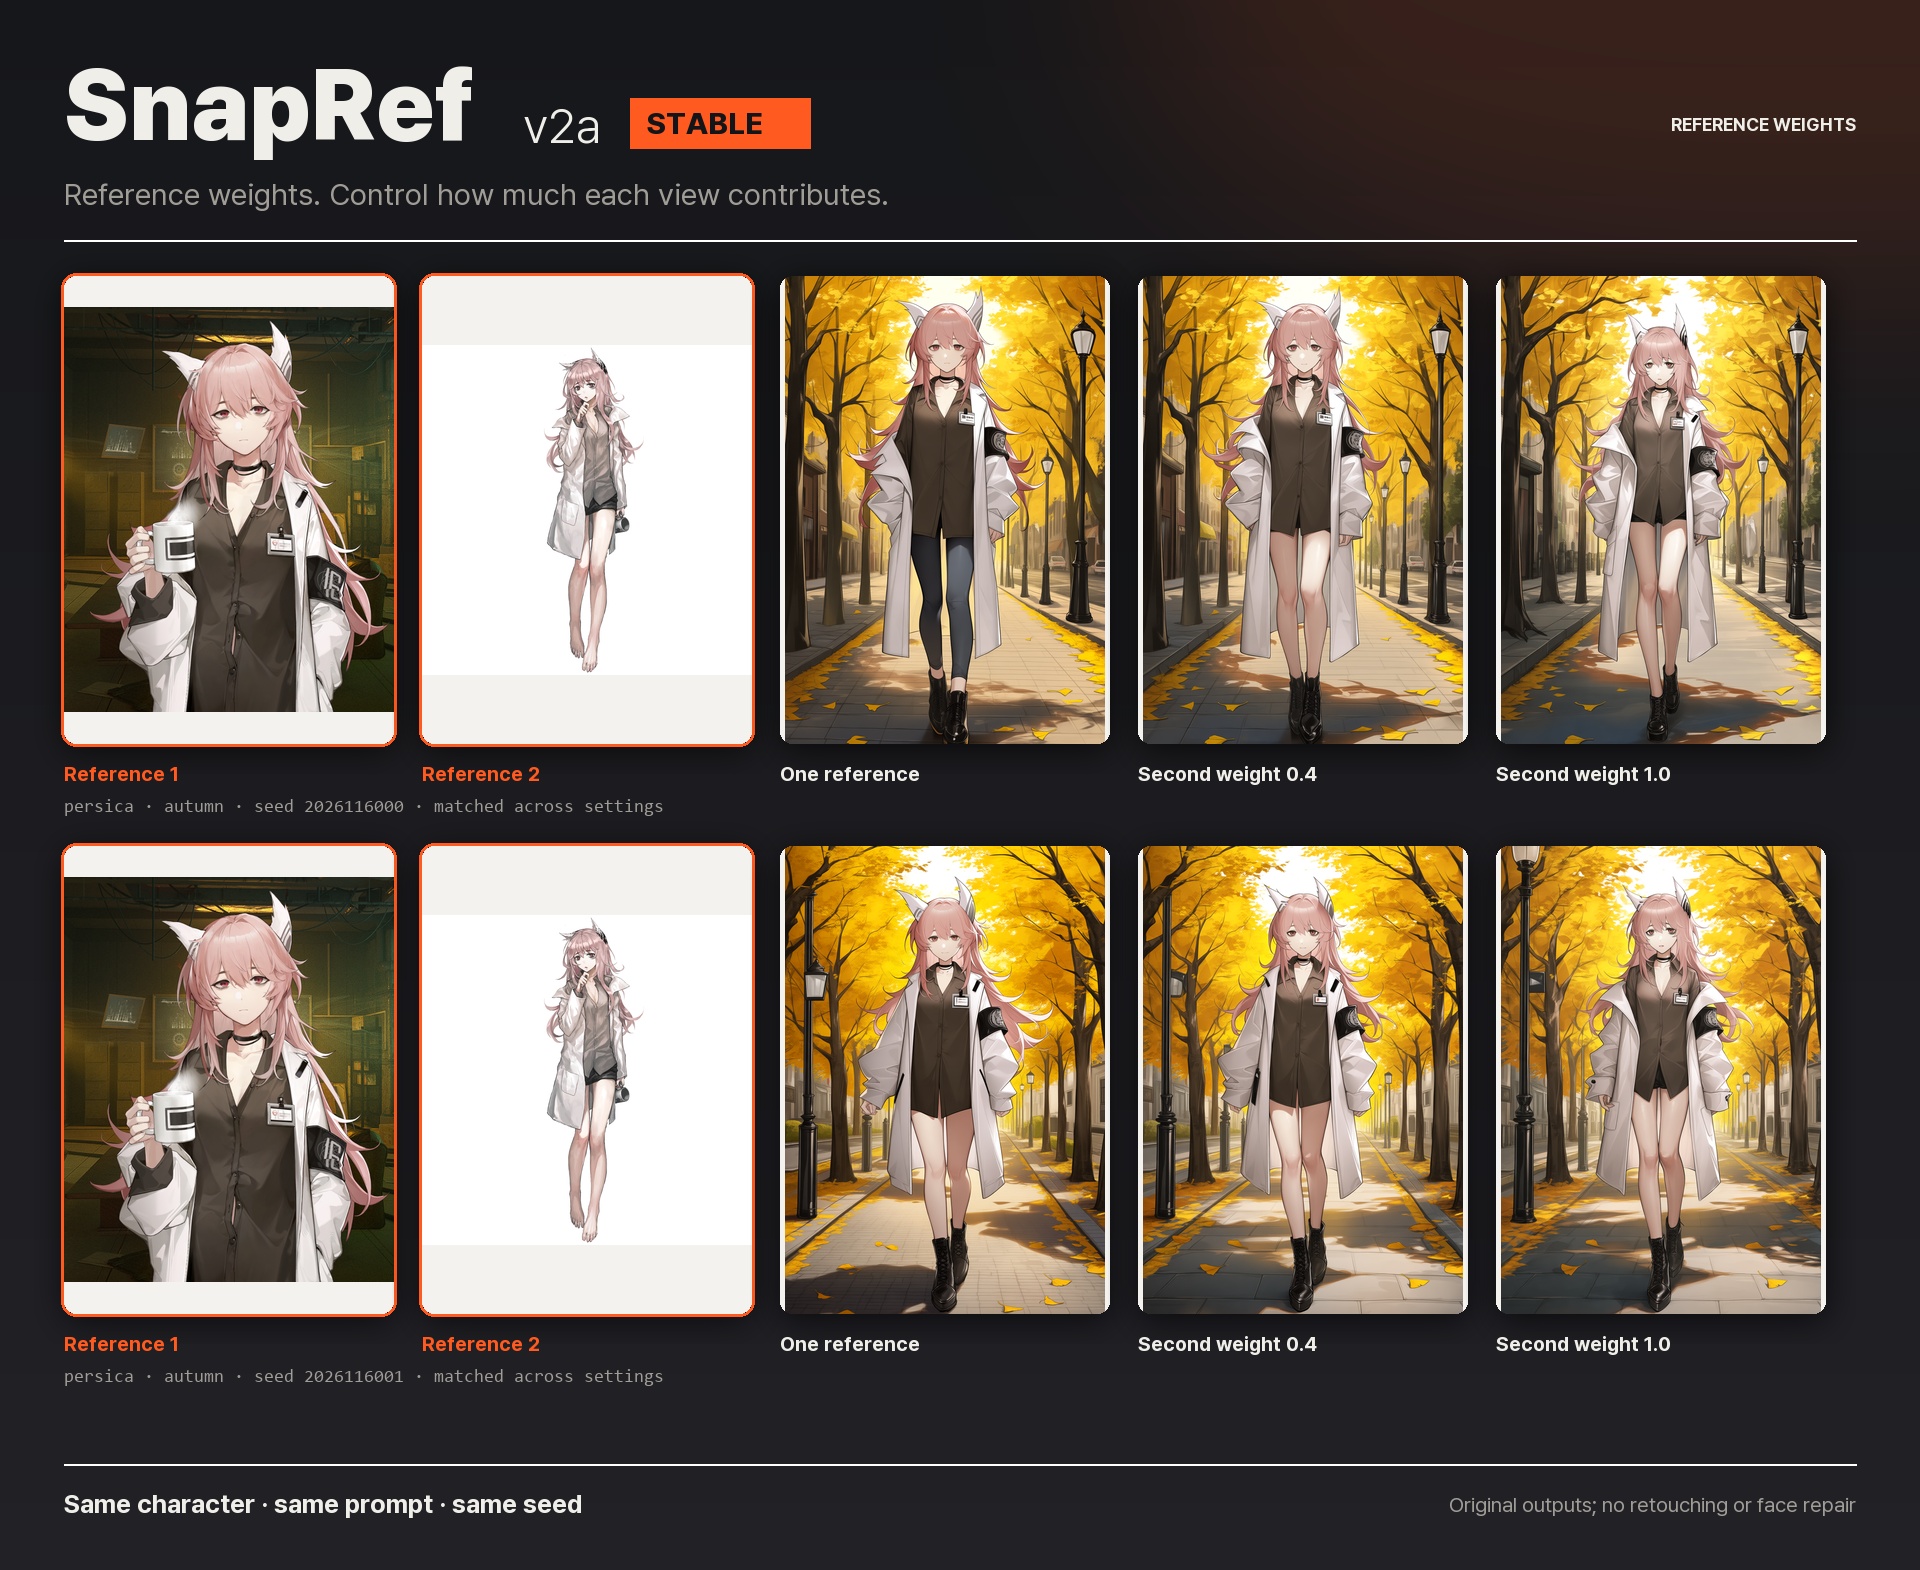
- Un peso por referencia. En el diseño
separatecada foto tiene su propio peso, 1.0 por defecto y 0 para desactivarla. Una segunda foto ajustada a 0.4 matiza el aspecto en lugar de imponerse. - Dos modos en el nodo simple. Character & Style conserva el renderizado de la referencia, Character toma solo el personaje, de modo que las etiquetas de artista y las palabras de estilo deciden el aspecto.
- Seis flujos de trabajo, incluidos dos personajes, y una comparación de pesos de referencia que incluye sus propios prompts y semillas.
 |
|---|
| Dos semillas fijas por fila: una referencia, segunda referencia a 0.4 y luego a 1.0. En el mismo par, 1.0 no siempre es el mejor resultado. |
Cómo ejecutarlo
- Instala Anima base v1.0 con su codificador de texto y VAE.
- Copia
comfyui/snapref/del repositorio enComfyUI/custom_nodes/snapref/y reinicia ComfyUI. - Coloca
snapref_v2a.safetensorsenComfyUI/models/loras/. Usa el nodo SnapRef, no LoraLoader: el archivo son dos ramas LoRA tras una sola clave y un cargador LoRA normal no lo leerá correctamente. - Abre el flujo de trabajo de abajo, suelta una foto en la ranura de imagen dentro del nodo y escribe solo la escena.
El gráfico simple ejecuta 28 pasos, Euler con simple, CFG 4.5 y fidelidad 1.0 a 832 x 1216. Para dos vistas de un personaje, el segundo flujo de trabajo fija el segundo peso a 0.4:
Un archivo FP8 ocupa 195 MB en lugar de 382 MB. Almacena matrices E4M3FN con escalas por fila y el nodo las restaura a bf16 al cargar, por lo que las imágenes pueden diferir ligeramente de los pesos completos.
Qué esperar
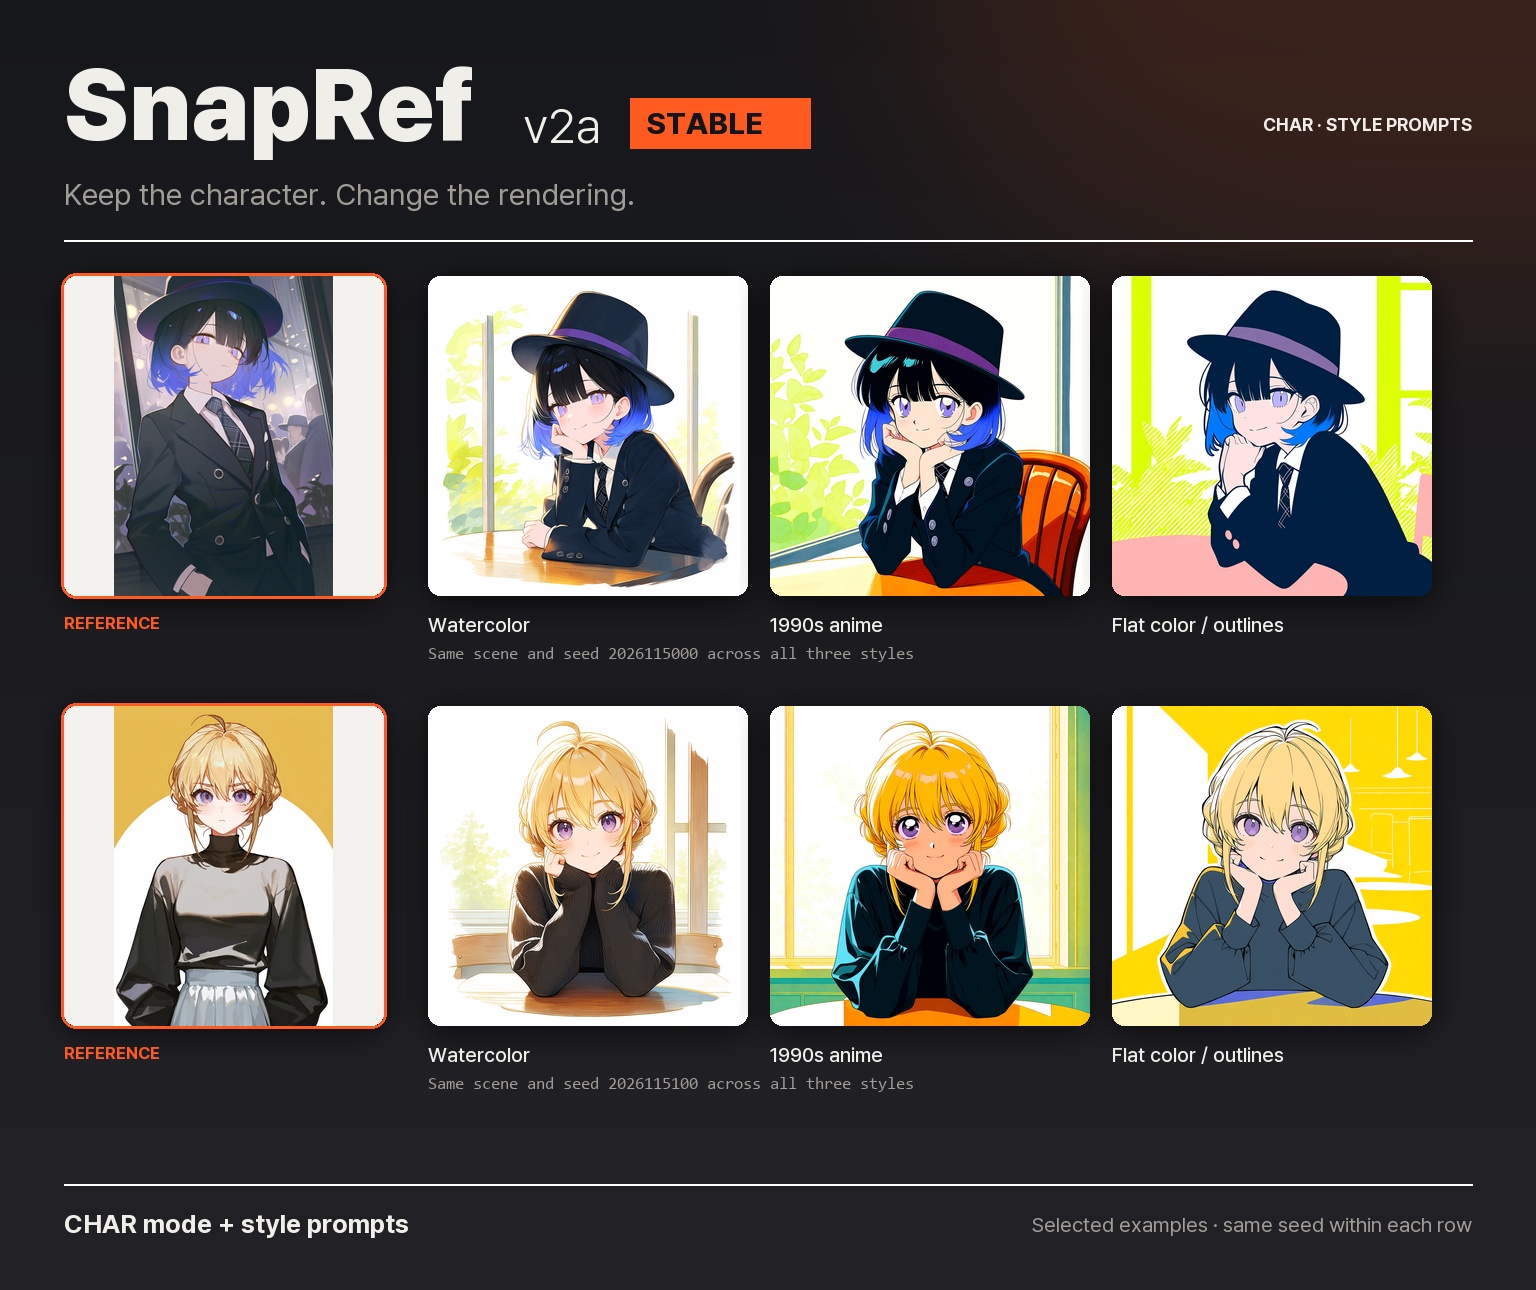
Modo char, semillas emparejadas por fila: la referencia aporta el personaje, el prompt aporta el estilo.
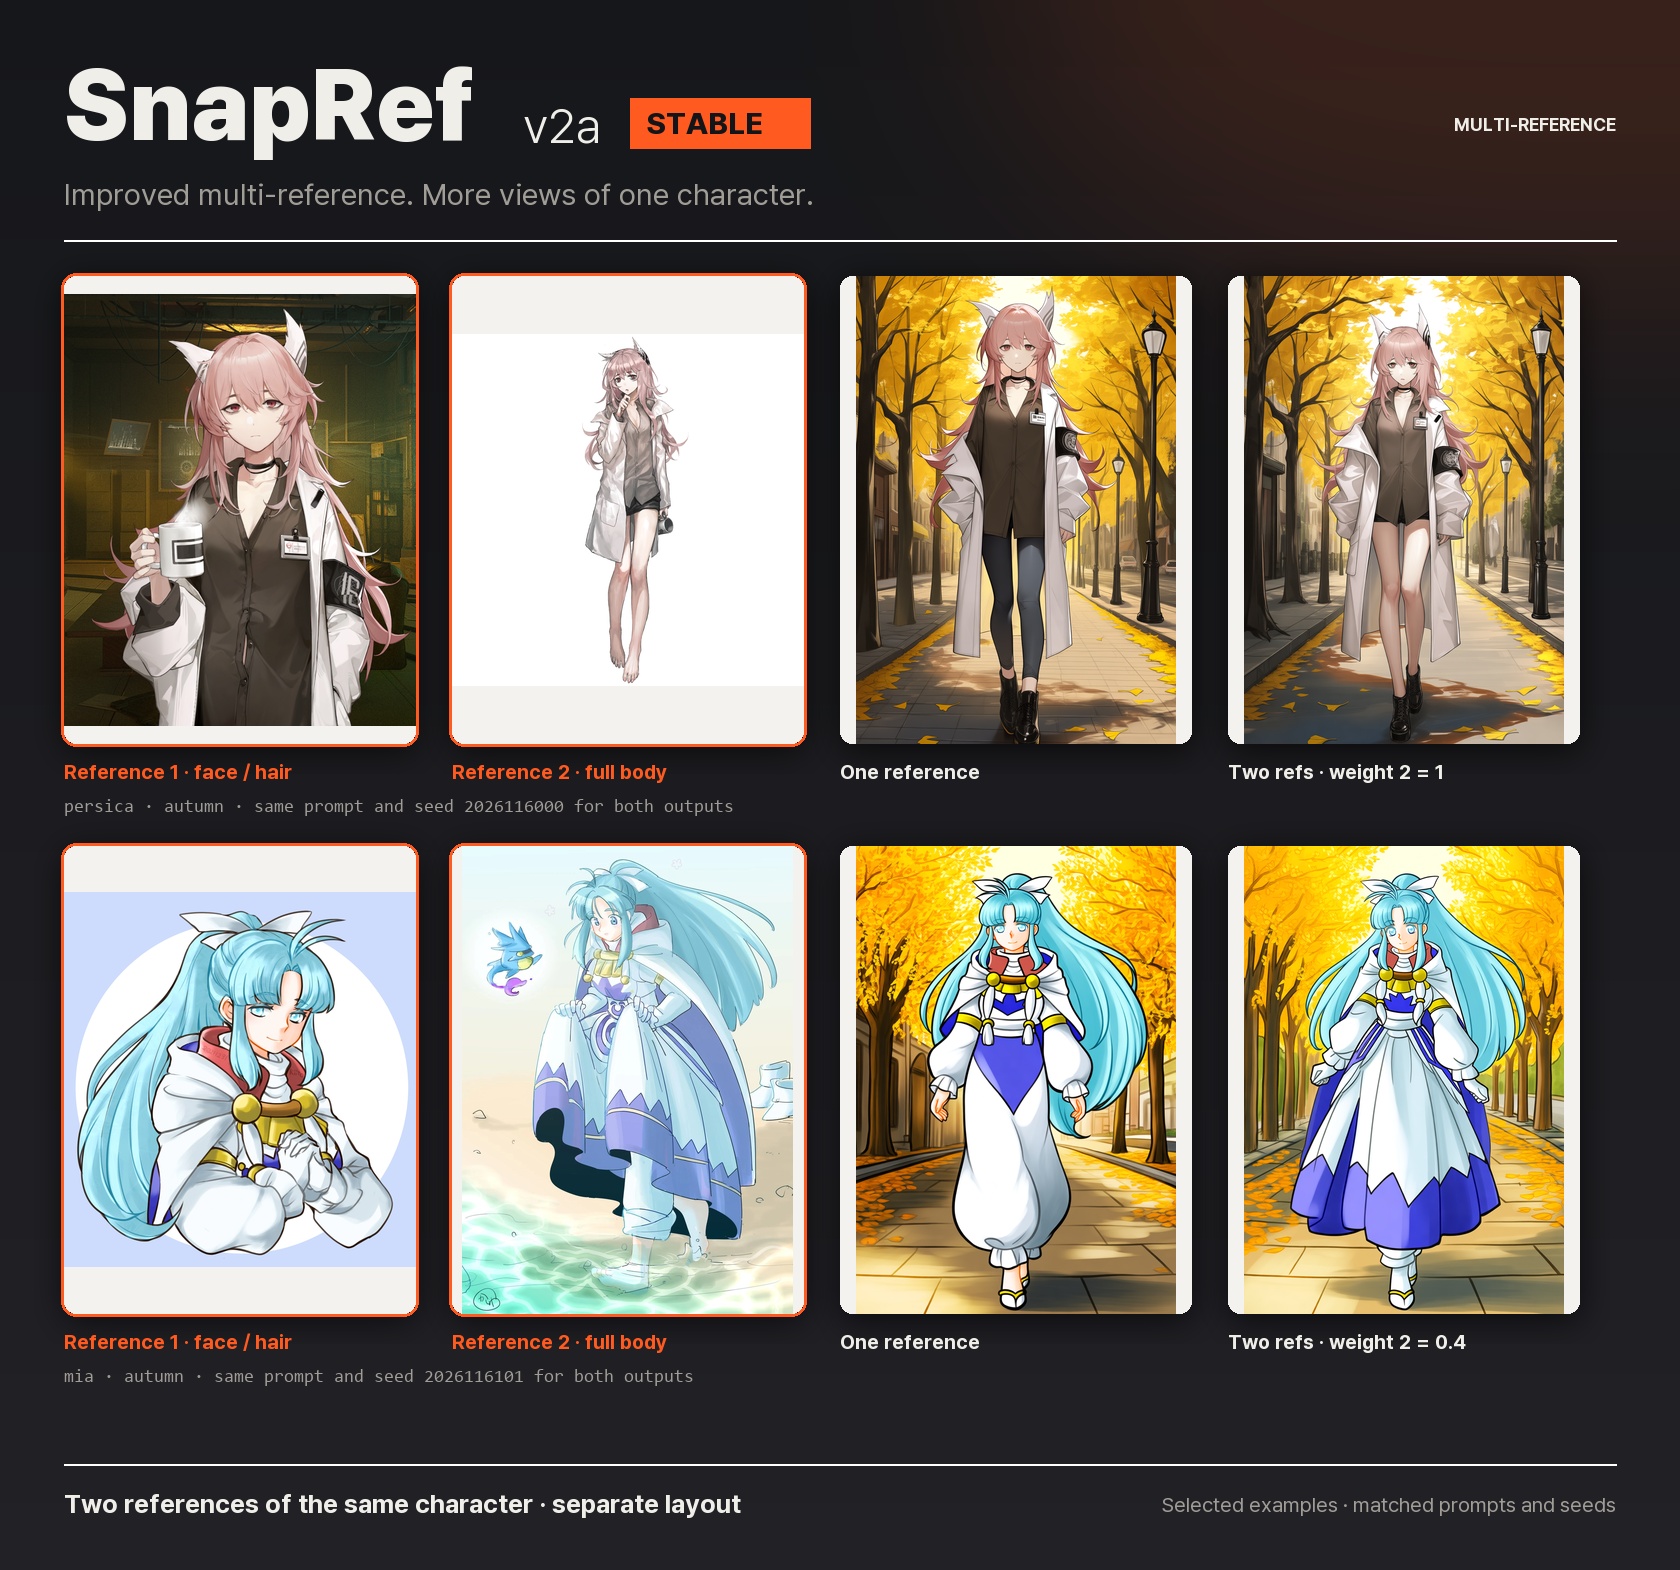
Una segunda vista añade el atuendo y la silueta. Peso 1.0 para Persica y 0.4 para Mia, ejemplos elegidos en lugar de una puntuación media.
En la evaluación fija de los autores (64 casos, dos semillas), v2a está a la par de v1a en lugar de por delante: la recuperación de etiquetas de apariencia pasa de 0.8722 a 0.8727, el SigLIP de cabeza de 0.8989 a 0.8903 y la distancia CCIP de imagen completa de 0.0725 a 0.0757. Su lectura cualitativa es un mejor seguimiento de la referencia, y la tarjeta sigue señalando los rostros brillantes de la referencia como punto débil para el detalle facial. Las métricas varían con el encuadre, la pose y la detección de cabezas, así que tómalas como una comprobación rápida.
Si v1a ya te da el personaje que quieres, no hay motivo para cambiar solo por precisión. Las razones para moverte son los pesos por referencia y los flujos de trabajo ajustados para v2a.
Disponibilidad
- Pesos, nodos, seis flujos de trabajo y figuras: 0ppxnhximxr/snapref-v2a
- Código de entrenamiento, datos y evaluación: ArcAnima/SnapRef
- Versión anterior: snapref-v1a, cubierta en SnapRef v1a
Comentarios
Inicia sesión con GitHub para unirte a la conversación.