SnapRef: adaptador de referencia con caché KV para Anima
SnapRef v1a mantiene un personaje de Anima desde una imagen de referencia al cachear sus claves y valores de atención, a 8,9 s por imagen. Incluye nodos ComfyUI y pesos FP8.
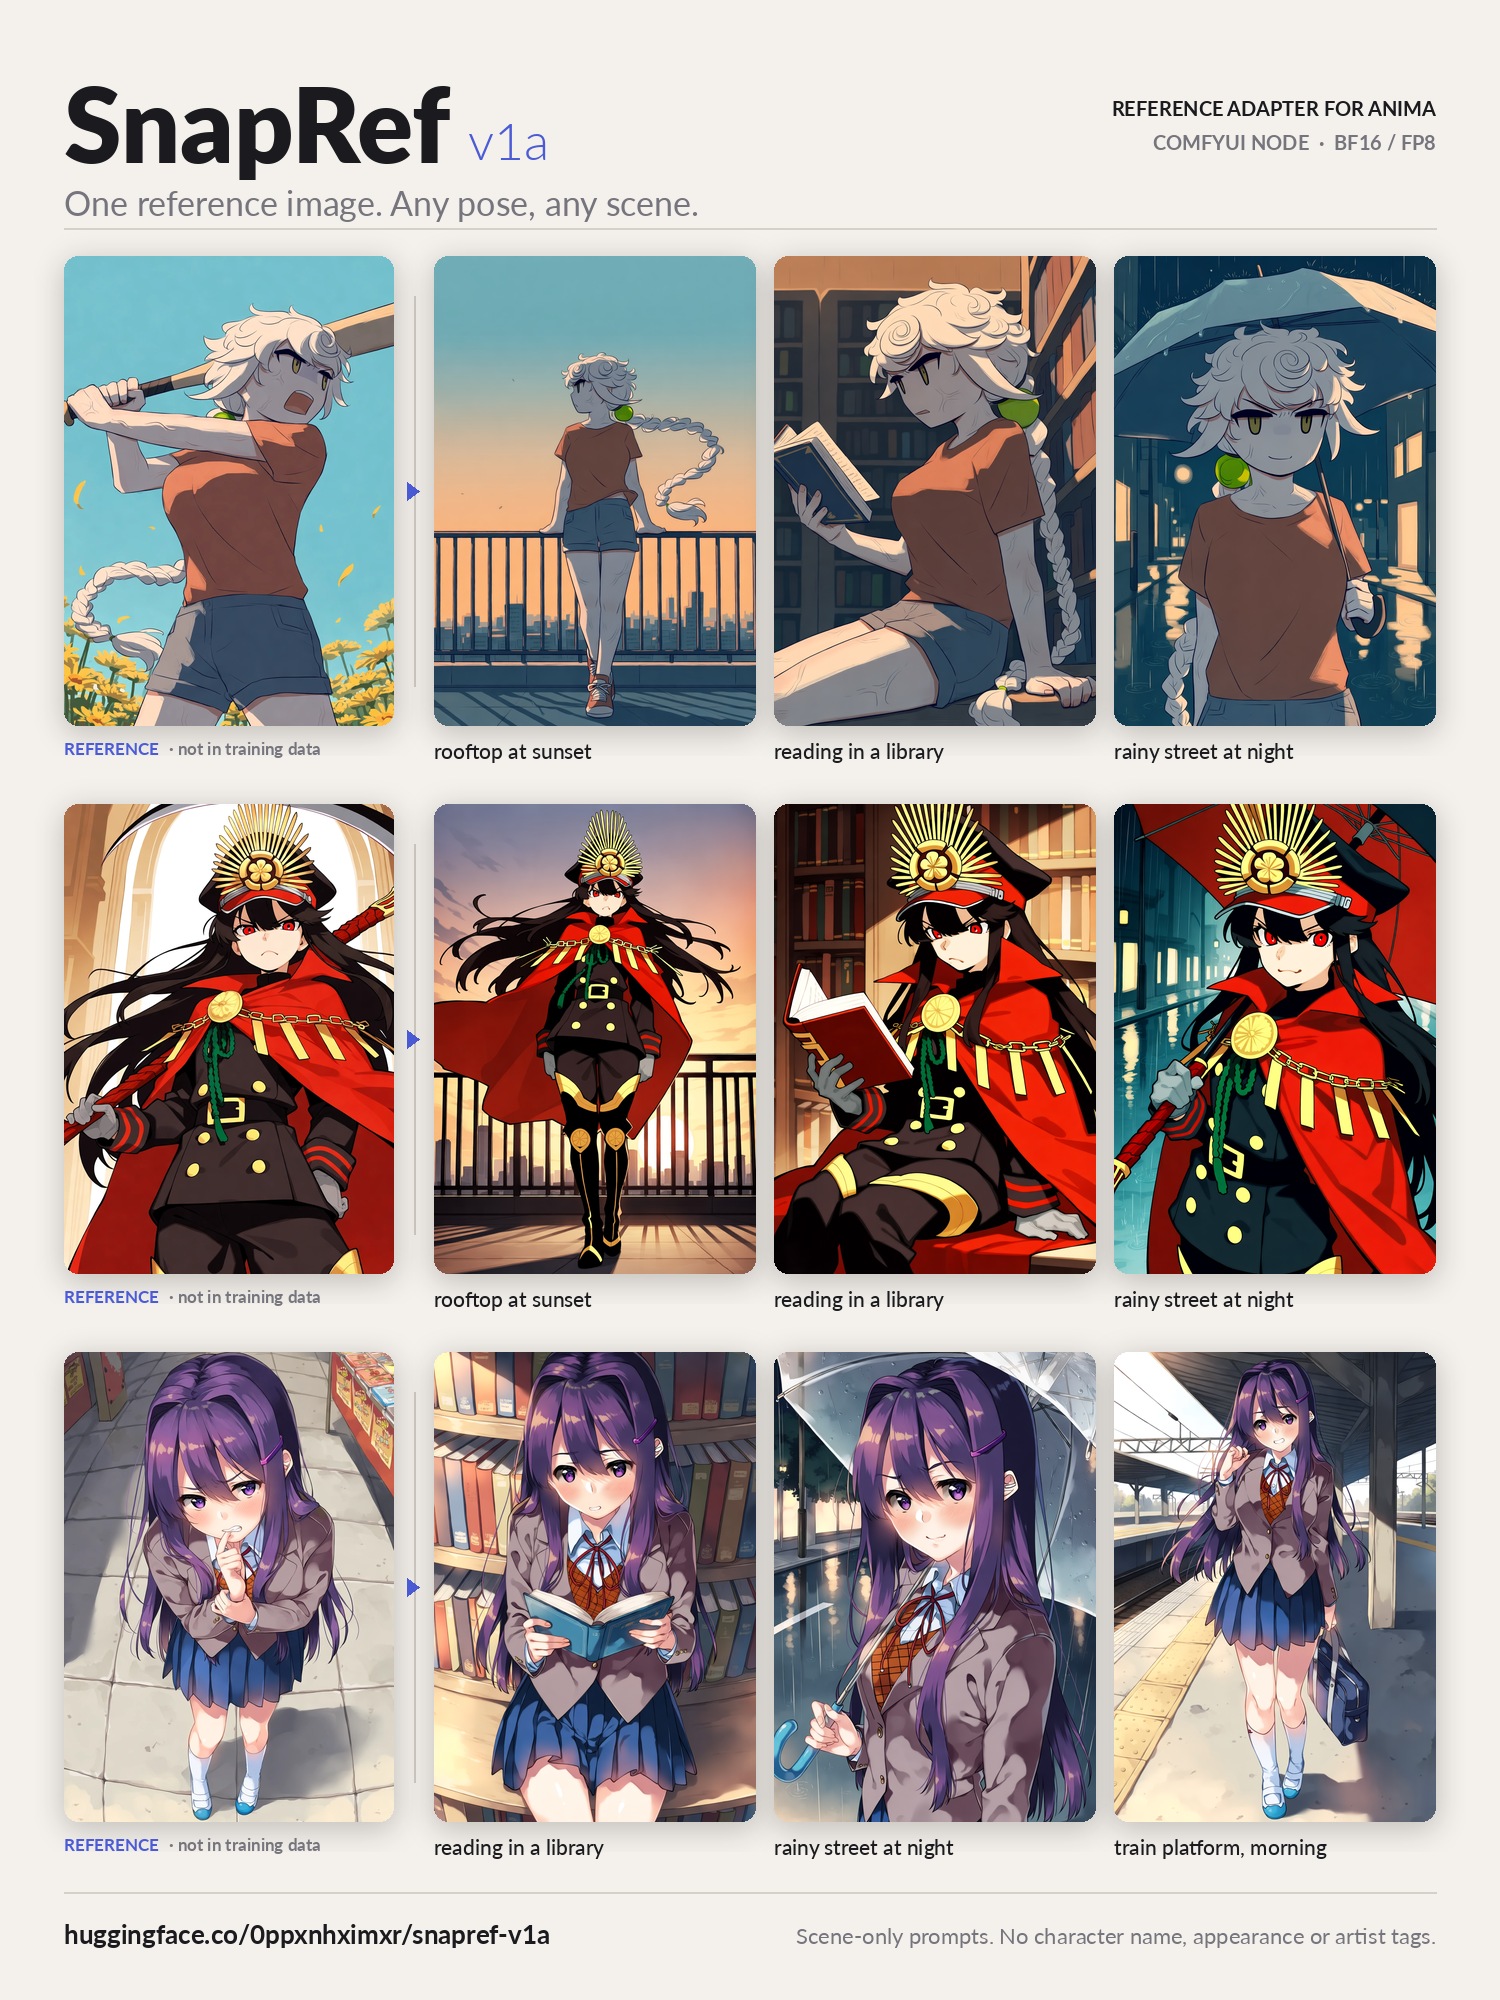
Una imagen de referencia, un prompt que solo nombra la escena.
Anima es un modelo guiado por etiquetas, así que un personaje normalmente se reproduce detallando el cabello, los ojos y el atuendo en el prompt, y solo para personajes que el modelo ya conoce. Un adaptador de referencia traslada esa tarea a la imagen: el texto se encarga de la pose, el encuadre y la ubicación, y la referencia se encarga de quién se dibuja.
Esa idea no es nueva en Anima. Anima Reference Adapter lo hizo el 27 de octubre añadiendo la referencia como un segundo fotograma latente desplazado, de modo que el prior de estilo vídeo no pudiera continuarlo como un plano. SnapRef toma una ruta diferente: pasa la referencia por el modelo una vez, almacena en caché lo que produce cada capa y vuelve a leer esa caché en cada paso de muestreo.
Cómo se almacena la referencia en caché
El archivo del adaptador son dos ramas LoRA agrupadas bajo una sola clave, anima_ref_kv/1: una rama de referencia de rango 128 en la autoatención, la atención cruzada y ambas capas MLP de los 28 bloques, y una rama de rango 64 en la autoatención del lado objetivo. Eso suma 190,8M de parámetros, 382 MB en bf16.
La referencia se codifica una vez y se mantiene como un conjunto fijo de tokens, con su propia posición en el espacio de coordenadas del modelo para que este la lea por apariencia en lugar de copiar su disposición. Durante el muestreo, cada capa atiende a sus propios tokens más la referencia en caché. El LoRA del lado objetivo permanece activo en cada pase forward del objetivo y, por defecto, solo la rama positiva de CFG lee la referencia; ref_guidance la envía a ambas ramas. Como la referencia no se vuelve a codificar en cada paso, la model card sitúa el coste en torno al 15% sobre una generación sin referencia.
Se exponen dos modos: cs copia el personaje y el estilo juntos, char copia solo el personaje para que las etiquetas de artista puedan definir el estilo. Una ruta independiente, ref_guidance, empuja con más fuerza hacia la referencia a aproximadamente 1,4× el tiempo, con APG o CFG rescale para evitar que los colores se sobresaturen, la misma corrección que necesitaba el adaptador anterior.
Qué cuesta frente a otras rutas
El repositorio incluye comparison_summary.json, una tabla de tiempos del mismo caso medida en una A100 a 832×1216, 28 pasos, con cada adaptador en sus propios valores por defecto:
| Ruta | Segundos por imagen |
|---|---|
| SnapRef v1a | 8,95 |
| ElectronGirl v2 | 14,36 |
| Role-Ref-KV | 12,53 |
| Anima Base, sin referencia | 7,72 |
En cuanto a identidad, la model card informa que, en personajes excluidos del entrenamiento, el adaptador predice mejor el objetivo con la referencia correcta que con una incorrecta, con una brecha de identidad de 0,0041 en la pérdida de denoising sobre datos reservados, y las cifras por caso en heldout_loss.json.
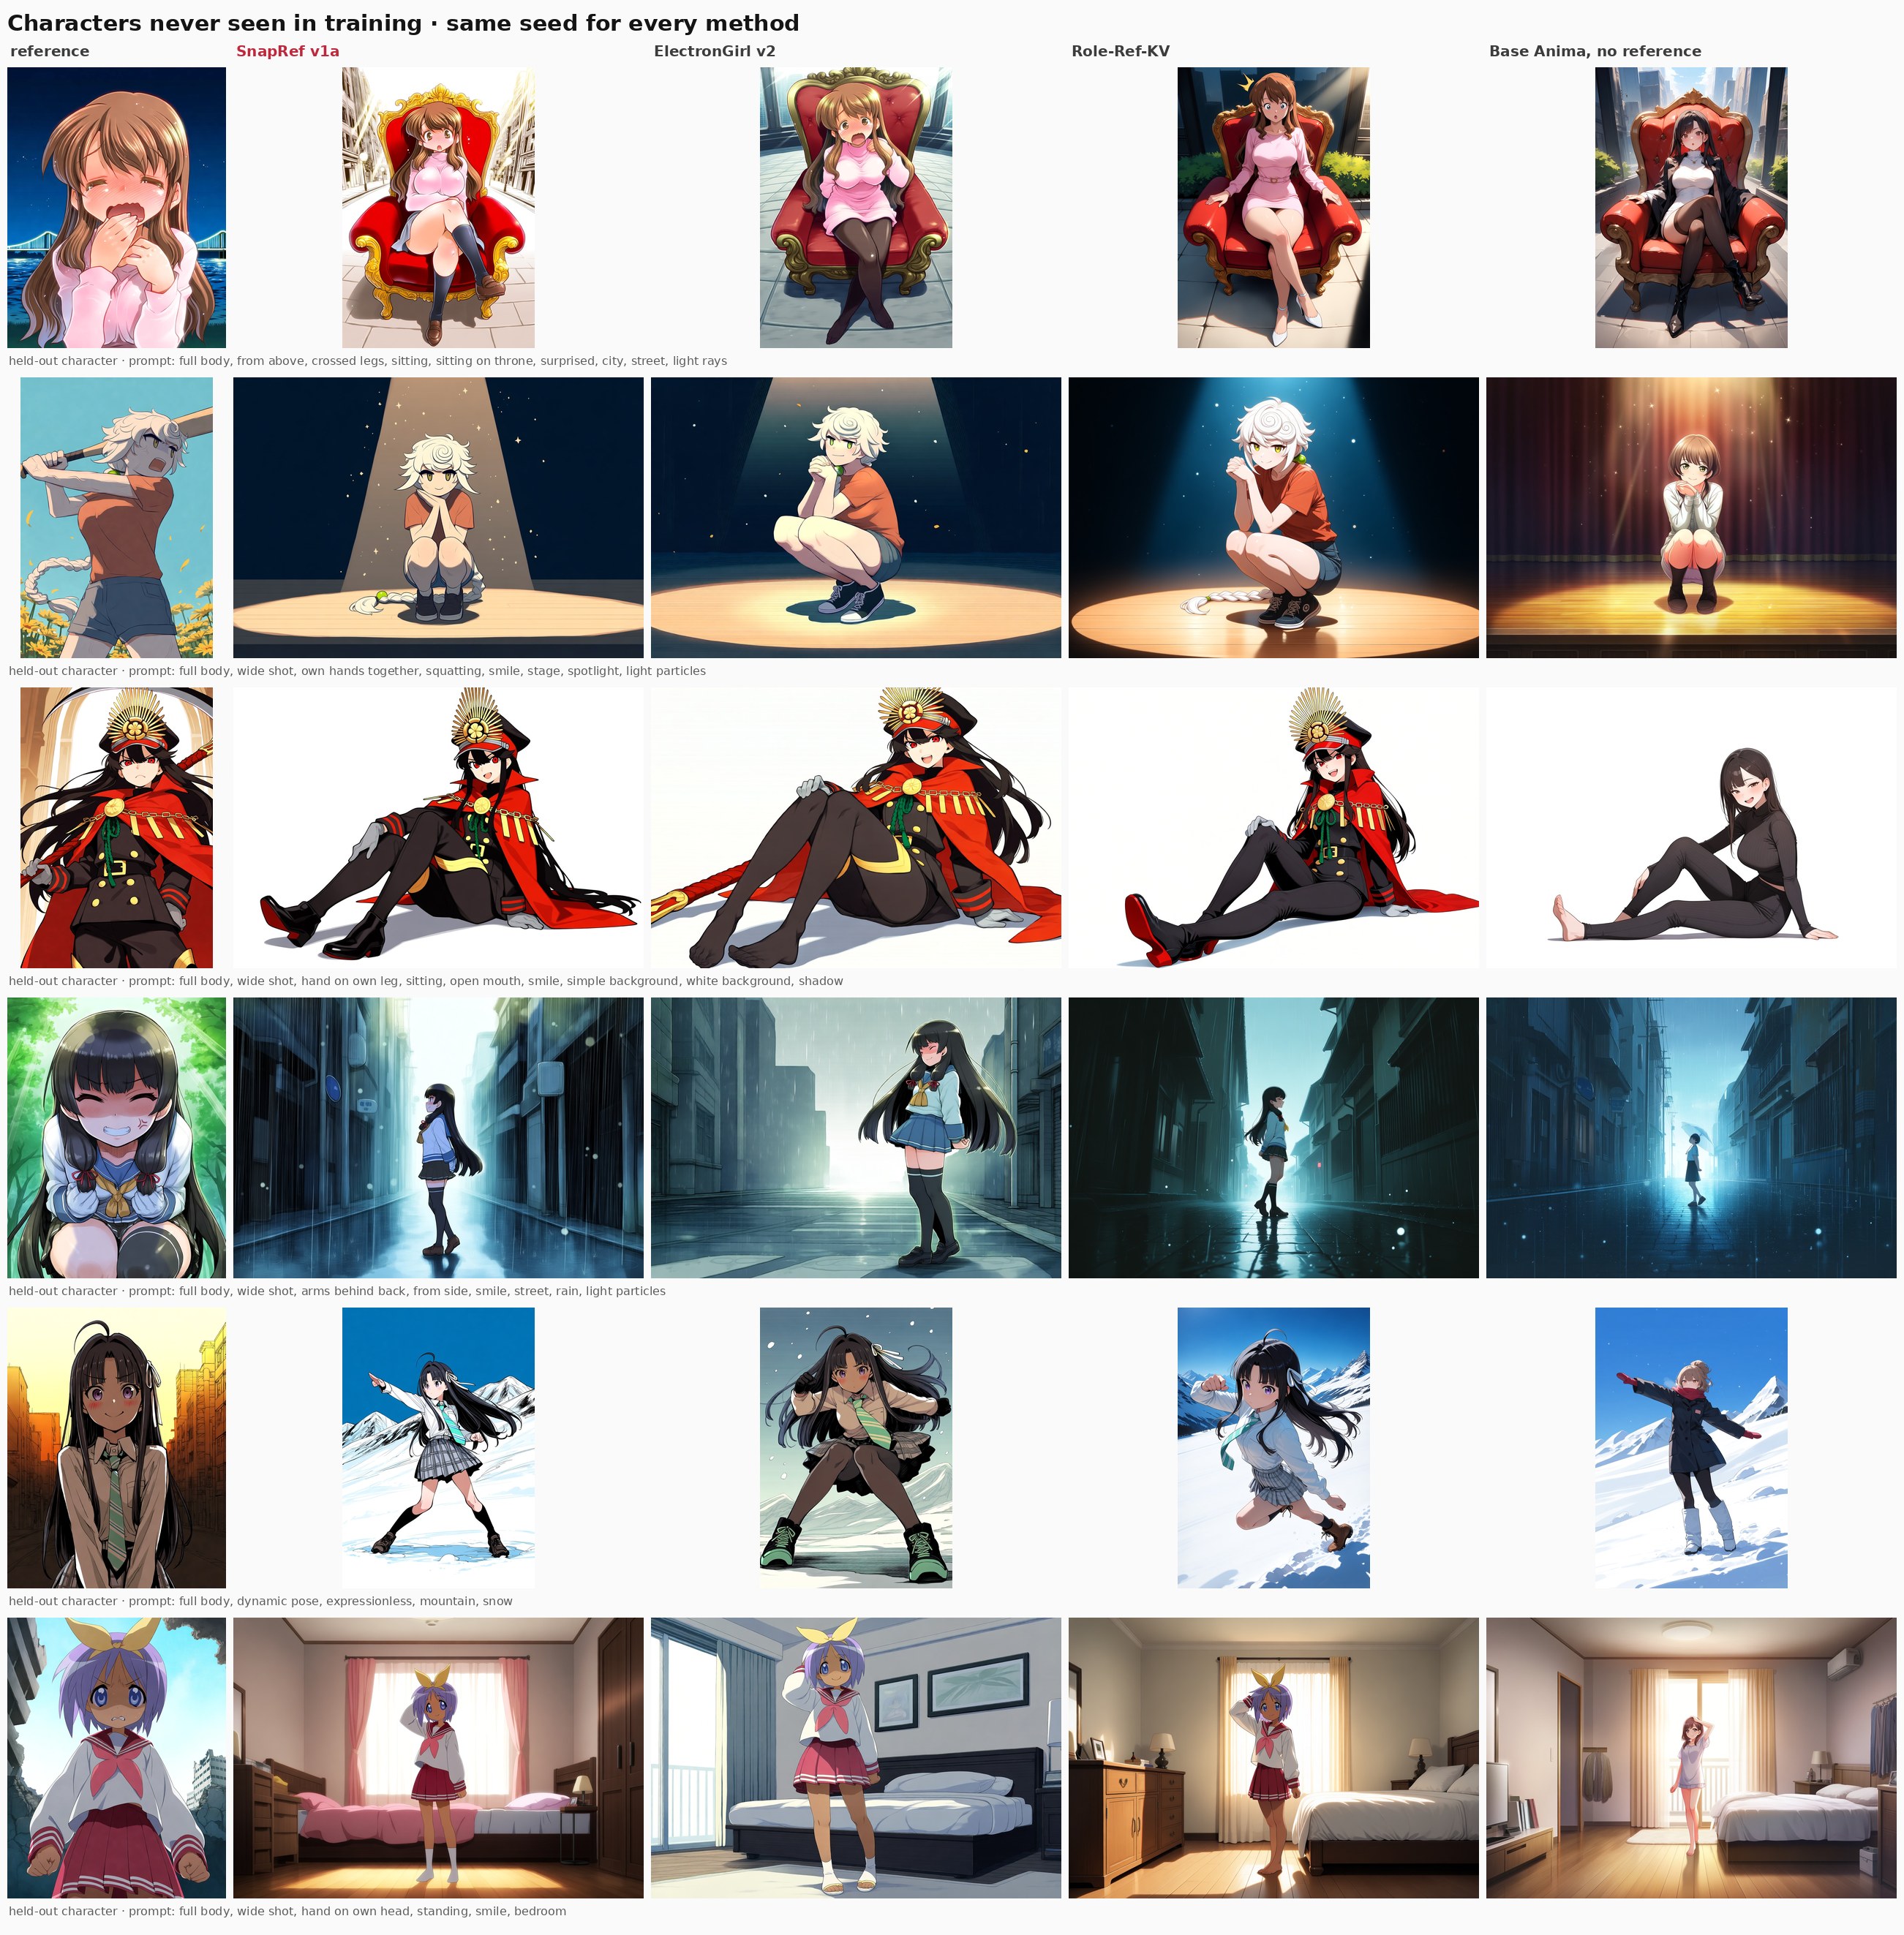
Personajes ausentes del entrenamiento. El prompt solo nombra la escena; el cabello, los ojos y el atuendo provienen de la referencia.
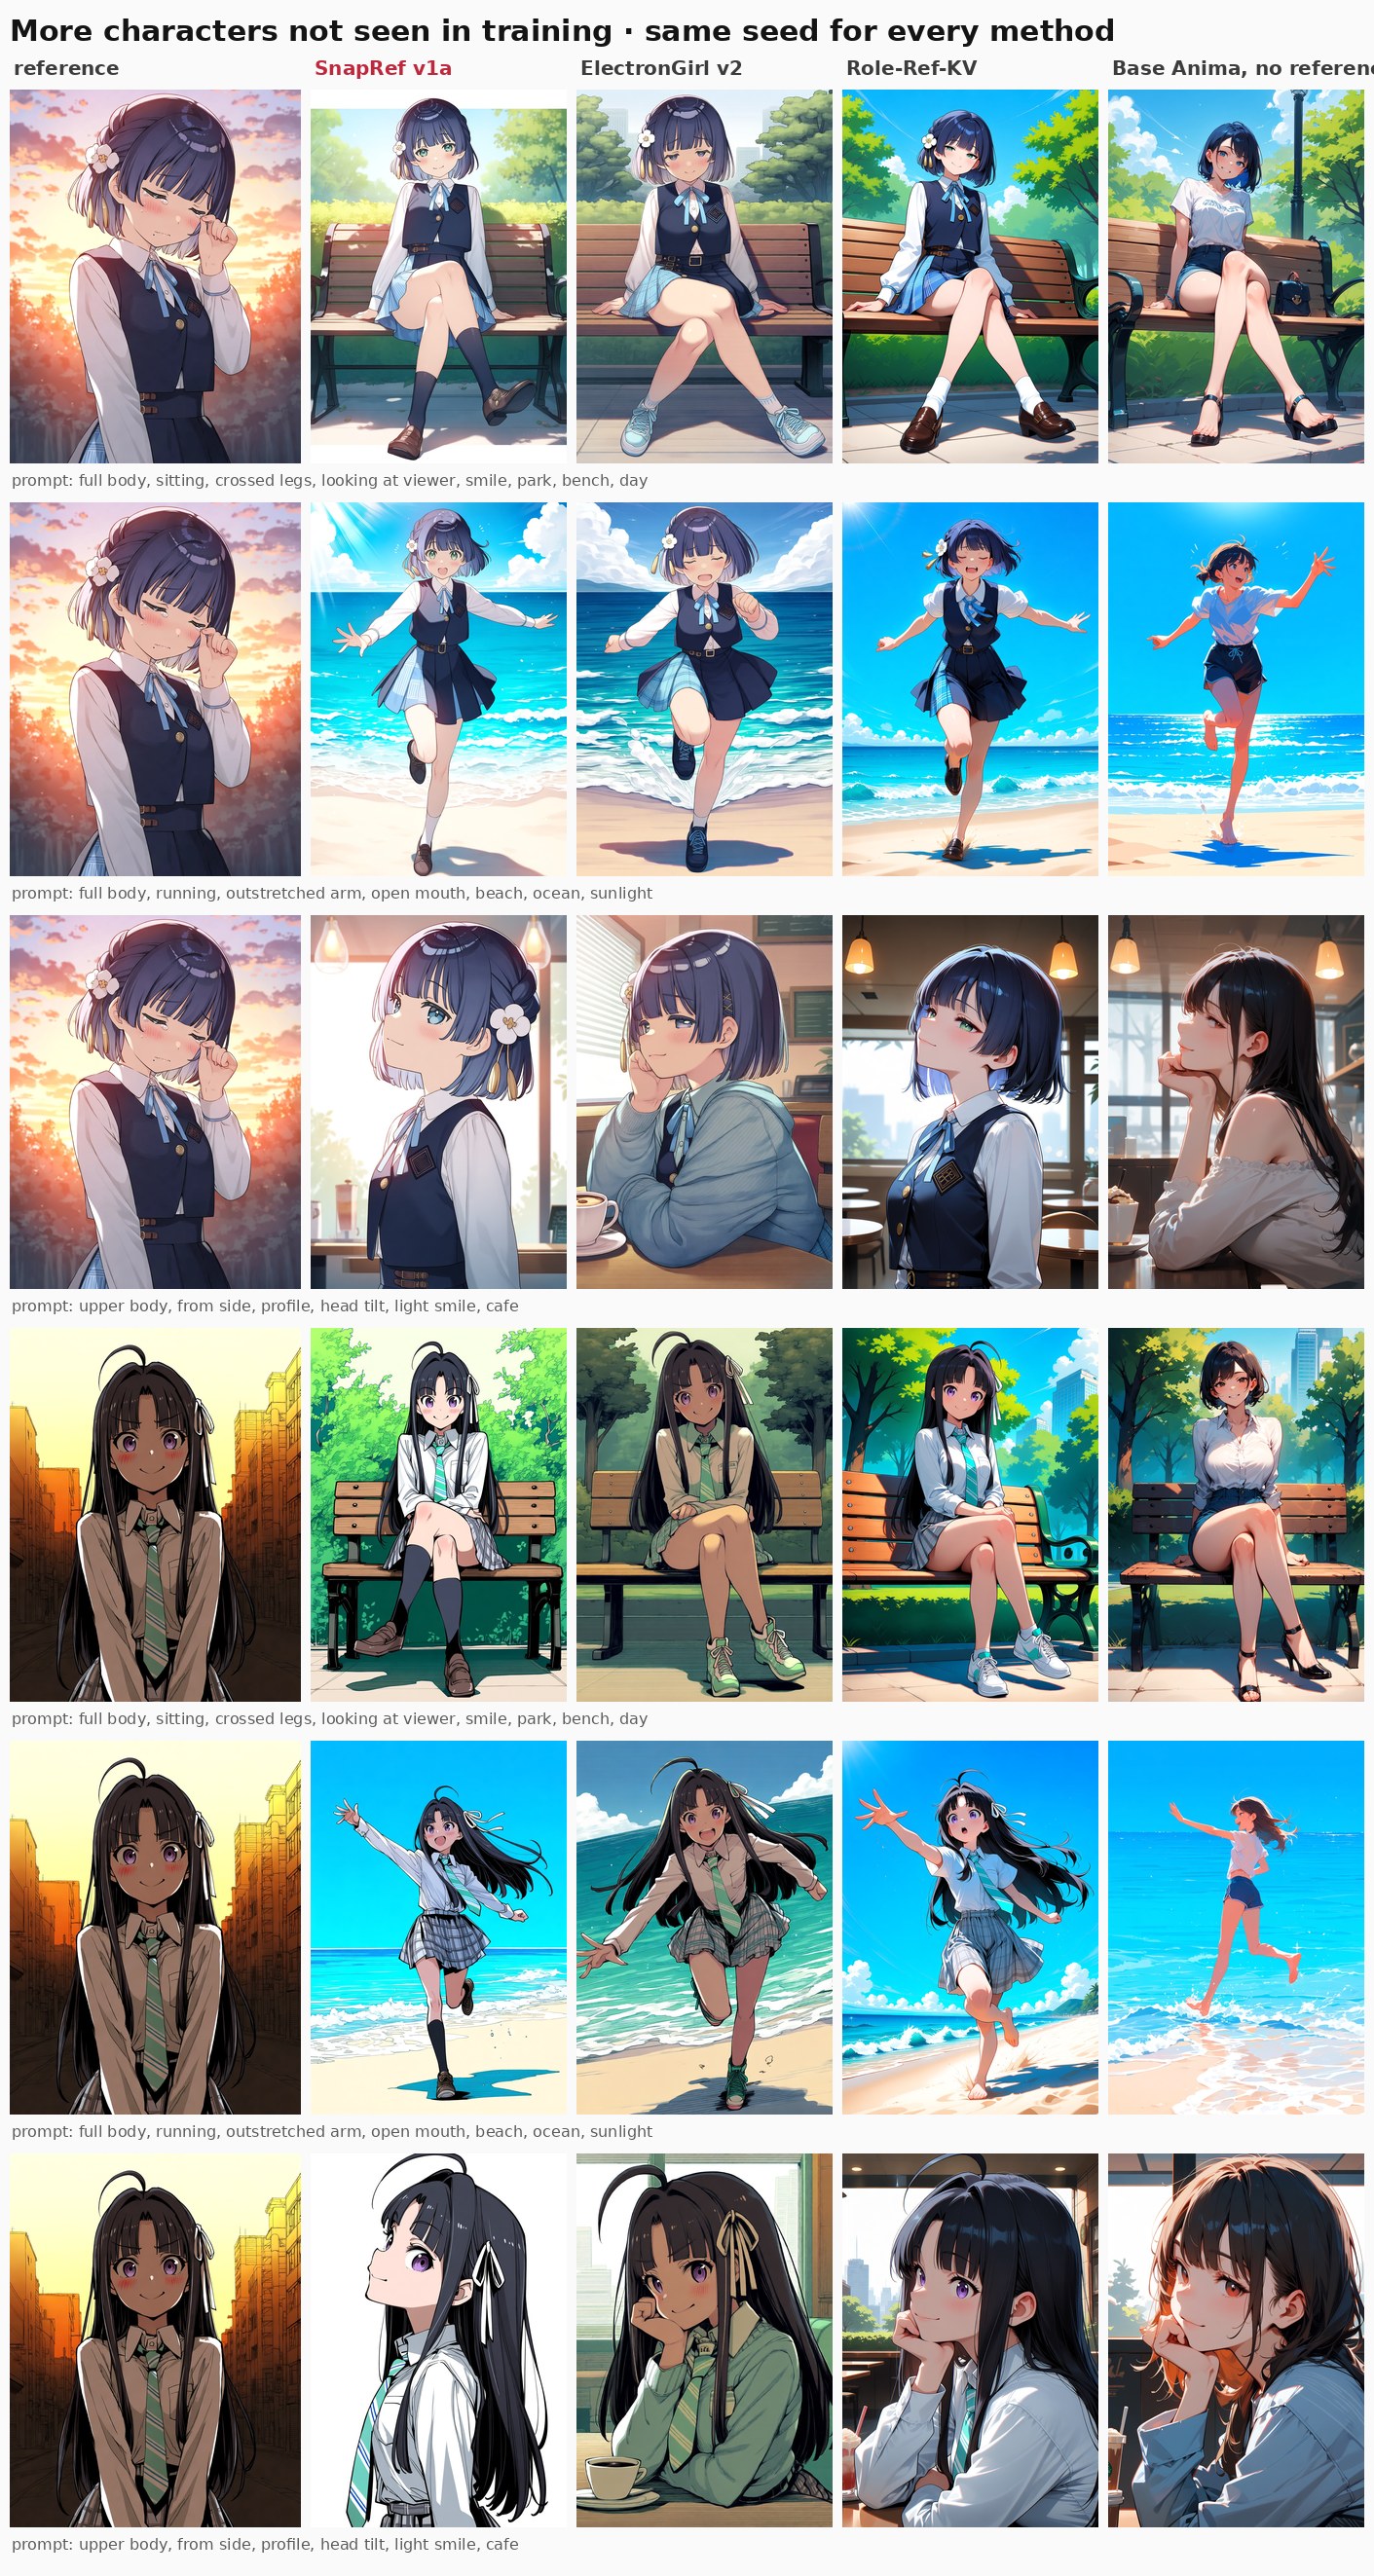
Referencias ajenas al conjunto de entrenamiento, procesadas por el adaptador.
Los datos de entrenamiento fueron generados por el propio Anima: 58.300 imágenes de 2.367 personajes, cada personaje dibujado en una variedad de escenas y poses con un mismo estilo de artista, y después una ejecución de unas 120 horas de GPU H100. Un segundo checkpoint, SnapRef v1b, duplica el rango del LoRA, sigue el prompt con mayor fidelidad y mantiene el personaje casi igual de bien.
El lado de ComfyUI
El paquete de nodos vive en el repositorio bajo comfyui/snapref/; cópialo en custom_nodes/, coloca el adaptador en models/loras/ y cárgalo con el nodo SnapRef en lugar de con un cargador de LoRA, ya que las dos ramas no son un LoRA simple. El nodo simple acepta una o dos imágenes, un modo, la fuerza y la fidelidad; el nodo avanzado expone todo lo demás, incluidos ref_in_uncond, ref_megapixels y ref_caption.
Se incluyen cinco flujos de trabajo: un solo personaje, dos personajes, varias referencias de un mismo personaje, una comparación lado a lado con otros adaptadores y el mínimo que aparece abajo. Para dos personajes, las instrucciones indican unir las dos referencias con el nodo principal Image Stitch y describir en el prompt quién está a la izquierda y quién a la derecha. El muestreo recomendado es euler o er_sde con simple, de 28 a 30 pasos y CFG 4,5.
El adaptador FP8 ocupa 195 MB en lugar de 382 MB y, según los informes, produce imágenes prácticamente idénticas, incluso sobre la base Anima en FP8. El nodo se actualizó el 31 de octubre para mantener la codificación de la referencia en fp32: con un checkpoint fp16, --fp16-unet o --fast con acumulación fp16, la versión anterior producía NaN y una imagen negra.
Dónde falla
La model card enumera los modos de fallo en lugar de ocultarlos. Los detalles muy pequeños, como pendientes, patrones finos y cicatrices, pueden simplificarse; una referencia de piel oscura puede salir más clara; y algunos prompts de cuerpo entero en exteriores convierten la parte inferior del encuadre en un suelo blanco liso a menos que se nombre el suelo. Una escena puede imponerse al atuendo de la referencia, así que un prompt de playa devuelve un bañador; subir strength o nombrar el atuendo lo mantiene. Con dos personajes, los atributos que las referencias no muestran con claridad, por ejemplo los ojos cerrados, pueden mezclarse entre ellos.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.