Anima Reference Adapter: una imagen, una nueva escena en ComfyUI
Anima Reference Adapter conserva personaje y estilo desde una sola imagen, mientras el prompt define pose y fondo. LoRA de rango 32 y tres nodos de ComfyUI.
Los modelos de anime con prompts por etiquetas solo dibujan a quien se les pide si el prompt detalla cada rasgo, y solo para personajes que el modelo ya conoce. Un adaptador de referencia le quita ese trabajo al texto: se le indica una imagen y el prompt queda libre para describir la pose, el encuadre y el lugar.
La mayor parte del acondicionamiento de referencia tomado de los modelos de video no hace ese intercambio. ComfyUI-Cosmos-Reference añade un latente de referencia como fotograma extra del clip, lo que funciona bien para edición, pero también copia la pose y la composición de la referencia, porque el prior de video lee ese fotograma como el plano anterior. Anima Reference Adapter busca lo contrario: conservar quién se dibuja y cómo, y descartar dónde y en qué pose.
Cómo se adjunta la referencia
Anima se ejecuta sobre Cosmos-Predict2 MiniTrainDIT: 28 bloques, ancho 2048, 16 cabezas, parches espaciales 2×2 sobre un latente VAE de Wan 2.1 de 16 canales, con un codificador de texto Qwen3-0.6B y flow matching con shift 3. Eso le da embeddings rotatorios de posición 3D sobre (t, h, w), que es la palanca que utiliza el adaptador.
La imagen de referencia se ajusta con letterbox a la resolución de salida, se codifica una vez con el VAE y se añade como un segundo fotograma latente. Tres cambios la separan de una referencia simple de estilo video:
- Fotograma de referencia limpio. El fotograma de referencia se alimenta con timestep 0 y el fotograma objetivo con σ. No se añade ruido en el lado de la referencia.
- RoPE desplazado. Las coordenadas de alto del fotograma de referencia se desplazan más allá de la cuadrícula objetivo (por una altura objetivo, más un pequeño jitter durante el entrenamiento), de modo que no sobrevive ninguna correspondencia píxel a píxel y el modelo no puede continuar la referencia como un plano.
- Un lector entrenado. Un LoRA de rango 32 con α = 32 en la autoatención, la atención cruzada y ambas capas MLP de cada bloque (280 módulos, 45,9 M de parámetros) aprende a leer ese fotograma desplazado. Se aplica mediante hooks forward y solo durante las llamadas al modelo que llevan una referencia, por lo que un modelo base cargado todavía puede ejecutar una pasada sin referencia.
La orientación también está dividida. Con la referencia en ambas ramas de CFG, solo se amplifica el texto; la guía utiliza escalas separadas para texto y referencia, de modo que ref_guidance puede llevar el resultado hacia la referencia sin tocar cfg. Una orientación de referencia alta sobresatura, así que el nodo aplica además guía adaptativa proyectada o CFG rescale.
Qué muestran los personajes no vistos en el entrenamiento
Los datos de entrenamiento son sintéticos y los genera el propio Anima: 600 grupos de un personaje en un estilo, seis renders cada uno con encuadre, cámara, pose, expresión, fondo e iluminación muestreados de forma independiente, para 3.600 imágenes de 300 personajes y 427 artistas en una única RTX PRO 6000 Max-Q en 4,25 horas. Se reservaron doce personajes por completo; los 576 grupos restantes produjeron 17.280 pares ordenados referencia-objetivo, de los cuales el 70 % eliminó todas las etiquetas de apariencia y vestuario del prompt objetivo.
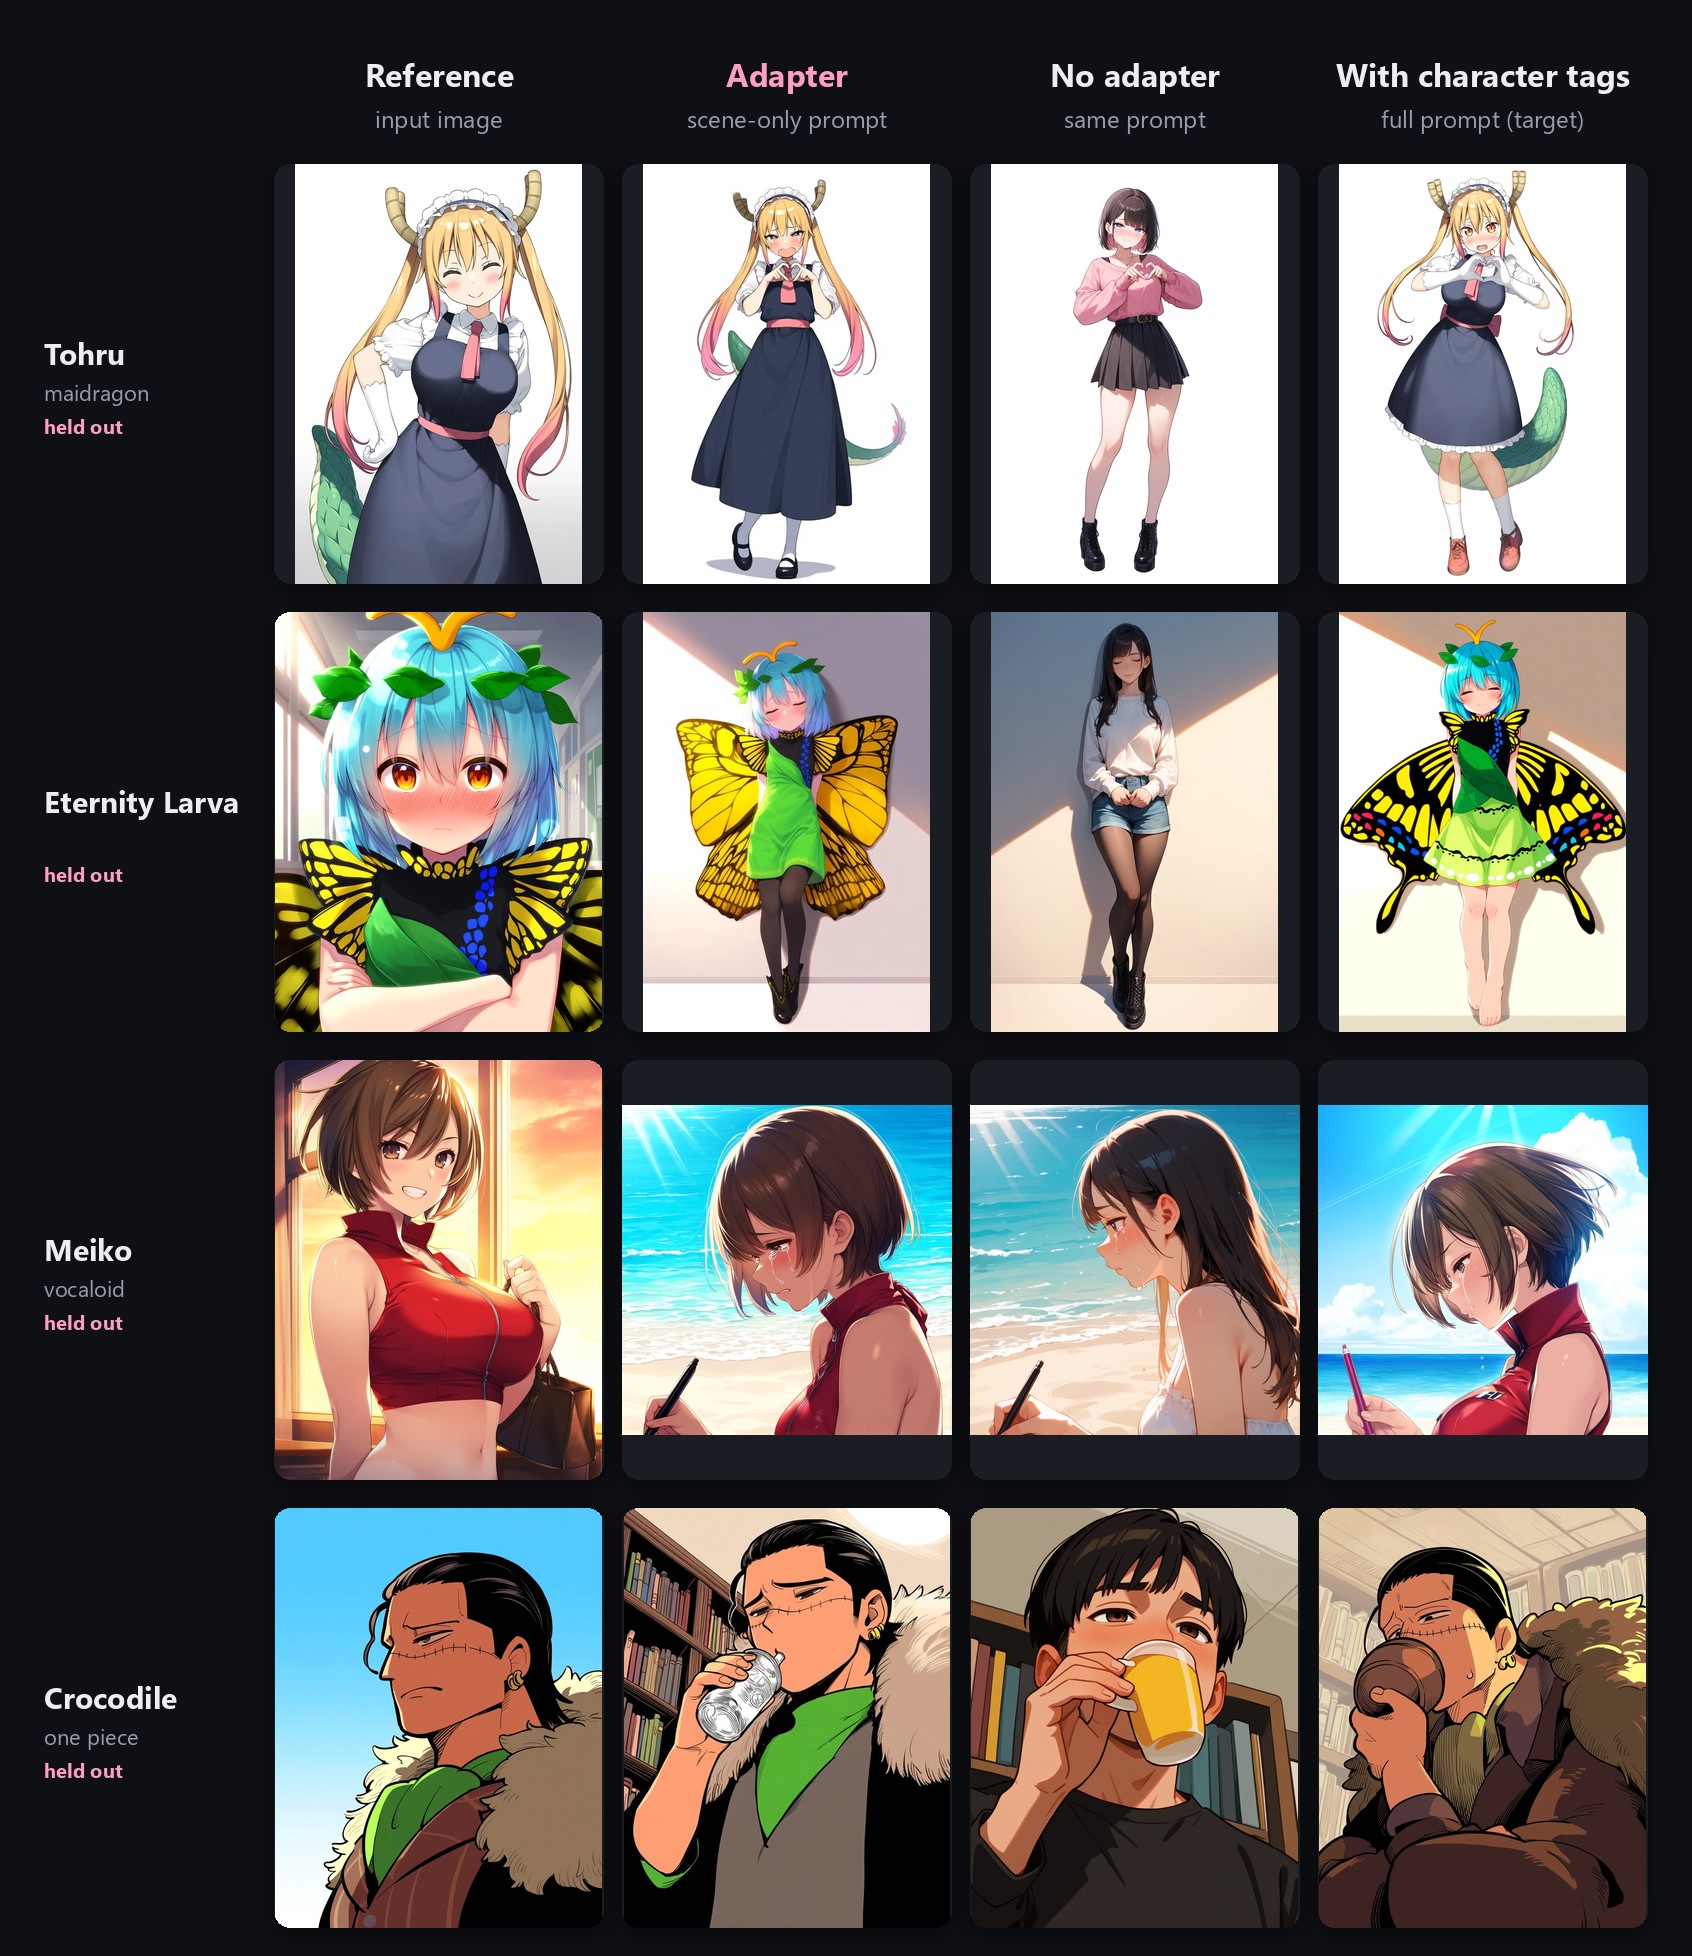
Personajes reservados, nunca vistos en el entrenamiento. Cada fila: la referencia; el adaptador con un prompt de solo escena; el mismo prompt sin el adaptador; y el modelo base al que se le pide el personaje por su nombre con todas las etiquetas de apariencia.
En los 18 casos de evaluación, el adaptador reproduce el color y el peinado del cabello, el color de los ojos, el atuendo y accesorios característicos como cuernos y cola, un halo, alas de mariposa o un tocado de sirvienta, mientras que el mismo prompt de solo escena en el modelo base sin adaptador devuelve un personaje genérico. La pose, el encuadre y el fondo siguieron el prompt en todos los casos, sin que se observara copia de la pose.
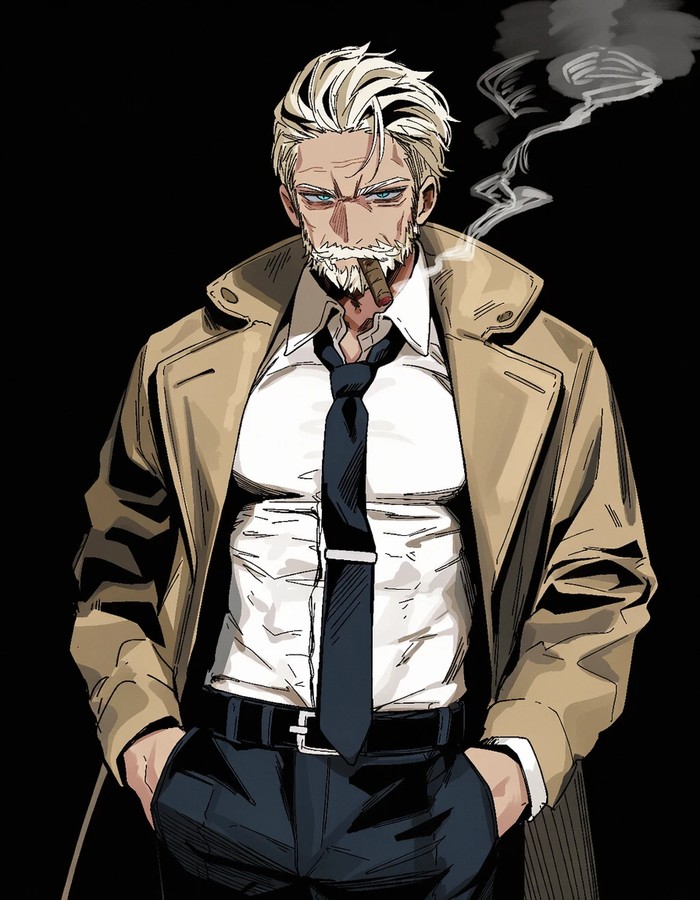
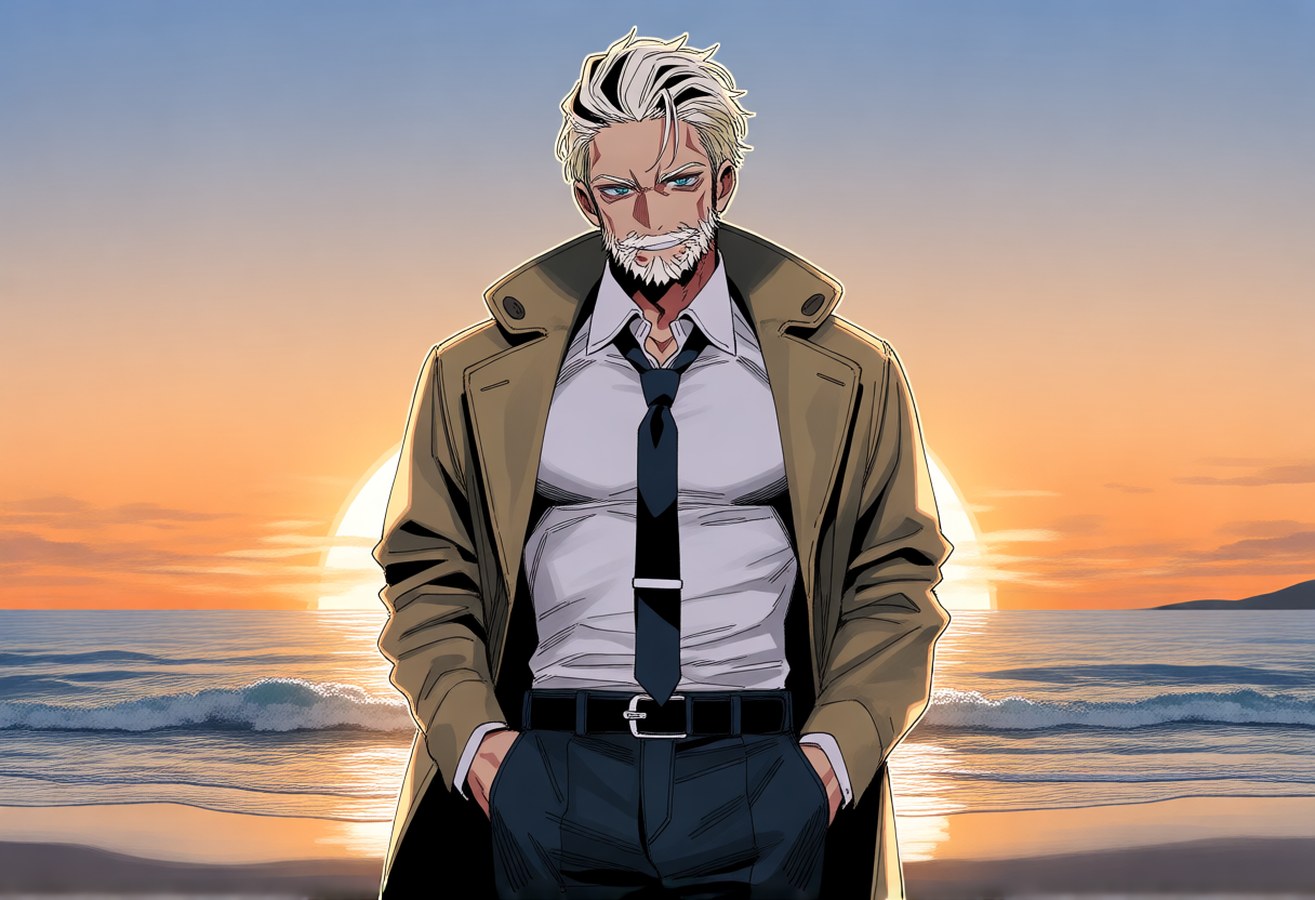
Dos referencias corrientes muestran la misma separación fuera del conjunto reservado:
 |  |
|---|---|
| Referencia A, la única imagen entregada al adaptador | cowboy shot, looking at viewer, smile, beach, ocean, sunset |
El prompt no incluye nombre de personaje, etiqueta de artista ni etiquetas de apariencia. Las configuraciones recomendadas son Euler con 28 a 30 pasos y simple, CFG de texto 4.5, orientación de referencia de 4.5 a 6 y APG, y cómputo en bf16, ya que Anima desborda en fp16.
El estilo es la mitad más débil
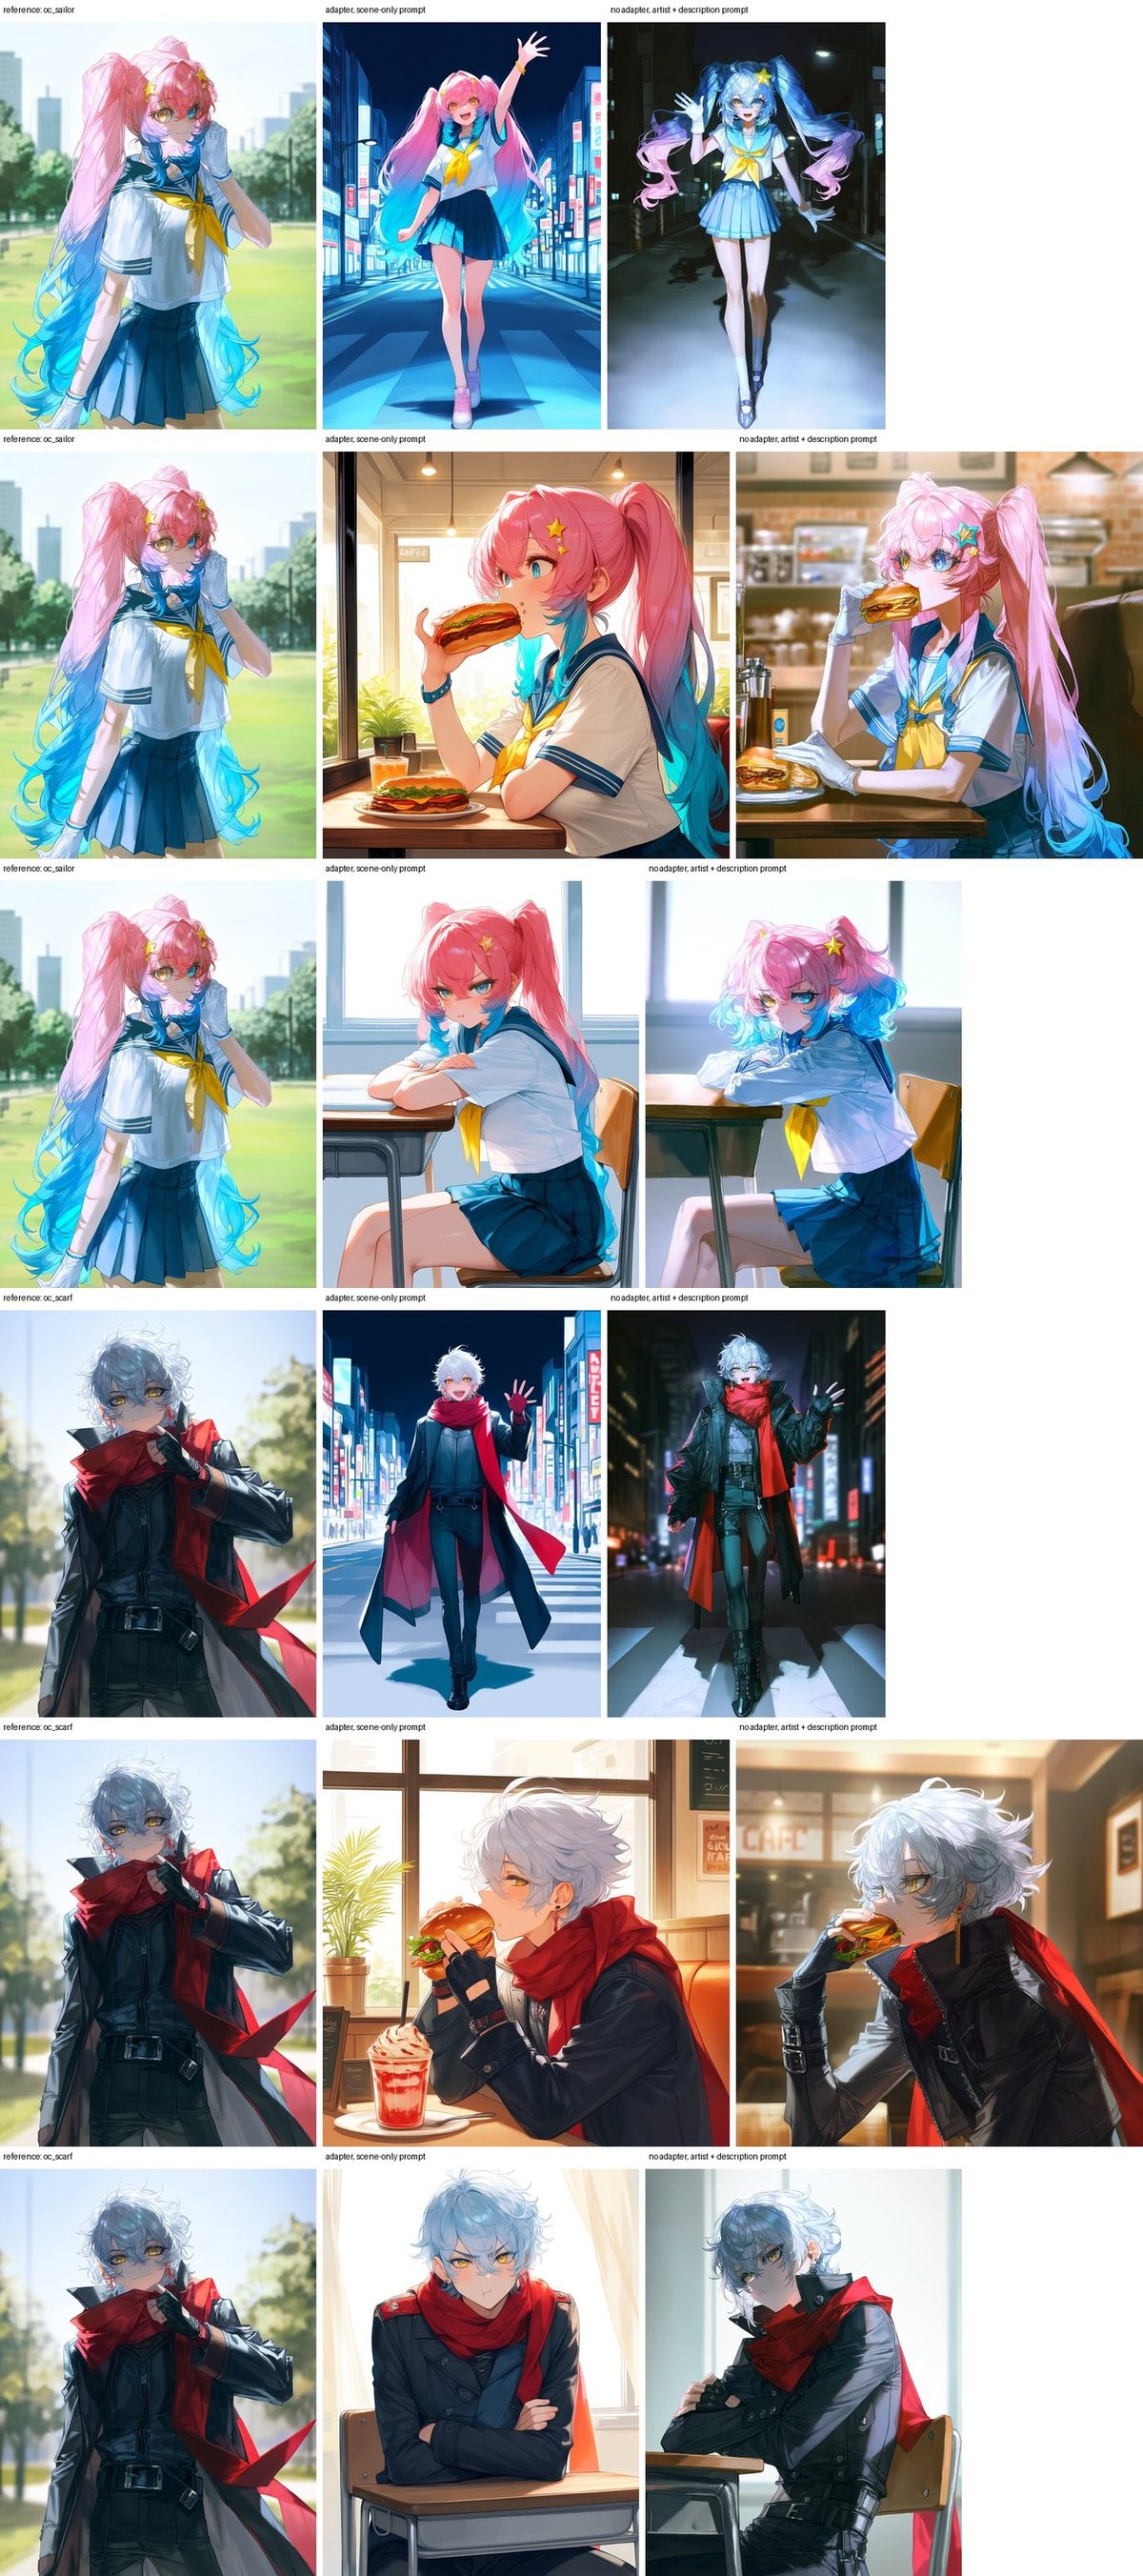
Personajes originales dibujados por el modelo base con una etiqueta de artista que nunca apareció en el entrenamiento. Cada fila: referencia; adaptador con un prompt de solo escena; modelo base con etiquetas de artista y descripción.
El diseño del personaje se transfiere bien: coletas con degradado, adornos de estrellas en el cabello, un pañuelo al cuello, cabello plateado con bufanda roja y guantes. El render pictórico del artista, la iluminación suave y la paleta apagada no se transmiten con orientación de referencia 1, y las salidas vuelven a un aspecto predeterminado de Anima más nítido.
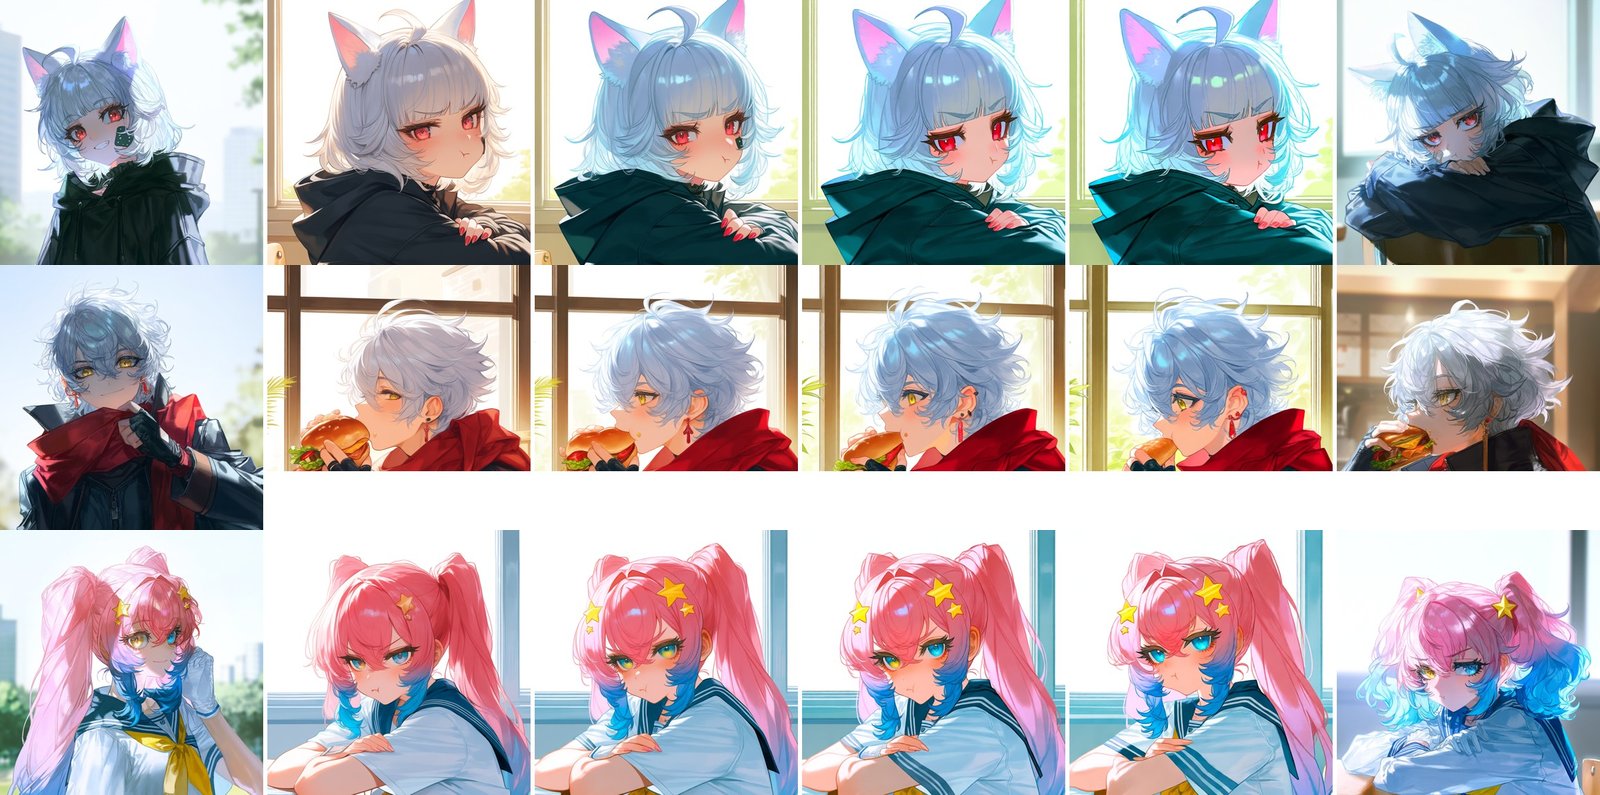
Recortes con orientación de referencia 1, 2.5, 4.5 y 6 junto a la referencia, con el modelo base más todas las etiquetas a la derecha.
Aumentar la orientación de referencia recupera la textura y los brillos del cabello, el render de los ojos, la paleta fría y pequeños accesorios como un vendaje o heterocromía que la orientación 1 descarta. Por encima de unos 4.5, los colores se sobresaturan y la deriva existente se amplifica, que es para lo que sirve la corrección APG o rescale. El render pictórico sigue sin aparecer, lo que el informe atribuye a que el LoRA aprendió poco de él y no a una amplificación insuficiente. El autor está generando un conjunto mayor de 2.000 personajes en tres estilos de artista y planea referencias separadas de personaje y estilo.
Los nodos
| Nodo | Qué hace |
|---|---|
| Anima Ref Adapter Loader | Adjunta el LoRA del adaptador a un MODEL de Anima. ref_offset_h se mantiene en 1.0, el valor de entrenamiento. |
| Anima Ref Latent | Ajusta la referencia al tamaño de salida con relleno blanco, la codifica y también devuelve el latente vacío para esa resolución. |
| Anima Ref Guider | Una GUIDER para SamplerCustomAdvanced con cfg de texto, ref_guidance, corrección APG o rescale, y parches posteriores al CFG como PAG. |
El núcleo de ComfyUI aporta el resto: UNETLoader para anima_baseV10.safetensors, CLIPLoader para el codificador Qwen3-0.6B, VAELoader para el VAE de Qwen-Image. El grafo básico funciona con 19 nodos en un único SamplerCustomAdvanced; el segundo flujo de trabajo añade Anima Safe PAG. Con ref_guidance en 1, la referencia está en ambas ramas de CFG y cada paso cuesta lo que cuesta un paso de CFG normal; por encima de 1, cada paso ejecuta el modelo tres veces, o aproximadamente 1,5× un paso de CFG normal. Los flujos de trabajo de ejemplo también usan Patch Sage Attention de ComfyUI-KJNodes, que se puede omitir.
Limitaciones
El piloto se entrenó con 300 personajes durante 2.000 pasos con rango 32, y el autor enumera lo que eso cuesta: la identidad se transfiere mucho mejor que el estilo, los estilos marcadamente pictóricos apenas se transfieren, los patrones pequeños, las cicatrices, los pendientes y los tonos de piel poco habituales a menudo se pierden, las prendas grandes pueden cambiar de color, y el personaje de referencia reaparece ocasionalmente como un objeto en la escena. Todos los pares de entrenamiento son renders de Anima, así que el adaptador hereda los sesgos del modelo base, y la evaluación hasta ahora es cualitativa, sin métricas de similitud de identidad o estilo.
Disponibilidad
Los pesos del adaptador están en Hugging Face como anima_ref_adapter_pilot_r32.safetensors (unos 92 MB) y se colocan en ComfyUI/models/loras/. El paquete de nodos se instala con git clone https://github.com/ElectronGirl/ComfyUI-Anima-Ref-Adapter.git dentro de ComfyUI/custom_nodes, y necesita Anima base v1.0 junto con su codificador de texto Qwen3-0.6B y el VAE de Qwen-Image. El adaptador se entrenó sobre el modelo base, así que el LoRA turbo de Anima aún puede cargarse delante del cargador del adaptador usando sus pasos y CFG habituales.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.