Control de color/profundidad de MOSS-Image llega al núcleo de ComfyUI
Un adaptador comunitario guía MOSS-Image con un mapa plano de regiones de color y un mapa de profundidad desde ruido puro, con soporte ese mismo día en el núcleo de ComfyUI.
MOSS-Image es el modelo de texto y diseño de 5B de OpenMOSS que se lanzó con una implementación en el núcleo de ComfyUI esa misma semana. Sus mecanismos existentes para controlar la composición son un diseño JSON de cajas y un LoRA de edición para cambios guiados por referencia. Ninguno responde a una pregunta más sencilla: pon a esta persona aquí, a esta escala, de pie frente a ese escritorio.
El nuevo adaptador responde con dos mapas en lugar de una imagen. El color codifica dónde se sitúa cada región, la profundidad codifica a qué distancia está cada superficie, y la generación sigue partiendo de ruido puro. No se copia nada de una imagen de referencia, por lo que el fondo proviene del prompt y no del render del que se trazaron los mapas.
Dos mapas como acondicionamiento
La ficha define las entradas de forma estricta, y eso es lo que la hace utilizable:
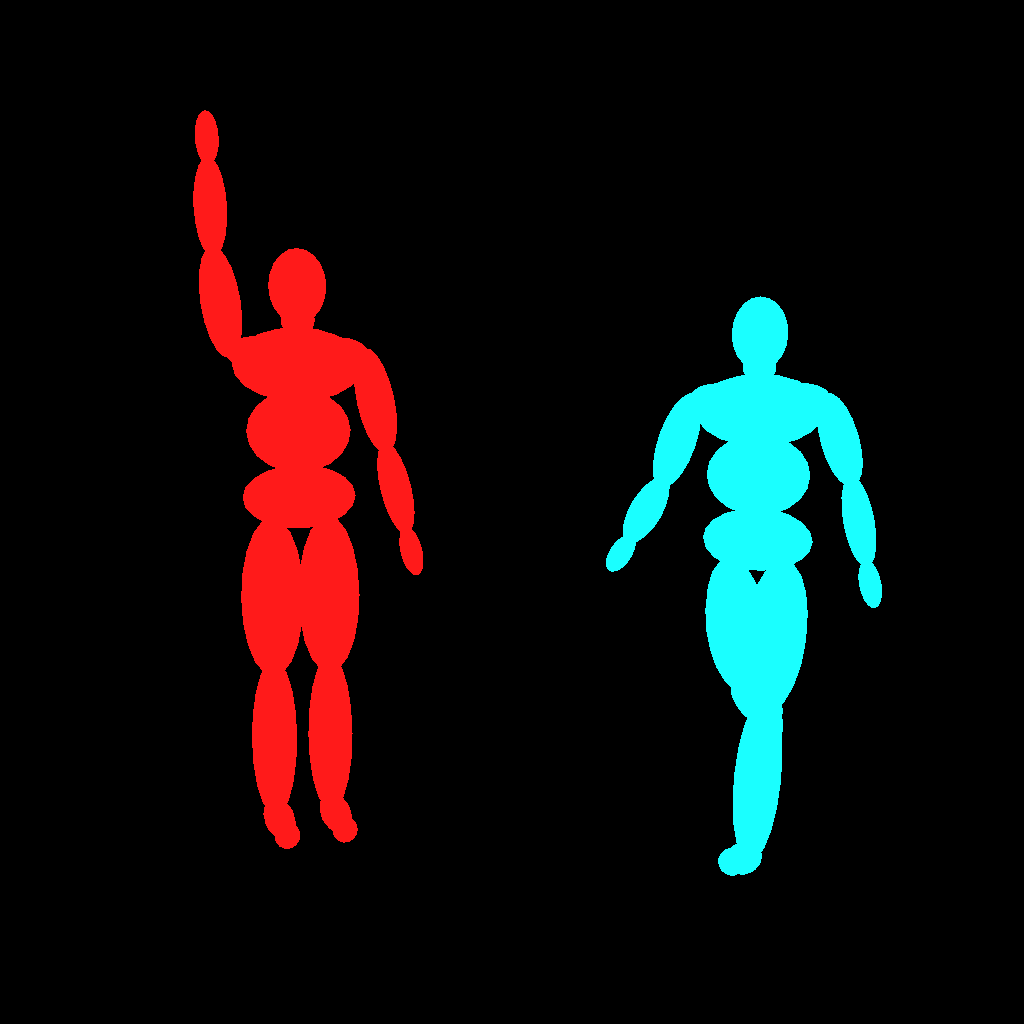
- Mapa de color: una imagen RGB del tamaño de salida donde cada objeto o región recibe un color plano. Los colores son identificadores de región, no colores con los que pintar, y el negro significa no especificado.
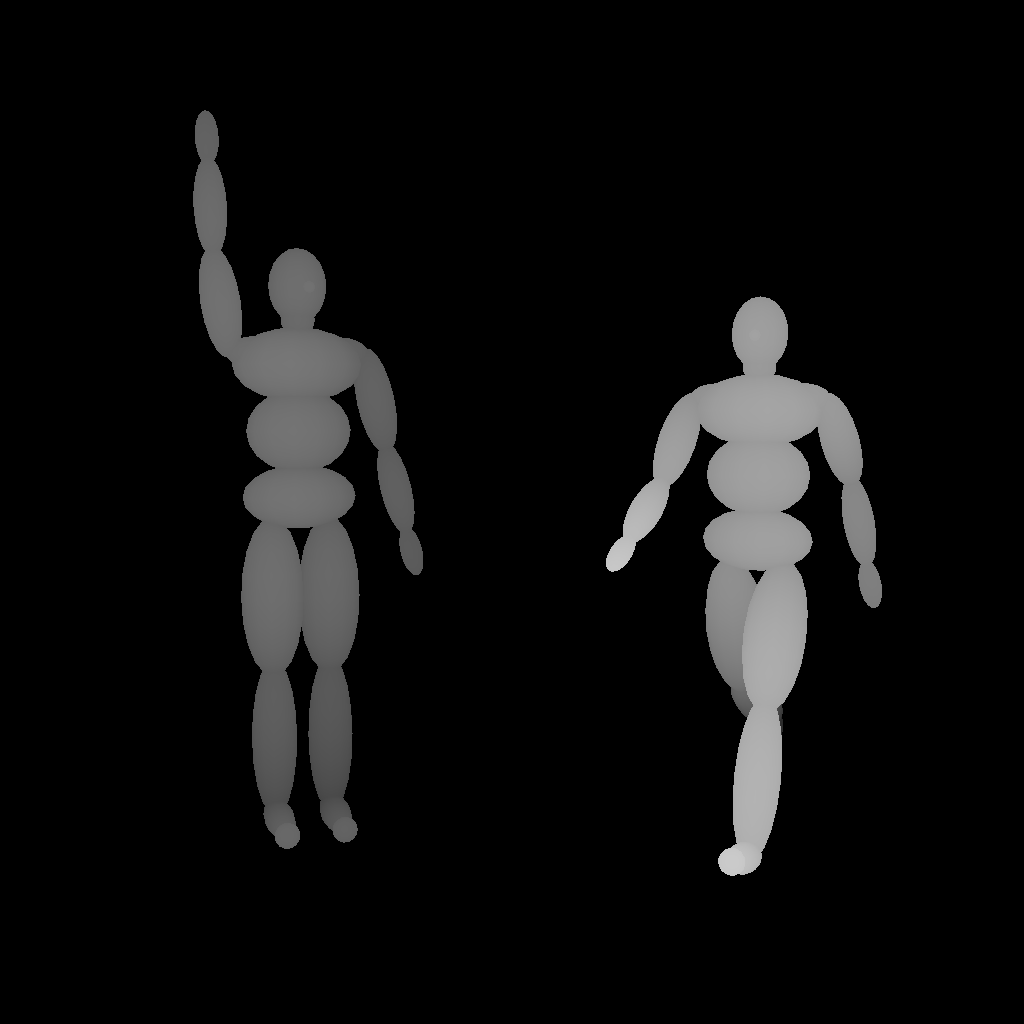
- Mapa de profundidad: en escala de grises al tamaño de salida, con lo cercano en blanco.
- Cualquiera de los dos mapas puede omitirse. El adaptador se entrenó con control dropout del 35% solo color, 35% solo profundidad, 20% ambos y 10% ninguno, por lo que las ejecuciones con un solo mapa permanecen dentro de la distribución de entrenamiento.
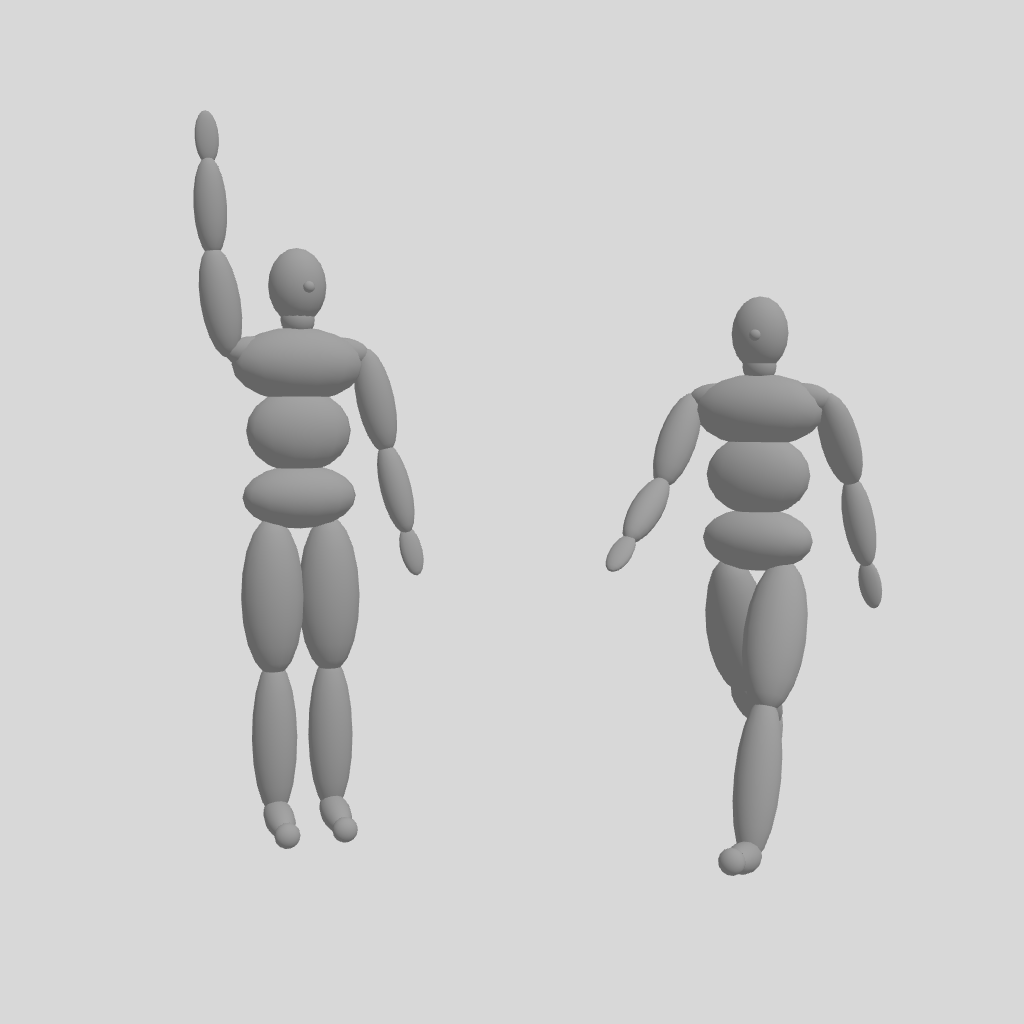
Cada escena se crea desde un editor de maniquíes en three.js, que exporta juntos un render sombreado, una pasada de color y una pasada de profundidad:
 |  |  |
|---|---|---|
| Render de origen | Mapa de regiones de color | Mapa de profundidad, lo cercano en blanco |
La comparación que importa es con image-to-image. Pasar un render 3D a un proceso img2img conserva el diseño, pero también conserva el fondo plano y las superficies grises del render. Con el adaptador, la ubicación, la escala y la pose siguen a los mapas mientras que el material y la iluminación se generan, y por eso las escenas publicadas son maniquíes 3D en lugar de fotografías.
Cómo se ve la salida
La figura principal de la ficha es una cuadrícula de la misma escena de maniquí con dos personas, con el control mantenido durante toda la ejecución frente a desactivado a mitad de camino.
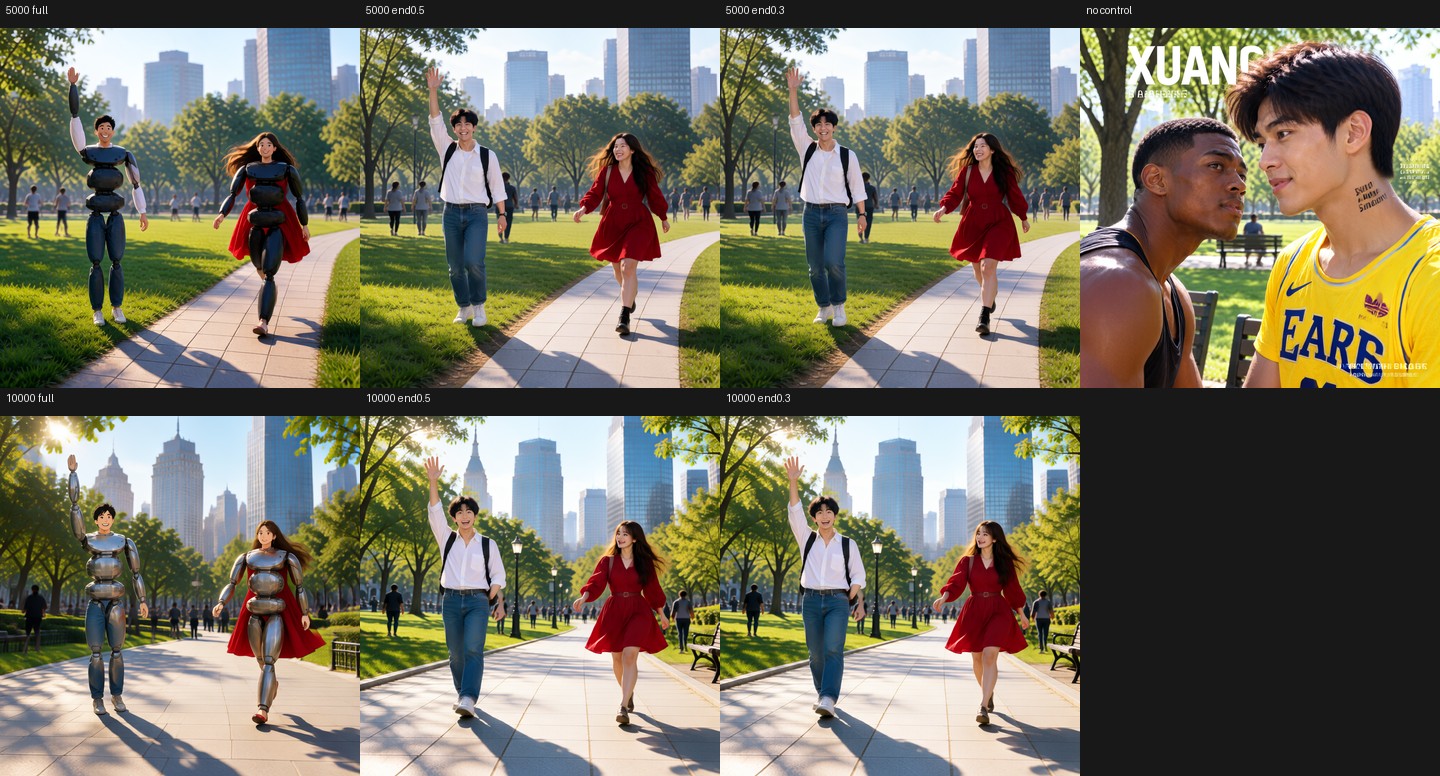
Publicado con el adaptador: fila superior a 5.000 pasos, fila inferior a 10.000, comparando el control mantenido hasta el final, terminando en 0.5, terminando en 0.3 y el modelo base sin control. Mantenido hasta el final, la superficie del maniquí se transparenta; terminando en 0.5 se colocan personas reales donde indican los mapas.
Esa cuadrícula es también la declaración honesta de la principal debilidad del adaptador. El control durante toda la ejecución reproduce el maniquí, porque los mapas de profundidad de entrenamiento provinieron de fotos reales y nada en los mapas dice "deja de ser madera". Terminar el control a la mitad de los pasos mantiene el diseño y deja que los pasos restantes resuelvan la piel, la ropa y el fondo.
El mismo adaptador con solo los mapas y sin prompts por región da el otro modo de fallo que documenta la ficha: con un mapa de color de estilo manga, el diseño de las viñetas se desvía y el texto se degrada en los checkpoints posteriores.
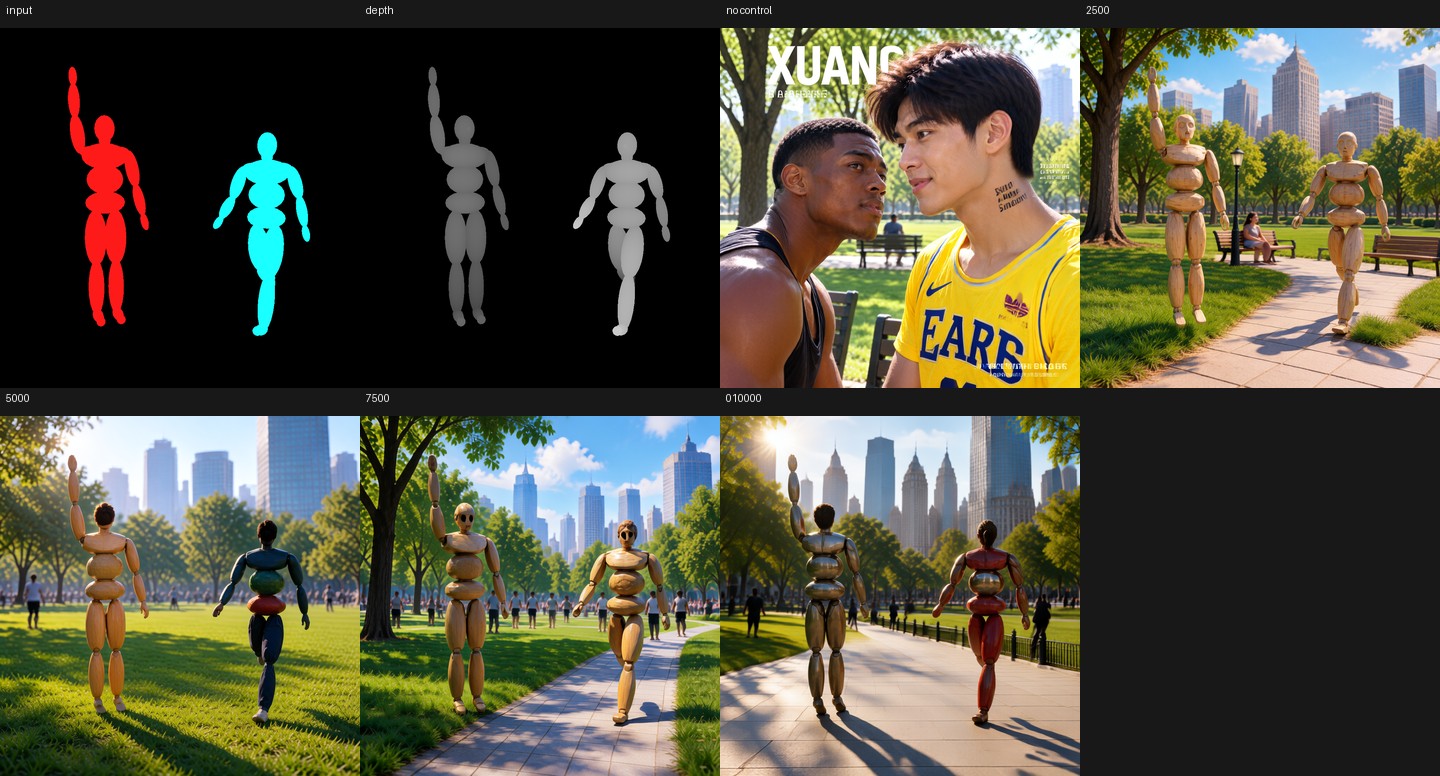
La escena de dos personas usando los mapas sin prompts por región. Fuente: darask0/MOSS-Image-color-depth-control
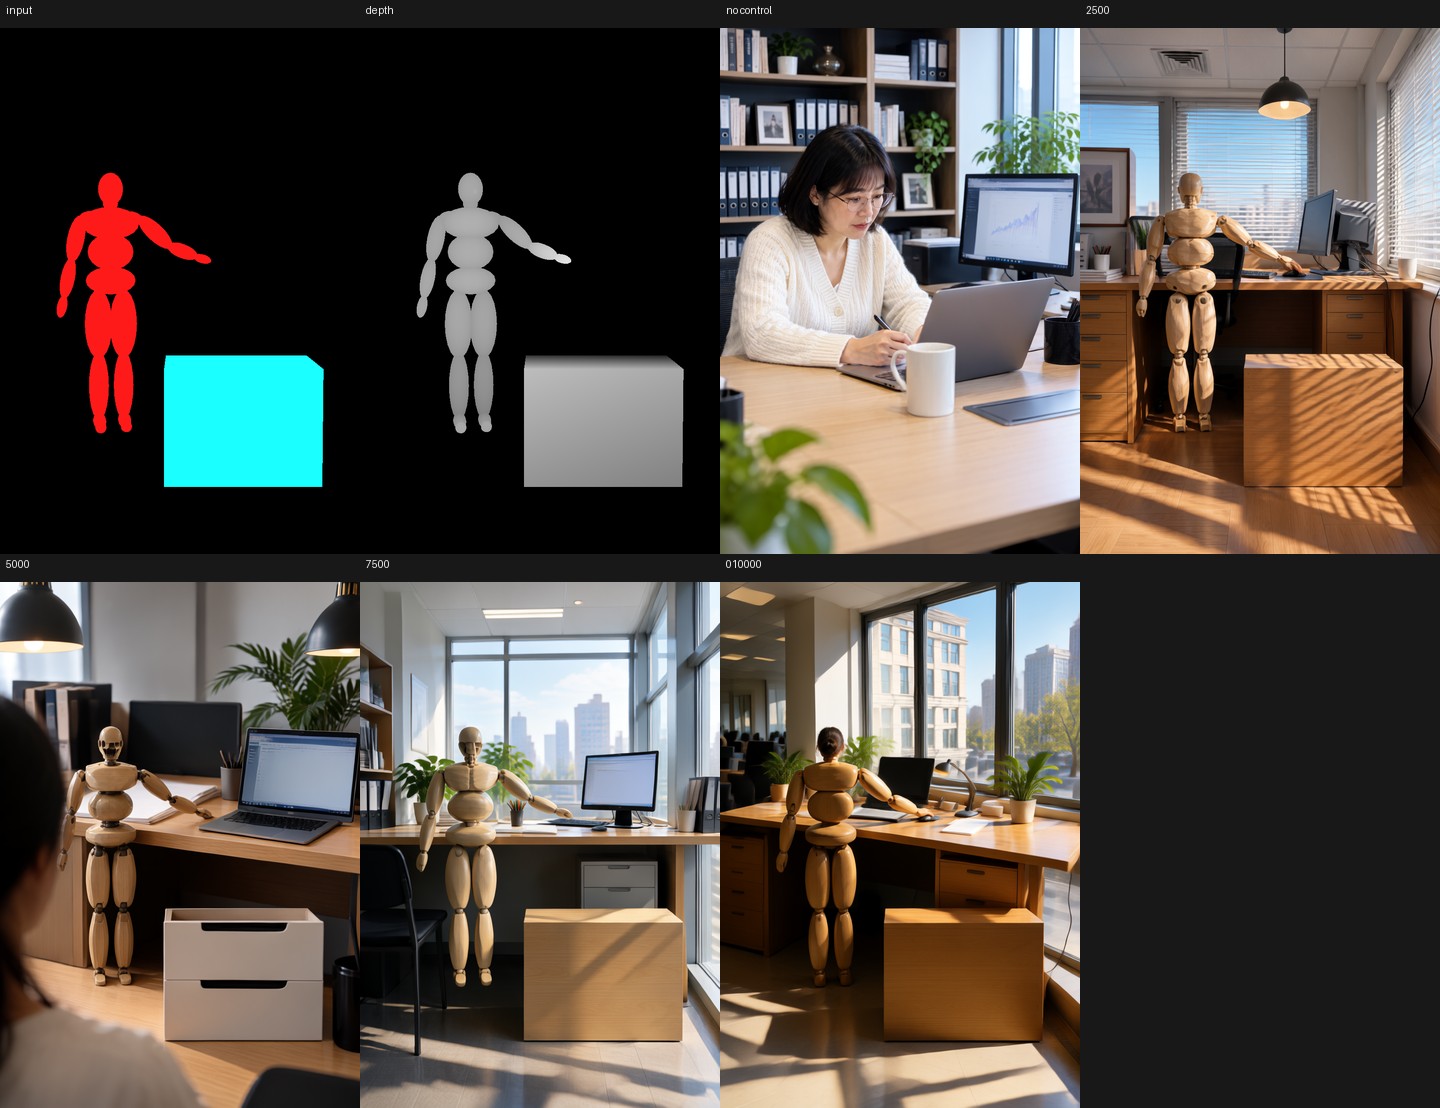
La segunda escena publicada, una persona en un escritorio, de nuevo con solo los mapas.
Ruta en el núcleo de ComfyUI
El PR #17206 de Kijai, fusionado el 19 de octubre a las 22:15 UTC, añade un nodo: MOSS-Image Color/Depth Control (MOSSImageControl), experimental, bajo model/conditioning/moss_image. Recibe el acondicionamiento positivo y negativo, el VAE, un color_map opcional, un depth_map opcional, además de strength, start_percent y end_percent, y devuelve ambas secuencias de acondicionamiento.
El grafo es el habitual de MOSS-Image con dos añadidos. El adaptador se carga mediante el cargador de LoRA estándar sobre el modelo de difusión, y el nodo de control se sitúa entre la codificación de texto y el muestreador. start_percent y end_percent son el equivalente en el núcleo del color_end y depth_end de la ficha, por lo que el 0.5 documentado para entradas sintéticas y el 1.0 para mapas trazados desde imágenes reales se traducen directamente en valores de nodo.
Merece la pena conocer el mecanismo porque explica el formato del archivo. El adaptador amplía la entrada video_embedder del modelo de 128 a 384 canales: el latente ruidoso del VAE de FLUX.2 en el primer tercio, el latente del mapa de color en el segundo y el latente del mapa de profundidad en el tercero. El PR añadió un concat_cond a la clase del modelo MOSS-Image que aumenta la resolución de lo que pase el nodo, lo añade al ruido y sustituye por un latente cero cuando falta un mapa, porque una entrada cero es exactamente "sin control" para un embedder lineal. También añadió una conversión en lora_convert.py que convierte las claves ampliadas de video_embedder en parches de reemplazo en lugar de adiciones, ya que el embedder se reemplaza en lugar de ajustarse.
Los prompts por región siguen siendo una ruta separada anterior a este PR: MOSS-Image Layout Prompt construye el JSON de diseño a partir de cajas creadas por Create Bounding Boxes, con el pie de foto de cada caja como su prompt. La ficha del adaptador recomienda combinar los mapas de control con esos prompts por región, y los ejemplos publicados se muestrearon de esa forma.
El soporte se fusionó después de la etiqueta v0.42.1, por lo que una instalación publicada necesita una compilación más reciente que esa etiqueta.
Configuraciones de la ficha
| Configuración | Valor | Motivo |
|---|---|---|
| Checkpoint del adaptador | moss-control.safetensors | 10.000 pasos, el recomendado |
strength | 1.0 | fuerza de entrenamiento; 0.0 equivale a sin mapas |
end_percent (mapas de maniquí 3D) | 0.5 | el control guía el diseño y la pose, luego se libera |
end_percent (mapas de fotos reales) | 1.0 | mantener el control durante toda la ejecución |
| Prompts por región | uno por color | sin ellos, un mapa con forma de maniquí se dibuja como un maniquí |
Los checkpoints anteriores son alternativas a la fracción final: 2.500 pasos sigue el mapa con menos fidelidad y se parece menos al maniquí; 7.500 y 10.000 lo siguen más. Los cuatro están en el repositorio.
Para ganar velocidad, el adaptador rapid-moss de 4 pasos del mismo autor, de darask0/MOSS-Image_4-step_adapter_lora, que el sitio cubrió el 17 de octubre, es la combinación documentada: la ficha informa de unos 1,8 s por imagen de 1024² en una RTX PRO 6000 con él.
Cómo se entrenó
Inspeccionar la cabecera del safetensors da 526 tensores: pares LoRA de rango 64 y alpha 64 en q, k, v, o, ffn_up_gate y ffn_down de las 42 capas del DiT (252 pares), cinco proyecciones por bloque en dos bloques del codificador de texto (10 pares), y el peso y el sesgo de reemplazo de video_embedder.
El entrenamiento se ejecutó sobre el transformer de MOSS-Image Base, congelado en FP8, con el embedder ampliado a 384 entradas y sus columnas de control inicializadas a cero. Los datos son 10.000 imágenes de Krea 2 Turbo a resolución de clase 1024 en cinco relaciones de aspecto con sus pies de foto; los mapas de color provinieron de Mask2Former Swin-L sobre la segmentación panóptica de COCO, y los mapas de profundidad de Depth Anything V2 Large. La optimización es AdamW a 1e-4 con una tasa de aprendizaje 10x en las columnas de control del embedder, batch 1, 10.000 pasos a 0,8 s por paso en una RTX PRO 6000, la distribución de timesteps logit-normal de MOSS y un 10% de pies de foto vacíos. La configuración y el script de entrenamiento se distribuyen con los pesos.
Límites que conviene conocer
La ficha es inusualmente directa sobre lo que no funciona:
- Aspecto de maniquí. El control durante toda la ejecución sobre un render 3D reproduce la superficie de madera o metal del render, ya que la profundidad de entrenamiento provino de fotografías.
- La precisión de la pose es más gruesa que el mapa. Los dedos y las caras se generan, no se proyectan.
- El control por sí solo no basta para los diseños. Sobre un mapa de color manga pierde la estructura de viñetas y estropea el texto a partir de 7.500 pasos.
- La combinación está limitada en el runtime Hayate del autor. La tarjeta indica que el adaptador no se puede combinar con img2img ni con inpainting allí, una u otra.
- El prior de estilo es fotográfico. Los datos de entrenamiento fueron salidas de Krea 2 Turbo.
- Sin benchmark. Evaluado en un puñado de escenas y dos semillas, según la ficha.
El adaptador tampoco es un lanzamiento oficial de OpenMOSS: los pesos, el código de entrenamiento y el runtime de referencia provienen de un solo autor, mientras que el soporte en el núcleo es la parte que revisaron los mantenedores de ComfyUI.
Disponibilidad
- Adaptador: darask0/MOSS-Image-color-depth-control, cuatro checkpoints, unos 30 me gusta una semana después de la subida.
- Núcleo de ComfyUI: PR #17206, fusionado el 19 de octubre de 2026, después del lanzamiento de v0.42.1.
- Combinación de velocidad: darask0/MOSS-Image_4-step_adapter_lora.
- Modelos base: MOSS-Image-Base y MOSS-Image-SFT, con pesos de ComfyUI de archivo único en Comfy-Org/MOSS-Image.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.