MOSS-Image Edit HQ v5 llega con dos formatos LoRA para ComfyUI
Un LoRA comunitario de edición para MOSS-Image llega a la v5: masked loss, 256 tokens de referencia y dos formatos para ComfyUI, con cuadrículas de evaluación y un Space de demo.
MOSS-Image es el modelo de texto y layout de 5B de OpenMOSS, cubierto en su lanzamiento, que adquirió la edición por instrucciones dos semanas después mediante un adaptador de la comunidad de rango 64. Ese adaptador era chinoll/Moss-Image-Edit, y la pregunta que dejó abierta era cuánto del comportamiento de edición proviene de ese único conjunto de entrenamiento. MOSS-Image-Edit-HQ la responde reconstruyendo la capacidad a partir de otros datos y midiéndose contra el original.
Qué cambia realmente la v5
El repositorio es un registro de cinco brazos de entrenamiento, no un solo lanzamiento. Cada brazo continuó desde el checkout anterior, y cada uno se conserva en disco con sus muestras, de modo que las diferencias son inspeccionables en lugar de solo afirmarse.
| Brazo | Datos y cambios | Resultado |
|---|---|---|
| v1 | warm-start más desde cero, datos multirreferencia, 1024px | perdió la puerta de evaluación, chinoll mantuvo mejor la identidad |
| v2 | filas quirúrgicas de OmniEdit, lr 1e-5, 300 pasos | reemplazado por v3 |
| v3 | filas quirúrgicas de ConceptEdit-12M filtradas a 6,000, 700 pasos | reemplazado por v4 |
| v4 | datos de eliminación, faciales y de entorno, 4,644 filas, masked loss con inverted_mask_prior | reemplazado por v5 |
| v5 | 5,644 filas con leyendas de escena completas, máscaras de diferencia de píxeles, masked loss, presupuesto de 256 tokens de referencia, 1,200 pasos | checkpoint actual |
El cambio de la v5 que más importa es el presupuesto de referencia. MOSS-Image base da a la imagen de referencia 144 tokens; este brazo lo eleva a 256, que es de donde se afirma que proviene la mejora en identidad y detalle fino. El resto de la v5 es trabajo de datos: máscaras de diferencia de píxeles para que las regiones no editadas se mantengan cerca de la fuente, y leyendas de escena completas derivadas de los metadatos de ConceptEdit para que la instrucción describa todo el fotograma en lugar de solo la edición.
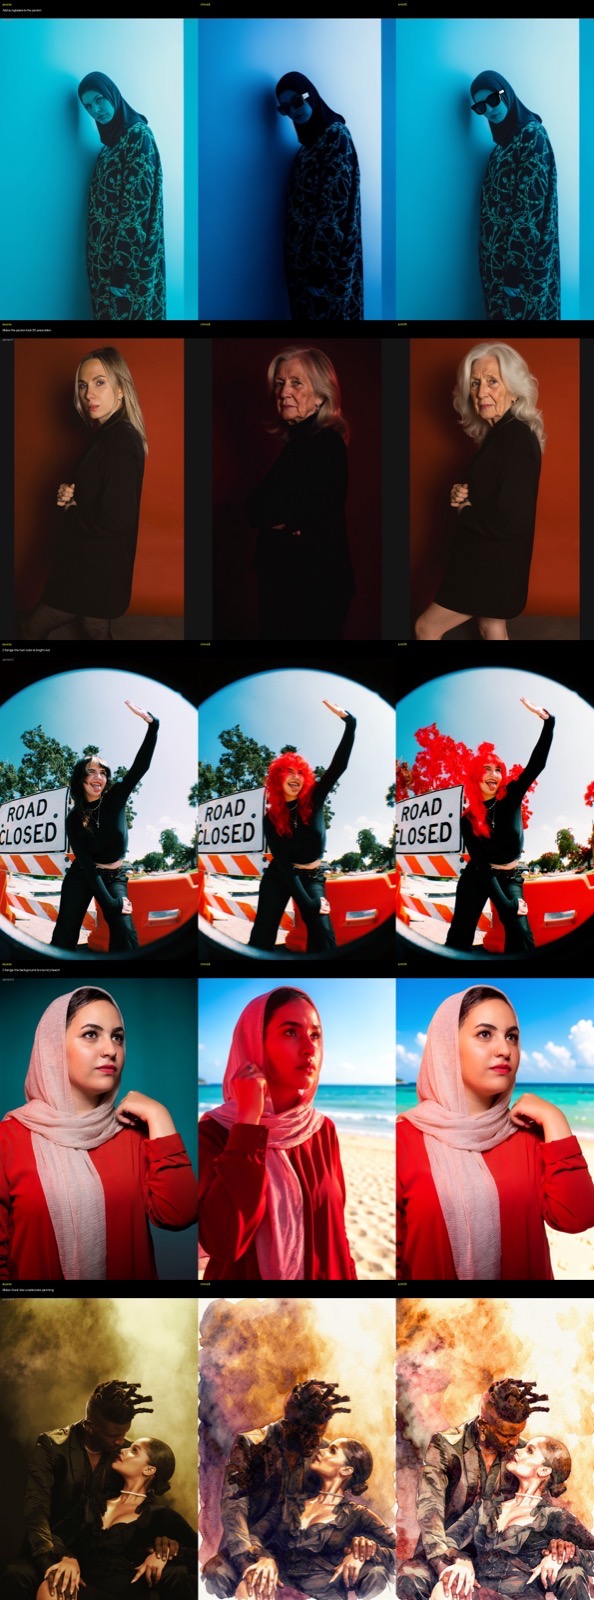
Cada fila comienza con la imagen de origen y continúa con la salida de la v5. Fuente: akhaliq/MOSS-Image-Edit-HQ
Los checkpoints ocupan 495 MB cada uno en formato peft: el final más los pasos 250, 500, 750 y 1000. El entrenamiento se ejecutó en ai-toolkit en el commit 14f8f95, una sola GPU por brazo, con el codificador de texto congelado y gradient checkpointing requerido a 1024px. Los datos de entrenamiento también están publicados: 6,000 filas filtradas de ConceptEdit-12M como fragmentos TAR, y las configuraciones de los brazos están en el repositorio.
Dos rutas en ComfyUI, dos diseños de LoRA
La razón por la que este lanzamiento requiere un poco de lectura es que los mismos pesos se distribuyen en dos diseños que se cargan mediante mecanismos distintos de ComfyUI.
La ruta nativa usa weights/armV5/armV5.safetensors como un LoRA normal: colócalo en models/loras/, añade un cargador de LoRA después de Cargar modelo de difusión y codifica con el nodo experimental Codificar texto para edición de MOSS-Image con edit_format establecido en ai-toolkit. Las referencias se reducen a un máximo de 384x384 antes de que las vea el codificador de texto.
La ruta del plugin usa armV5-moss-edit-lora.safetensors, que en cambio va en models/model_patches/ y se carga mediante Chenkin-x/ComfyUI-Moss-Image-Edit, el mismo paquete de nodos que usa el adaptador anterior. Ese paquete requiere ComfyUI 0.42.3 o posterior.
La ruta nativa solo está disponible en una compilación maestra actual. El PR #17296 de Kijai se fusionó el 22 de octubre y añadió el nodo de edición, pero la versión etiquetada más reciente, la v0.42.5 del 23 de octubre, todavía incluye el antiguo comfy_extras/nodes_moss_image.py sin él, por lo que una instalación de lanzamiento tiene que actualizar a una nocturna para usar edit_format = ai-toolkit. Ambos flujos de trabajo se distribuyen con los nombres de archivo y las configuraciones ya rellenados, para una referencia y para hasta cuatro.
| Configuración | Valor |
|---|---|
| Muestreador | Euler, flow matching |
| Shift | 5.0 |
| Pasos | 50 (calidad), 8 con el stack de velocidad DMD |
| CFG | 3.0, súbelo a 3.5 o 4.0 para ediciones débiles |
| Capa SLG | 22 |
| Tamaño de referencia | resolución de origen hacia el codificador, 384x384 máximo |
| Salida | hasta 1024px |
El diseño ai-toolkit no es el mismo que el diseño Moss-Image-Edit que usa el adaptador anterior, y la tarjeta del modelo lo dice explícitamente: el adaptador de chinoll usa claves q, k y v separadas, mientras que ai-toolkit las fusiona, por lo que hacer warm-start de uno a partir del otro requiere una fusión diagonal por bloques exacta de rango 192. El repositorio incluye el conversor y reporta 336 de 336 tensores coincidentes tras la conversión.
Dónde es más rápido y dónde no
Combinar el LoRA de edición con el LoRA de velocidad DMD de 8 pasos reduce el muestreo a 8 pasos y CFG 1 para ediciones aproximadamente seis veces más rápidas. El propio veredicto de la tarjeta es que la pasada de 50 pasos sigue ganando: a 8 pasos las adiciones de objetos se debilitan y la contención del color se degrada, así que la ruta rápida es para borradores.
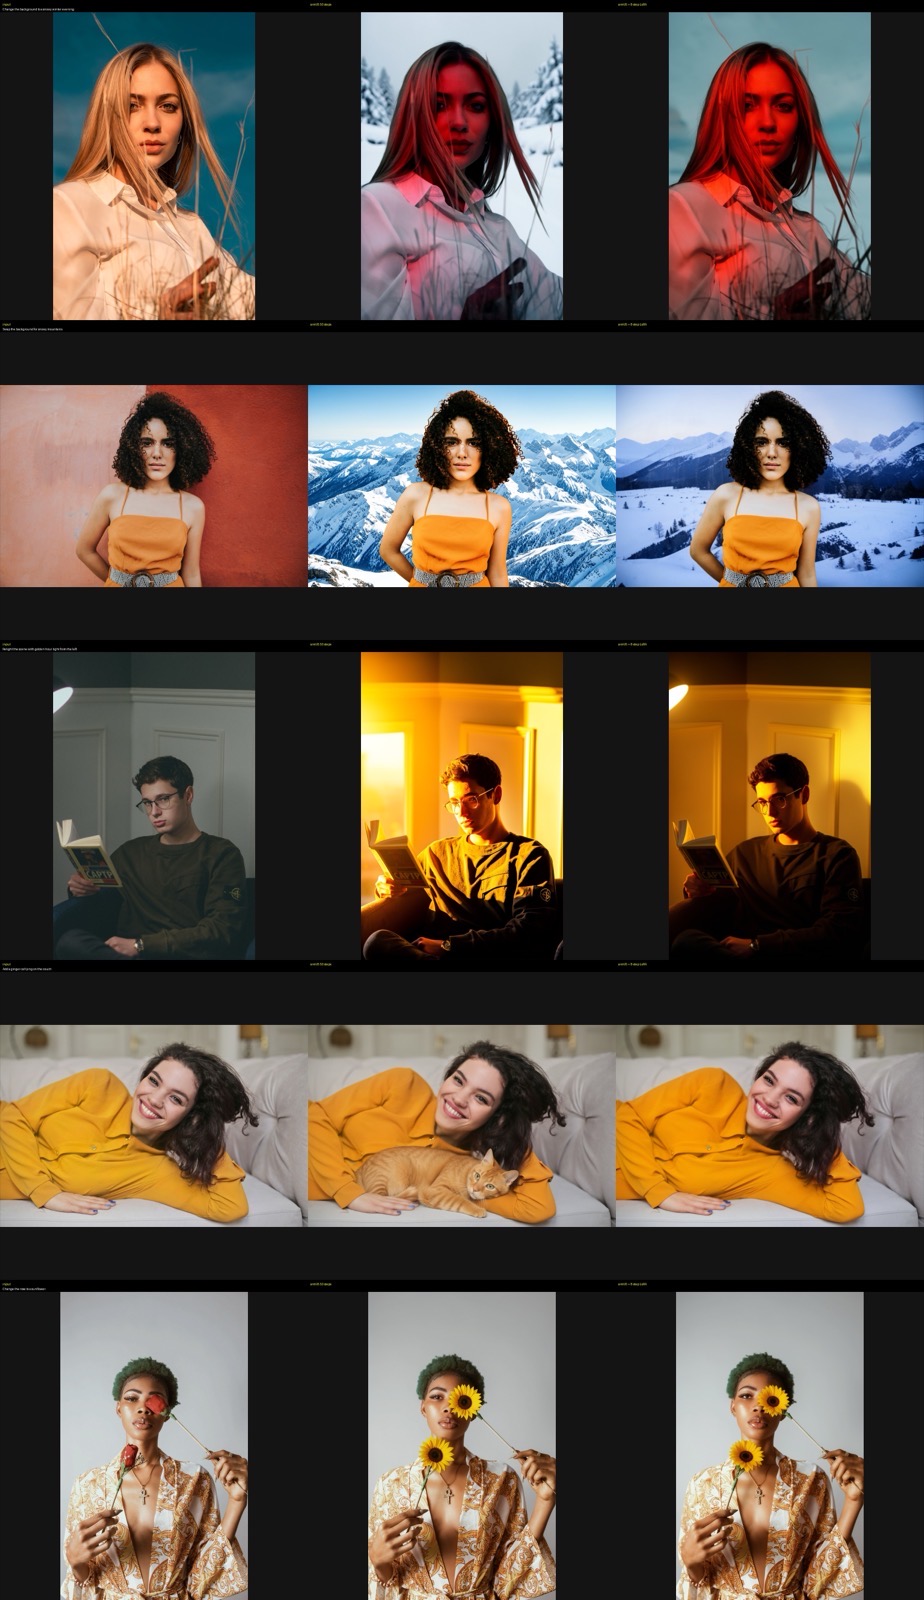
Entrada, luego 50 pasos, luego el stack DMD de 8 pasos. Fuente: akhaliq/MOSS-Image-Edit-HQ
La demostración de la v5, una instrucción por edición, renderizada con las configuraciones del demo de 50 pasos y CFG 3.
La misma honestidad se aplica a las comparaciones. El objetivo declarado del proyecto es superar a chinoll/Moss-Image-Edit en calidad, y el brazo v1 falló abiertamente esa puerta en la preservación de la identidad antes de que los brazos posteriores pasaran a masked loss. Las cuadrículas publicadas comparan la v5 tanto con el adaptador anterior como con Krea 2, pero son los propios conjuntos de evaluación del autor y un Space de demostración, no un benchmark de terceros.
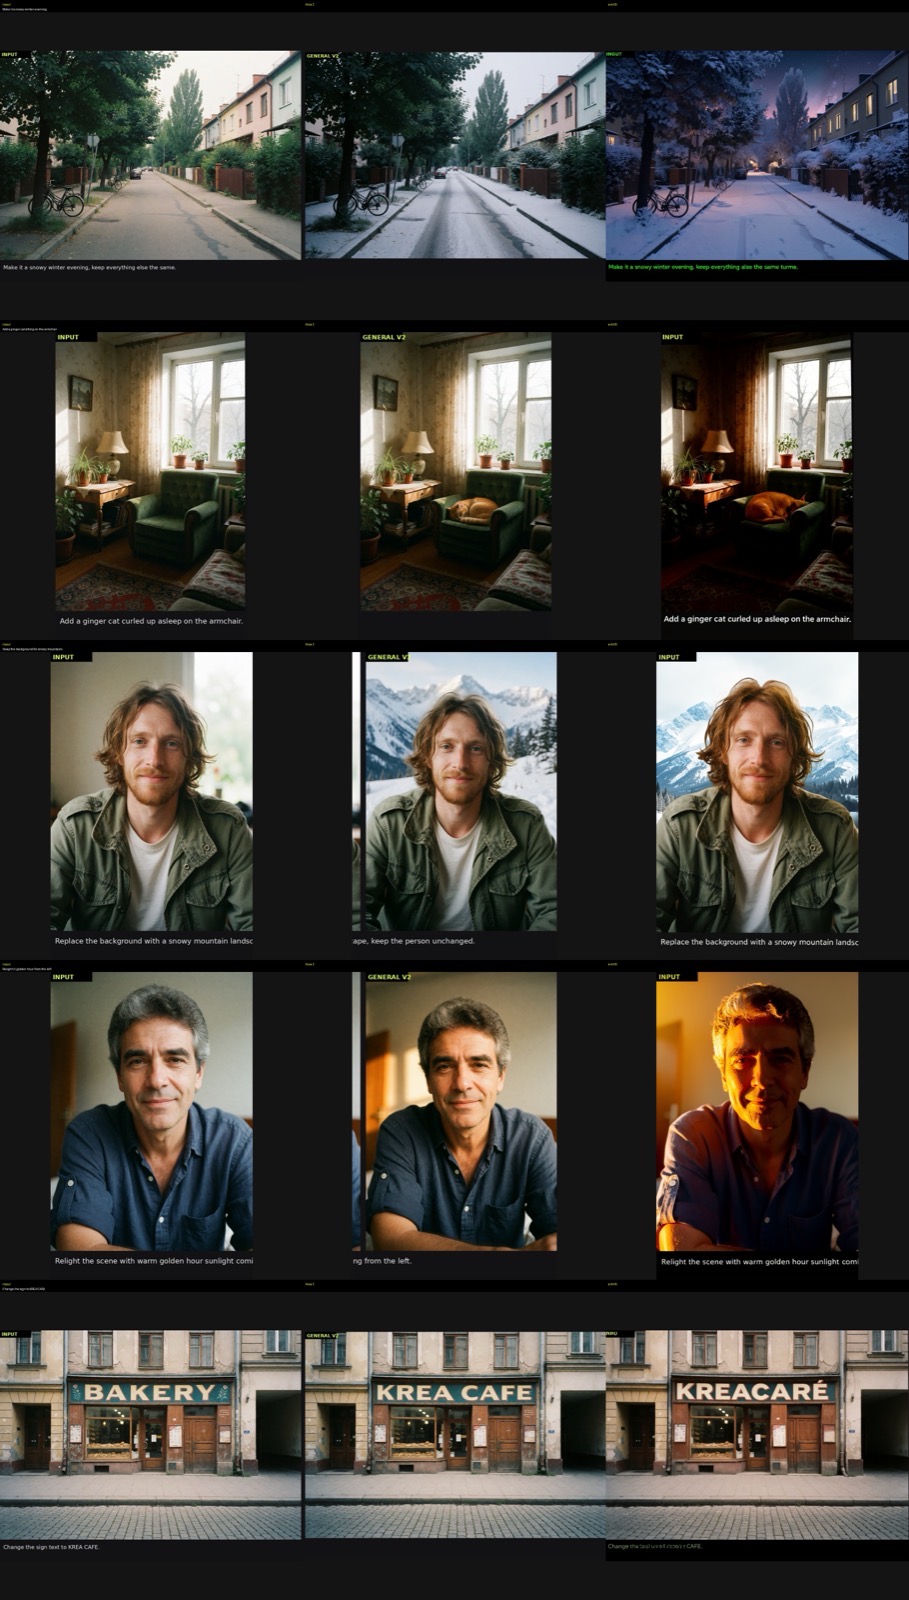
Ediciones de la v5 de prompts de demostración de Krea 2 junto a los renders de referencia de Krea 2. Fuente: akhaliq/MOSS-Image-Edit-HQ
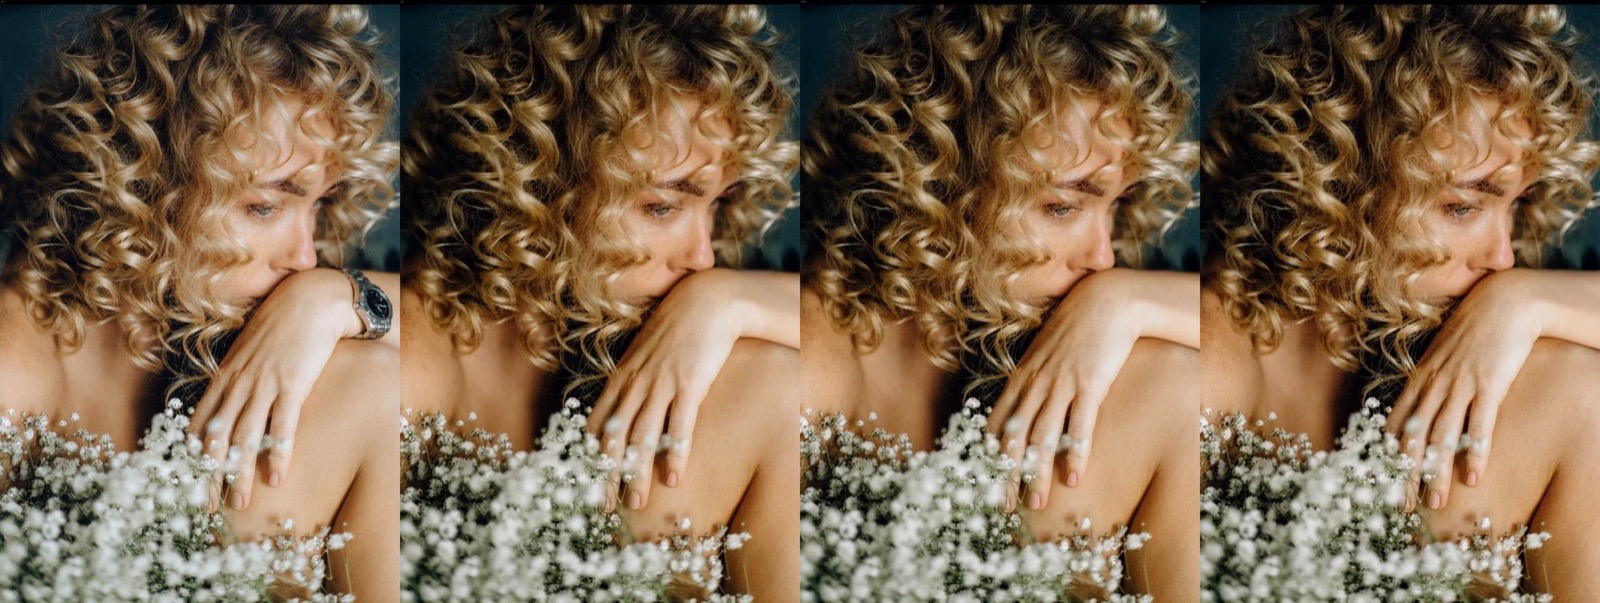
Casos de eliminación de objetos del repositorio. Fuente: akhaliq/MOSS-Image-Edit-HQ
Para facilitar su uso, la tarjeta también enlaza un Space de demostración Gradio que ejecuta tanto el modo de calidad como el de 8 pasos para que se pueda comprobar el compromiso antes de descargar 495 MB.
Límites que conviene conocer
- VRAM: la pipeline necesita unos 20 GB en bf16. La tarjeta responde directamente a la pregunta obvia: no, no funciona con 6 GB, ni siquiera con compilaciones de la comunidad en int8 del modelo base.
- Modelo base: está entrenado sobre MOSS-Image-SFT. La compatibilidad con Base y Kromoss figura como no verificada, y la ruta nativa se describe como la fiable.
- Entrenamiento con una sola referencia: la arquitectura acepta hasta cuatro referencias, pero el adaptador se entrenó con pares de edición de una sola referencia. La composición de una persona u objeto de una foto en otra no es explícitamente aquello para lo que se entrenó.
- Color: un usuario reportó en la tarjeta del modelo un rasgo conocido de la v3 de empujar la saturación más allá de la fuente, y la masked loss de la v4 lo abordó.
- Alcance: ediciones de atributos, eliminación, iluminación, faciales y de texto. El lanzamiento no dice nada sobre cambios de pose, que es lo que pedía el primer comentario del anuncio.
Nada de esto es un lanzamiento de OpenMOSS. Los pesos, los datos, las cuadrículas de evaluación y el demo provienen todos de un solo autor, y la tarjeta lo dice claramente.
Disponibilidad
- LoRA: akhaliq/MOSS-Image-Edit-HQ, v5 publicada el 25 de octubre de 2026.
- Flujos de trabajo:
armV5_workflow_single.jsonyarmV5_workflow_multi.json. - Demo: moss-image-edit-hq-demo en Hugging Face Spaces.
- Núcleo de ComfyUI: PR #17296, fusionado el 22 de octubre de 2026, solo master y nocturna.
- Paquete de nodos: Chenkin-x/ComfyUI-Moss-Image-Edit, con ComfyUI 0.42.3 o posterior.
- Datos de entrenamiento y código: moss-image-edit-conceptedit-packed más el directorio
training/del repositorio.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.