El LoRA MOSS-Image Edit añade edición por instrucciones a ComfyUI
Un LoRA de edición de rango 64 aporta a MOSS-Image edición por instrucciones con una a cuatro referencias, y ComfyUI integró el soporte nativo para LoRA de edición el mismo día.
MOSS-Image es el modelo de texto y maquetación de 5B de OpenMOSS que el sitio cubrió en su lanzamiento: texto legible, cajas de maquetación JSON y una implementación en el núcleo de ComfyUI que llegó la misma semana. Lo que no tenía era una forma de tomar una imagen existente y cambiarla. Editar significaba ediciones de maquetación o un adaptador de control, no "ponerle a esta persona otra chaqueta".
El nuevo adaptador cubre ese hueco. Es un lanzamiento de la comunidad, no de OpenMOSS, pero es la implementación sobre la que los mantenedores de ComfyUI construyeron el soporte del núcleo.
Qué cambia el LoRA
La model card describe el alcance con claridad: color, conjuntos de ropa, iluminación, estaciones y estilo visual, guiados por una instrucción de texto y hasta cuatro imágenes de referencia. La instrucción dice qué cambiar; las referencias aportan lo que debe permanecer.
Cuadrícula de casos publicada con el LoRA. Fuente: chinoll/Moss-Image-Edit
Con más de una referencia, cada imagen debe nombrarse en la instrucción, ya que el adaptador por sí mismo no asigna roles. El prompt de ejemplo del paquete de nodos es Dress the person in image 1 in the outfit from image 2.
Mecánicamente, el adaptador es pequeño y convencional. Inspeccionar la cabecera del safetensors revela 504 tensores en las 42 capas del DiT, seis proyecciones por capa (q, k, v, o, ffn_up_gate, ffn_down), con rango 64 y alpha 64. Su adapter_config.json declara un formato moss-edit-lora versión 1 y registra su contrato de entrenamiento como ref-prefix-only-t0__target-text-original-moss-v1, que es la disposición que ComfyUI implementa ahora con el nombre Moss-Image-Edit.
Los mismos pesos funcionan tanto con MOSS-Image-Base como con MOSS-Image-SFT; Base conserva más de la señal de entrenamiento, SFT es el punto de partida más ordenado. Los ejemplos de la model card se entrenaron y muestrearon con SFT.
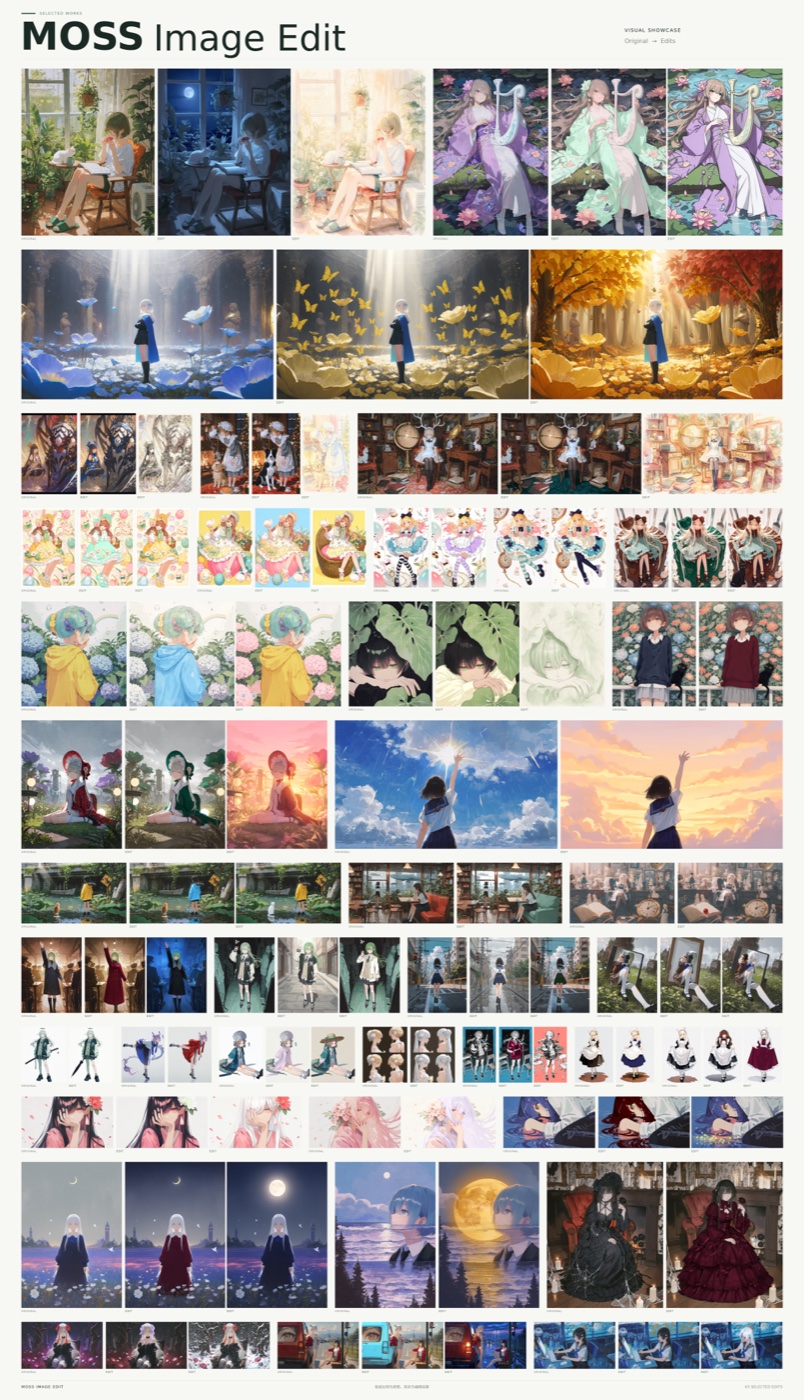
Muestra de edición del repositorio del proyecto: cada grupo empieza con la imagen de origen y continúa con sus ediciones.
Ruta en el núcleo de ComfyUI
El PR #17296 de Kijai añade un nodo Text Encode MOSS-Image Edit, todavía marcado como experimental, dentro de model/conditioning/moss_image. Recibe un clip, un prompt, un vae, una opción edit_format y un conjunto de imágenes que crece automáticamente. El selector edit_format es la parte interesante, porque codifica el hecho de que los LoRA de edición no son intercambiables:
| Opción | Disposición de referencias | El codificador de texto ve las referencias |
|---|---|---|
ai-toolkit | index_timestep_zero_isolated | Sí, con el prefijo Picture N: |
ai-toolkit (kv_cache off) | index_timestep_zero | Sí, y las referencias atienden a la imagen generada en cada paso |
Moss-Image-Edit | index_timestep_zero_text_start | No |
Con la disposición Moss-Image-Edit, la torre de visión nunca recibe las imágenes de referencia, así que la instrucción debe describir la edición por sí sola; la apariencia proviene enteramente de los latentes de referencia inyectados en el DiT. Para los adaptadores entrenados con ai-toolkit, las referencias se reducen a un máximo de 384×384 y se anteponen al prompt como tokens Picture N:.
El adaptador se carga mediante el cargador LoRA estándar, porque el PR añadió alias para el estilo de claves layers.N.proj.q que usan estos archivos. Eso significa que la ruta nativa es el grafo ordinario de MOSS-Image con los pesos de archivo único de Comfy-Org/MOSS-Image, más un cargador LoRA y el nuevo nodo de codificación de texto; las imágenes de referencia se conectan al nodo como imágenes, no como una entrada latente separada.
El PR también reporta una corrección de velocidad más que una función: para las disposiciones aisladas, los K/V por bloque de las referencias se calculan una vez en extra_conds en lugar de en cada paso, lo que lleva 1024² con una referencia de 1 MP de 826 ms a 457 ms por paso. El soporte se fusionó después de la etiqueta v0.42.1, así que una instalación publicada necesita actualizarse más allá de esa etiqueta para usarlo.
Ruta del paquete de nodos
El mismo autor publica un paquete de nodos autocontenido, Chenkin-x/ComfyUI-Moss-Image-Edit, que apareció el 22 de octubre y añade tanto un cargador como un nodo de edición bajo la categoría MOSS Image Edit. Ejecuta su propia copia del entorno de ejecución de MOSS en lugar de los nodos del núcleo, y espera una instantánea completa de Diffusers en lugar del repack de archivo único:
ComfyUI/models/moss_image/
├── MOSS-Image-SFT/          # pipeline_moss_image.py, transformer/, text_encoder/, tokenizer/, vae/, scheduler/
└── Moss-Image-Edit/         # adapter_config.json, adapter_model.safetensors
El snapshot_dir del cargador apunta al modelo base y adapter_dir al adaptador. Incluye dos flujos de trabajo, uno para una referencia y otro para dos, y para llegar a tres o cuatro hay que añadir nodos Load Image a las entradas libres reference_3 y reference_4. Los valores predeterminados documentados son salida de 512×512, 30 pasos, CFG 4.0, inference_shift 5.0 y un borde largo de referencia de 512 sin recorte.
| Ajuste | Predeterminado | Nota |
|---|---|---|
width / height | 512 / 512 | múltiplos de 16 |
reference_max_edge | 512 | alineado a 16, nunca recortado |
steps | 30 | |
cfg | 4.0 | |
inference_shift | 5.0 | distribución temporal de muestreo |
seed | 42 | fijado por defecto |
Cómo llegan las referencias al DiT
Ambas rutas se apoyan en el mismo truco. Las imágenes de referencia se codifican con el VAE en tokens latentes y se añaden a la secuencia de imagen en su propio índice RoPE, en el paso de tiempo cero, atendiendo únicamente entre sí. Como esos tokens nunca cambian a lo largo del bucle de muestreo, sus K/V por bloque pueden cachearse una vez y reutilizarse, que es lo que hace que un adaptador de rango 64 sin entrenamiento del codificador de texto baste para mantener una identidad mientras la instrucción reescribe el resto.
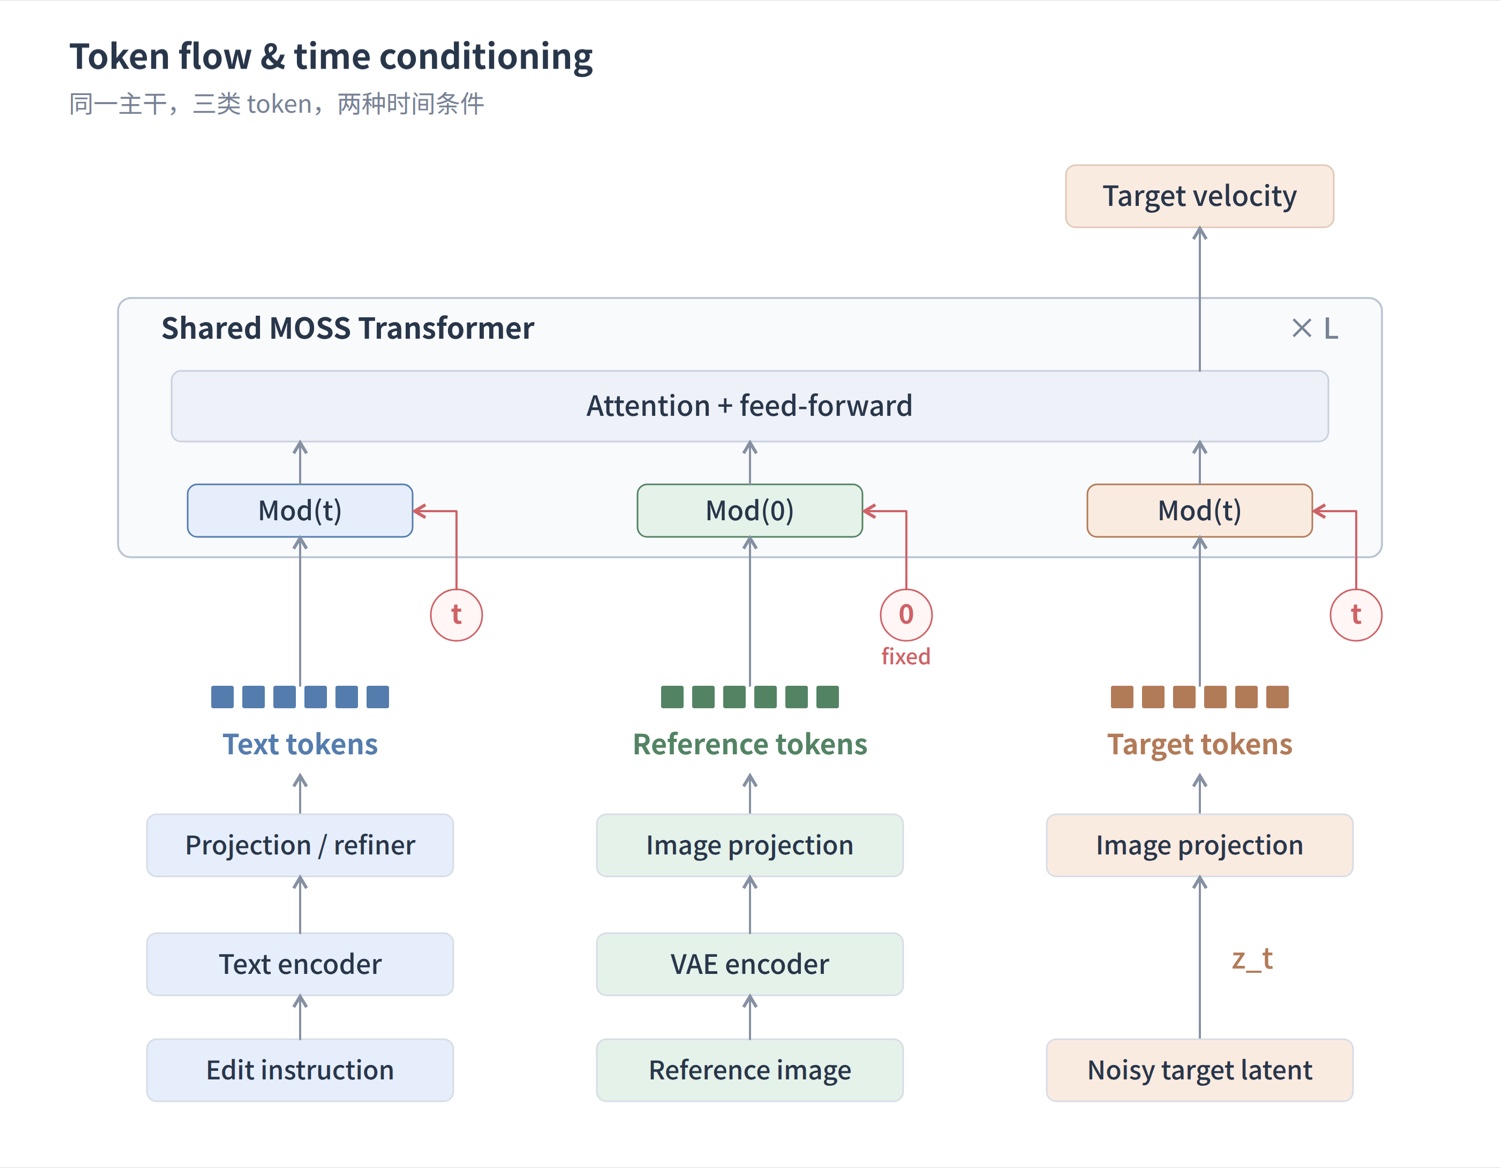
Diagrama de la caché KV de referencias del repositorio de entrenamiento, que muestra los bloques de referencia cacheados junto a los tokens generados.
El repositorio de entrenamiento publica toda la receta en lugar de solo los pesos: preparación de datos, configuraciones y un script de inferencia. Los datos de entrenamiento son pares NOOB2 más el conjunto ConceptEdit-12M, con instrucciones tomadas de instruction.detailed_en, imágenes de origen y editadas codificadas juntas por el VAE, y ambas imágenes escaladas de modo que el borde largo se mantenga por debajo de max_edge sin recorte ni relleno. La guía se lanza con un torchrun de cuatro procesos, DeepSpeed Muon sobre ZeRO-2 mediante un adjust_lr_fn parcheado, Flash Attention 4 con empaquetado varlen y el codificador de texto cuantizado a int8 durante el entrenamiento. Las muestras de validación se escriben en cada paso junto a tripletas generada/fuente/objetivo, de modo que los checkpoints del repositorio pueden reproducirse o ampliarse.
Límites que conviene conocer
El LoRA es un adaptador bf16 de 297 MB, pequeño frente al modelo base, pero no es un editor de propósito general. El alcance publicado son ediciones de atributos y escena: color, ropa, iluminación, estación y estilo, además de expresiones. La model card no documenta inserción de objetos, no publica ningún benchmark y no afirma nada sobre componer dos sujetos en una sola escena. Las ediciones con múltiples referencias dependen de que el prompt asigne roles, como se indicó antes. Tampoco es un lanzamiento oficial de OpenMOSS: los pesos, el paquete de nodos y el código de entrenamiento provienen de un único autor, y el PR del núcleo es la única parte revisada por los mantenedores de ComfyUI.
Disponibilidad
- LoRA: chinoll/Moss-Image-Edit, alrededor de 21 likes en el momento de escribir esto, un día después de la subida.
- Núcleo de ComfyUI: PR #17296, fusionado el 22 de octubre de 2026, después del lanzamiento de la v0.42.1.
- Paquete de nodos: Chenkin-x/ComfyUI-Moss-Image-Edit con flujos de trabajo de una y varias referencias.
- Código de entrenamiento e inferencia: Chenkin-x/Moss-Image-Edit, incluidos
prepare_data.py,configs/train.jsoneinfer.py. - Modelos base: MOSS-Image-Base y MOSS-Image-SFT, con pesos de archivo único para ComfyUI en Comfy-Org/MOSS-Image.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.