KohakuMoss: LoRA para MOSS-Image con exportación a ComfyUI
KohakuMoss 0.1.0 entrena LoRA, LyCORIS o finetunes completos sobre MOSS-Image-Base y SFT, funciona desde tarjetas de 6 GB y exporta adaptadores con el formato de claves de ComfyUI.
KohakuMoss es un framework de finetuning para MOSS-Image-Base y MOSS-Image-SFT, publicado como versión 0.1.0 en PyPI el 18 de octubre de 2026. Está creado por KohakuBlueleaf, el autor de LyCORIS, y cubre la parte de la cadena de herramientas de MOSS-Image que ni el lanzamiento del modelo ni los adaptadores de pocos pasos de la comunidad abordaban: entrenar con tus propias imágenes a resolución nativa y luego exportar algo que ComfyUI pueda cargar sin un paso de conversión.
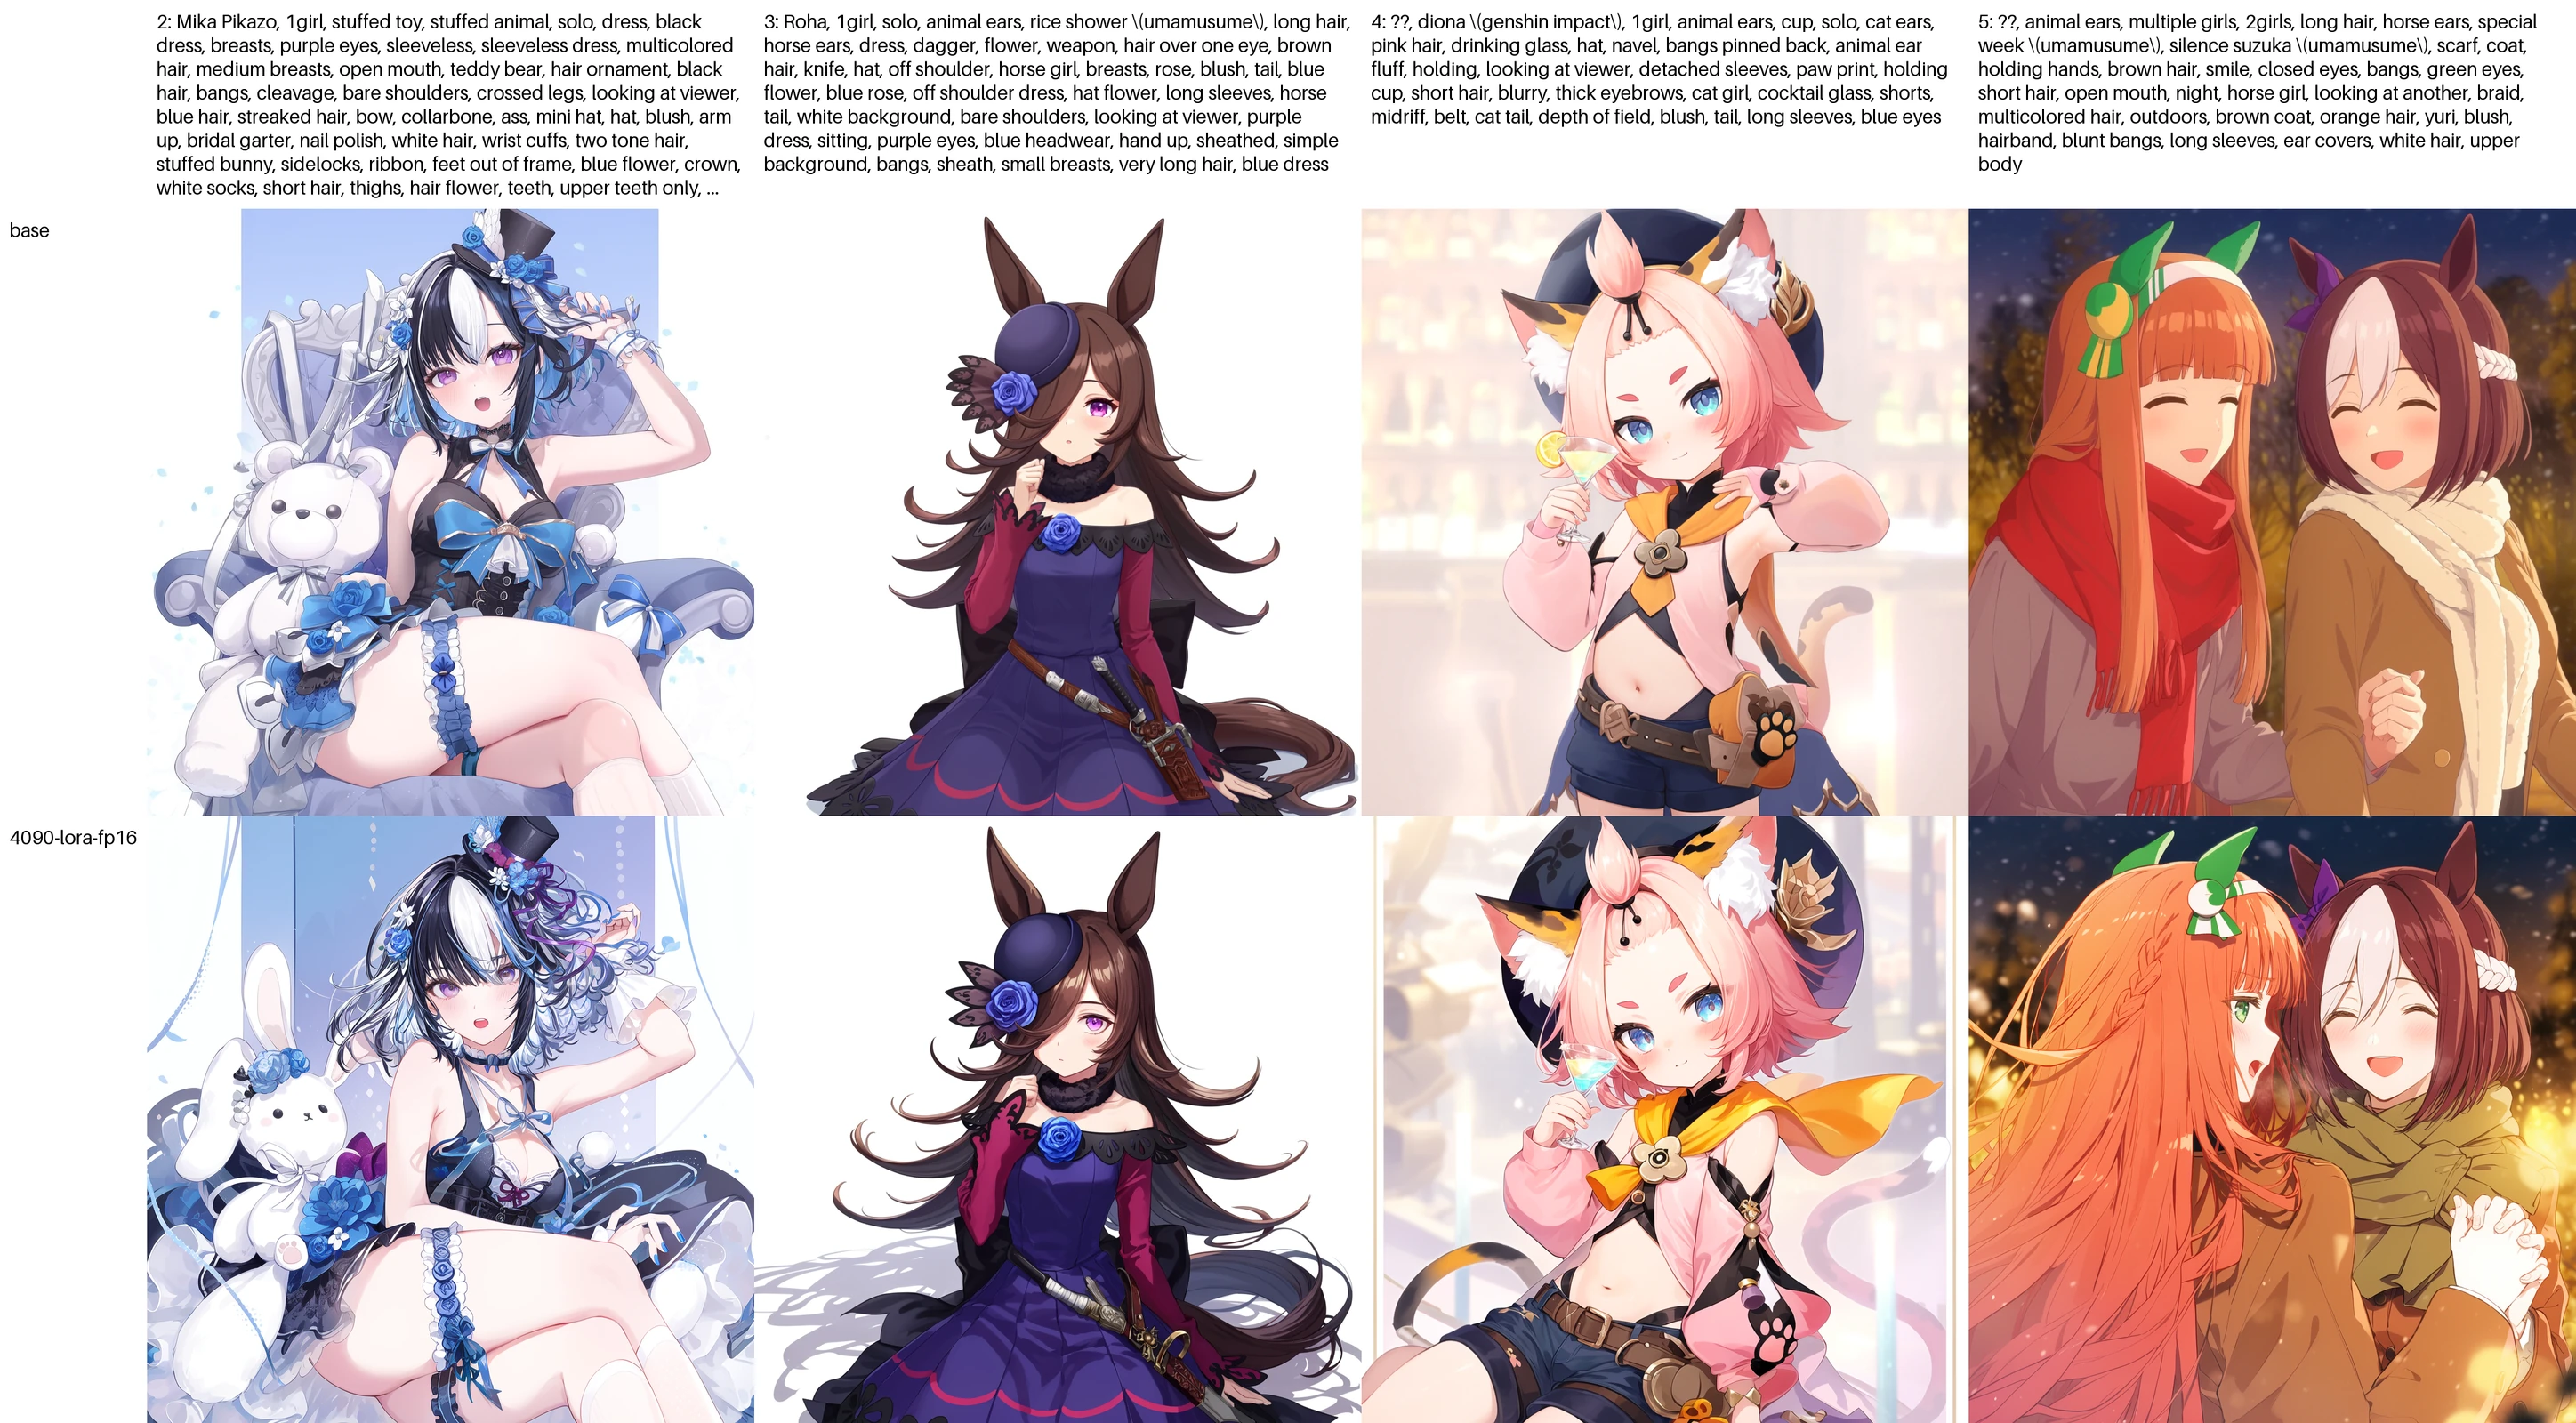
El hueco que llena
MOSS-Image llegó el 16 de octubre con dos checkpoints, control de layout y soporte de ComfyUI el mismo día, y los LoRA comunitarios de 4 y 8 pasos llegaron en un día. Lo que ninguno incluía era un entrenador pensado para este diffusion transformer concreto de 5B y su text encoder Qwen3.5-9B. Los entrenadores de diffusion genéricos asumen un UNet o una pila con forma de Flux; MOSS-Image necesita su propia atención empaquetada y sus propios nombres de claves. KohakuMoss proporciona ambas cosas: una implementación independiente de MOSS-Image, el conjunto de adaptadores de LyCORIS, un pipeline de datos y los planes de memoria necesarios para ejecutarlos en una sola tarjeta.
Adaptadores y finetune completo
El entrenamiento de adaptadores cubre LoRA y LoCon, LoHa, LoKr, DoRA, OFT, BOFT, GLoRA, IA3, DyLoRA y T-LoRA, todo mediante LyCORIS, por lo que sus algoritmos, formato de guardado y kernels fusionados se mantienen sin cambios. Dropout, LoRA+, forwards omitidos o fusionados y los presets de targeting son configuraciones en lugar de scripts separados.
El finetune completo también es compatible, usando Muon con AdamW y EMA siguiendo el informe técnico de MOSS. Cabe en una sola tarjeta de 24 GB con los pesos maestros en memoria del host, así que el intercambio es RAM del sistema en lugar de otra GPU.
Ejecución en 6 GB
La memoria se gestiona como un conjunto de capas en lugar de un único interruptor: checkpointing por bloques, streaming de pesos, offload de activaciones, offload de gradientes y estados del optimizador en el host. Cuatro perfiles con nombre abarcan de speed a minimal, kohakumoss-config elige uno según la tarjeta que detecta, y debajo hay un catálogo de 240 entradas para ajuste manual. El entrenamiento de adaptadores llega a tarjetas de 8 GB, y la capa de 6 GB cabe cuando tanto la caché de latentes como la de texto se construyen offline. Una tarjeta de 24 GB sigue cubriendo el caso de finetune completo.
La precisión sigue al hardware: bf16 donde existe, fp16 en tarjetas más antiguas con una corrección de residuales, cómputo fp8 y MXFP8 en sm89 y posteriores tanto para el DiT como para el text encoder en entrenamiento e inferencia, y cuantización solo de pesos int8 o fp8 para una base congelada.
Kernels por arquitectura
El proyecto incluye sus propios kernels en lugar de depender de una sola pila: TileLang para sm70 y sm75, Triton para sm80 y posteriores, así como Intel Arc, con torch.compile y eager por detrás de ambos. La atención varlen, las operaciones por bloques y las lineales fusionadas eligen backend según arquitectura, dtype y forma, medido una vez en la tarjeta y almacenado en una tabla de tuning, de modo que la misma instalación se ajusta de forma distinta en una V100 y una RTX 5090.
La implementación del modelo ejecuta lotes empaquetados de longitud variable: un eje de tokens plano, con la atención contenida dentro de cada muestra. Frente al código oficial, el proyecto reporta un error relativo de 4.7e-6 en el forward fp32 y un LPIPS de muestreo a 50 pasos de 2.3e-6.
Datos y reanudación
Los formatos de entrada incluyen carpetas estilo kohya, jsonl, parquet, webdataset y shards nativos, con un catálogo incremental que se almacena en caché tras el primer escaneo. Los planificadores de redimensionado, bucketing y recorte gestionan imágenes a resolución nativa, el batching por tokens mantiene los pasos uniformes, y las cachés de latentes y de texto pueden construirse offline o llenarse durante el entrenamiento. El plan de muestreo es una función pura de los datos, la semilla y las configuraciones, de modo que una ejecución reanudada reproduce el mismo orden en lugar de aproximarlo.
Multi-GPU solo en Linux: DDP bajo todos los perfiles de memoria, incluido el streaming de pesos, FSDP2, pipeline y un pipeline con hilos.
Exportar a ComfyUI
El paso de exportación es lo que hace que esto sea más que otro entrenador. Una ejecución puede producir un archivo LyCORIS, un modelo fusionado, un transformer diffusers o un adaptador en formato ComfyUI escrito contra el layout de claves de MOSS-Image propio de ComfyUI, incluido el repack para su proyección q/k/v fusionada. Ese archivo va a models/loras y se carga en un flujo de trabajo normal de ComfyUI, así que un LoRA entrenado aquí no necesita un nodo de terceros ni un notebook de conversión. La exportación también funciona con cualquier checkpoint guardado, no solo con el paso final.
Velocidad medida
Las tablas de la versión reportan entrenamiento a 1 MP en MOSS-Image-Base con un LoRA de rango 32 en el perfil balanced. En una RTX 5090 la ejecución alcanza 1.01 muestras por segundo sin caché y 1.14 con las cachés de latentes y de texto; una RTX 4090 pasa de 0.49 a 0.73 y una RTX 3090 de 0.31 a 0.39. Los picos por paso se sitúan cerca de 6.6 GiB de memoria asignada por torch en la mayoría de esas filas, y las cifras de la 5090 incluyen un text encoder residente de 15.6 GiB, que es la razón por la que su valor sin caché es el más rápido.
El ejemplo del README se acerca más a un primer proyecto real: un LoRA de estilo fp16 de rango 8 sobre una base fp8, 100 pasos a aproximadamente 20k tokens por paso, con el perfil agresivo ckpt-ring4-actoff y la codificación del text encoder y del VAE en línea en cada paso. En una RTX 4090 mantiene 12 a 13 GB y produce alrededor de 0.85 imágenes por segundo.
Configuración
Cada script es un script de KohakuEngine, así que las configuraciones son ajustes a nivel de módulo y una config puede apilar presets unos sobre otros. kohakumoss-config escribe una config verificada para la GPU y el dataset detectados, kohakumoss-config wizard pregunta por la GPU, el algoritmo, los datos y los pesos en lugar de aceptar flags, y las recetas fijas como lora_24g_bf16 pueden extenderse con todos los ajustes listados.
Disponibilidad y licencia
KohakuMoss está en github.com/KohakuBlueleaf/KohakuMossTrainer y se instala desde PyPI como kohakumoss. Los asistentes de instalación detectan el driver, eligen el índice de torch correspondiente y luego ejecutan kohakumoss-doctor, que reporta todo lo faltante junto con el comando que lo soluciona. Se requiere Python 3.10 o superior, con CUDA 12.6 o superior o un driver de Intel Arc; Windows necesita las Visual Studio Build Tools, y las tarjetas sm70 y sm75 necesitan el CUDA toolkit para nvcc.
La licencia es la KohakuMoss License 1.0: Apache 2.0 más un término, que una obra derivada, paquete, producto o servicio construido sobre KohakuMoss debe incluir "Kohaku" en su nombre. Los modelos, adaptadores e imágenes entrenados o generados con el framework quedan explícitamente fuera de ese término, así que un LoRA o checkpoint producido con él puede nombrarse y licenciarse como su autor desee.
Para los checkpoints en sí, consulta la cobertura del lanzamiento de MOSS-Image y los adaptadores de 4 y 8 pasos que hicieron práctico el muestreo rápido.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.