LoRA SFT Destripe de MOSS-Image quita franjas verticales en ComfyUI
Un LoRA de 1.9 MB elimina las tenues franjas verticales de color que MOSS-Image SFT dibuja en cielos y fondos lisos, y se carga con el cargador LoRA estándar de ComfyUI.
MOSS-Image SFT dibuja un patrón regular de tenues franjas verticales de color sobre las áreas Suaves: cielos, niebla, paredes lisas, fondos de estudio. El 18 de octubre, nynxz publicó un LoRA de 1.9 MB, SFT Destripe, que las Elimina y deja casi todo lo demás del modelo SFT intacto. Es un parche de pesos, no un reentrenamiento: sin Nodos Personalizados, sin nuevos checkpoints, un único LoraLoaderModelOnly después del modelo que el sitio cubrió en su lanzamiento.
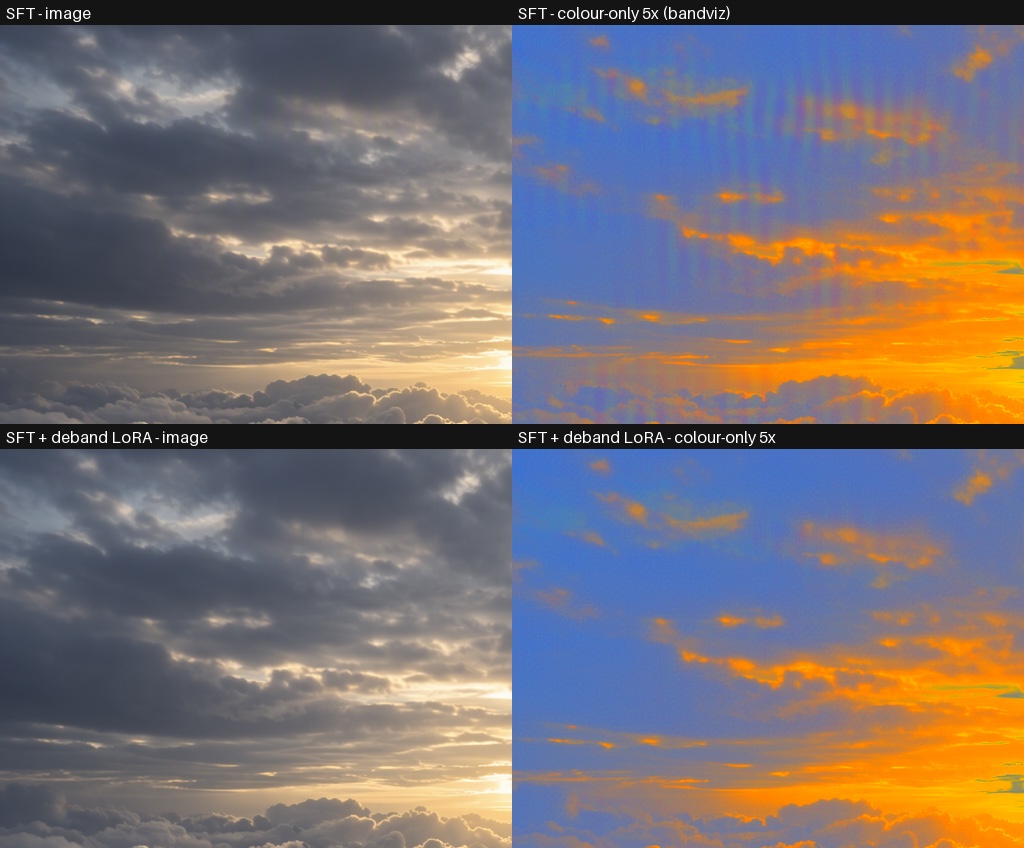
Arriba: Salida de SFT, sin tratar y con el brillo Eliminado y el color amplificado 5x. Abajo: el mismo prompt y semilla con el LoRA Destripe a intensidad 1.5. Las franjas son un cambio de color, no de brillo, y por eso sobreviven a la Imagen sin tratar. Fuente: nynxz/MOSS-Image
Qué son las franjas
El artefacto es fácil de pasar por alto a simple vista e imposible de no ver una vez que se amplifica el color. Sigue un período fijo: unos 16 px con 768 px de ancho y 21,3 px con 1024 px de ancho, lo que da 48 ciclos a lo ancho de la Imagen en ambos casos. Como el período escala con el ancho, no parece ruido de sensor ni una costura de mosaico. Se comporta como un patrón que el modelo aprendió a dibujar.
Los usuarios lo reportaron en el Repositorio de SFT a los pocos días del lanzamiento: el primer hilo de reportes se abrió el 16 de octubre con renders de ejemplo, y las conjeturas iban desde un VAE incorrecto hasta un artefacto del profesor destilado. Ninguna se confirmó. El hilo sigue abierto y OpenMOSS no ha publicado ninguna explicación.
Cómo un LoRA de 1.9 MB las elimina
El LoRA se extrae de la Diferencia entre Base y SFT en lugar de entrenarse. En resumen:
- Para cada una de las 252 Capas Lineales de SFT, se toma el delta de pesos respecto a Base y se descompone en direcciones de rango 1 con una SVD. Cada dirección es una regla de «patrón de Entrada a patrón de Salida» que añadió el ajuste fino.
- Se puntúa cada dirección según cuánto alimenta la franja. La franja se mide como la energía del patrón de columnas de 48 ciclos en la propia predicción del modelo, en los pasos de muestreo tempranos donde se forma (la cabecera del archivo registra los pasos 4 a 13 de una ejecución de 25 pasos, ER-SDE, CFG 2.5, 768 px, dos semillas). Una pasada hacia atrás da, para cada dirección, la rapidez con que crece esa energía de franja cuando se añade la dirección.
- Se Restan las 64 direcciones con mayor puntuación. Quedan en 25 matrices en las Capas 24 a 41, once de ellas la
ffn_up_gatedel MLP, y el resto enffn_down, q, k, v y o. Los rangos van de 1 a 7, y por eso el archivo pesa 1.9 MB: 945.152 números almacenados. El análisis de pesos de MATLOWAI lo sitúa en torno al 0,09 por ciento de la energía del cambio total de SFT respecto a Base.
La puntuación de direcciones es lo que hace que el archivo sea pequeño sin volverlo contundente. Dos correcciones Anteriores revierten Capas enteras a Base y lo pagan con deriva; esta solo Elimina las direcciones dentro de esas Capas que portan la franja. Como comprobación causal, aplicar las mismas direcciones con el signo opuesto hace que las franjas sean unas 22 veces más fuertes.
Cómo usarlo en ComfyUI
Coloca moss_sft_destripe_top64_bf16.safetensors en ComfyUI/models/loras/, carga MOSS-Image SFT (moss_image_sft_bf16 o moss_image_sft_int8_convrot de Comfy-Org/MOSS-Image), añade LoraLoaderModelOnly y ajusta la intensidad según el ancho:
- 1.0 a 768 px
- 1.5 a 1024 px
A 1024 px, la intensidad 1.0 limpia la franja en 6 de 12 Imágenes de prueba y deja un rastro tenue en el resto. Con 1.5 baja a 1 de 12, y 2.0 no mejora a 1.5 y además se aleja más de SFT. El LoRA se construye a partir de los propios cambios de SFT, así que no aporta nada útil sobre Base. Las claves usan el prefijo diffusion_model. y el cargador estándar las mapea directamente.
Un aviso sobre el cargador viene del mismo Repositorio: si usas Load LoRA (Bypass), los adaptadores q/k/v se descartan en los checkpoints fusionados de Comfy-Org, y este LoRA toca q, k y v en algunas Capas. El parchado normal funciona bien en los archivos fusionados.
Qué muestran los números del Autor
La prueba a ciegas usa cuatro prompts con grandes áreas Suaves (dunas de arena, una pared lisa, agua abierta, un retrato sobre un fondo desenfocado) con tres semillas cada uno, ninguna de ellas usada para construir la corrección. La puntuación es la métrica bandviz de MATLOWAI, donde más bajo significa menos banding y alrededor de 16 o menos se lee como limpio.
| Modelo | bandviz, 768 px | La franja sigue siendo el pico principal | SSIM respecto a SFT |
|---|---|---|---|
| SFT | 9.8 | 9 de 12 | 1.000 |
| SFT + Destripe @ 1.0 | 4.2 | 1 de 12 | 0.995 |
| Base, como Referencia | 4.2 | 5 de 12 | 0.876 |
A 1024 px, el SFT sin tratar puntúa 24.0 con la franja como pico principal en 11 de 12 Imágenes; el LoRA a 1.5 puntúa 5.9 con 1 de 12, frente a 4.0 de Base. La Imagen sigue siendo más de un 99 por ciento similar a lo que produjo SFT.
El color plano es donde el artefacto se ve más fácil y cuesta más Eliminar, ya que un área sólida no le da a la franja dónde esconderse:
 |  |
|---|---|
| Fondo beige sólido, SFT sin tratar | Mismo prompt y semilla, LoRA a 1.5 |
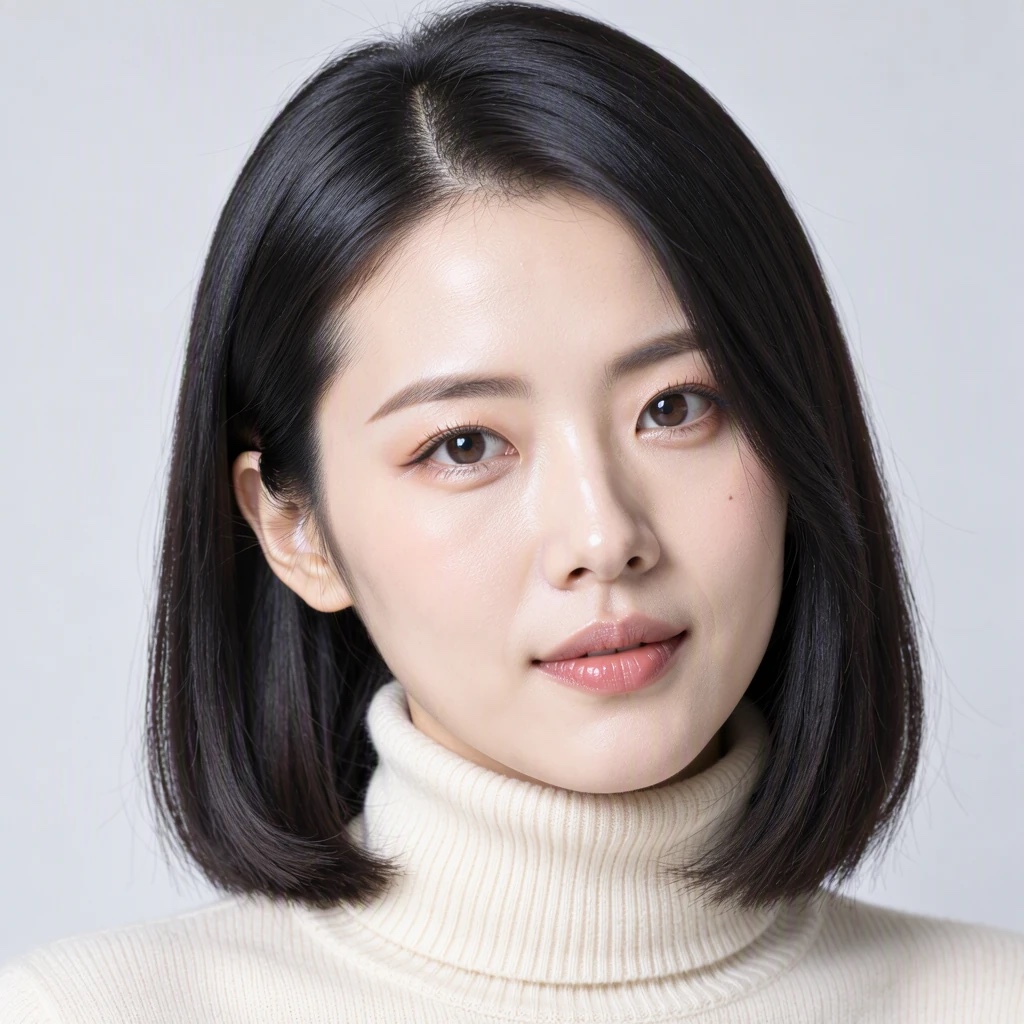
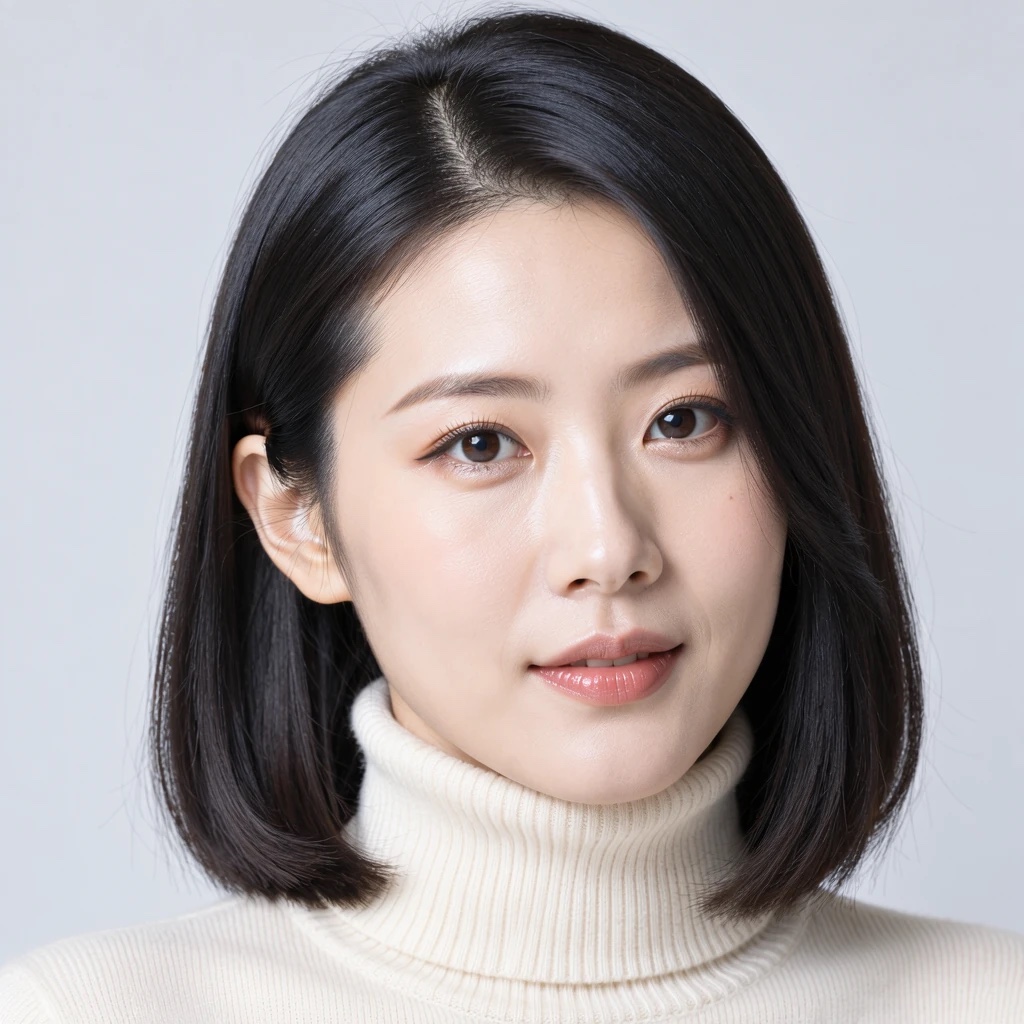
Los rostros son el otro extremo del compromiso, la parte de una Imagen que una corrección contundente tiende a Suavizar:
 |  |
|---|---|
| Retrato, SFT sin tratar | Mismo prompt y semilla, LoRA a 1.5 |
Renders de terceros del benchmark de MATLOWAI, que mide la identidad con ArcFace: 0.94 con las Configuraciones predefinidas Estándar y 0.96 con las Configuraciones de muestreador propias del LoRA. Fuente: MOSS-Image-SFT-DeBand
Verificación de terceros
La evidencia externa más sólida viene de MATLOWAI, que ya había publicado una investigación sobre las mismas franjas y un conjunto de correcciones de reversión de Capas ANTES de que este LoRA existiera. Ese benchmark ahora incluye el LoRA Destripe cara a cara con las alternativas, y lo reporta como el extremo suave del rango:
| Corrección | Sólidos, dB de mediana | Peor caso | Similitud facial |
|---|---|---|---|
| Destripe @ 1.0 | −3.2 | −1.9 | 0.94 |
| Destripe @ 1.5 | −3.9 | −1.8 | 0.94 |
| Destripe @ 1.5, con sus propias Configuraciones de muestreador | −4.6 | −3.0 | 0.96 |
| Modelo base, como Referencia | −16.6 | −10.4 | 0.45 |
El mismo texto expone el compromiso con claridad: el LoRA solo limpia en parte las áreas de color plano, alrededor de −4 dB, así que las franjas se atenúan pero aún pueden verse en una vista con el color amplificado, donde las correcciones de reversión de Capas llegan más lejos a costa de mover toda la Imagen. Su README ahora remite a este LoRA a quien quiere el cambio más pequeño posible, y a la corrección más agresiva a quien necesita los fondos planos más limpios.
Límites
- Las mediciones cubren 768 y 1024 px con ER-SDE, 25 pasos y CFG 2.5. Otros muestreadores, recuentos de pasos y Resoluciones no se han probado, y el banding varía mucho de una semilla a otra.
- La corrección es parcial por diseño: 64 direcciones, puntuadas con una estimación de primer orden a una sola Resolución. Las Imágenes más anchas (1536 px y más) dibujan una franja distinta, más ondulada, contra la que este LoRA no se puntuó.
- No hay ninguna declaración oficial de OpenMOSS. El texto del Autor en el Repositorio de SFT, publicado el 19 de octubre, pregunta si el pipeline de datos de SFT usó escalado de Posición, bucketing o Imágenes redimensionadas, y ofrece las puntuaciones por dirección; no tiene respuesta hasta la fecha.
También en el Repositorio
El mismo repo incluye versiones con q/k/v separados de ambos checkpoints de MOSS-Image, con las q, k y v de cada capa de Atención almacenadas como tensores separados en lugar de un único qkv fusionado. Los pesos son los mismos números con otro diseño, 463 tensores en vez de 379. Existen para el trabajo con adaptadores: entrenadores como AI Toolkit escriben Capas q, k y v separadas, y en archivos fusionados esos adaptadores hay que mapearlos a porciones. Se cargan con Load Diffusion Model en lugar de los archivos de Comfy-Org.
Disponibilidad
Ambos artefactos están en Hugging Face. El codificador de texto y el VAE no cambian y vienen de Comfy-Org/MOSS-Image. El análisis de banding y la métrica bandviz sobre la que se construye la puntuación son de MATLOWAI, en MOSS-Image-SFT-DeBand, junto a una comparación interactiva de cada corrección con los mismos prompts y semillas.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.