Qwen-Image-2.1 Next-Scene LoRA: storyboards encadenados en ComfyUI
El LoRA Next-Scene de akhaliq enseña a Qwen-Image 2.1 a generar el siguiente plano dirigido desde un solo fotograma y a encadenar storyboards con un nodo LoRA de ComfyUI.
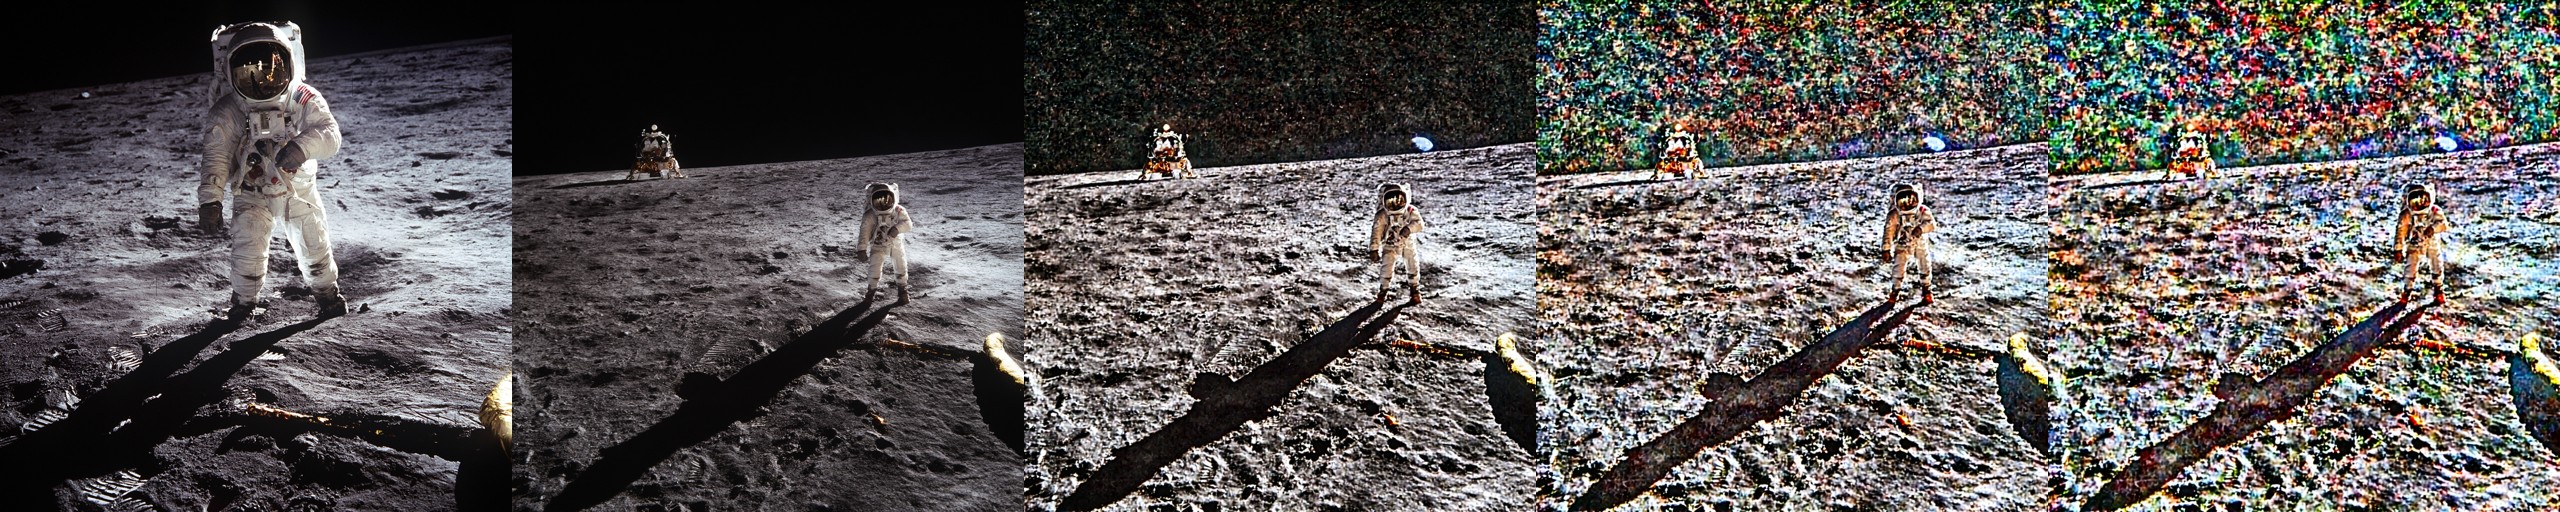
Cuatro planos dirigidos a partir de una sola fotografía. Cada fotograma es la salida anterior reinyectada con una nueva instrucción, con el checkpoint recomendado step-2,500 y fuerza 0.7.
Qué aporta a Qwen-Image 2.1
El formato next-scene proviene de lovis93/next-scene-qwen-image-lora-2509, que ha superado las 313.000 descargas en el modelo de edición Qwen-Image 2509. Este es el port a la base actual: reentrenado de forma nativa sobre Qwen-Image 2.1, donde la capacidad todavía no existe. Se combina con el LoRA Multiple-Angles anteriores de akhaliq, que controla dónde está la cámara, mientras que Next-Scene controla hacia dónde va la historia a continuación.
Los prompts empiezan por Next Scene: y encabezan con la dirección de cámara, por ejemplo "Next Scene: The camera pulls back to a sweeping aerial view, revealing the fleet behind the cliffs":
Next Scene: The camera tracks forward and tilts down as rain begins to streak the lens.
Next Scene: Cut to a low-angle shot; sunlight breaks through the clouds behind her.
Next Scene: The camera pans right, revealing the fleet massing behind the ridge.
Encadenado, con una receta medida
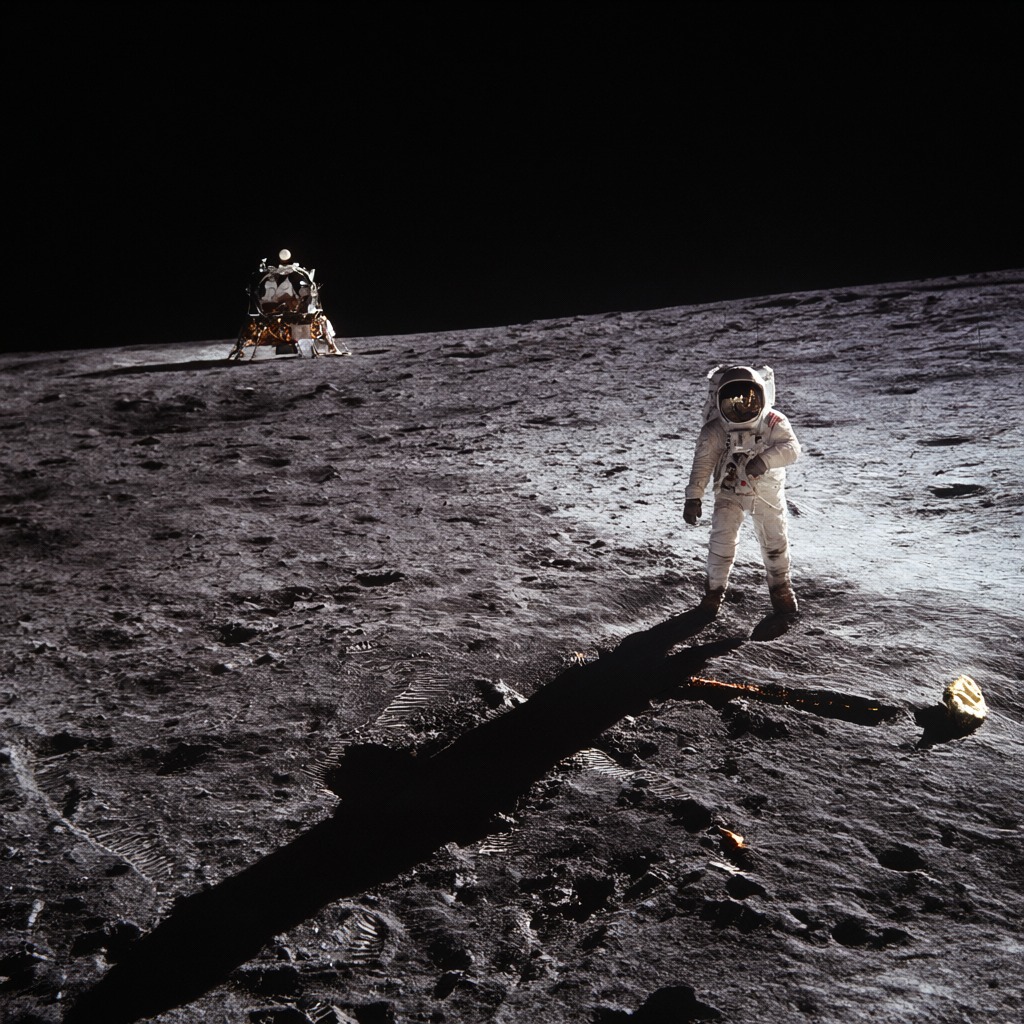
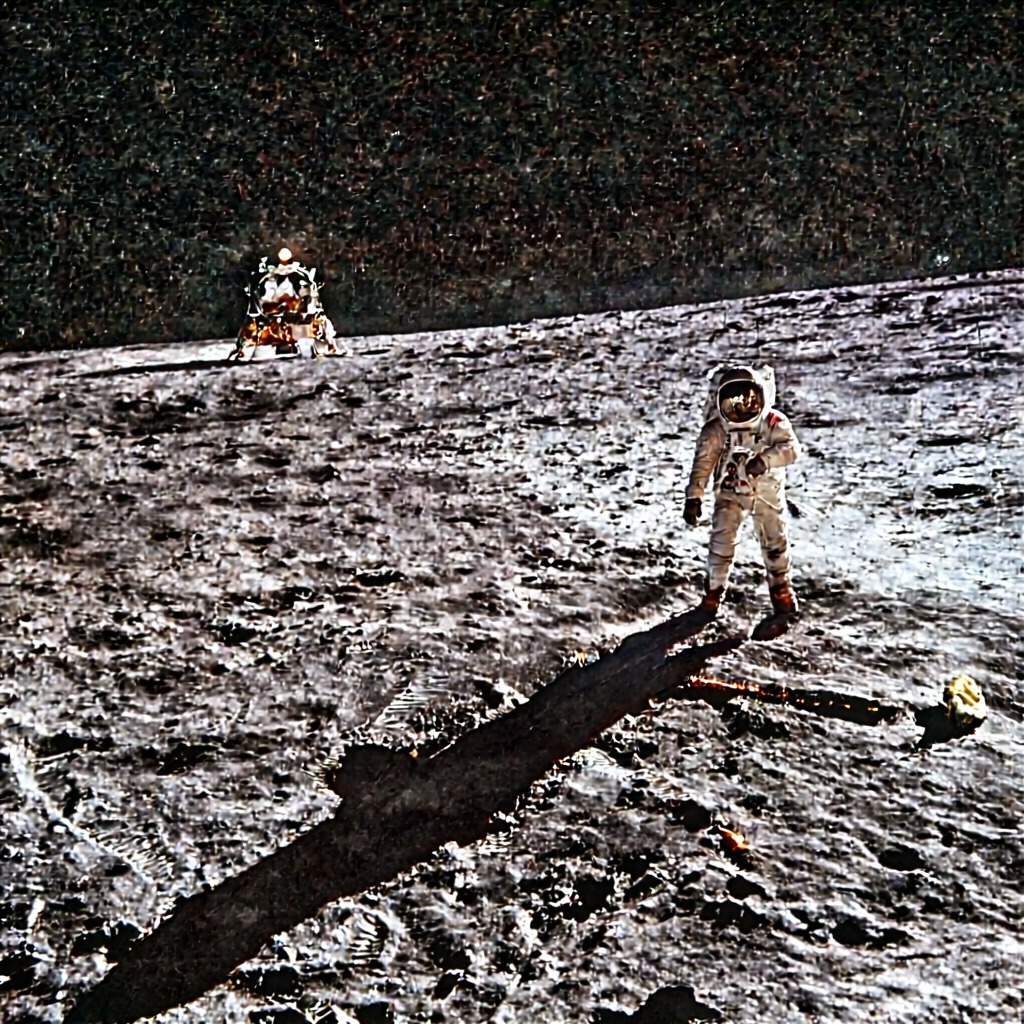
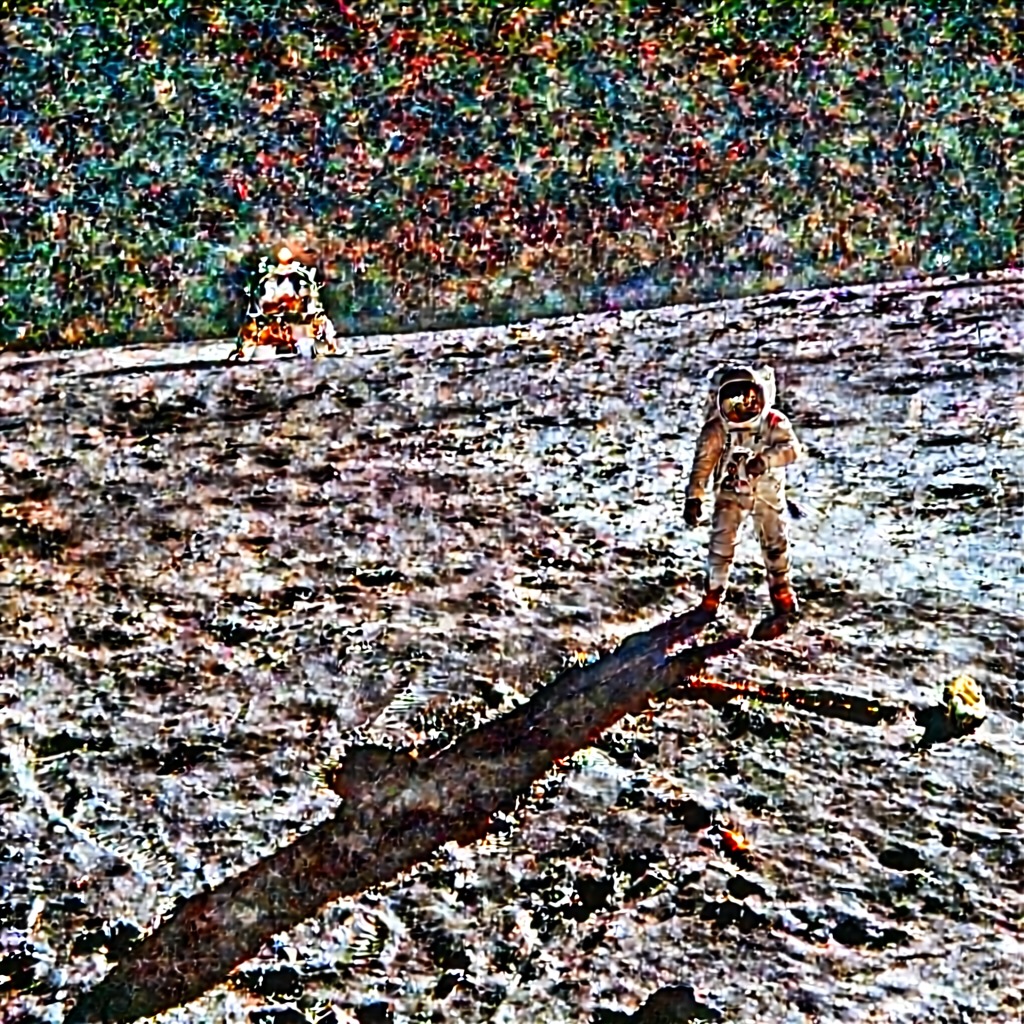
Reinyectar cada salida como la siguiente entrada es lo que convierte el adaptador en una herramienta de storyboard, pero el autor midió un modo de fallo en lugar de suponerlo: el encadenado ingenuo con fuerza 0.9 acumula grano de película hasta convertirlo en ruido de color visible en el salto 3 o 4. La receta verificada para cadenas limpias es fuerza 0.7 o inferior más un desenfoque gaussiano de 0.5 píxeles en cada entrada encadenada, lo que rompe el bucle de retroalimentación de amplificación de grano. El ejemplo de cuatro saltos anterior se renderizó exactamente así.
 |  |
|---|---|
| Salto 1: la cámara retrocede a un plano general | Salto 2: panea a la derecha, el astronauta avanza a saltos por el regolito |
 |  |
|---|---|
| Salto 3: corte a un plano contrapicado mientras el astronauta saluda | Salto 4: acercamiento a la visera dorada, con el módulo lunar reflejado en ella |
Qué checkpoint usar
El repositorio incluye tres checkpoints convertidos además de las salidas de entrenamiento sin procesar:
| Checkpoint | Veredicto |
|---|---|
next_scene_step2500.safetensors | RECOMENDADO. Paso final, convertido al diseño de claves de diffusers. La transformación de escena más potente manteniendo la composición y la identidad. |
next_scene_step1500.safetensors | Alternativa más suave y más respetuosa con la identidad. Úsala si 2,500 fuerza demasiado. |
next_scene_step1000.safetensors | La transformación más débil, útil sobre todo para estudiar la curva de entrenamiento. |
checkpoints/qwen21_next_scene_v1_*.safetensors | Formato ai-toolkit sin procesar. Las claves MLP usan la nomenclatura fusionada de ai-toolkit, que diffusers omite en silencio. Solo se pueden usar a través de ai-toolkit o de su propio loader. |
El autor también publicó un barrido de checkpoints sobre un mismo prompt de tormenta en los pasos 1.000, 1.500 y 2.500, con un control sin LoRA. El modelo base ya intenta la tormenta, ya que Qwen-Image 2.1 edita bien por sí solo, pero el paso 2.500 es la celda que despliega un frente de tormenta completo sobre el valle manteniendo intactos al explorador, las ruinas y la paleta.
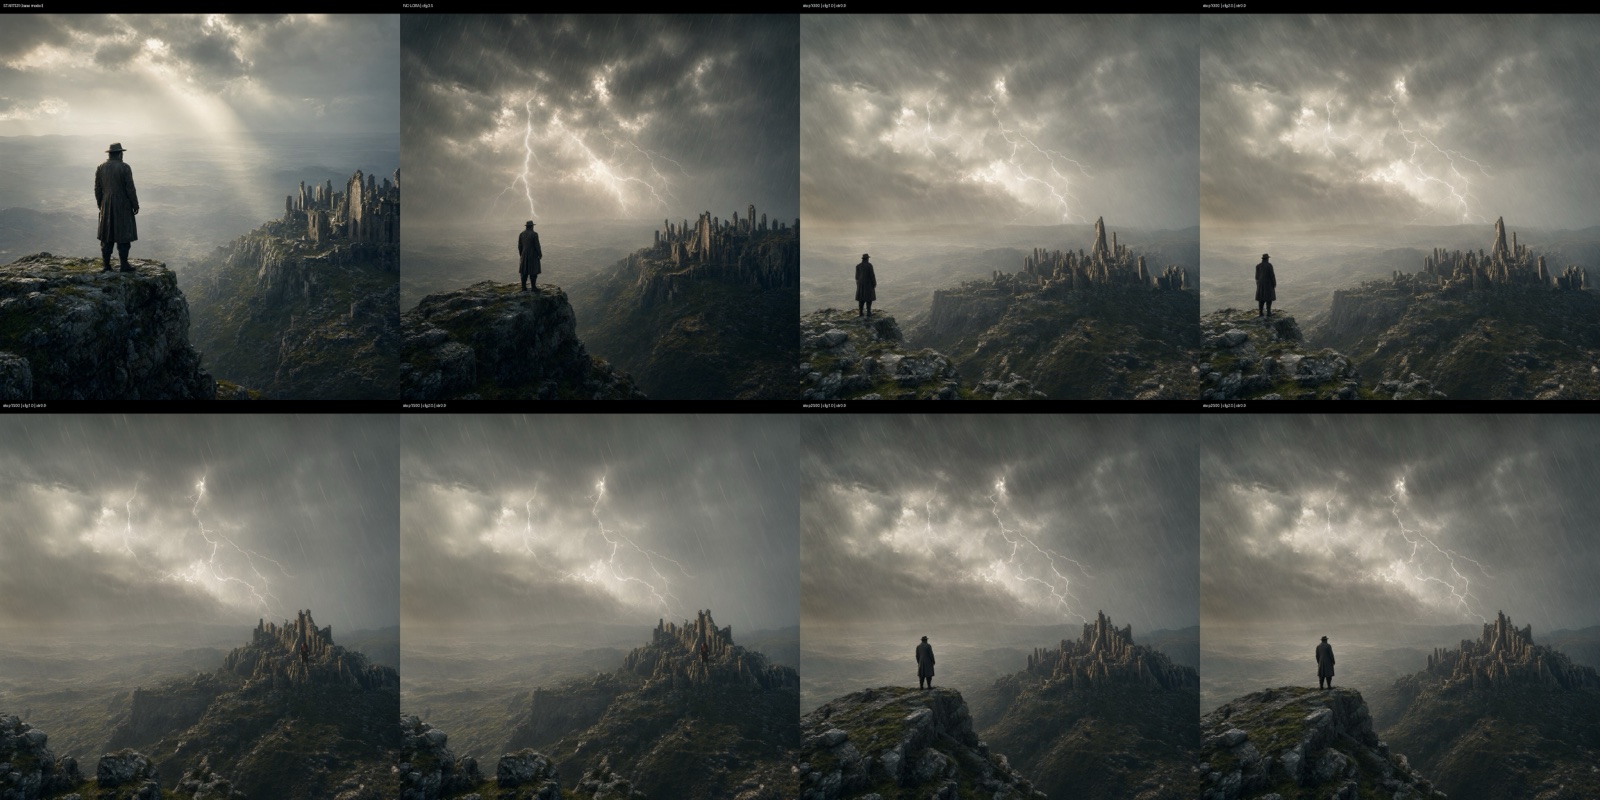
Un mismo punto de partida cinematográfico, la misma instrucción de tormenta en cada checkpoint, más un control sin LoRA.
Cómo se entrenó
- Base: Qwen-Image 2.1,
arch: qwen_image_2. - Datos: 1.144 pares de progresión de escena, fotogramas consecutivos de los cortos abiertos de Blender Sintel y Tears of Steel (CC-BY), descritos como instrucciones al estilo de un director "Next Scene: ..." por Qwen3-VL-4B sobre cada par de fotograma a siguiente fotograma. Se publican tanto los pares sin procesar como el conjunto con descripciones.
- Entrenamiento: ostris/ai-toolkit, rango 64 / alfa 64, adamw8bit, tasa de aprendizaje 1e-4, timesteps ponderados, caption dropout 0.05, 512 píxeles, 2.500 pasos, sobre una base cuantizada en uint3 en bf16.
Alcance y límites
El adaptador se entrenó con fotogramas de cine, uno de animación y otro de acción real. Generaliza a fotografías, pero es más potente en escenas fílmicas, paisajes y planos de establecimiento, y los retratos estáticos quedan fuera de alcance por diseño. El entrenamiento se hizo a 512 píxeles; los lienzos mayores heredan el comportamiento, pero no se entrenaron con ellos. Las cuadrículas de muestras cada 250 pasos se guardan en checkpoints/samples/, y desde la model card se enlazan un panel de Trackio y un Space de demostración.
Disponibilidad en ComfyUI
El checkpoint recomendado ya está convertido, así que se carga en cualquier flujo de trabajo de Qwen-Image 2.1 mediante un nodo LoRA con fuerza 0.7 a 0.9, pasando la imagen como entrada de edición o de referencia. No hay un archivo de flujo de trabajo aparte para el adaptador, y los archivos next_scene_step*.safetensors de la raíz son los que hay que usar en ComfyUI; las copias de checkpoints/ están en formato ai-toolkit.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.