LoRA Multiple-Angles de Qwen-Image 2.1: Reencuadrar objetos
El LoRA Multiple-Angles de Akhaliq aporta control de cámara a Qwen-Image 2.1: sube una foto, elige uno de los 72 encuadres de azimut y elevación y reencuadra el sujeto en ComfyUI.
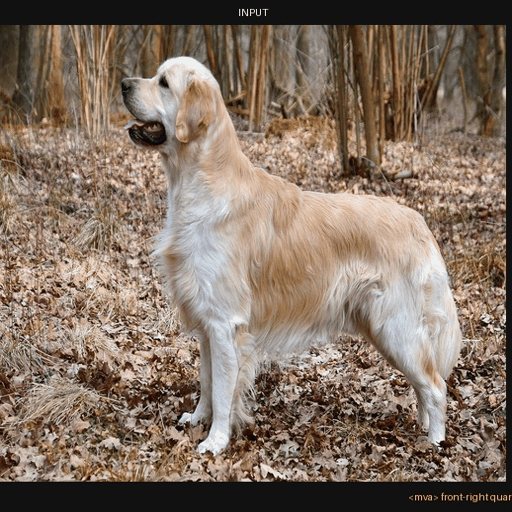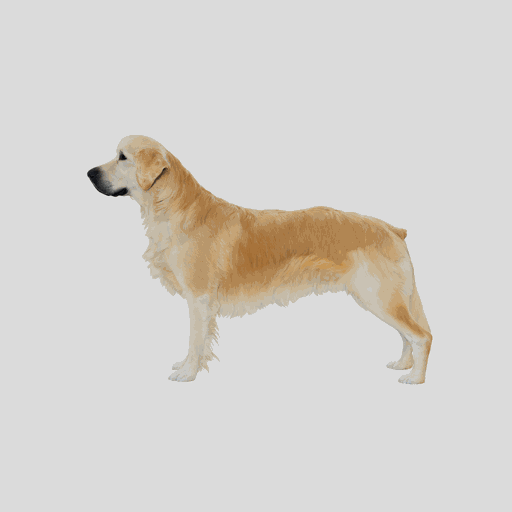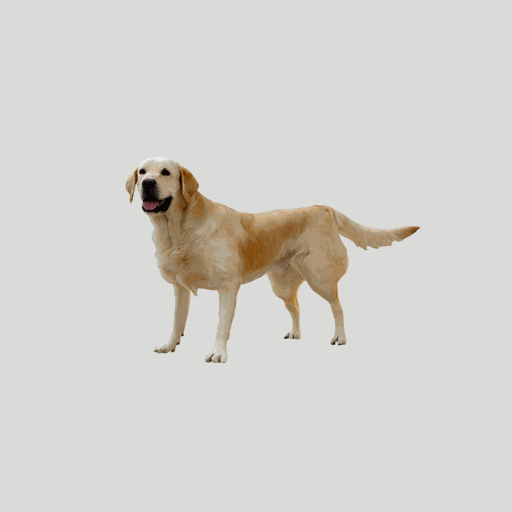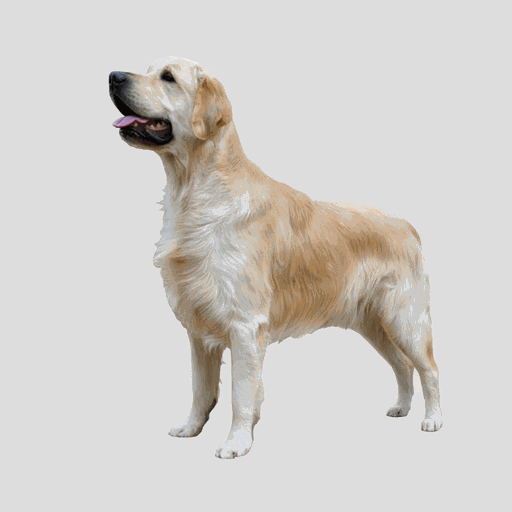
Una órbita de un golden retriever a la altura de los ojos, los 12 pasos de azimut, generada con el checkpoint v2 en el paso 1.500.
Qué aporta el adaptador
Qwen-Image 2.1 maneja generación y edición en un solo modelo, pero no tiene noción de dónde está situada la cámara. Pedirle que "muestre la espalda" suele dejar al sujeto más o menos donde estaba. Este LoRA enseña en su lugar el diccionario de poses: cada prompt empieza con el trigger <mva> seguido de un azimut y una elevación con nombre, y el modelo mueve la cámara en lugar de la escena.
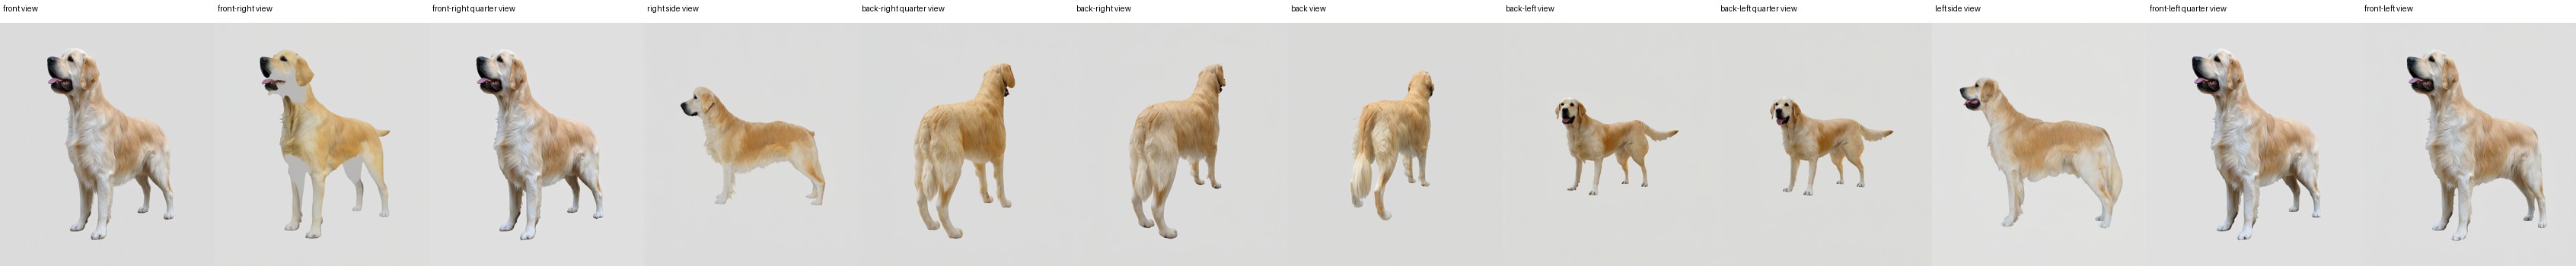
La misma órbita como tira etiquetada, un fotograma por azimut.
La gramática es corta:
<mva> {azimuth}, {elevation}[ close-up]- 12 azimuts en pasos de 30 grados, desde la vista frontal pasando por ambos lados hasta la vista trasera.
- 4 elevaciones: a la altura de los ojos, elevado (30 grados), ángulo alto (60 grados) y picado cenital (90 grados).
- Una variante
close-upde cada combinación, para 72 encuadres direccionables en total. - Fuerza de LoRA recomendada entre
0.8y1.0en ComfyUI o diffusers.
Funciona con fotos reales
El conjunto de entrenamiento son objetos renderizados, pero la tarjeta del modelo documenta una prueba con datos reservados sobre fotos corrientes que nunca vio: un golden retriever, un gato y una manzana de Wikimedia Commons. Con una fuerza cercana a 1.0 el sujeto rota a la vista solicitada y la escena se conserva en gran medida, aunque el detalle fino, como el pelaje, se suaviza en sujetos alejados de la distribución de entrenamiento.
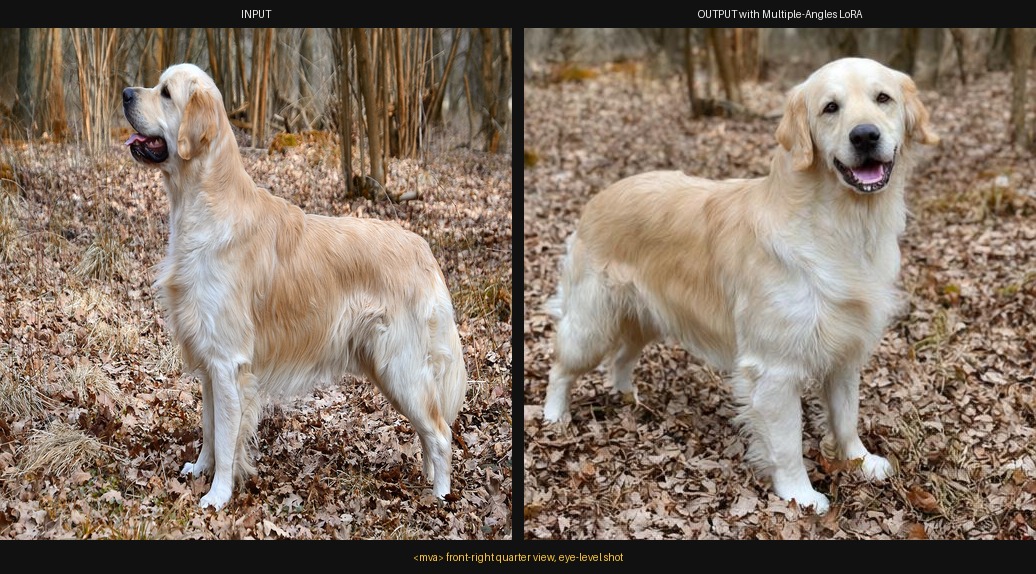 | 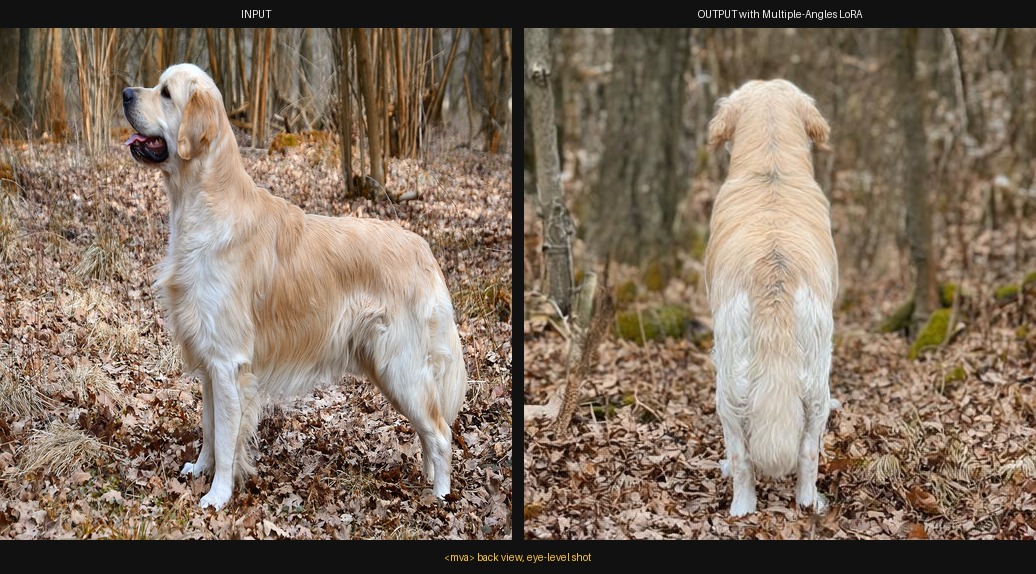 |
|---|---|
| Vista de tres cuartos frontal derecha, a la altura de los ojos | Vista trasera, a la altura de los ojos |
La regla práctica de la tarjeta: empieza con una fuerza de 1.0; si el reencuadre tiende a copiar la foto de referencia en lugar de mover la cámara, baja la fuerza hacia 0.8 en vez de cambiar de checkpoint.
Qué cambia la v2
La segunda revisión es la descarga recomendada. Eleva los pares de entrenamiento de 5.028 a 13.328 (un conjunto Dome-Objaverse con prioridad de personajes más personajes riggeados filtrados por licencia), pasa el rango de 32 a 64 y cambia la precisión base de convrot int8 a bf16 con muestreo de timesteps ponderado.
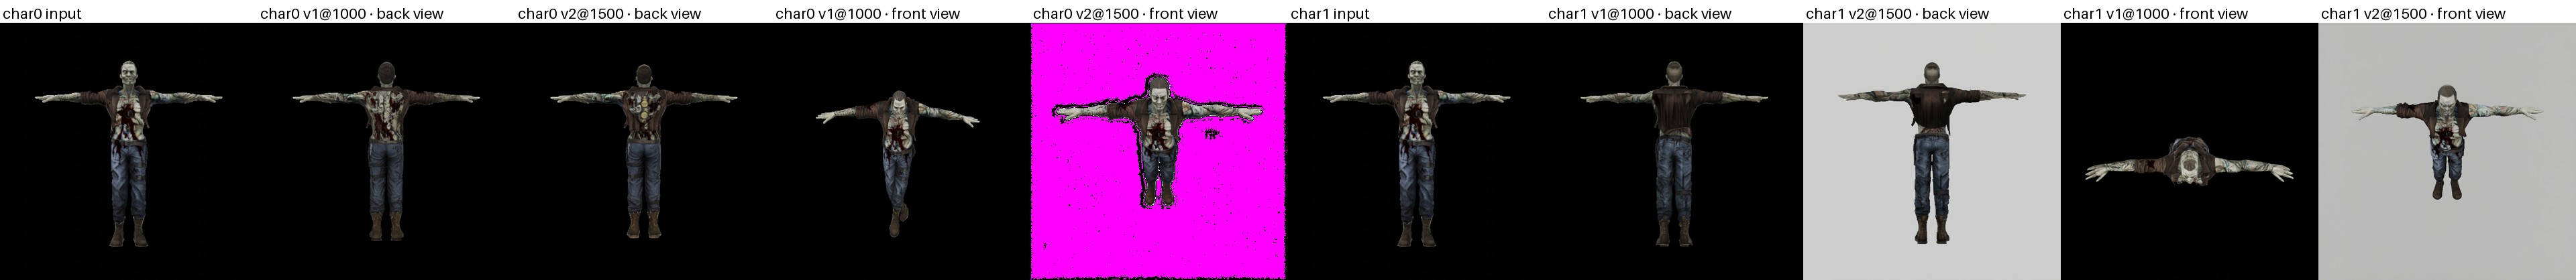
Hoja de poses de personajes que compara la v1 en el paso 1.000 con la v2 en el paso 1.500.
La gramática <mva> y el diccionario de poses no cambian entre versiones, así que un flujo de trabajo creado para la v1 sigue funcionando tras sustituir el archivo. La tarjeta recomienda el paso 1.500 de la ejecución v2 (rango 64, precisión completa, unos 319 MB en checkpoints_v2/); los archivos de la v1 permanecen en checkpoints/, donde el paso 1.000 es el elegido.
Cómo ejecutarlo en ComfyUI
El adaptador es un LoRA normal, así que no hace falta ningún paquete de nodos personalizado: coloca el .safetensors en ComfyUI/models/loras/ y cárgalo con el cargador de LoRA estándar junto al modelo de difusión Qwen-Image 2.1, su text encoder y el VAE correspondiente. La tarjeta recomienda una fuerza de 0.8 a 1.0; no hay muestreador ni valor de CFG específicos del adaptador, así que se aplican las configuraciones del propio modelo base.
Benchmark, explicado con claridad
La tarjeta publica un benchmark de 144 casos reservados (24 objetos no vistos, seis poses cada uno) puntuado contra renders de cúpula de referencia con coseno imagen-imagen de CLIP, y lo reporta con honestidad: la base sin adaptar puntúa en realidad ligeramente más alto de media (0.857 frente a 0.832), porque esa métrica mide sobre todo la similitud global de la imagen y no si la cámara se movió. Los autores señalan que el protocolo correcto es la precisión de recuperación de pose, que aún requiere otra pasada de render, y remiten a los lectores a las imágenes A/B con prompt emparejado como evidencia principal de la capacidad en sí.
Disponibilidad
Pesos: akhaliq/Qwen-Image-2.1-Multiple-Angles-LoRA
Modelo base: Qwen/Qwen-Image-2.1
Datos de entrenamiento (v2): akhaliq/qwen21-multiple-angles-train-v2
Página de la familia base: Qwen-Image 2.1
Comentarios
Inicia sesión con GitHub para unirte a la conversación.