LoRAs Pruna de 5 y 8 pasos para Qwen-Image 2.1 en ComfyUI
Los LoRA Pruna-Qwen-Image-2.1 de PrunaAI reducen la generación y edición con Qwen-Image 2.1 a 5 u 8 pasos sin CFG, con conversiones ComfyUI de la comunidad y sigmas por paso.
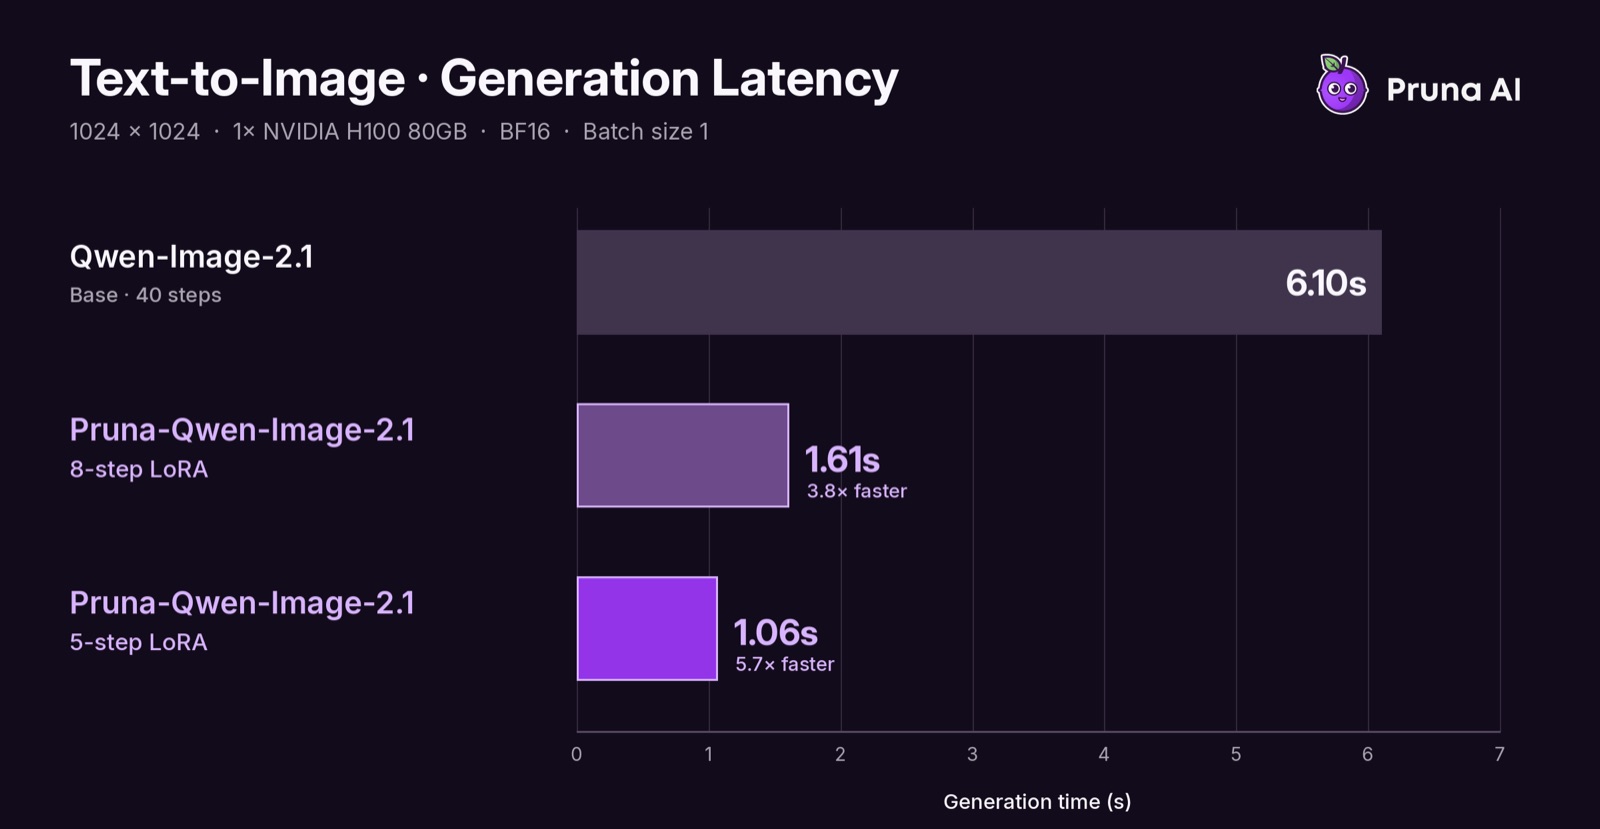
Comparativas de texto a imagen de la tarjeta oficial del modelo.
Dos adaptadores, dos programaciones
El lanzamiento no es un único modelo destilado, sino dos estudiantes entrenados por separado, y PrunaAI espera que elijas uno según si priorizas la calidad o la velocidad:
| Adaptador | Pasos | Compromiso |
|---|---|---|
p_qwen_image_2.1_8step_v0.1.safetensors | 8 | Mayor calidad, la opción predeterminada recomendada |
p_qwen_image_2.1_5step_v0.1.safetensors | 5 | Más rápido, con imágenes visiblemente peores |
Cada adaptador se entrenó para su propia programación sigma, y la tarjeta del modelo pide cargar solo uno a la vez. Las programaciones son la parte que debe copiarse exactamente, porque los estudiantes no se entrenaron para un número de pasos que un muestreador derive por su cuenta:
| Pasos | Sigmas |
|---|---|
| 5 | 1.0, 0.94, 0.857142857, 0.666666667, 0.4 |
| 8 | 1.0, 0.933333333, 0.857142857, 0.769230769, 0.666666667, 0.545454545, 0.4, 0.222222222 |
Ambos están entrenados con DMD, ambos se ejecutan con CFG 1.0 y un prompt negativo vacío, y el 0 final lo añade el scheduler en lugar de estar escrito en la programación. Otros números de pasos, programaciones o valores de CFG quedan fuera de aquello para lo que se entrenaron los adaptadores.
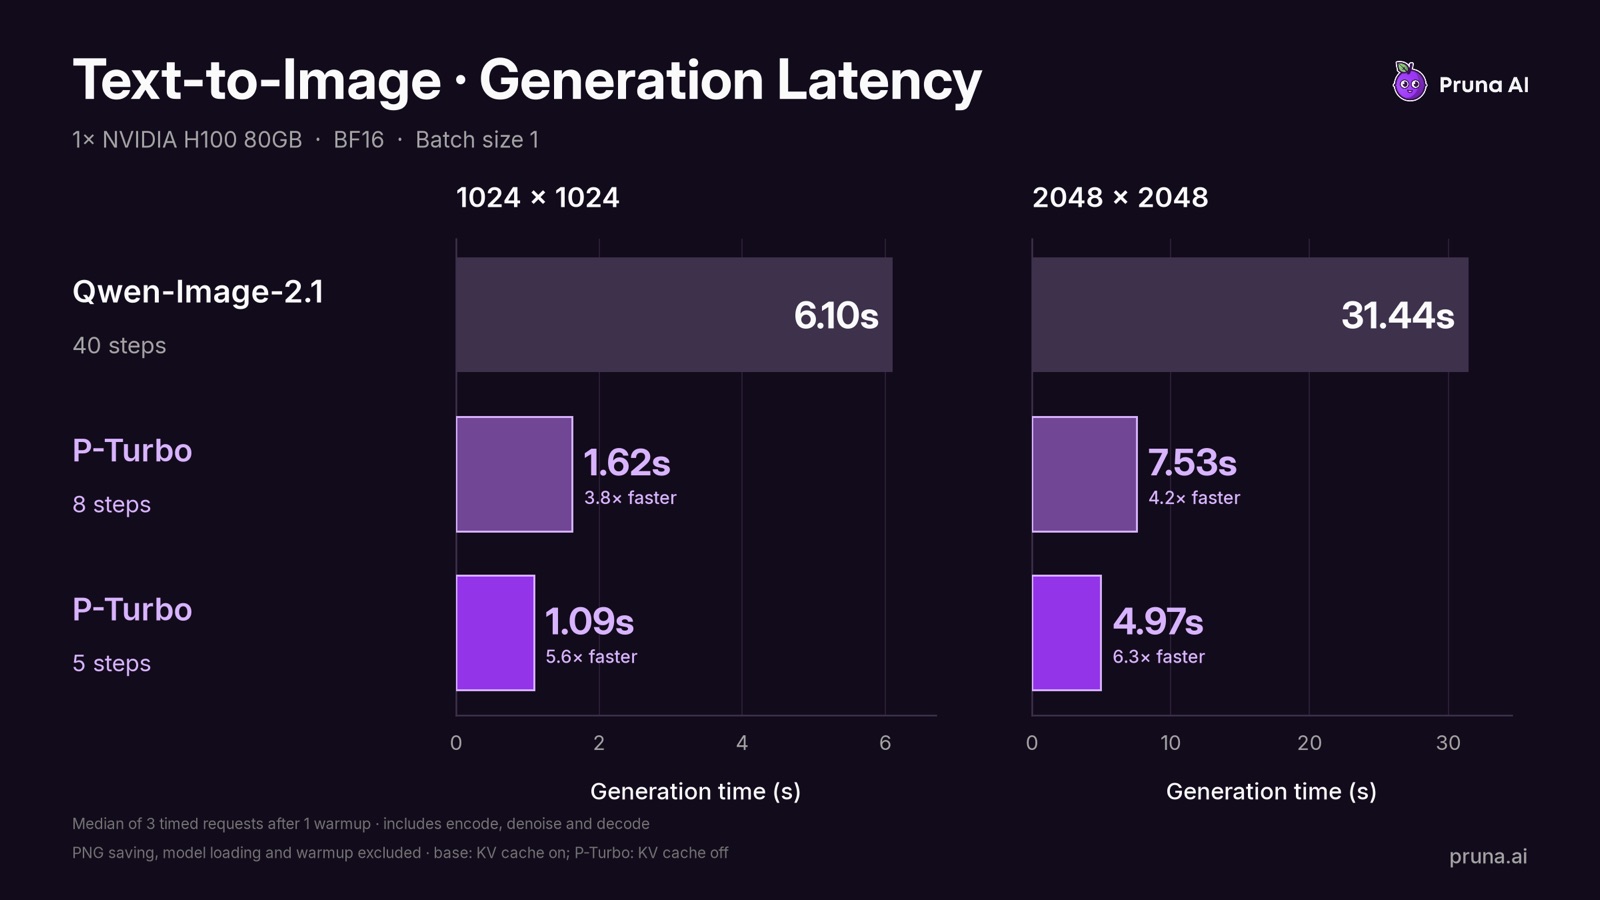
El gráfico de latencia de texto a imagen de la tarjeta, medido en una sola H100 de 80GB: mediana de tres solicitudes tras un calentamiento, incluyendo la codificación del prompt, el denoising y la decodificación, con el modelo base a 40 pasos con caché KV y los adaptadores a 5 u 8 pasos sin ella.
La cifra destacada de PrunaAI es hasta 6,3 veces más rápido, y la tarjeta es cuidadosa con lo que no afirma: los tiempos no implican una calidad de imagen igual, los LoRA se mantuvieron sin fusionar para el benchmark, y las imágenes de ejemplo activan la caché KV mientras que el gráfico no se volvió a medir con esa configuración.
Cobertura de entrenamiento y límites
Los adaptadores se entrenaron solo a resolución 1K, con una mezcla de prompts simples y con upscale, cubriendo texto a imagen y edición de una o varias imágenes con hasta 3 imágenes de referencia. PrunaAI recomienda empezar a 1024x1024 y considera la salida 2K, más imágenes de referencia y prompts cortos y vagos como fuera de la cobertura, donde la calidad puede variar.
El lanzamiento está etiquetado explícitamente como v0.1, en progreso:
- La calidad está por debajo de la del modelo base de 40 pasos, y el repositorio se actualizará a medida que mejore la destilación.
- El adaptador de 5 pasos es el rápido, y sus imágenes son visiblemente peores que las del adaptador de 8 pasos.
- No es un modelo independiente: los pesos base de
Qwen/Qwen-Image-2.1siguen siendo requeridos.
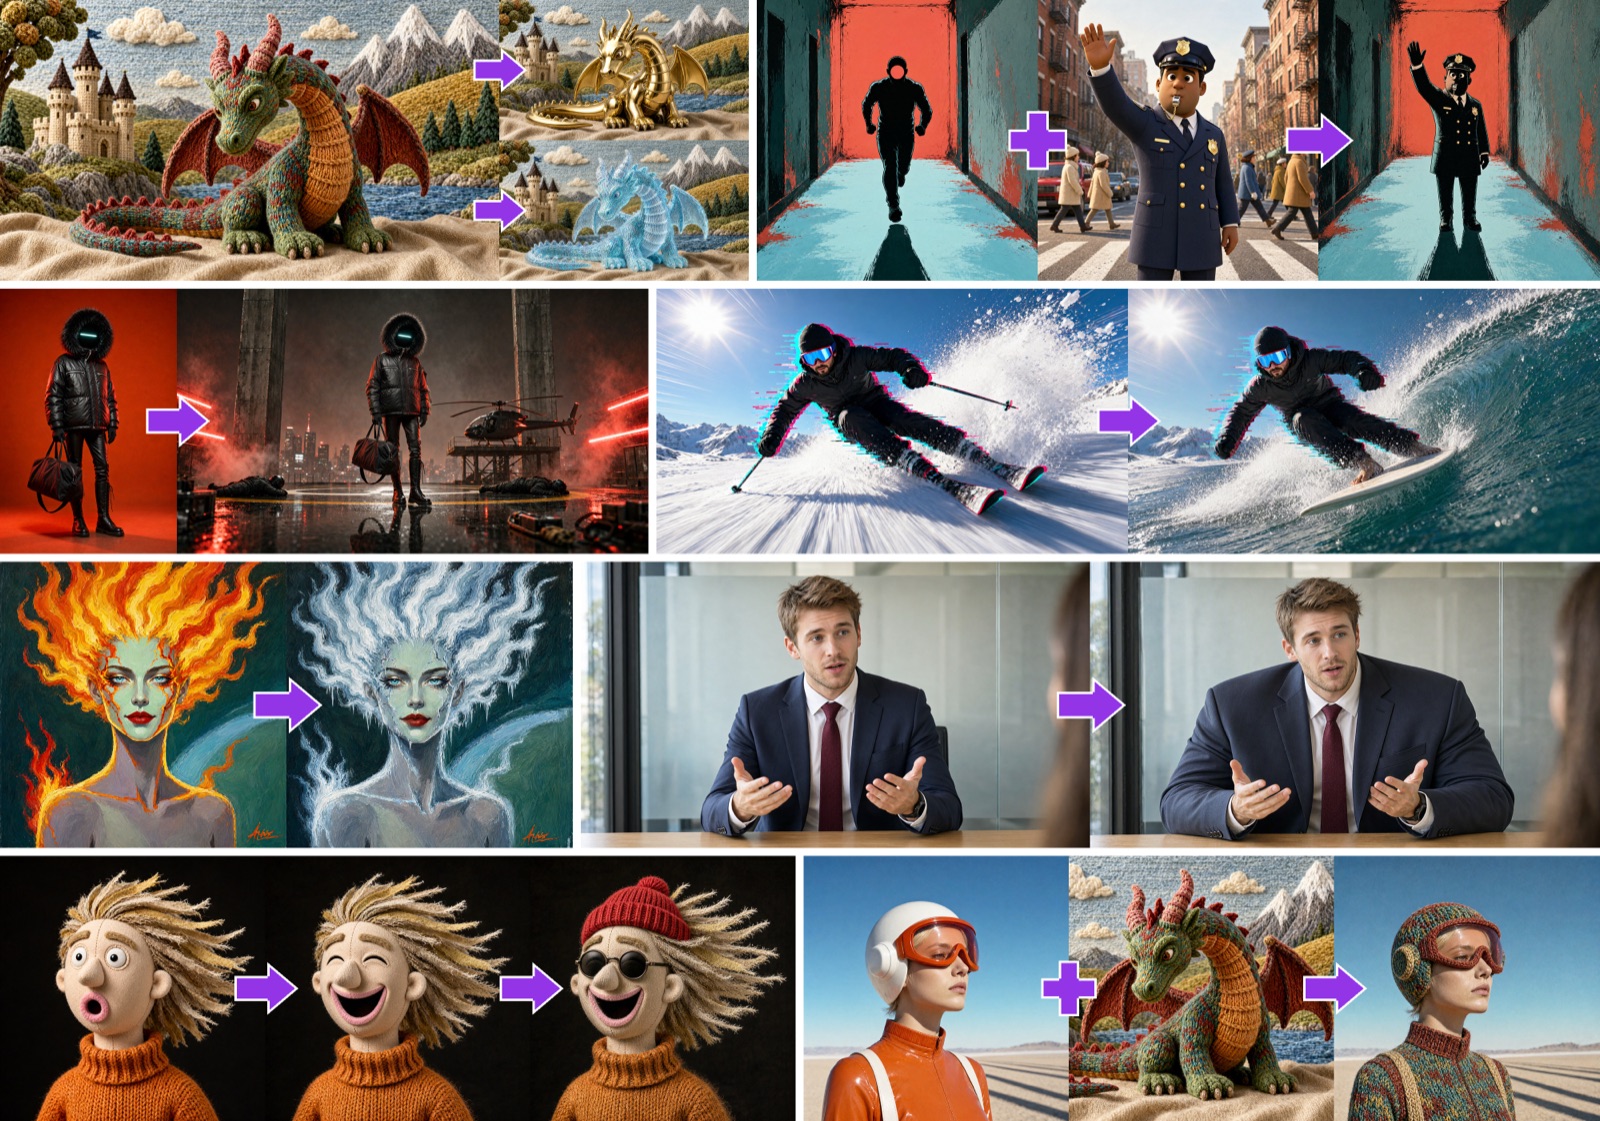
Cuadrículas de edición de la tarjeta oficial del modelo.
Disponibilidad en ComfyUI
Todavía no hay un paquete oficial de ComfyUI para los adaptadores: se distribuyen como archivos diffusers/PEFT con rank 64 y un alfa PEFT de 128, y el alfa se almacena en los metadatos de safetensors en lugar de en los tensores que lee el cargador LoRA de ComfyUI, por lo que un uso directo se ejecutaría con la escala incorrecta. La comunidad cerró esa brecha en un día desde el lanzamiento:
NidAll/pruna-image-2.1-comfyui-lorases una conversión no oficial que añade un tensor escalar.alphaa cada uno de los 224 objetivos LoRA para que los adaptadores se ejecuten a la escala prevista con fuerza de LoRA 1.0, dejando intactos los pesos A y B. Incluye sus propios JSON de flujo de trabajo de 5 y 8 pasos.- Esos flujos de trabajo usan solo nodos nativos de ComfyUI:
ManualSigmas,SamplerCustom, Euler, CFG 1.0, fuerza de LoRA 1.0, sin prompt negativo, y texto a imagen a 1024x1024. Los archivos base provienen deComfy-Org/Qwen-Image-2.1, lo que significa que el transformerint8_convrotes el objetivo práctico para cualquiera con VRAM de consumo.
ComfyUI admite Qwen-Image 2.1 de forma nativa desde el lanzamiento del Día 0, así que no hay que instalar nada extra: un ComfyUI reciente con ManualSigmas y SamplerCustom cubre ambos flujos de trabajo incluidos.
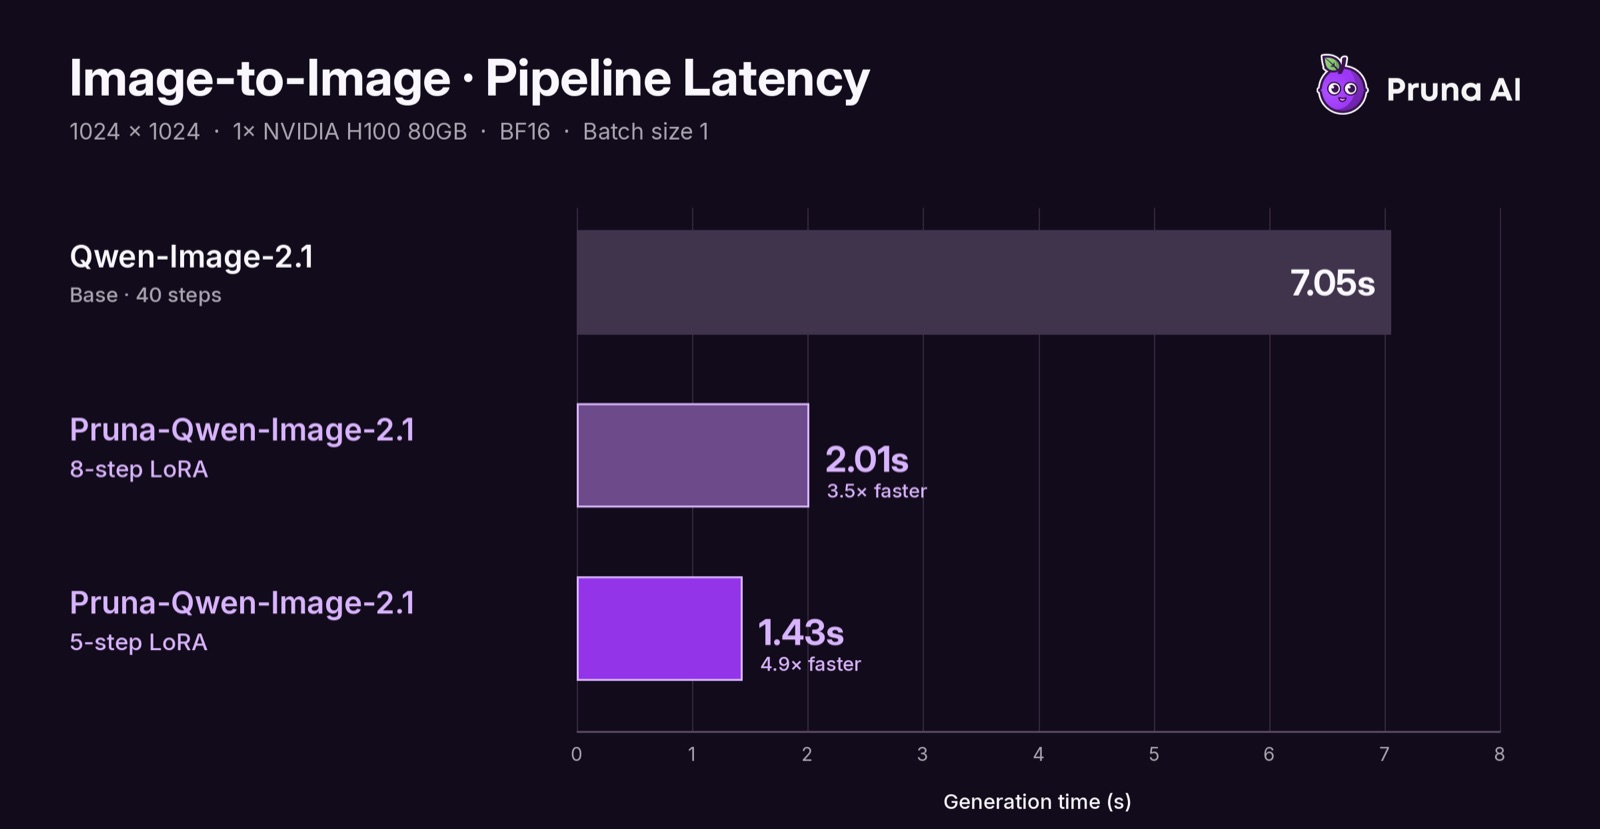
Una muestra de edición de la tarjeta del modelo, ejecutada con los adaptadores de pocos pasos.
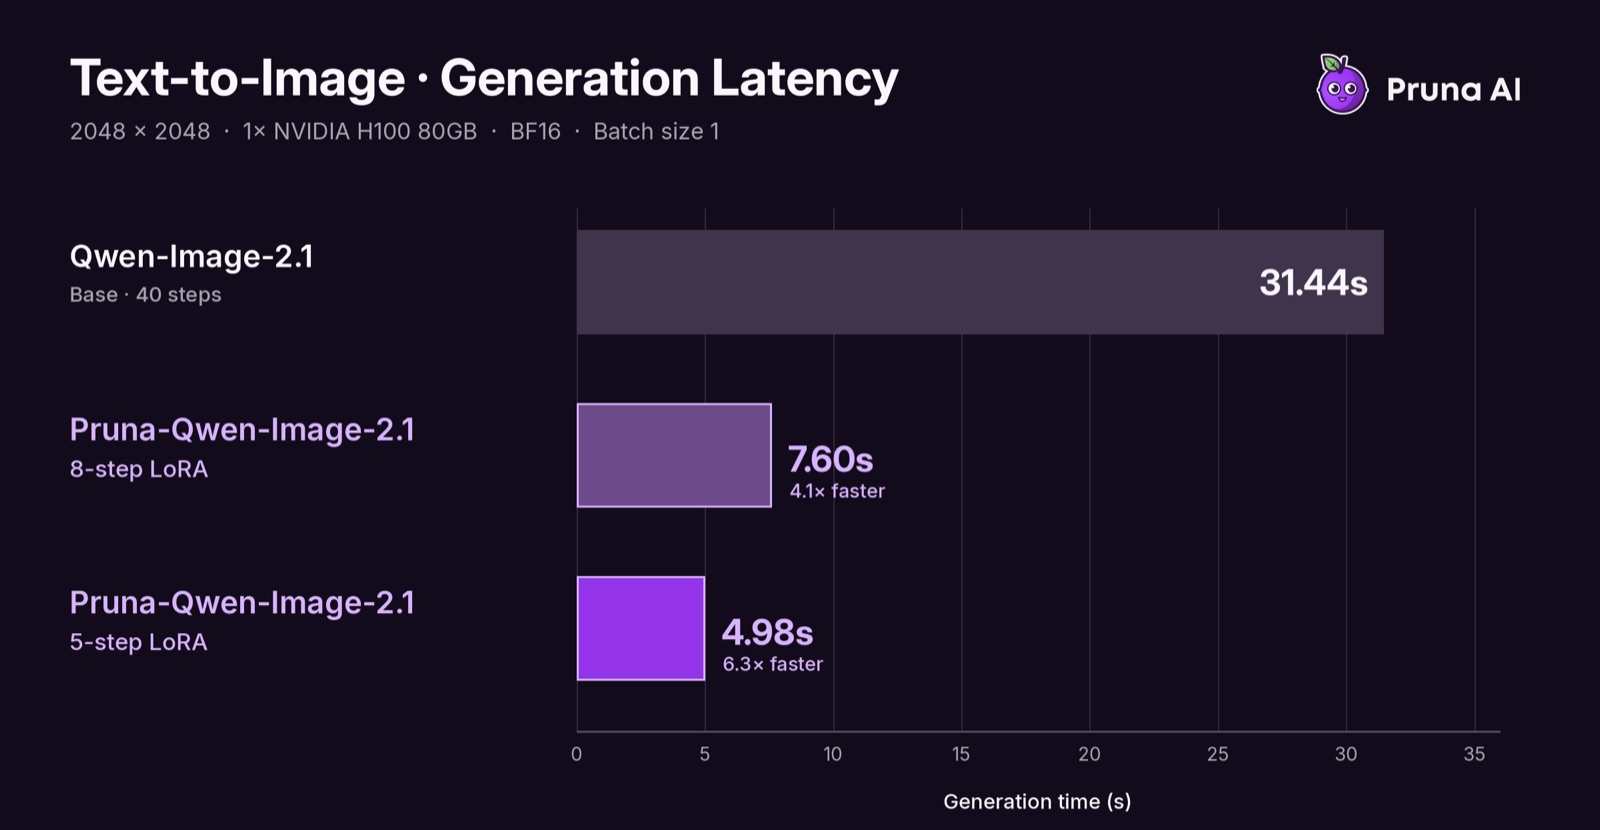
Texto a imagen a 2048, fuera de la cobertura de entrenamiento de 1K pero parte de las mediciones de latencia publicadas.
Las primeras pruebas provienen sobre todo de la comunidad de ComfyUI más que del propio lanzamiento: los adaptadores se compararon con el turbo de Viggle y los LoRA Qwen Acc oficiales en el canal #qwen-image de Banodoco, donde los probadores destacaron el adaptador de 8 pasos, y se publicaron en r/StableDiffusion y X poco después de que se subieran los pesos.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.