使用 pDMD LoRA 让 MiniMax-H3-Image 实现 2 步生成
pDMD 2 步 LoRA 将 MiniMax-H3-Image 从 6 步降至 2 步,在原生 16 MP 下单张图像从 25.1 秒缩短到 17.4 秒,并附带现成的 ComfyUI 工作流。
 |  |
|---|---|
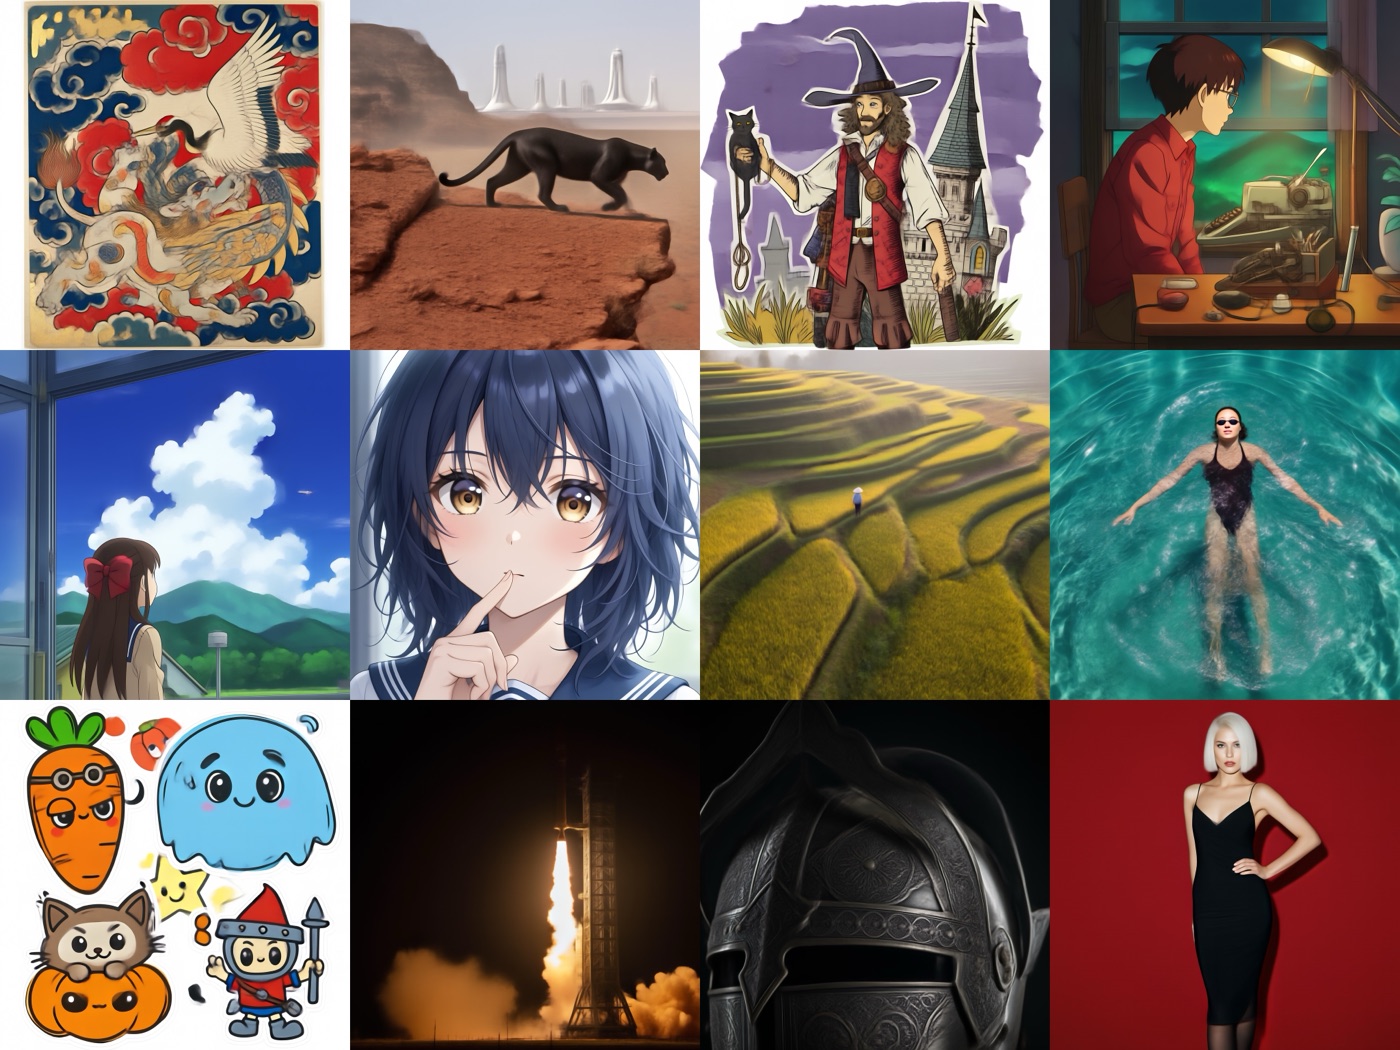
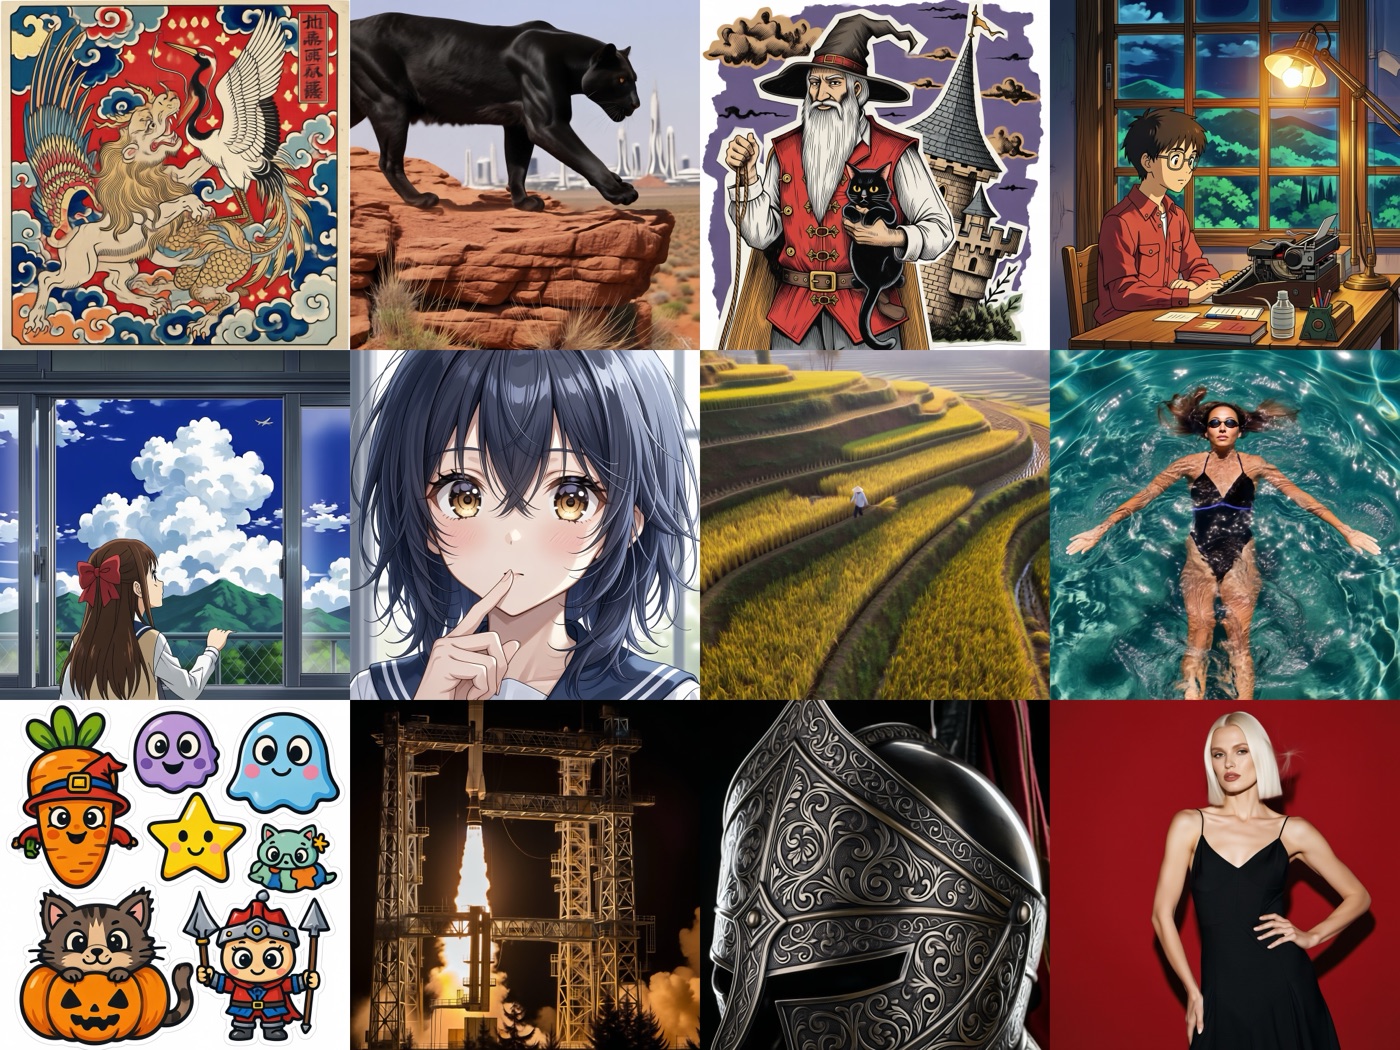
| 原生 checkpoint,2 步 | 使用 pDMD LoRA,2 步 |
十二个提示词,4096x4096,两步,flow shift 12,种子 3。原生模型无法低于其固定的 6 步调度,因此在 2 步时它仍处于去噪中途。
运行方式
两种加载方式,同一个节点图。
- 单文件: 将 40 GB 的
minimax_h3_image_pdmd_2step_bf16.safetensors下载到ComfyUI/models/diffusion_models/,另外还需要一个 Qwen3-VL-32B 文本编码器,以及来自 Comfy-Org/MiniMax-H3-Image 的图像 VAE。LoRA 已经合并,因此不需要 LoRA 节点,也无需设置强度。 - 基础模型加 LoRA: 保留当前 Comfy-Org checkpoint,并将 2 GB 的
minimax_h3_pdmd_2nfe_comfyui.safetensors添加到ComfyUI/models/loras/,在 UNet加载器(Load Diffusion Model)与 MiniMaxH3SigmaShift 之间插入 LoraLoaderModelOnly,强度设为 1.0。这是int8_convrot和w4a8重打包版本唯一的途径,因为预合并的权重无法构建在旋转或量化张量之上。
然后采样 2 步,采样器 euler,调度器 simple,denoise 1.0,shift_video 12,不使用 CFG。Latent 来自 EmptyHunyuanLatentVideo,因为 H3 的图像 Latent 只有一帧。
速度带来的收益
| 配置 | 4096x4096,单张 H200 |
|---|---|
| 原生,6 步 | 约 25.1 秒 |
| pDMD LoRA,2 步 | 约 17.4 秒 |
| 2 步加 IC 精修 | 约 50 秒 |
单张图像的收益约为 1.4 倍,而不是 3 倍:步数从 6 步降到 2 步,但在 16 MP 下每一步仍要跑同一个 33B transformer。更大的收益在于 demo Space 上的迭代速度:加上细节精修,它以约 4.6 秒渲染 2048x2048,而官方 6 步 Space 在相同尺寸下约需 7 秒。
对大多数提示词而言,2 步都够用。图形类提示词可能会生成伪文字,构图也可能偏离原生结果;3 步是稳妥的折中,4 步最接近 6 步的输出。编辑任务同理。
细节精修
先用 2 步在半尺寸下出草稿,用 lanczos 做像素级放大,VAE 编码,然后进行第二次采样:3 步,denoise = sigma_0。起始 sigma 是关键旋钮:0.4 到 0.55 在保持草稿的同时进行打磨,0.7 能增加更多细节,但可能在平坦区域产生噪点并让人脸偏移。编辑任务请保持在 0.55 或以下。
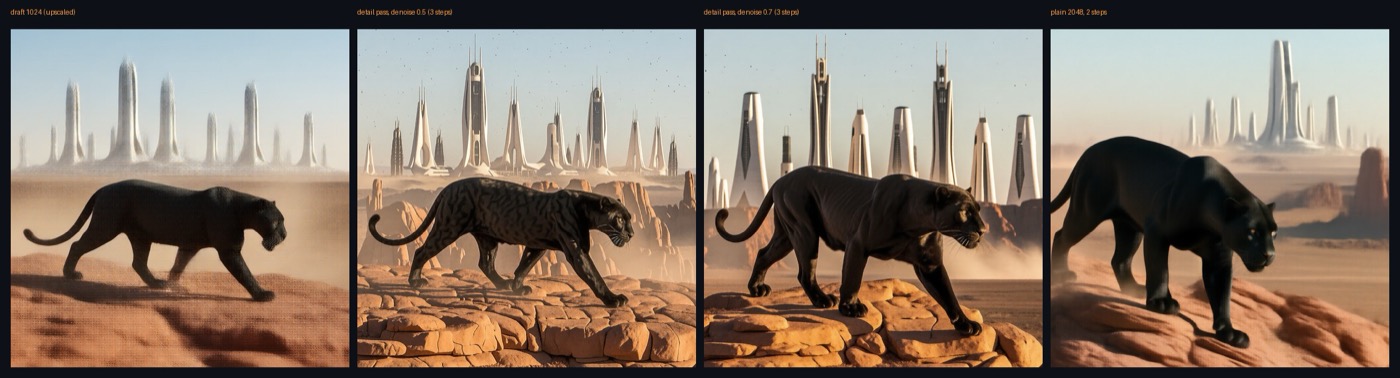
左侧为半尺寸草稿,中间为 0.5 和 0.7 的精修结果,右侧为普通的全尺寸 2 步渲染。在 4 MP 下精修只需增加 1 到 2 秒。
实时预览
由于 2 步出图成本很低,demo Space 会在你输入时渲染约 1 MP 的画面,在其 FP8 版本上每帧约 0.9 秒,并在你停顿时进行精修。这正是 LoRA 带来的能力:原生调度被固定在 6 步。
以蒙娜丽莎来源图像进行实时提示词编辑,每个分块渲染一帧 2 步结果。
获取方式
- LoRA、工作流与对比图:akhaliq/minimax-h3-image-pdmd-2step
- Demo Space:akhaliq/minimax-h3-image-2step
- 基础模型:MiniMaxAI/MiniMax-H3-Image,ComfyUI 重打包版本见 Comfy-Org/MiniMax-H3-Image
- LoRA 上游:pdmd2026/pdmd_2NFE_lora,方法见 arXiv 2609.35768
评论
使用 GitHub 登录后即可参与讨论。