MOSS-Image 颜色/深度控制适配器登陆 ComfyUI 核心
一个社区适配器通过纯色区域图和深度图引导 MOSS-Image,从纯噪声开始生成,ComfyUI 核心当晚即合并支持。
MOSS-Image 是 OpenMOSS 推出的 5B 文本与布局模型,同一周就在 ComfyUI 中有了核心实现。它原本控制构图的手段是一个由边框组成的 JSON 布局,以及一个用于参考驱动修改的编辑 LoRA。这两者都无法回答一个更简单的问题:把这个人放在这里,这个大小,站在那张桌子前面。
新适配器用两张图而不是一张参考图来回答这个问题。颜色编码每个区域的位置,深度编码每个表面的远近,而生成仍然从纯噪声开始。参考图像中没有任何内容被复制过来,因此背景来自提示词,而不是来自描摹这两张图时所依据的渲染图。
两张图作为条件
模型卡把输入定义得很窄,这正是它易用的原因:
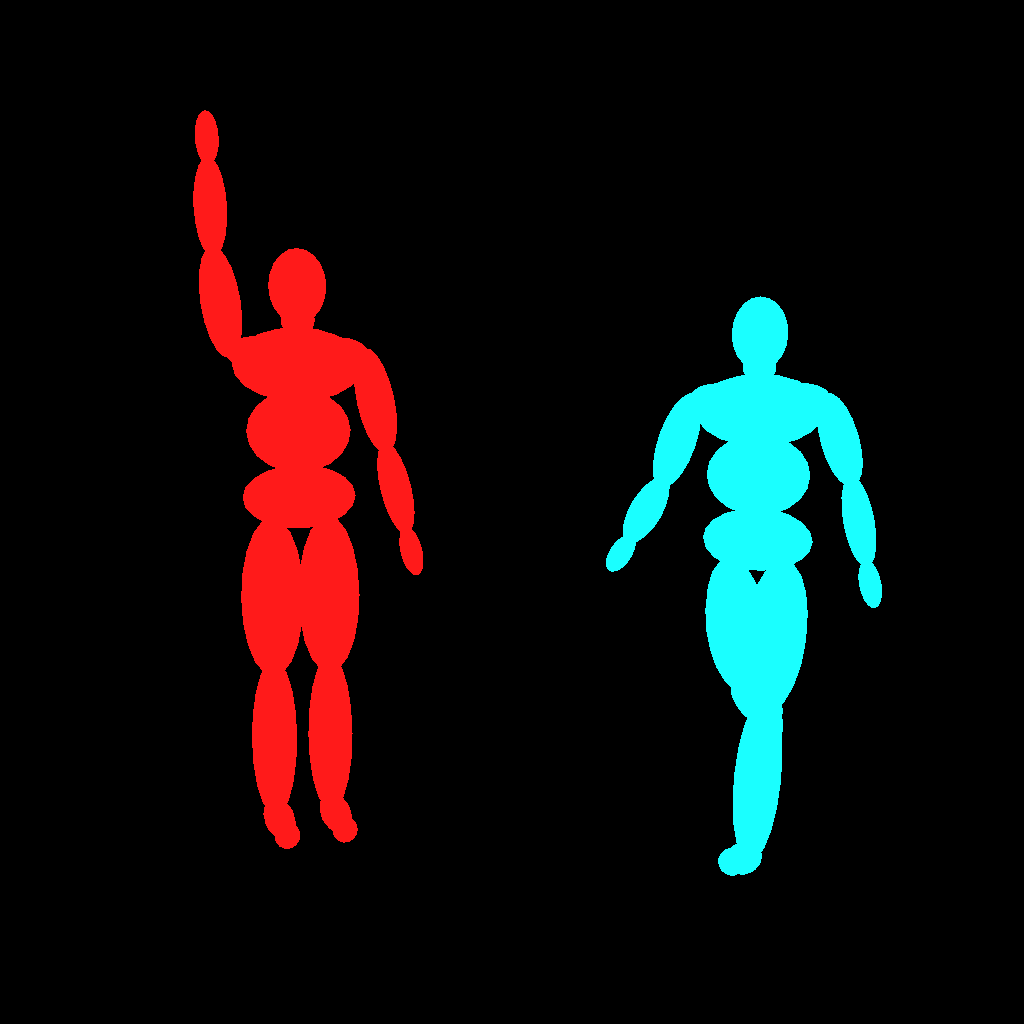
- 颜色图:与输出尺寸一致的 RGB 图像,每个物体或区域使用一种纯色。颜色是区域 ID,而不是用来上色的颜色,黑色表示未指定。
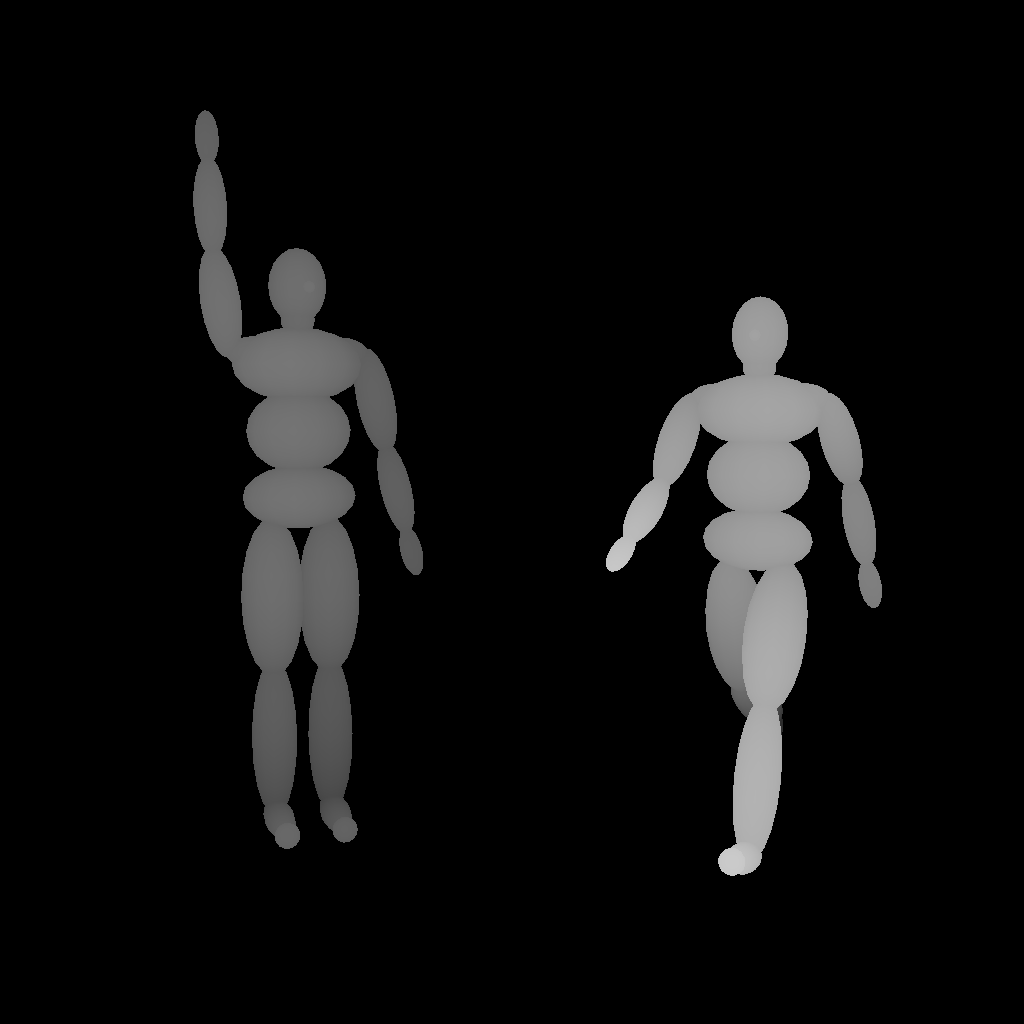
- 深度图:与输出尺寸一致的灰度图,越近越白。
- 两张图都可以省略。适配器训练时的控制丢弃率为 35% 仅颜色、35% 仅深度、20% 两者都有、10% 两者都没有,因此单图推理仍处于训练分布之内。
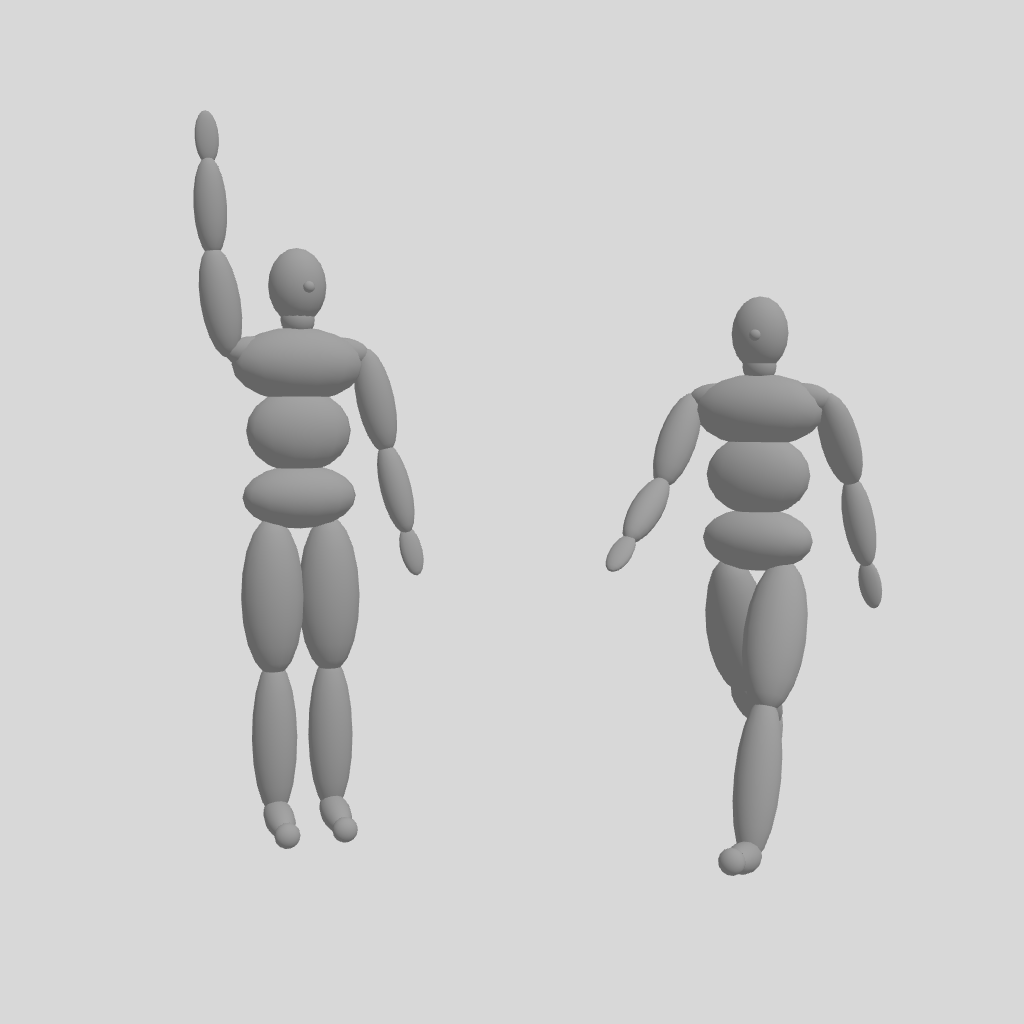
每个场景都在一个 three.js 人体模型编辑器中制作,该编辑器会同时导出着色渲染图、颜色通道和深度通道:
 |  |  |
|---|---|---|
| 源渲染图 | 颜色区域图 | 深度图,越近越白 |
真正有意义的对比是与图生图的对比。把 3D 渲染图送入 img2img 处理会保留布局,但也会保留渲染图扁平的背景和灰色表面。使用适配器时,位置、比例和姿态遵循这两张图,而材质和光照则是生成的,这也是为什么公布的场景用的是 3D 人体模型而非照片。
输出效果
模型卡的主图是一组同一个人物双人场景的网格图,对比全程保持控制与中途关闭控制的差异。
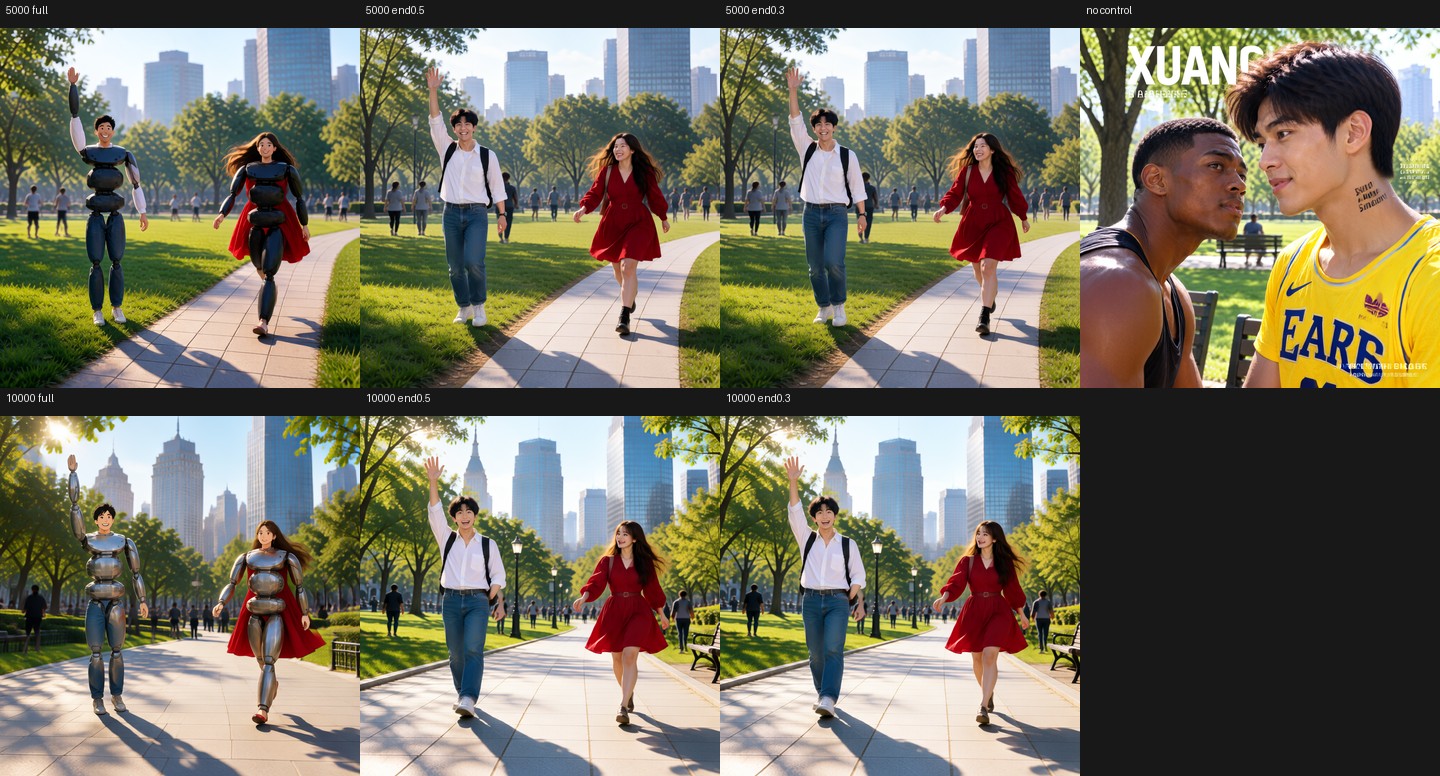
随适配器一同发布:上排为 5,000 步,下排为 10,000 步,对比控制保持到结束、在 0.5 结束、在 0.3 结束,以及无控制的基础模型。保持到结束时,人体模型的表面会透出来;在 0.5 结束则在图所指示的位置生成真实人物。
这张网格图也如实说明了适配器的主要弱点。全程保持控制会复现人体模型,因为训练用的深度图来自真实照片,而图中没有任何信息表示"不要再画成木头"。
把控制在一半步数时结束,可以保留布局,并让剩余步数生成皮肤、服装和背景。
同样的适配器只给图、不给逐区域提示词时,会出现模型卡记录的另一类失败:使用漫画风格的颜色图时,在较后的模型上分格布局会漂移,文字也会退化。
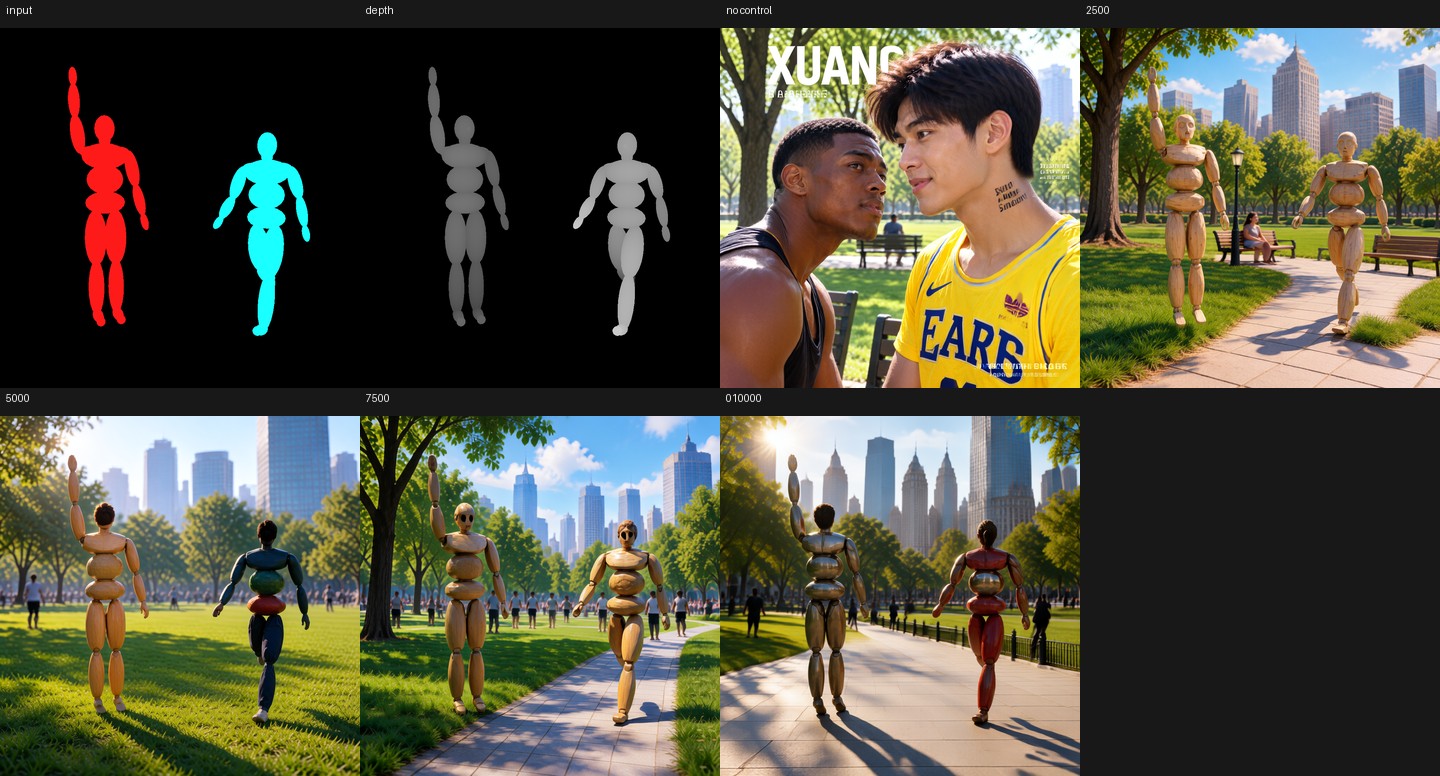
仅使用控制图、不带逐区域提示词的双人场景。来源:darask0/MOSS-Image-color-depth-control
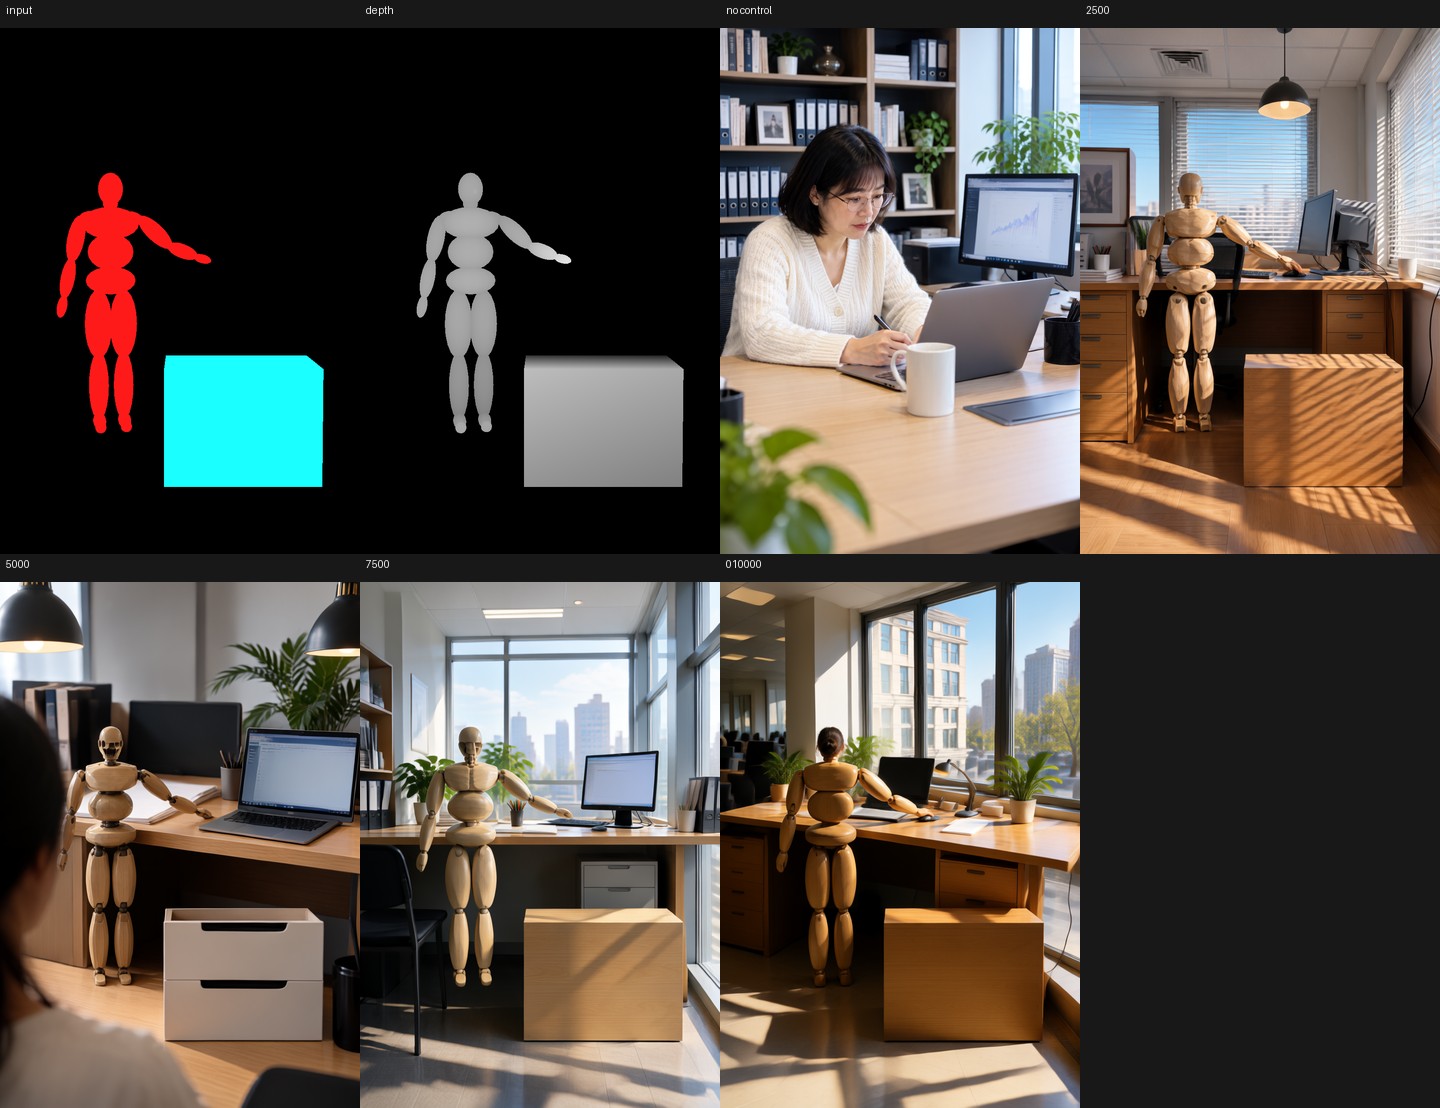
公布的第二个场景,一个人在桌前,同样只使用这些图。
ComfyUI 核心实现路径
Kijai 的 PR #17206 于 10 月 19 日 22:15 UTC 合并,新增一个节点:MOSS-Image Color/Depth Control(MOSSImageControl),属实验性,位于 model/conditioning/moss_image 下。它接收正向和负向条件、VAE、可选的 color_map、可选的 depth_map,以及 strength、start_percent 和 end_percent,并返回两路条件流。
工作流就是普通的 MOSS-Image 工作流,加了两处。适配器通过标准的 LoRA 加载器加载到扩散模型上,控制节点位于文本编码与采样器之间。start_percent 和 end_percent 对应模型卡的 color_end 和 depth_end,因此文档中针对合成输入建议的 0.5、针对描摹真实照片所得地图建议的 1.0,可以直接换算为节点取值。
这个机制值得了解,因为它解释了文件格式。适配器把模型的 video_embedder 输入从 128 通道扩展到 384 通道:前三分之一为带噪的 FLUX.2 VAE latent,第二个三分之一为颜色图 latent,第三个三分之一为深度图 latent。该 PR 为 MOSS-Image 模型类新增了 concat_cond,对节点传入的内容进行上采样、追加到噪声之后,并在缺少某张图时以零 latent 替代,因为对线性 embedder 而言,零输入恰好就等于"无控制"。PR 还在 lora_convert.py 中新增了转换,把扩展后的 video_embedder 键转为替换型补丁而非增量补丁,因为该 embedder 是被替换而不是被微调。
逐区域提示词是一条早于该 PR 的独立路径:MOSS-Image Layout Prompt 根据 Create Bounding Boxes 创建的边界框构建布局 JSON,每个框的说明文字即其提示词。适配器模型卡建议把控制图与这些逐区域提示词配合使用,公布的示例也是这样采样的。
该支持在 v0.42.1 标签之后才合并,因此已发布的安装需要比该标签更新的构建版本。
模型卡中的设置
| 设置 | 值 | 原因 |
|---|---|---|
| 适配器模型 | moss-control.safetensors | 10,000 步,即推荐的那一个 |
strength | 1.0 | 训练时的强度;0.0 等于不使用这些图 |
end_percent(3D 人体模型图) | 0.5 | 控制先驱动布局和姿态,然后释放 |
end_percent(来自真实照片的图) | 1.0 | 全程保持控制 |
| 区域提示词 | 每种颜色一个 | 没有它们,人体模型形状的图就会被画成人体模型 |
更早的模型是结束比例的替代方案:2,500 步对图的遵循更宽松,看起来不那么像人体模型;7,500 和 10,000 步则遵循得更严格。四个都在仓库中。
就速度而言,文档给出的搭配是同一作者的 4 步 rapid-moss 适配器,来自 darask0/MOSS-Image_4-step_adapter_lora,本站已于 10 月 17 日报道。模型卡称在 RTX PRO 6000 上配合它时,每张 1024² 图像约需 1.8 秒。
训练方式
查看 safetensors 头部可得到 526 个张量:全部 42 个 DiT 层的 q、k、v、o、ffn_up_gate 和 ffn_down 上的 rank 64、alpha 64 的 LoRA 对(252 对),两个文本编码器块上每块五个投影(10 对),以及替换式的 video_embedder 权重和偏置。
训练在 MOSS-Image Base transformer 上进行,以 FP8 冻结,embedder 扩展至 384 输入且其控制列零初始化。数据为 10,000 张 Krea 2 Turbo 图像,属 1024 级分辨率,覆盖五种宽高比及其说明文字;颜色图来自在 COCO 全景分割上运行的 Mask2Former Swin-L,深度图来自 Depth Anything V2 Large。优化器为 AdamW,学习率 1e-4,embedder 控制列使用 10 倍学习率,批大小 1,10,000 步,单张 RTX PRO 6000 上每步 0.8 秒,采用 MOSS 的 logit-normal 时间步分布,10% 空说明文字。配置和训练脚本随权重一同发布。
值得了解的局限
模型卡对不奏效之处写得异常直白:
- 人体模型外观。 对 3D 渲染图全程保持控制会复现渲染图的木质或金属表面,因为训练用的深度来自照片。
- 姿态精度比图更粗。 手指和面部是生成的,不是投影出来的。
- 仅靠控制不足以确定布局。 在漫画颜色图上,从 7,500 步起就会丢失分格结构并使文字错乱。
- 在作者的 Hayate 运行时中组合受限。 模型卡说明该适配器在 Hayate 中无法与图生图或图像修复同时使用,只能选其一。
- 风格先验是照片式的。 训练数据是 Krea 2 Turbo 的输出。
- 没有基准测试。 模型卡称只用少量场景和两个随机种子进行了评估。
该适配器也不是 OpenMOSS 的官方发布:权重、训练代码和参考运行时都来自一位作者,只有核心支持是经过 ComfyUI 维护者审核的部分。
获取方式
- 适配器:darask0/MOSS-Image-color-depth-control,四个模型,上传一周后约有 30 个点赞。
- ComfyUI 核心:PR #17206,2026 年 10 月 19 日合并,位于 v0.42.1 版本之后。
- 速度搭配:darask0/MOSS-Image_4-step_adapter_lora。
- 基础模型:MOSS-Image-Base 和 MOSS-Image-SFT,单文件 ComfyUI 权重位于 Comfy-Org/MOSS-Image。
评论
使用 GitHub 登录后即可参与讨论。