MOSS-Image Edit HQ v5 发布,提供两种 ComfyUI LoRA 格式
社区版 MOSS-Image 编辑 LoRA 更新至 v5,采用掩码损失、256 token 参考预算与两种 ComfyUI 格式,并附评估网格、演示 Space 和完整配方。
MOSS-Image 是 OpenMOSS 的 5B 文本与版式模型,发布时我们做过报道,两周后它通过一个 rank-64 社区适配器获得了指令编辑能力。那个适配器是 chinoll/Moss-Image-Edit,而它留下的疑问是:编辑能力究竟有多少来自那一份训练数据。MOSS-Image-Edit-HQ 用另一批数据重建这项能力,并与原始版本对比测量,给出了回答。
v5 到底改了什么
这个仓库是一份包含五个训练分支的记录,而不是一次发布。每个分支都从上一个检查点继续训练,每一个都连同样本保留在磁盘上,因此差异可以被检视,而不是仅凭声称。
| 分支 | 数据与改动 | 结果 |
|---|---|---|
| v1 | warm-start 加从零训练,多参考数据,1024px | 未通过评估门槛,chinoll 的身份保持更好 |
| v2 | OmniEdit 精修数据行,lr 1e-5,300 步 | 被 v3 取代 |
| v3 | ConceptEdit-12M 精修数据行筛选至 6,000 条,700 步 | 被 v4 取代 |
| v4 | 移除、人脸与环境数据,4,644 条,使用 inverted_mask_prior 的掩码损失 | 被 v5 取代 |
| v5 | 5,644 条含完整场景描述的数据,像素差分掩码,掩码损失,256 token 参考预算,1,200 步 | 当前模型 |
v5 最重要的改动是参考预算。基础 MOSS-Image 给参考图像 144 个 token;这一分支将其提升到 256,据称身份与细节方面的提升正来源于此。v5 的其余部分是数据工作:像素差分掩码让未编辑区域保持接近来源图像,以及从 ConceptEdit 元数据折叠出的完整场景描述,使指令描述整个画面而不只是编辑内容。
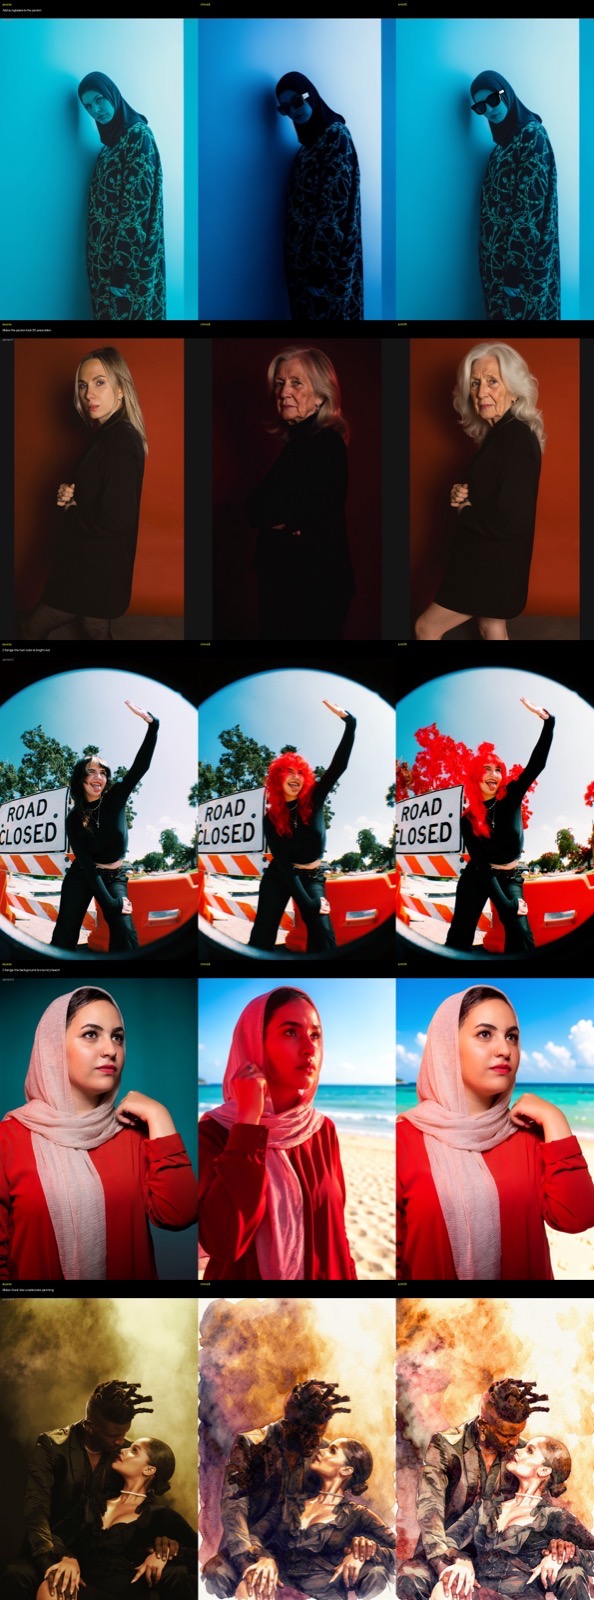
每一行从源图开始,随后是 v5 的输出。来源:akhaliq/MOSS-Image-Edit-HQ
每个模型文件为 peft 格式,大小 495 MB,包括最终版以及第 250、500、750 和 1000 步。训练在 ai-toolkit 上进行,提交为 14f8f95,每个分支使用单张 GPU,文本编码器冻结,1024px 下必须启用梯度检查点。训练数据也已公开:6,000 条筛选后的 ConceptEdit-12M 数据行,以 TAR 分片形式提供,各分支的配置位于仓库中。
两条 ComfyUI 路径,两种 LoRA 布局
这次发布需要稍作研读,原因是同一份权重以两种布局提供,通过不同的 ComfyUI 机制加载。
原生路径把 weights/armV5/armV5.safetensors 当作普通 LoRA 使用:放进 models/loras/,在 UNet加载器之后添加一个 LoRA 加载器,并使用实验性的 文本编码 MOSS-Image 编辑 节点进行编码,将 edit_format 设为 ai-toolkit。参考图像在进入文本编码器之前会缩小到最大 384x384。
插件路径使用 armV5-moss-edit-lora.safetensors,它需要放在 models/model_patches/,并通过 Chenkin-x/ComfyUI-Moss-Image-Edit 加载,也就是更早那个适配器所用的同一个节点包。该节点包要求 ComfyUI 0.42.3 或更新版本。
原生路径仅在当前 master 构建中可用。Kijai 的 PR #17296 于 10 月 22 日合并,加入了编辑节点,但最新的正式发布版本,也就是 10 月 23 日的 v0.42.5,仍然附带不含该节点的旧版 comfy_extras/nodes_moss_image.py,因此已发布的安装版本必须更新到每夜版才能使用 edit_format = ai-toolkit。两个工作流都已填好文件名和设置,一个面向单参考,一个最多支持四参考。
| 设置 | 值 |
|---|---|
| 采样器 | Euler,flow matching |
| Shift | 5.0 |
| 步数 | 50(质量模式),搭配 DMD 加速栈时为 8 |
| CFG | 3.0,编辑效果弱时提高到 3.5 或 4.0 |
| SLG 层 | 22 |
| 参考尺寸 | 源分辨率进入编码器,最大 384x384 |
| 输出 | 最高 1024px |
ai-toolkit 布局与更早适配器使用的 Moss-Image-Edit 布局并不相同,模型卡对此有明确说明:chinoll 的适配器使用分离的 q、k、v 键,而 ai-toolkit 将它们融合,因此要从一方 warm-start 另一方,需要做精确的 rank-192 块对角融合。仓库提供了转换器,并报告转换后 336 个张量中有 336 个匹配。
哪里更快,哪里不快
将编辑 LoRA 与 8 步 DMD 加速 LoRA 叠加,可将采样降至 8 步、CFG 1,编辑速度约提升六倍。模型卡自己的结论是 50 步仍然胜出:8 步时对象添加会变弱,颜色约束也会退化,因此快速路径适合打草稿。
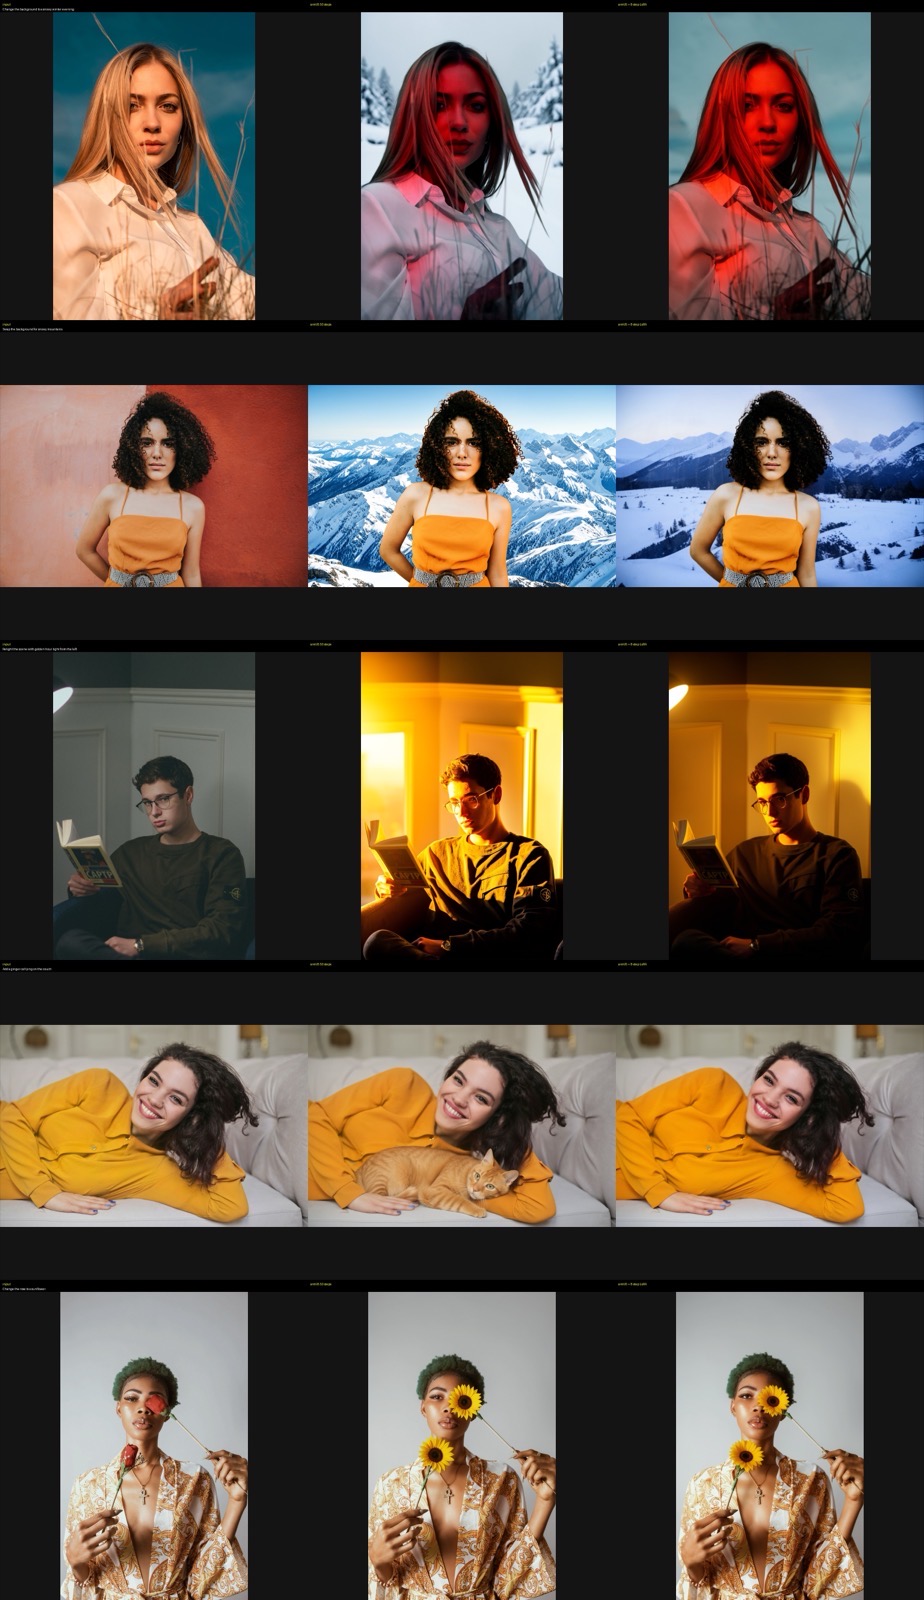
依次为输入、50 步结果、8 步 DMD 加速栈结果。来源:akhaliq/MOSS-Image-Edit-HQ
v5 展示视频,每次编辑一条指令,使用演示的 50 步与 CFG 3 设置渲染。
这种坦诚同样适用于对比结果。项目的既定目标是在质量上超过 chinoll/Moss-Image-Edit,而 v1 分支在身份保持方面公开未能通过这一门槛,之后的几个分支才转向掩码损失。公开的网格将 v5 与更早的适配器以及 Krea 2 对比,但这些是作者自己的评估集和一个演示 Space,而非第三方基准测试。
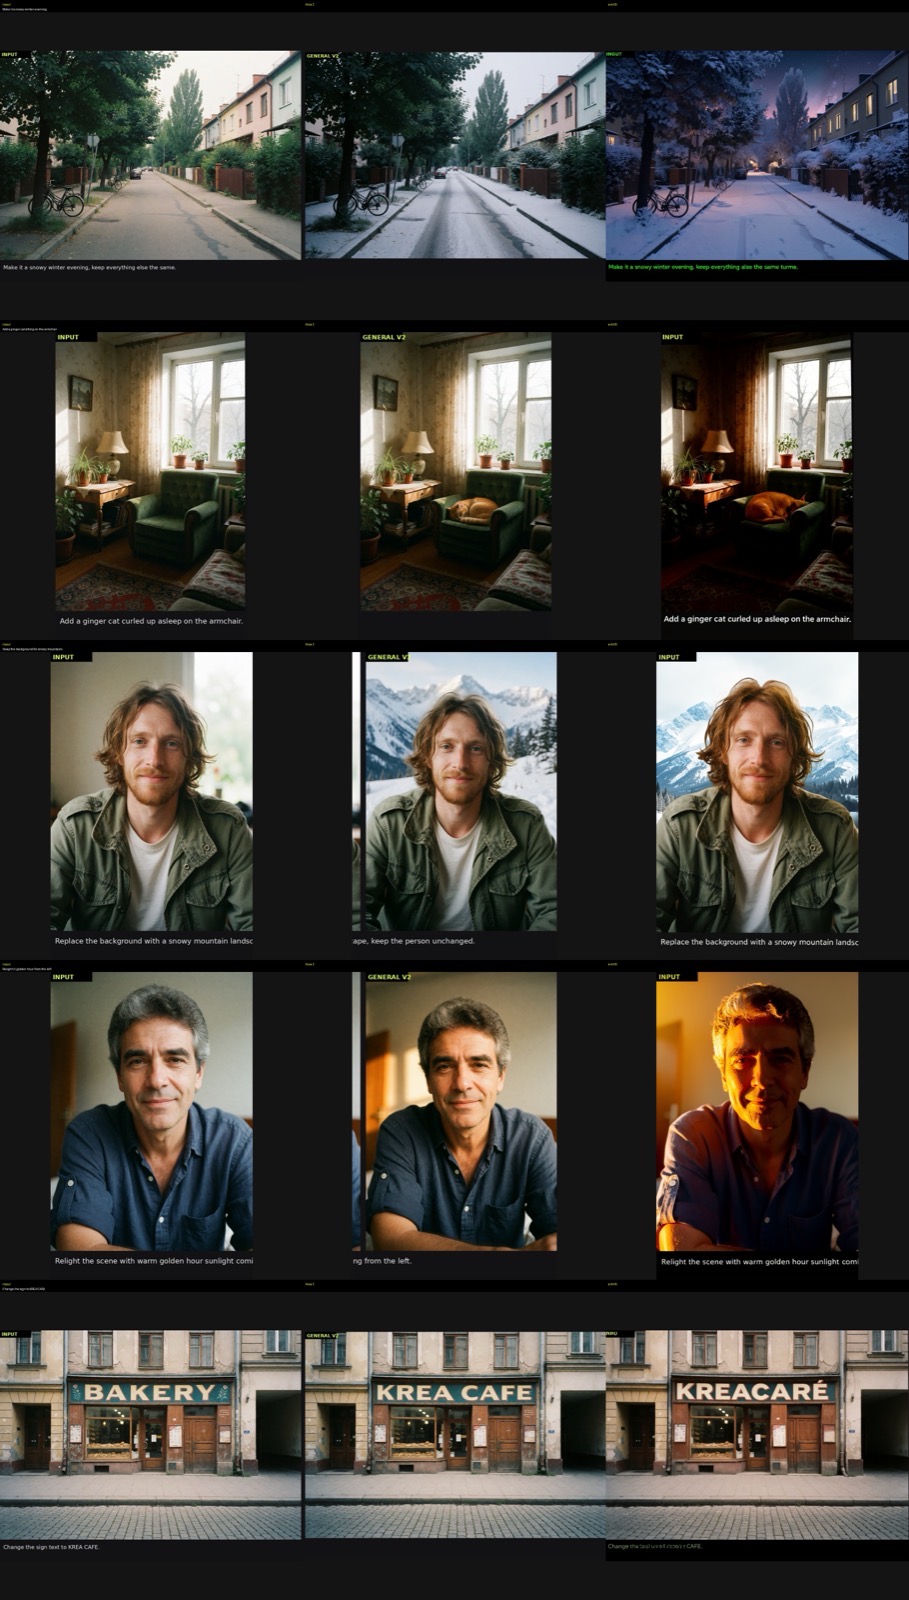
对 Krea 2 展示提示词执行 v5 编辑,旁边是 Krea 2 参考渲染图。来源:akhaliq/MOSS-Image-Edit-HQ
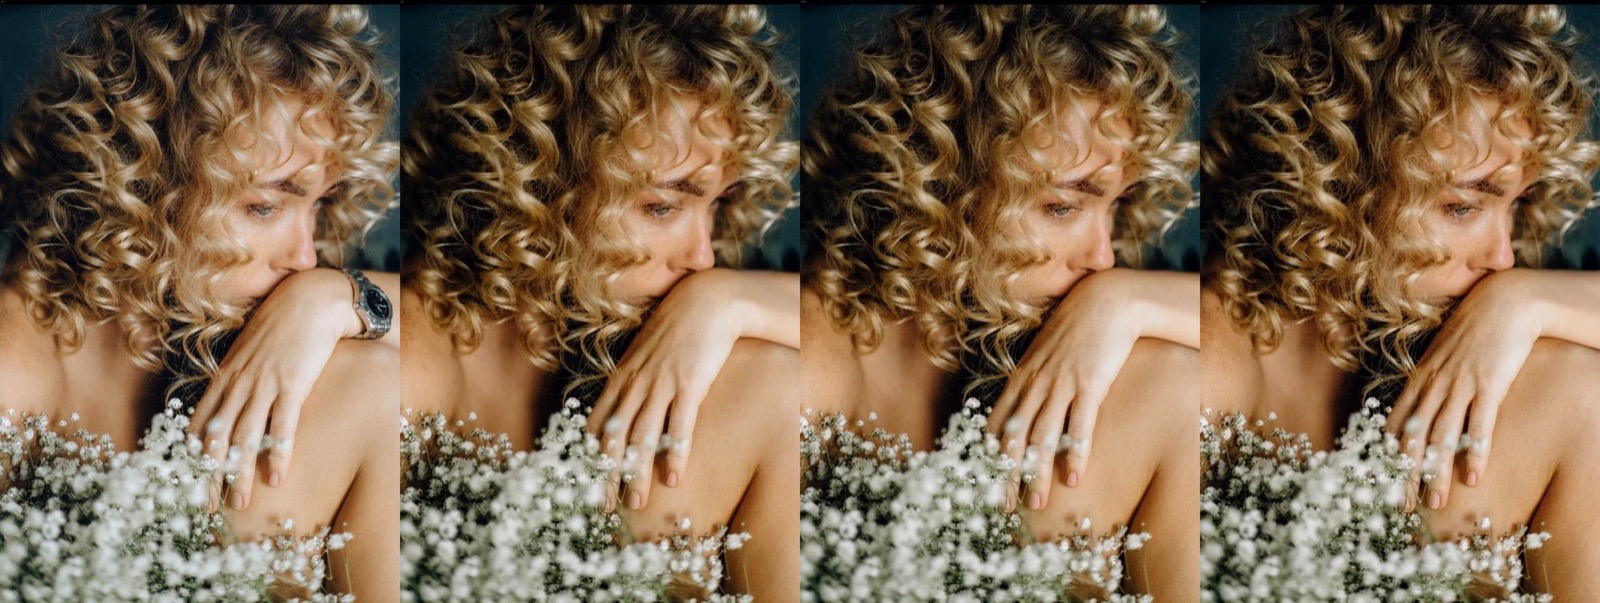
仓库中的对象移除案例。来源:akhaliq/MOSS-Image-Edit-HQ
为了方便快速试用,模型卡还给出了一个 Gradio 演示 Space 的链接,同时提供质量模式和 8 步模式,便于在下载 495 MB 之前先验证这种取舍。
值得了解的局限
- 显存: 该 pipeline 在 bf16 下需要约 20 GB。模型卡直接回答了那个显而易见的问题:不行,它无法在 6 GB 上运行,即使使用基础模型的 int8 社区构建版本也不行。
- 基础模型: 它基于 MOSS-Image-SFT 训练。与 Base 和 Kromoss 的兼容性标注为未经验证,原生路径被描述为可靠的那一条。
- 单参考训练: 架构最多接受四个参考,但适配器是在单参考编辑对上训练的。把一张照片中的人物或对象合成到另一张里,明确不是它的训练目标。
- 颜色: 用户曾在模型卡上反馈 v3 存在把饱和度推得高于来源的已知特性,v4 的掩码损失已针对这一点。
- 范围: 属性、移除、光照、人脸与文字编辑。发布说明完全没有提到姿态改动,而这恰恰是公告下第一条评论所要求的。
以上都不是 OpenMOSS 的发布。权重、数据、评估网格和演示都出自同一位作者,模型卡也直言这一点。
获取方式
- LoRA: akhaliq/MOSS-Image-Edit-HQ,v5 于 2026 年 10 月 25 日发布。
- 工作流:
armV5_workflow_single.json和armV5_workflow_multi.json。 - 演示: Hugging Face Spaces 上的 moss-image-edit-hq-demo。
- ComfyUI 核心: PR #17296,2026 年 10 月 22 日合并,仅限 master 与每夜版。
- 节点包: Chenkin-x/ComfyUI-Moss-Image-Edit,需要 ComfyUI 0.42.3 或更新版本。
- 训练数据与代码: moss-image-edit-conceptedit-packed 以及仓库的
training/目录。
评论
使用 GitHub 登录后即可参与讨论。