MOSS-Image Edit LoRA 为 ComfyUI 带来指令编辑能力
一个 rank-64 的编辑 LoRA 让 MOSS-Image 获得基于指令、支持一到四张参考图像的编辑能力,ComfyUI 核心也在同一天合并了原生编辑 LoRA 支持。
MOSS-Image 是 OpenMOSS 的 5B 文本与排版模型,本站曾在发布时报道:清晰的文字、JSON 布局框,以及同一周内发布的 ComfyUI 核心实现。它缺少的正是拿一张已有图像去修改的能力。编辑意味着布局编辑或控制适配器,而不是“给这个人换一件夹克”。
新的适配器填补了这一空白。它是社区发布,而非 OpenMOSS 官方发布,但它正是 ComfyUI 维护者围绕其接入核心支持的实现。
LoRA 改变了什么
模型卡直白地描述了适用范围:颜色、服装、光照、季节和视觉风格,由一条文本指令和最多四张参考图像驱动。指令说明要改什么,参考图像承载要保留什么。
随 LoRA 发布的案例网格图。来源:chinoll/Moss-Image-Edit
使用多张参考图像时,每张图像都必须在指令中被指明,因为适配器本身不会分配角色。节点包的示例提示词是 Dress the person in image 1 in the outfit from image 2.
从机制上看,这个适配器小巧且常规。检查 safetensors 头部可得到全部 42 个 DiT 层中的 504 个 tensor,每层六个投影(q、k、v、o、ffn_up_gate、ffn_down),rank 为 64,alpha 为 64。其 adapter_config.json 声明了 moss-edit-lora 格式版本 1,并把训练约定记录为 ref-prefix-only-t0__target-text-original-moss-v1,这正是 ComfyUI 现在以 Moss-Image-Edit 为名实现的布局。
同一份权重可配合 MOSS-Image-Base 或 MOSS-Image-SFT 使用;Base 保留更多训练信号,SFT 则是更整洁的起点。模型卡中的示例均以 SFT 为对象进行训练和采样。
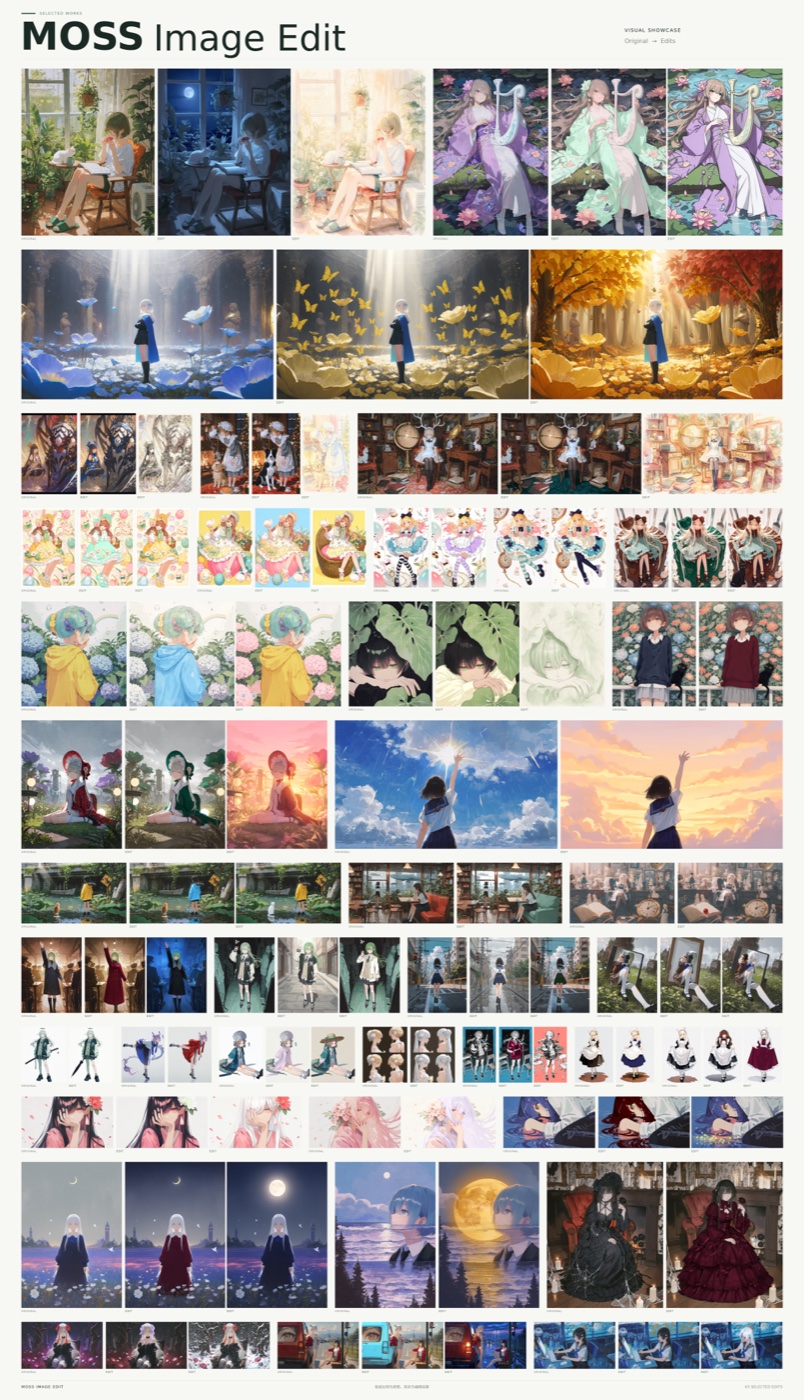
项目仓库中的编辑展示:每组以源图像开头,随后是其编辑结果。
ComfyUI 核心路径
Kijai 的 PR #17296 新增了 Text Encode MOSS-Image Edit 节点,仍标记为实验性,位于 model/conditioning/moss_image 下。它接收 clip、prompt、vae、edit_format 选项,以及一组可自动增长的图像。edit_format 选择器是有意思的部分,因为它体现了编辑 LoRA 之间并不通用这一事实:
| 选项 | 参考布局 | 文本编码器能否看到参考图像 |
|---|---|---|
ai-toolkit | index_timestep_zero_isolated | 能,以 Picture N: 为前缀 |
ai-toolkit (kv_cache off) | index_timestep_zero | 能,且参考图像在每一步都对已生成图像做注意力 |
Moss-Image-Edit | index_timestep_zero_text_start | 不能 |
对于 Moss-Image-Edit 布局,视觉塔从不接收参考图像,因此指令必须自行描述编辑内容;外观完全来自注入 DiT 的参考 Latent。对于用 ai-toolkit 训练的适配器,参考图像会被缩小到最大 384×384,并作为 Picture N: token 前置到提示词中。
该适配器通过标准 LoRA 加载器加载,因为该 PR 为这些文件所使用的裸 layers.N.proj.q 键风格添加了别名。也就是说,原生路线就是普通的 MOSS-Image 节点图,配合来自 Comfy-Org/MOSS-Image 的单文件权重,外加一个 LoRA 加载器和新的文本编码节点;参考图像以图像形式连接到该节点,而不是单独的 Latent 输入。
该 PR 还报告了一项速度修复而非新功能:对于隔离布局,参考图像的每块 K/V 只在 extra_conds 中计算一次,而不是每一步都计算,这使得 1024² 输出配 1 MP 参考图像的情况从每步 826 ms 降到 457 ms。该支持在 v0.42.1 标签之后合并,因此已安装的发布版需要更新到该标签之后才能使用。
节点包路径
同一位作者还提供了一个自包含的节点包 Chenkin-x/ComfyUI-Moss-Image-Edit,于 10 月 22 日出现,在 MOSS Image Edit 类别下新增了加载器和编辑节点。它运行自己的一份 MOSS 运行时,而不是核心节点,并且需要完整的 Diffusers 快照,而非单文件重新打包版本:
ComfyUI/models/moss_image/
├── MOSS-Image-SFT/          # pipeline_moss_image.py, transformer/, text_encoder/, tokenizer/, vae/, scheduler/
└── Moss-Image-Edit/         # adapter_config.json, adapter_model.safetensors
加载器的 snapshot_dir 指向基础模型,adapter_dir 指向适配器。随包附带两个工作流,一个用于单张参考图像,一个用于两张;要扩展到三张或四张,需向空闲的 reference_3 和 reference_4 输入添加 Load Image 节点。文档给出的默认值为:输出 512×512、30 步、CFG 4.0、inference_shift 5.0,参考图像长边 512 且不裁剪。
| 设置 | 默认值 | 说明 |
|---|---|---|
width / height | 512 / 512 | 16 的倍数 |
reference_max_edge | 512 | 对齐到 16,从不裁剪 |
steps | 30 | |
cfg | 4.0 | |
inference_shift | 5.0 | 采样时间分布 |
seed | 42 | 默认固定 |
参考图像如何进入 DiT
两条路线都依赖同一个技巧。参考图像被 VAE 编码为 Latent token,在自身 RoPE 索引处以时间步零追加到图像序列,并且只彼此做注意力。由于这些 token 在采样循环中从不改变,它们的每块 K/V 可以缓存一次并重复使用,这正是为什么一个没有训练文本编码器的 rank-64 适配器足以在指令改写其余内容的同时保持身份一致。
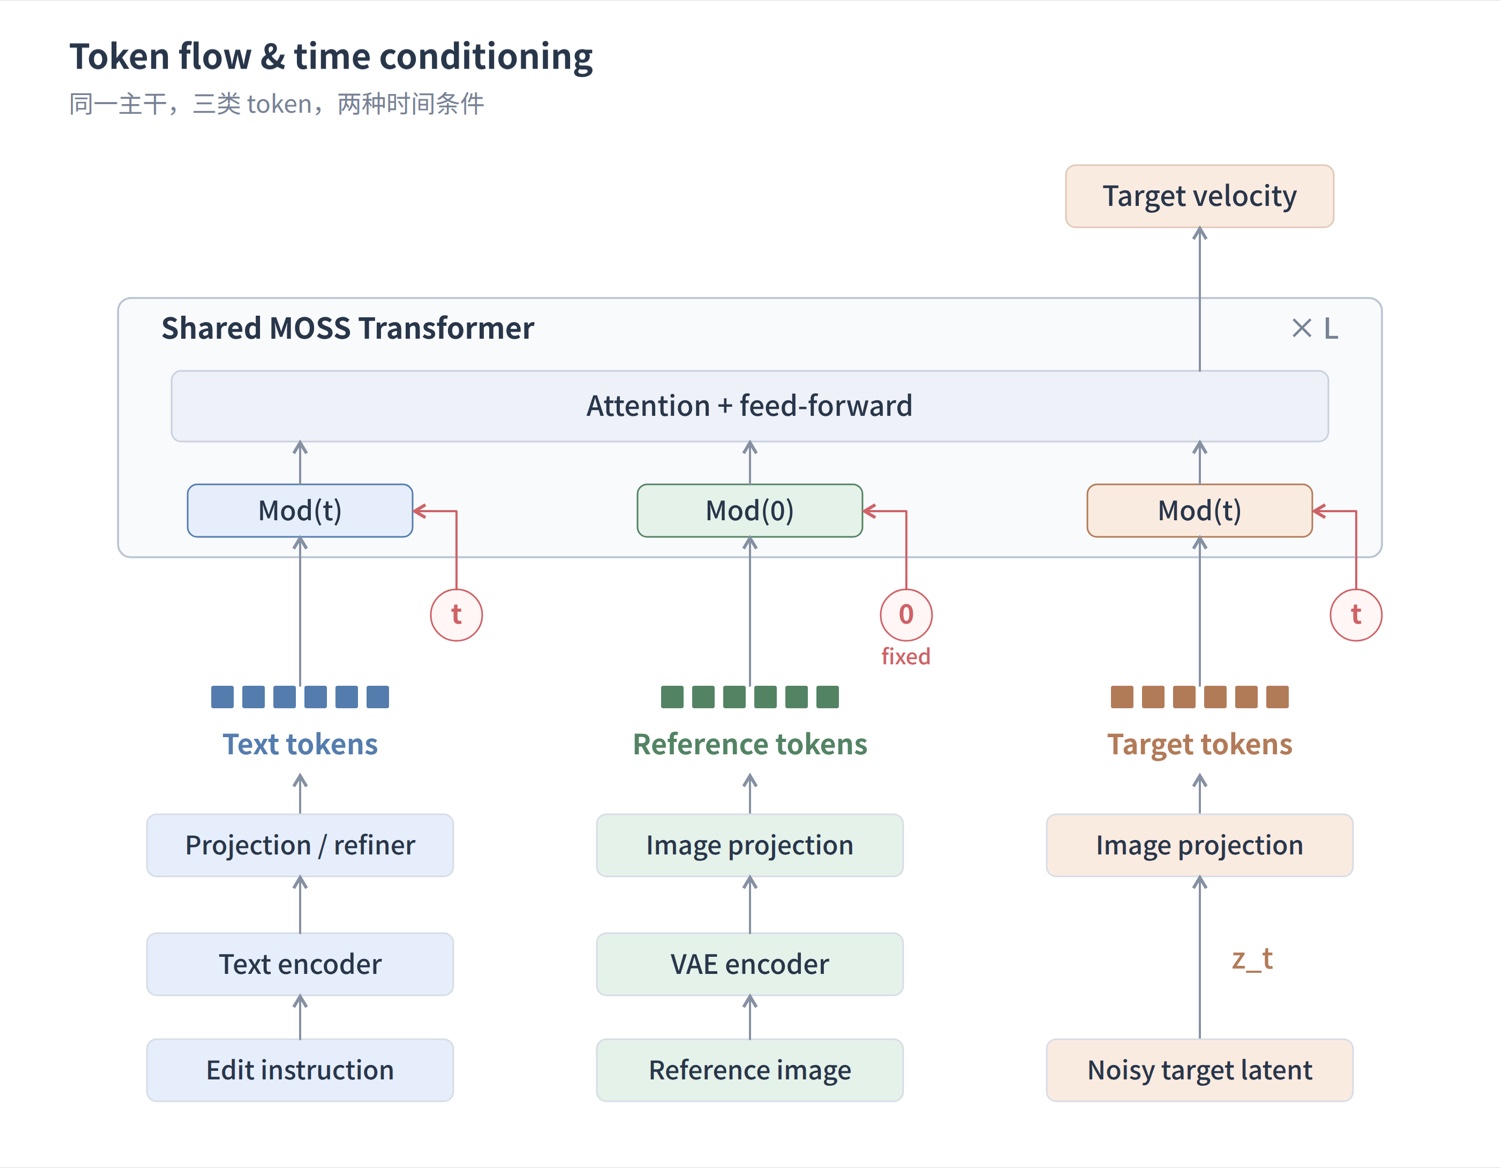
来自训练仓库的参考 KV 缓存示意图,展示缓存的参考块与已生成 token 并列。
训练仓库公布了整套流程而非仅有权重:数据准备、配置和推理脚本。训练数据是 NOOB2 配对数据加上 ConceptEdit-12M 数据集,指令取自 instruction.detailed_en,源图像与编辑后图像由 VAE 一起编码,两张图像都会缩放使长边保持在 max_edge 以内,且不裁剪、不填充。指南使用四进程 torchrun 启动,通过打过补丁的 adjust_lr_fn 在 ZeRO-2 上使用 DeepSpeed Muon,使用带 varlen 打包的 Flash Attention 4,训练期间文本编码器量化为 int8。验证样本按步写出,并附上已生成/源/目标三元组,因此仓库中的 checkpoint 可以复现或扩展。
值得了解的局限
该 LoRA 是一个 297 MB 的 bf16 适配器,相对基础模型很小,但它不是通用编辑器。公布的范围是属性与场景编辑:颜色、服装、光照、季节和风格,外加表情。模型卡未记录对象插入,未发布基准测试,也未声称能把两个主体合成到一个场景中。如前所述,多参考编辑依赖提示词来分配角色。这也不是 OpenMOSS 的官方发布:权重、节点包和训练代码全部出自同一位作者,只有核心 PR 经过了 ComfyUI 维护者的审查。
获取方式
- LoRA: chinoll/Moss-Image-Edit,截至撰写时(上传一天后)约有 21 个 like。
- ComfyUI 核心: PR #17296,于 2026 年 10 月 22 日合并,晚于 v0.42.1 发布。
- 节点包: Chenkin-x/ComfyUI-Moss-Image-Edit,包含单参考与多参考工作流。
- 训练与推理代码: Chenkin-x/Moss-Image-Edit,包含
prepare_data.py、configs/train.json和infer.py。 - 基础模型: MOSS-Image-Base 和 MOSS-Image-SFT,单文件 ComfyUI 权重位于 Comfy-Org/MOSS-Image。
评论
使用 GitHub 登录后即可参与讨论。