KohakuMoss:MOSS-Image LoRA 训练与 ComfyUI 导出
KohakuMoss 0.1.0 支持在 MOSS-Image-Base 和 SFT 上训练 LoRA、LyCORIS 或进行全量微调,6 GB 显卡即可运行,并以 ComfyUI 的键名布局导出适配器。
KohakuMoss 是面向 MOSS-Image-Base 和 MOSS-Image-SFT 的微调框架,于 2026 年 10 月 18 日以 0.1.0 版本发布到 PyPI。它由 LyCORIS 的作者 KohakuBlueleaf 开发,填补了 MOSS-Image 工具链中模型发布和社区少步适配器都未覆盖的部分:以原生分辨率在你自己的图像上训练,然后导出一份 ComfyUI 无需转换步骤即可加载的文件。
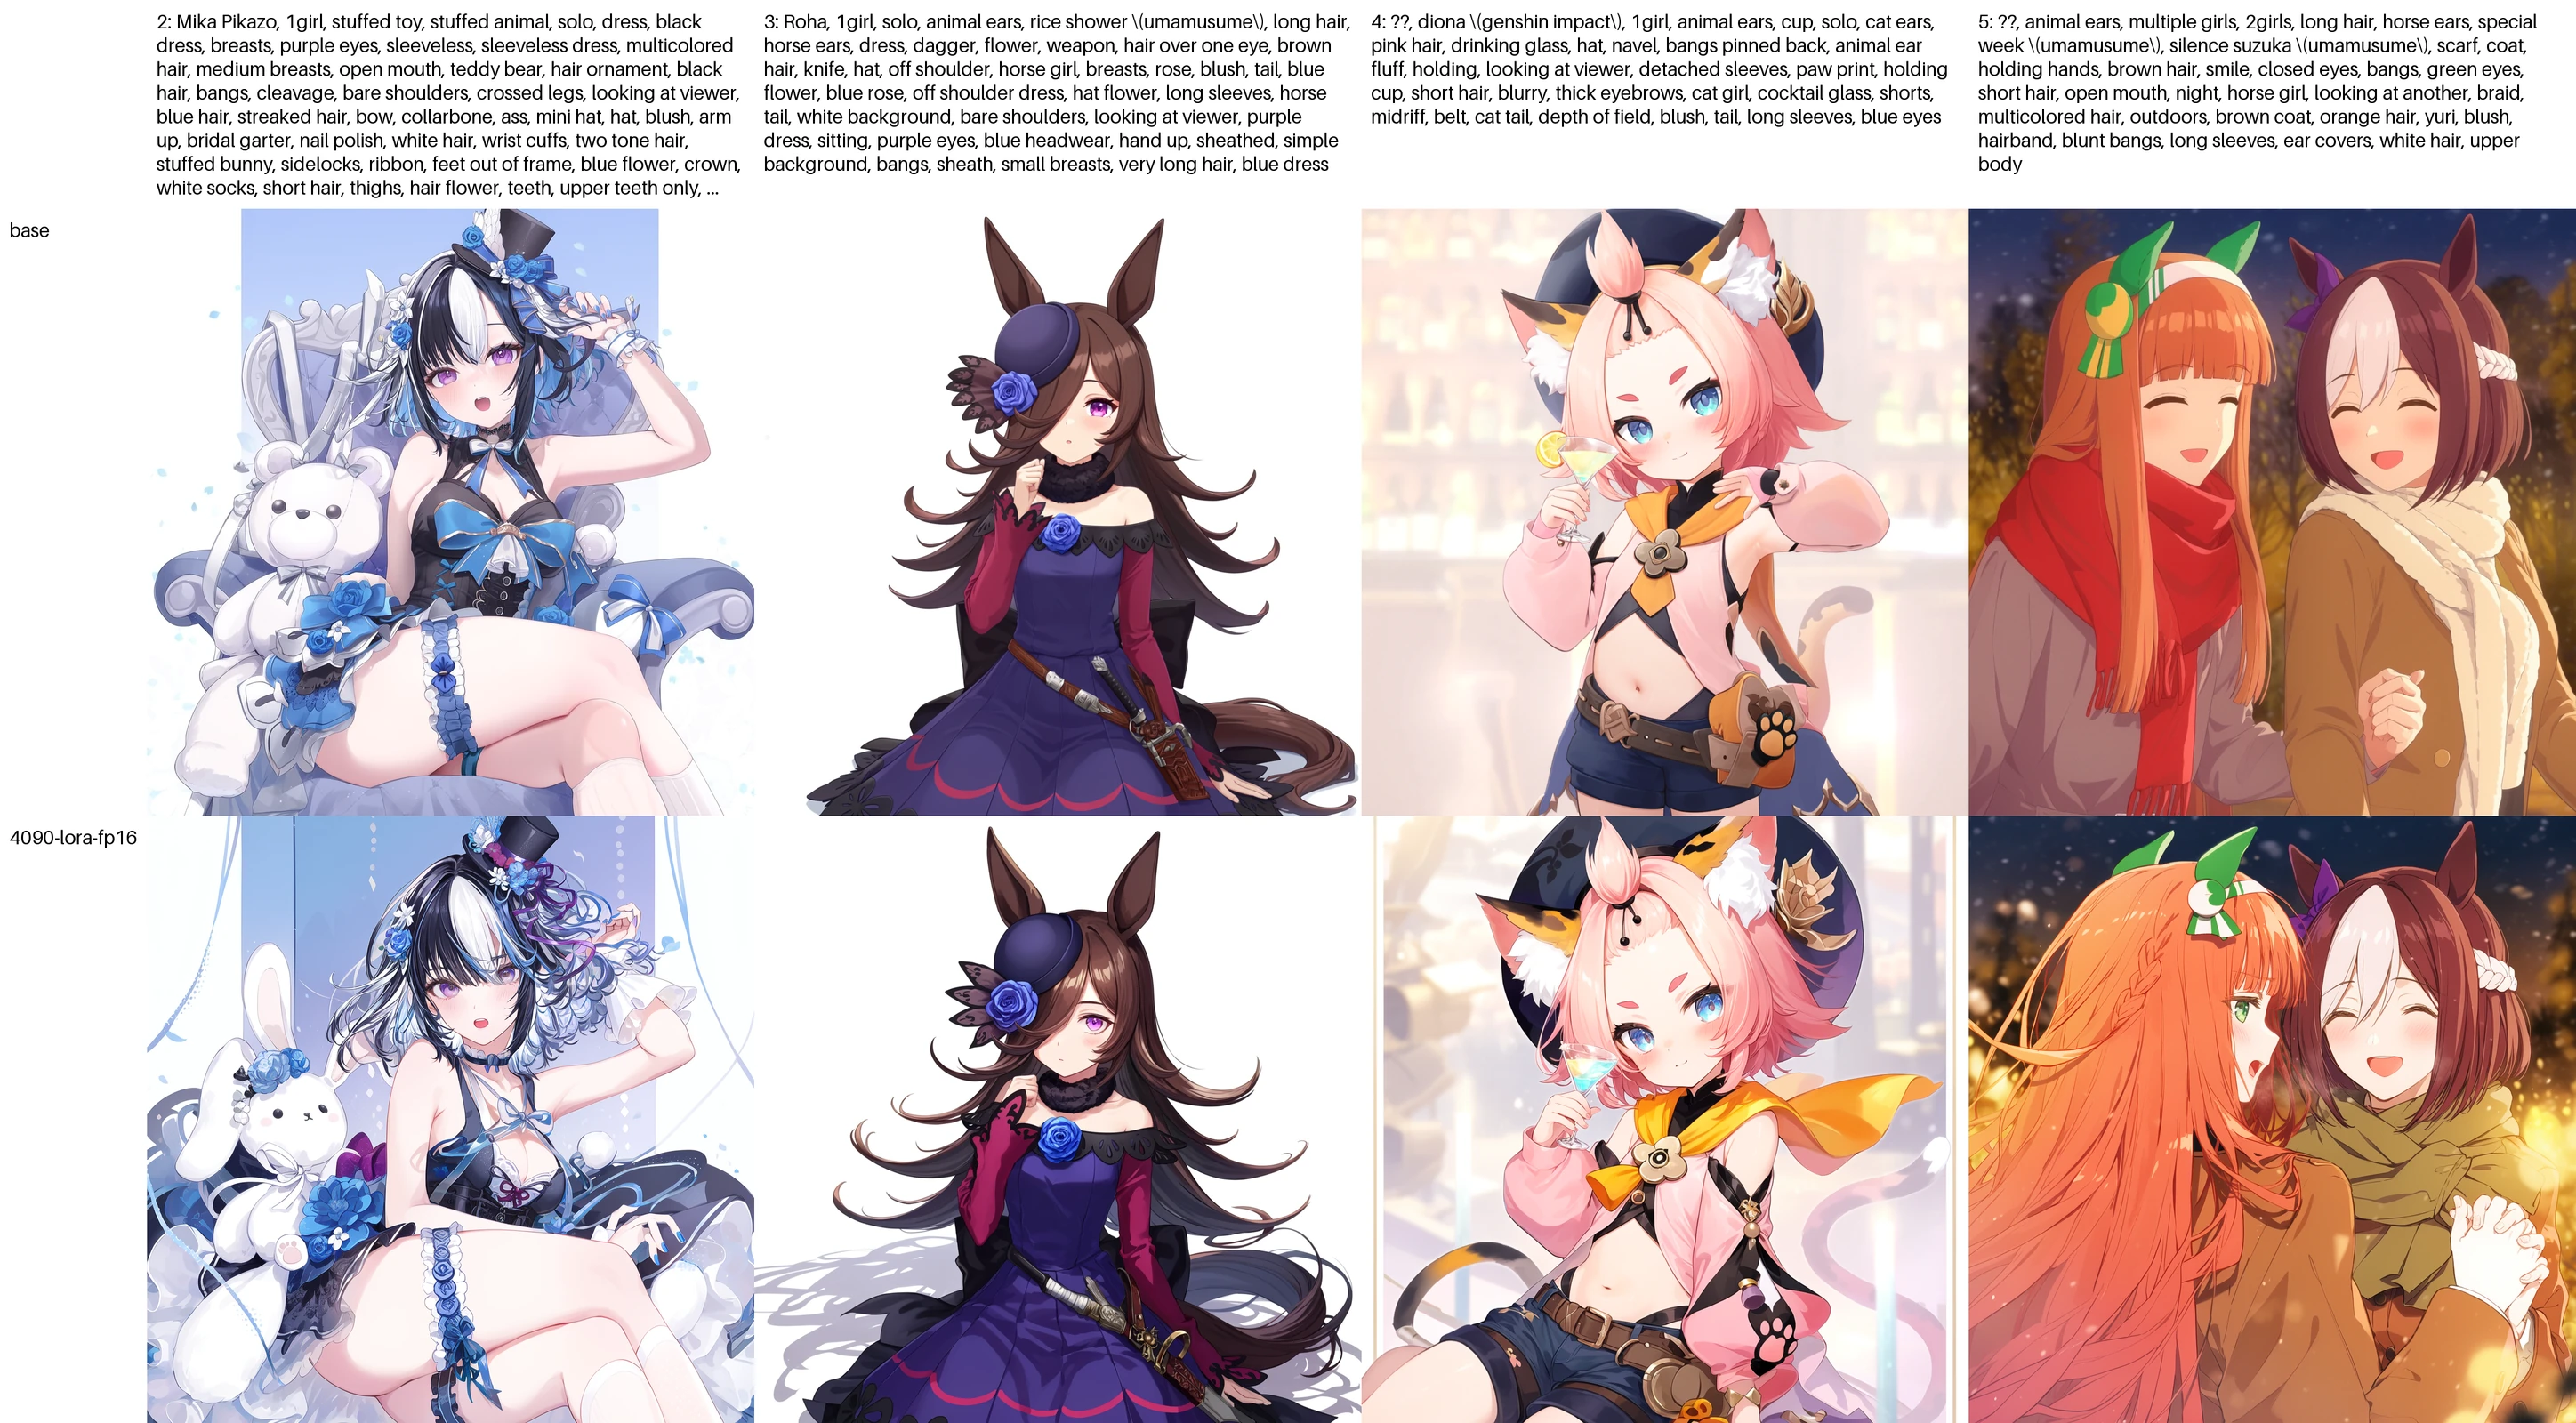
它填补的空白
MOSS-Image 于 10 月 16 日发布,带来两个模型、布局控制以及当天的 ComfyUI 支持,社区 4 步和 8 步 LoRA 也在一天之内跟进。但两者都没有提供针对这个特定 5B 扩散 Transformer 及其 Qwen3.5-9B 文本编码器的训练器。通用扩散训练器假定的是 UNet 或 Flux 形态的结构;MOSS-Image 需要自己的打包注意力和自己的键名。KohakuMoss 两者都提供:一套独立的 MOSS-Image 实现、LyCORIS 适配器集合、数据管线,以及在单张显卡上运行它们所需的内存方案。
适配器与全量微调
适配器训练覆盖 LoRA 与 LoCon、LoHa、LoKr、DoRA、OFT、BOFT、GLoRA、IA3、DyLoRA 和 T-LoRA,全部通过 LyCORIS 实现,因此其算法、保存格式和融合 kernel 都原样沿用。Dropout、LoRA+、绕过后合并的前向以及目标模块预设都是设置项,而不是独立脚本。
全量微调同样受支持,按 MOSS 技术报告使用 Muon 搭配 AdamW 和 EMA。它可在单张 24 GB 显卡上运行,主权重放在主机内存中,因此代价是系统内存而不是再加一块 GPU。
在 6 GB 上运行
内存管理由一组分层机制而非单一开关处理:块检查点、权重流式加载、激活值卸载、梯度卸载,以及主机上的优化器状态。四个命名档案从 speed 覆盖到 minimal,kohakumoss-config 会根据检测到的显卡自动选择其一,底层还有一份包含 240 个条目的目录供手动调优。适配器训练可下探到 8 GB 显卡,而在 Latent 和文本缓存都离线构建时,6 GB 档位也能装下。24 GB 显卡仍然覆盖全量微调场景。
精度跟随硬件:支持时使用 bf16,较老显卡使用带残差修正的 fp16,sm89 及更新架构在训练和推理中均可对 DiT 和文本编码器使用 fp8 与 MXFP8 计算,冻结的基础模型可选用 int8 或 fp8 纯权重量化。
按架构选择的 kernel
项目自带 kernel,而不是依赖单一技术栈:sm70 和 sm75 使用 TileLang,sm80 及更新架构以及 Intel Arc 使用 Triton,两者背后都有 torch.compile 和 eager 模式兜底。Varlen 注意力、块操作和融合线性层各自按架构、dtype 和形状选择后端,在显卡上测量一次后存入调优表,因此同一份安装在 V100 和 RTX 5090 上会得到不同的调优结果。
模型实现使用打包的变长批次:一条扁平 token 轴,注意力保持在每个样本内部。与官方代码相比,项目报告的 fp32 前向相对误差为 4.7e-6,50 步采样的 LPIPS 为 2.3e-6。
数据与续训
输入格式包括 kohya 风格文件夹、jsonl、parquet、webdataset 和原生分片,并带有增量目录,首次扫描后即缓存。调整大小、分桶和裁剪规划器可处理原生分辨率图像,token 批处理保持步数均匀,Latent 和文本缓存既可离线构建,也可在训练过程中填充。采样计划是数据、随机种子和设置的纯函数,因此续训的运行会重放同样的顺序,而不是近似它。
多 GPU 仅支持 Linux:在所有内存档案下都支持 DDP(包括权重流式加载)、FSDP2、流水线以及线程化流水线。
导出到 ComfyUI
导出这一步才是它不只是一款训练器的原因。一次运行可以产出 LyCORIS 文件、合并后的模型、diffusers Transformer,或者按 ComfyUI 自身的 MOSS-Image 键名布局编写的 ComfyUI 格式适配器,其中包括针对其融合 q/k/v 投影的重打包。该文件放入 models/loras,即可在普通 ComfyUI 工作流中加载,因此在这里训练的 LoRA 不需要第三方节点或转换 notebook。导出同样适用于任何已保存的检查点,而不只是最后一步。
实测速度
发布表格报告的是在 balanced 档案下对 MOSS-Image-Base 进行 1 MP 训练、使用 rank 32 LoRA 的结果。在 RTX 5090 上,无缓存时达到每秒 1.01 个样本,同时启用 Latent 和文本缓存时为 1.14;RTX 4090 从 0.49 提升到 0.73,RTX 3090 从 0.31 提升到 0.39。这些行中大多数单步峰值占用约 6.6 GiB 的 torch 分配内存,而 5090 的数据还包含一个常驻的 15.6 GiB 文本编码器,这正是它无缓存数字反而更快的原因。
README 中的示例更接近真实的首个项目:在 fp8 基础模型上训练 rank 8 的 fp16 风格 LoRA,100 步、每步约 20k token,采用激进的 ckpt-ring4-actoff 档案,并在每一步在线进行文本编码器和 VAE 编码。在单张 RTX 4090 上它占用 12 到 13 GB,产出约每秒 0.85 张图像。
配置
每个脚本都是 KohakuEngine 脚本,因此设置项是模块级旋钮,一份配置可以层层叠加预设。kohakumoss-config 会为检测到的 GPU 和数据集写出经过校验的配置,kohakumoss-config wizard 则询问 GPU、算法、数据和权重,而不需要传参,像 lora_24g_bf16 这样的固定配方可以用列出的每一个旋钮进行扩展。
可用性与许可证
KohakuMoss 位于 github.com/KohakuBlueleaf/KohakuMossTrainer,可通过 PyPI 以 kohakumoss 安装。安装辅助脚本会检测驱动、选择匹配的 torch 索引,然后运行 kohakumoss-doctor,报告任何缺失项以及修复它的指令。需要 Python 3.10 或更新版本,以及 CUDA 12.6 或更新版本或 Intel Arc 驱动;Windows 需要 Visual Studio Build Tools,sm70 和 sm75 显卡需要 CUDA toolkit 以提供 nvcc。
许可证为 KohakuMoss License 1.0:Apache 2.0 加一条附加条款,即基于 KohakuMoss 构建的衍生作品、软件包、产品或服务必须在其名称中包含 "Kohaku"。使用该框架训练或生成的模型、适配器和图像明确不在此条款范围内,因此用它产出的 LoRA 或模型可以由作者自由命名和授权。
关于模型本身,请参阅 MOSS-Image 发布报道 以及让快速采样变得实用的 4 步和 8 步适配器。
评论
使用 GitHub 登录后即可参与讨论。