Qwen-Image-2.1 Next-Scene LoRA:链式分镜生成
akhaliq 的 Next-Scene LoRA 让 Qwen-Image 2.1 能从单帧渲染出下一个导演镜头,并通过 ComfyUI 的 LoRA 节点串联成完整分镜。
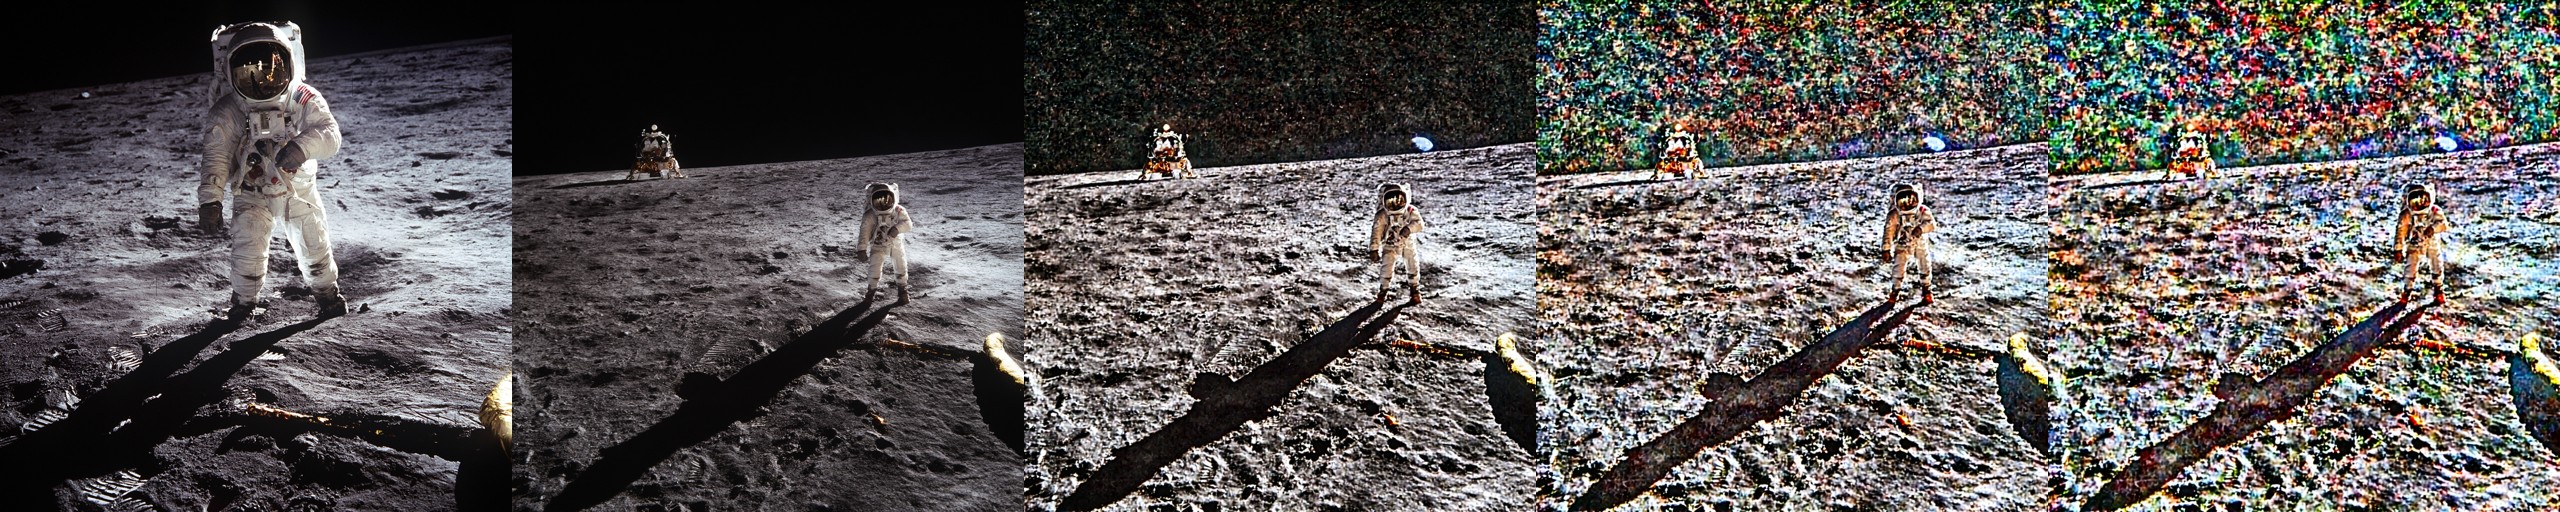
从一张照片生成四个导演镜头。每一帧都是把上一个输出配合新指令回喂得到的,使用推荐的 step-2,500 模型和强度 0.7。
它为 Qwen-Image 2.1 带来了什么
next-scene 格式来自 lovis93/next-scene-qwen-image-lora-2509,该 LoRA 在 Qwen-Image 2509 编辑模型上已获得 313,000 次下载。本次是把该能力移植到当前的基础模型上:在尚不具备此能力的 Qwen-Image 2.1 上原生重新训练。它与 akhaliq 更早的 Multiple-Angles LoRA 搭配使用:后者控制相机所处的位置,而 Next-Scene 控制故事接下来走向何方。
提示词以 Next Scene: 开头,并把相机运镜方向放在最前面,例如 "Next Scene: The camera pulls back to a sweeping aerial view, revealing the fleet behind the cliffs":
Next Scene: The camera tracks forward and tilts down as rain begins to streak the lens.
Next Scene: Cut to a low-angle shot; sunlight breaks through the clouds behind her.
Next Scene: The camera pans right, revealing the fleet massing behind the ridge.
链式生成:一份经过实测的配方
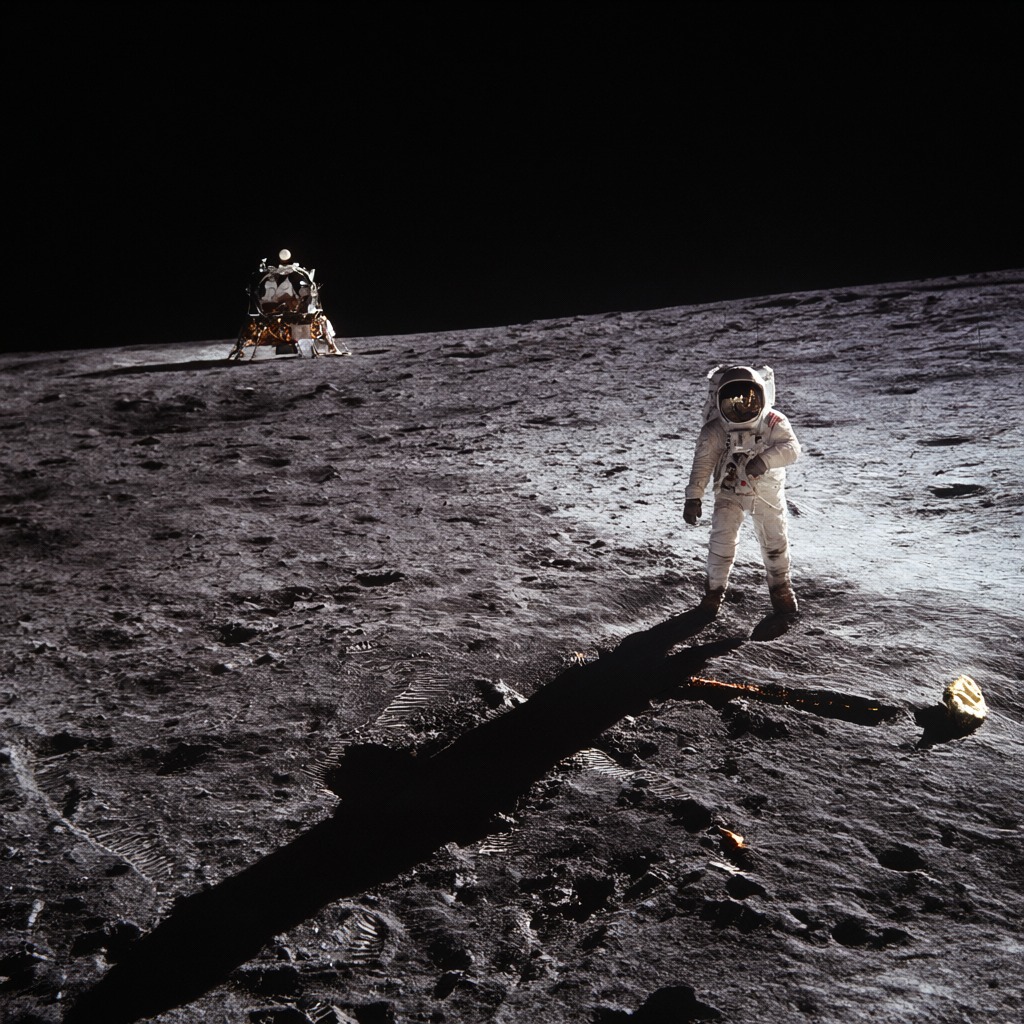
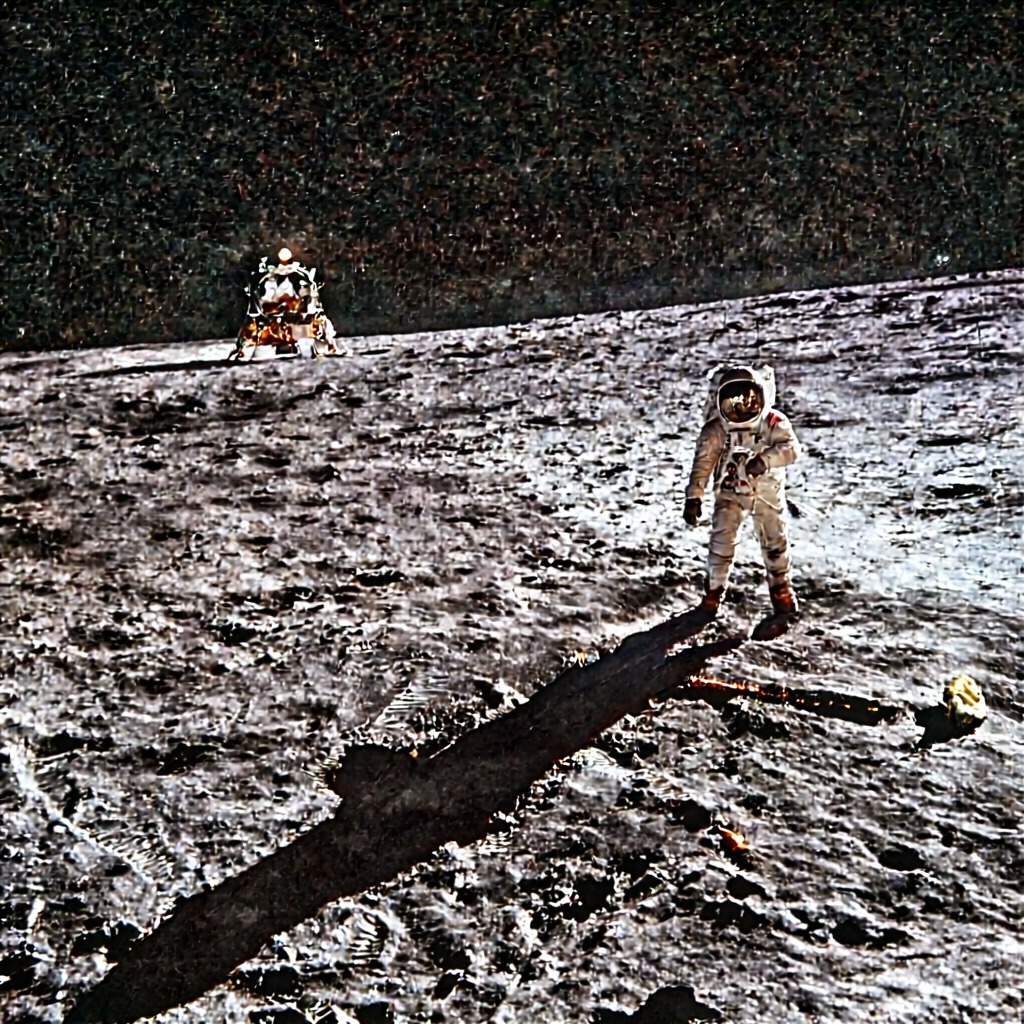
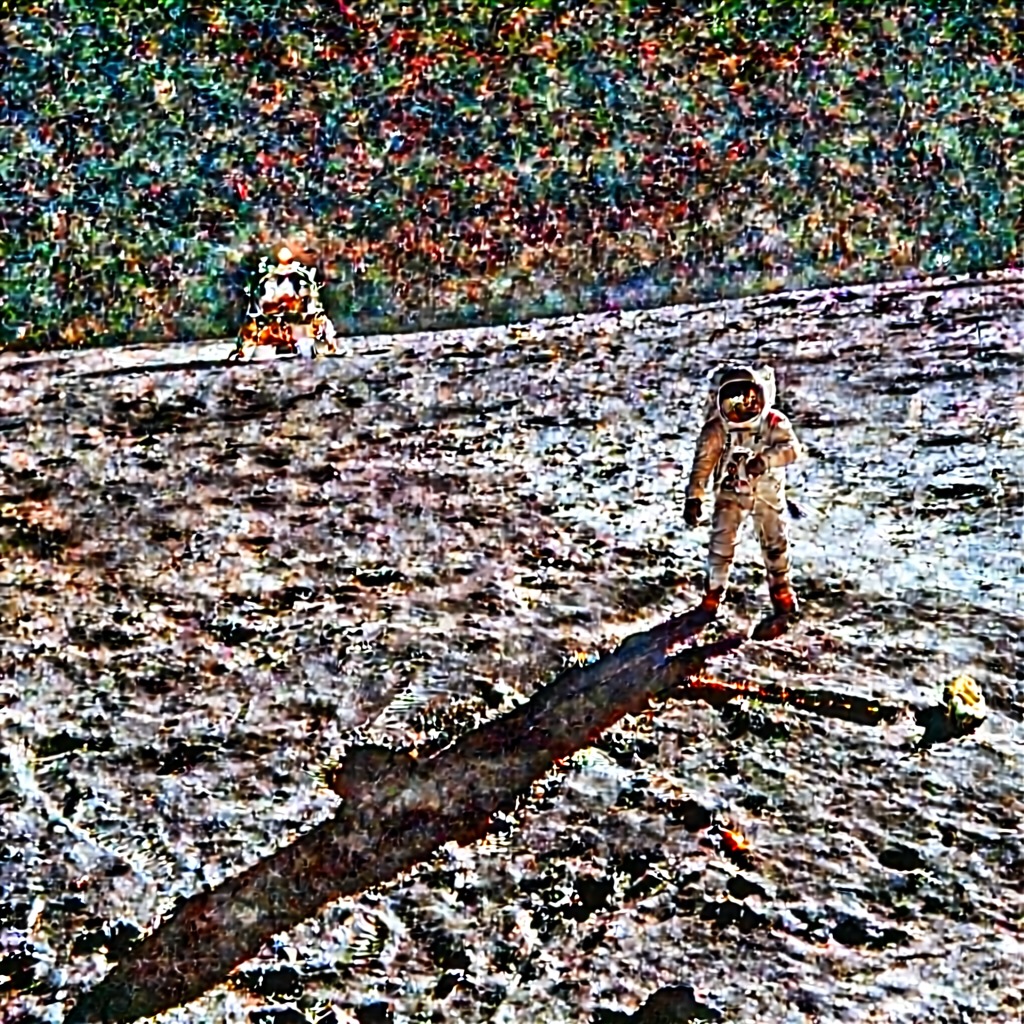
把每次输出回喂作为下一次输入,正是让这个适配器变成分镜工具的关键;不过作者并没有凭空猜测失败模式,而是实测出了一种:在强度 0.9 下进行朴素的链式生成,会不断累积胶片颗粒,到第 3 或第 4 跳时就会变成肉眼可见的彩色噪波。经过验证的干净链条配方是:强度 0.7 或更低,并对每个链式输入施加 0.5 像素的高斯模糊,以此打破颗粒放大的反馈循环。上面的四跳示例正是按这种方式渲染的。
 |  |
|---|---|
| 第 1 跳:相机后拉成全景 | 第 2 跳:向右平移,宇航员在月壤上跳跃前行 |
 |  |
|---|---|
| 第 3 跳:切到仰角镜头,宇航员正在敬礼 | 第 4 跳:推近金色面罩,其中映出登月舱 |
该使用哪个模型
仓库提供了三个转换后的模型,以及原始训练输出:
| 模型 | 结论 |
|---|---|
next_scene_step2500.safetensors | 推荐。最终步数,已转换为 diffusers 键名布局。在保持构图和人物身份的同时带来最强的场景变换。 |
next_scene_step1500.safetensors | 更柔和的替代方案,对人物身份更温和。如果 2,500 力度过强就用它。 |
next_scene_step1000.safetensors | 变换最弱,主要用于研究训练曲线。 |
checkpoints/qwen21_next_scene_v1_*.safetensors | 原始 ai-toolkit 格式。MLP 键使用 ai-toolkit 的融合命名,diffusers 会静默跳过。只能通过 ai-toolkit 或其自带加载器使用。 |
作者还发布了一组模型扫描对比:同一个风暴提示词分别使用 step 1,000、1,500 和 2,500,另附一个无 LoRA 的对照组。由于 Qwen-Image 2.1 自身编辑能力就很强,基础模型已经会尝试表现风暴,但只有 step 2,500 这一格能让整片风暴锋面席卷山谷,同时保持探险者、废墟和整体色调完好无损。
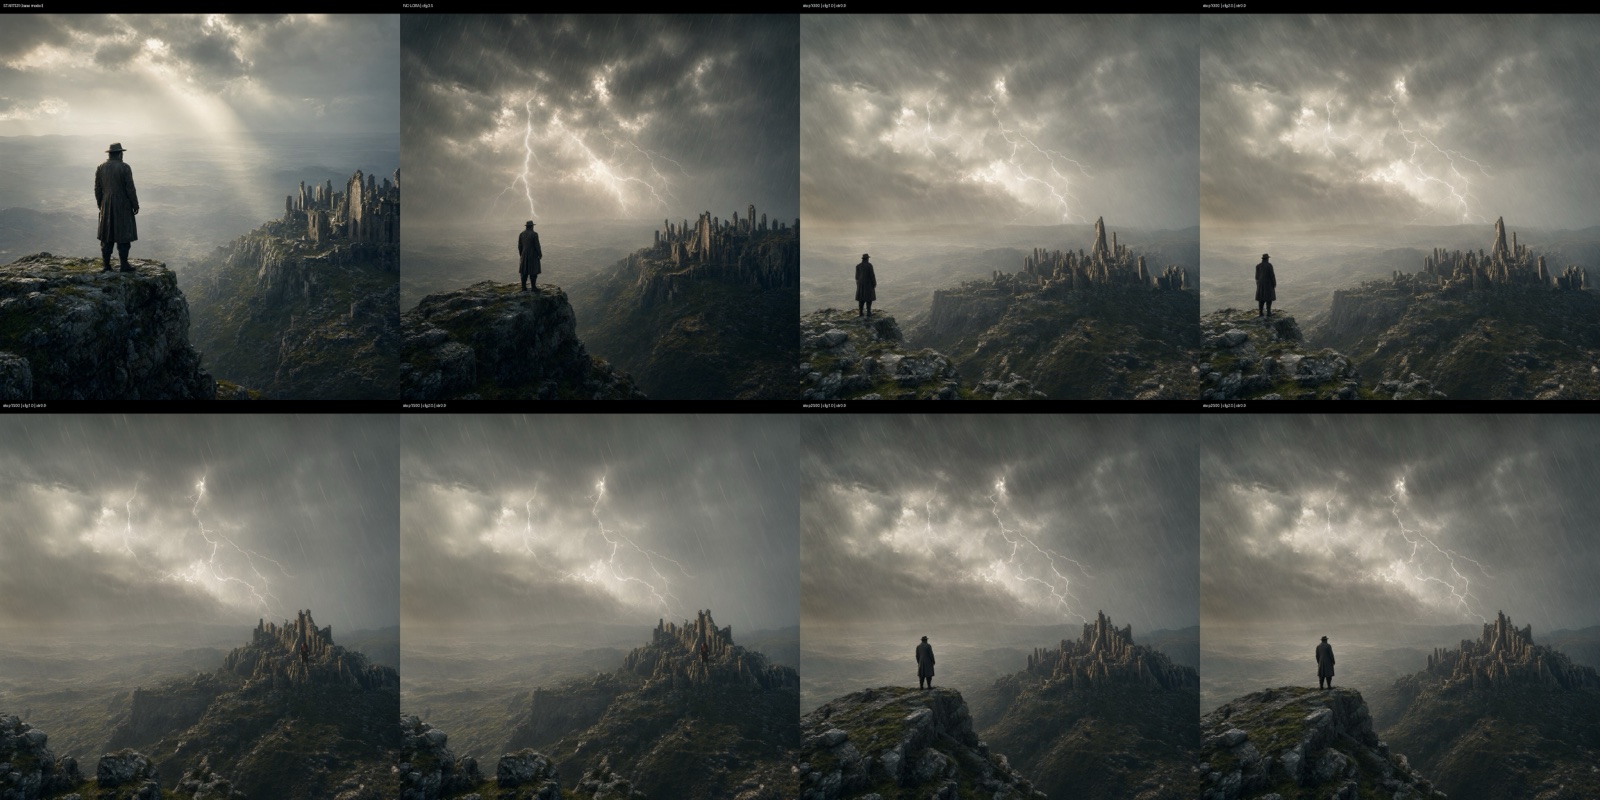
同一张电影感起始图,在每个模型上使用相同的风暴指令,另附一组无 LoRA 对照。
训练方式
- 基础模型: Qwen-Image 2.1,
arch: qwen_image_2。 - 数据: 1,144 组场景推进对,取自 Blender 开源影片 Sintel 和 Tears of Steel(CC-BY)的连续帧,由 Qwen3-VL-4B 针对每一组"当前帧到下一帧"的配对,标注为导演风格的 "Next Scene: ..." 指令。原始配对与带标注的数据集均已发布。
- 训练: ostris/ai-toolkit,rank 64 / alpha 64,adamw8bit,学习率 1e-4,加权时间步,caption dropout 0.05,512 像素,2,500 步,基于 bf16 下的 uint3 量化基础模型。
适用范围与限制
该适配器是在电影胶片帧上训练的,一部动画、一部真人实拍。它能泛化到照片,但在电影感场景、风景和定场镜头上表现最好,而静态人像按设计就不在其适用范围之内。训练在 512 像素下完成;更大的画布会继承该行为,但并非训练时见过。每 250 步的样本网格保存在 checkpoints/samples/ 中,模型卡片还链接了一个 Trackio 仪表盘和一个演示 Space。
ComfyUI 可用性
推荐的这个模型已经转换完毕,因此它可以通过 LoRA 节点以 0.7 到 0.9 的强度加载进任何 Qwen-Image 2.1 工作流,图像作为编辑输入或引用图像传入。该适配器没有单独的工作流文件;在 ComfyUI 中应使用根目录下的 next_scene_step*.safetensors 文件,checkpoints/ 里的副本是 ai-toolkit 格式。
评论
使用 GitHub 登录后即可参与讨论。