Qwen-Image 2.1 Multiple-Angles LoRA:在 ComfyUI 中从任意视角重拍物体
Akhaliq 的 Multiple-Angles LoRA 为 Qwen-Image 2.1 带来相机控制:输入一张照片,从 72 种方位角与仰角取景中任选一种,即可在 ComfyUI 中重新拍摄主体。
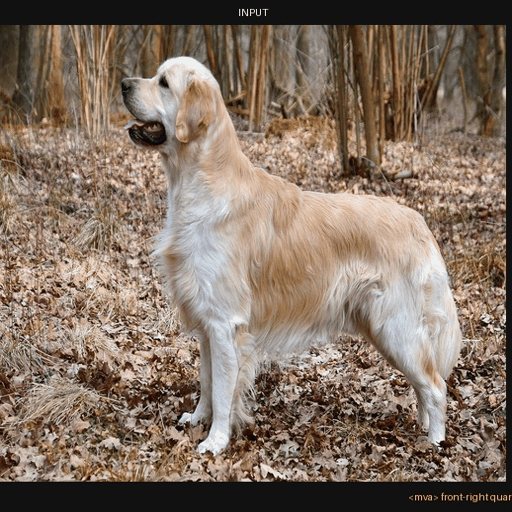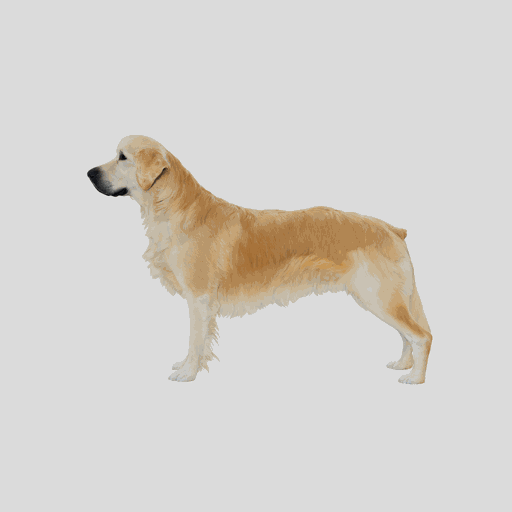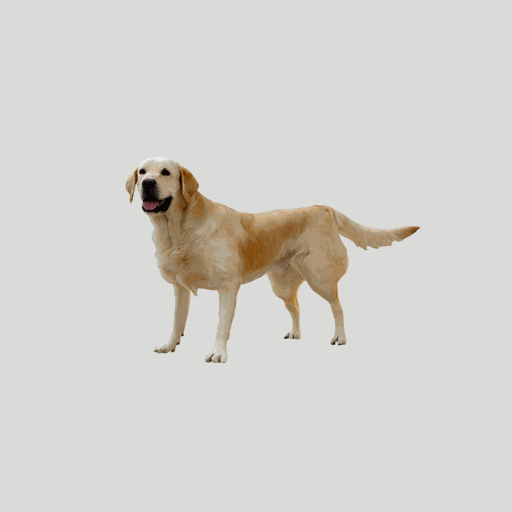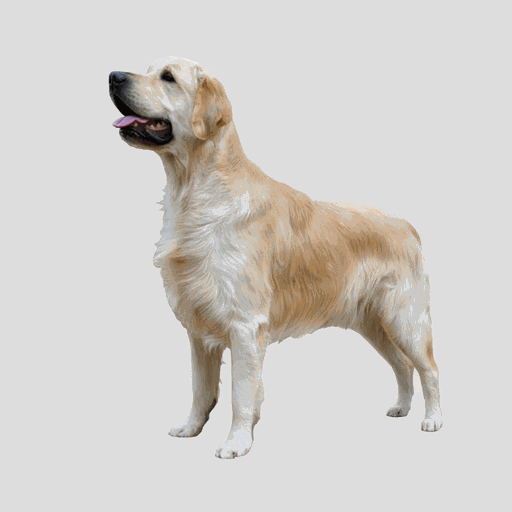
平视高度下金毛寻回犬的环绕视角,涵盖全部 12 个方位角步进,使用 v2 模型的第 1,500 步生成。
适配器带来了什么
Qwen-Image 2.1 在单一模型中同时处理生成与编辑,但并不知道相机位于何处。提示它“展示背面”通常会让主体基本停在原位。这个 LoRA 转而教会模型一套姿态字典:每条提示都以触发词 <mva> 开头,后接具名的方位角与仰角,模型移动的是相机,而不是场景。
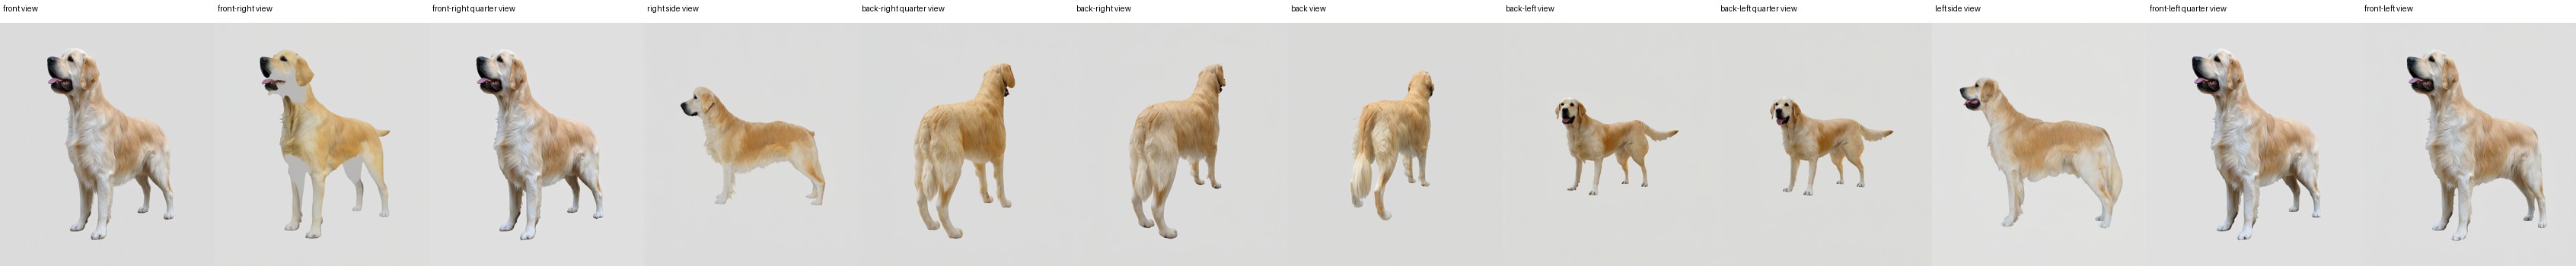
同一组环绕视角以带标注的条带形式呈现,每个方位角一帧。
语法很简短:
<mva> {azimuth}, {elevation}[ close-up]- 12 个方位角,以 30 度为步进,从正面视角经两侧一直到背面视角。
- 4 种仰角:平视、抬高(30 度)、高角度(60 度)以及俯视(90 度)。
- 每种组合都有一个
close-up变体,总计 72 种可寻址的取景。 - 在 ComfyUI 或 diffusers 中,推荐 LoRA 强度为
0.8到1.0。
在真实照片上的表现
训练集是渲染物体,但模型卡片记录了一项针对从未见过的普通照片的留出测试:来自 Wikimedia Commons 的金毛寻回犬、猫和苹果。在强度约为 1.0 时,主体会旋转到所请求的视角,场景基本得以保留,不过对于远离训练分布的物体,毛发等细节会变软。
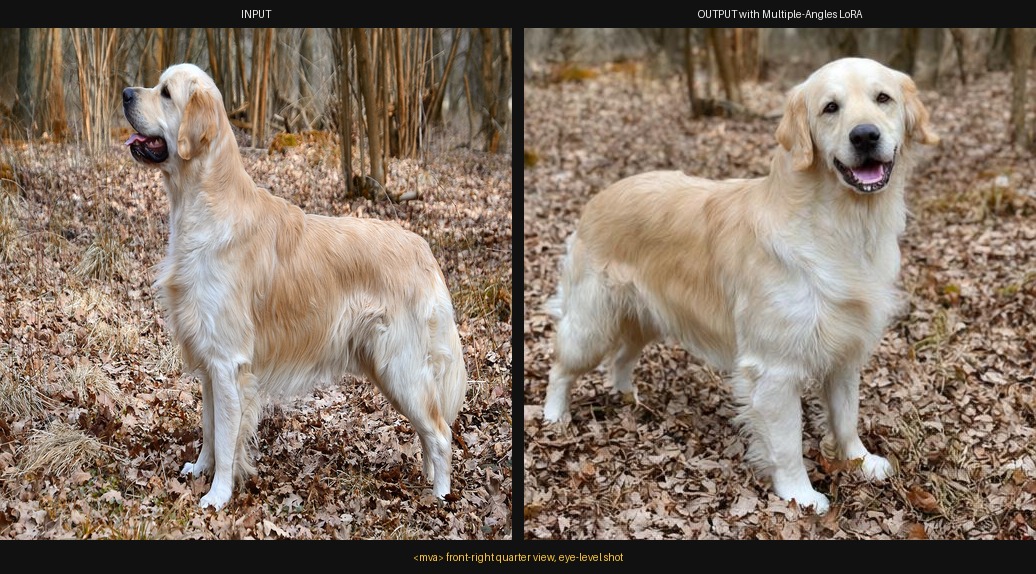 | 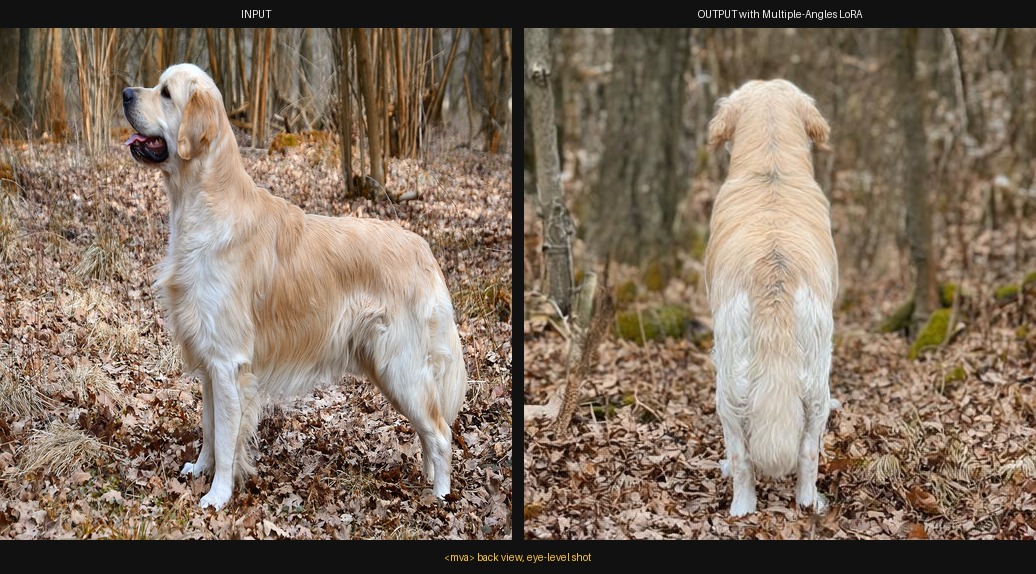 |
|---|---|
| 右前方四分之三视角,平视 | 背面视角,平视 |
卡片给出的经验法则:从强度 1.0 开始;如果重拍结果偏向于复制参考照片而不是移动相机,就把强度降到 0.8 左右,而不是更换模型。
v2 有哪些变化
第二个修订版是推荐的下载版本。它把训练对从 5,028 提升到 13,328(以角色为优先的 Dome-Objaverse 数据集,加上经过许可证筛选的绑定角色),把 rank 从 32 提升到 64,并将基础精度从 convrot int8 切换为 bf16,同时采用加权时间步采样。
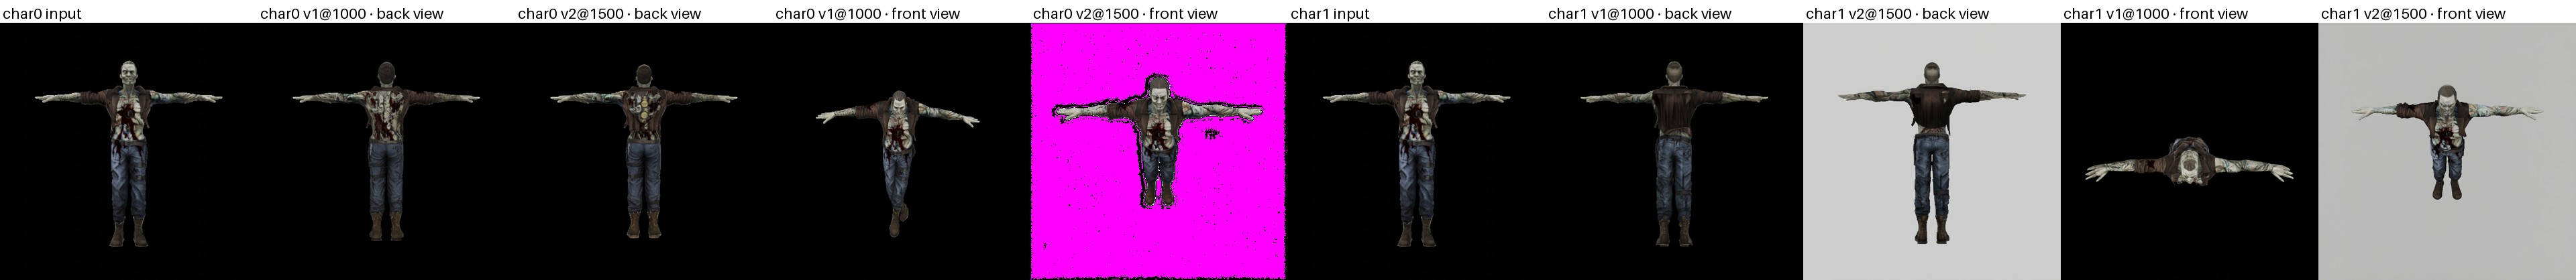
角色姿态对照表:v1 第 1,000 步与 v2 第 1,500 步的对比。
各版本之间的 <mva> 语法和姿态字典没有变化,因此为 v1 构建的工作流在替换文件后仍可继续使用。卡片推荐 v2 训练的第 1,500 步(rank 64、完整精度,checkpoints_v2/ 中约 319 MB);v1 文件仍位于 checkpoints/ 中,其中第 1,000 步是最佳选择。
在 ComfyUI 中运行
这个适配器就是普通的 LoRA,因此不需要任何自定义节点包:把 .safetensors 放进 ComfyUI/models/loras/,然后用标准 LoRA 加载器与 Qwen-Image 2.1 扩散模型、其文本编码器和配套 VAE 一起加载。卡片推荐强度为 0.8 到 1.0;没有适配器专用的采样器或 CFG 值,因此沿用基础模型自身的设置。
基准测试:如实说明
卡片公布了一个包含 144 个用例的留出基准(24 个未见过的物体,每个 6 种姿态),使用 CLIP 图像-图像余弦相似度与真实圆顶渲染结果进行评分,并如实报告:未适配的基础模型平均得分实际上略高(0.857 对比 0.832),因为该指标主要衡量整体图像相似度,而不是相机是否发生了移动。作者指出,正确的评估方案是姿态检索准确率,这还需要再进行一次渲染;他们让读者把匹配提示的 A/B 图像作为该能力本身的主要证据。
获取方式
权重: akhaliq/Qwen-Image-2.1-Multiple-Angles-LoRA
基础模型: Qwen/Qwen-Image-2.1
训练数据(v2): akhaliq/qwen21-multiple-angles-train-v2
基础系列页面: Qwen-Image 2.1
评论
使用 GitHub 登录后即可参与讨论。