SnapRef: адаптер референса с кэшем KV для Anima в ComfyUI
SnapRef v1a удерживает персонажа Anima по одному референсному изображению, кэшируя ключи и значения внимания, за 8,9 с на изображение. Включены узлы ComfyUI и веса FP8.
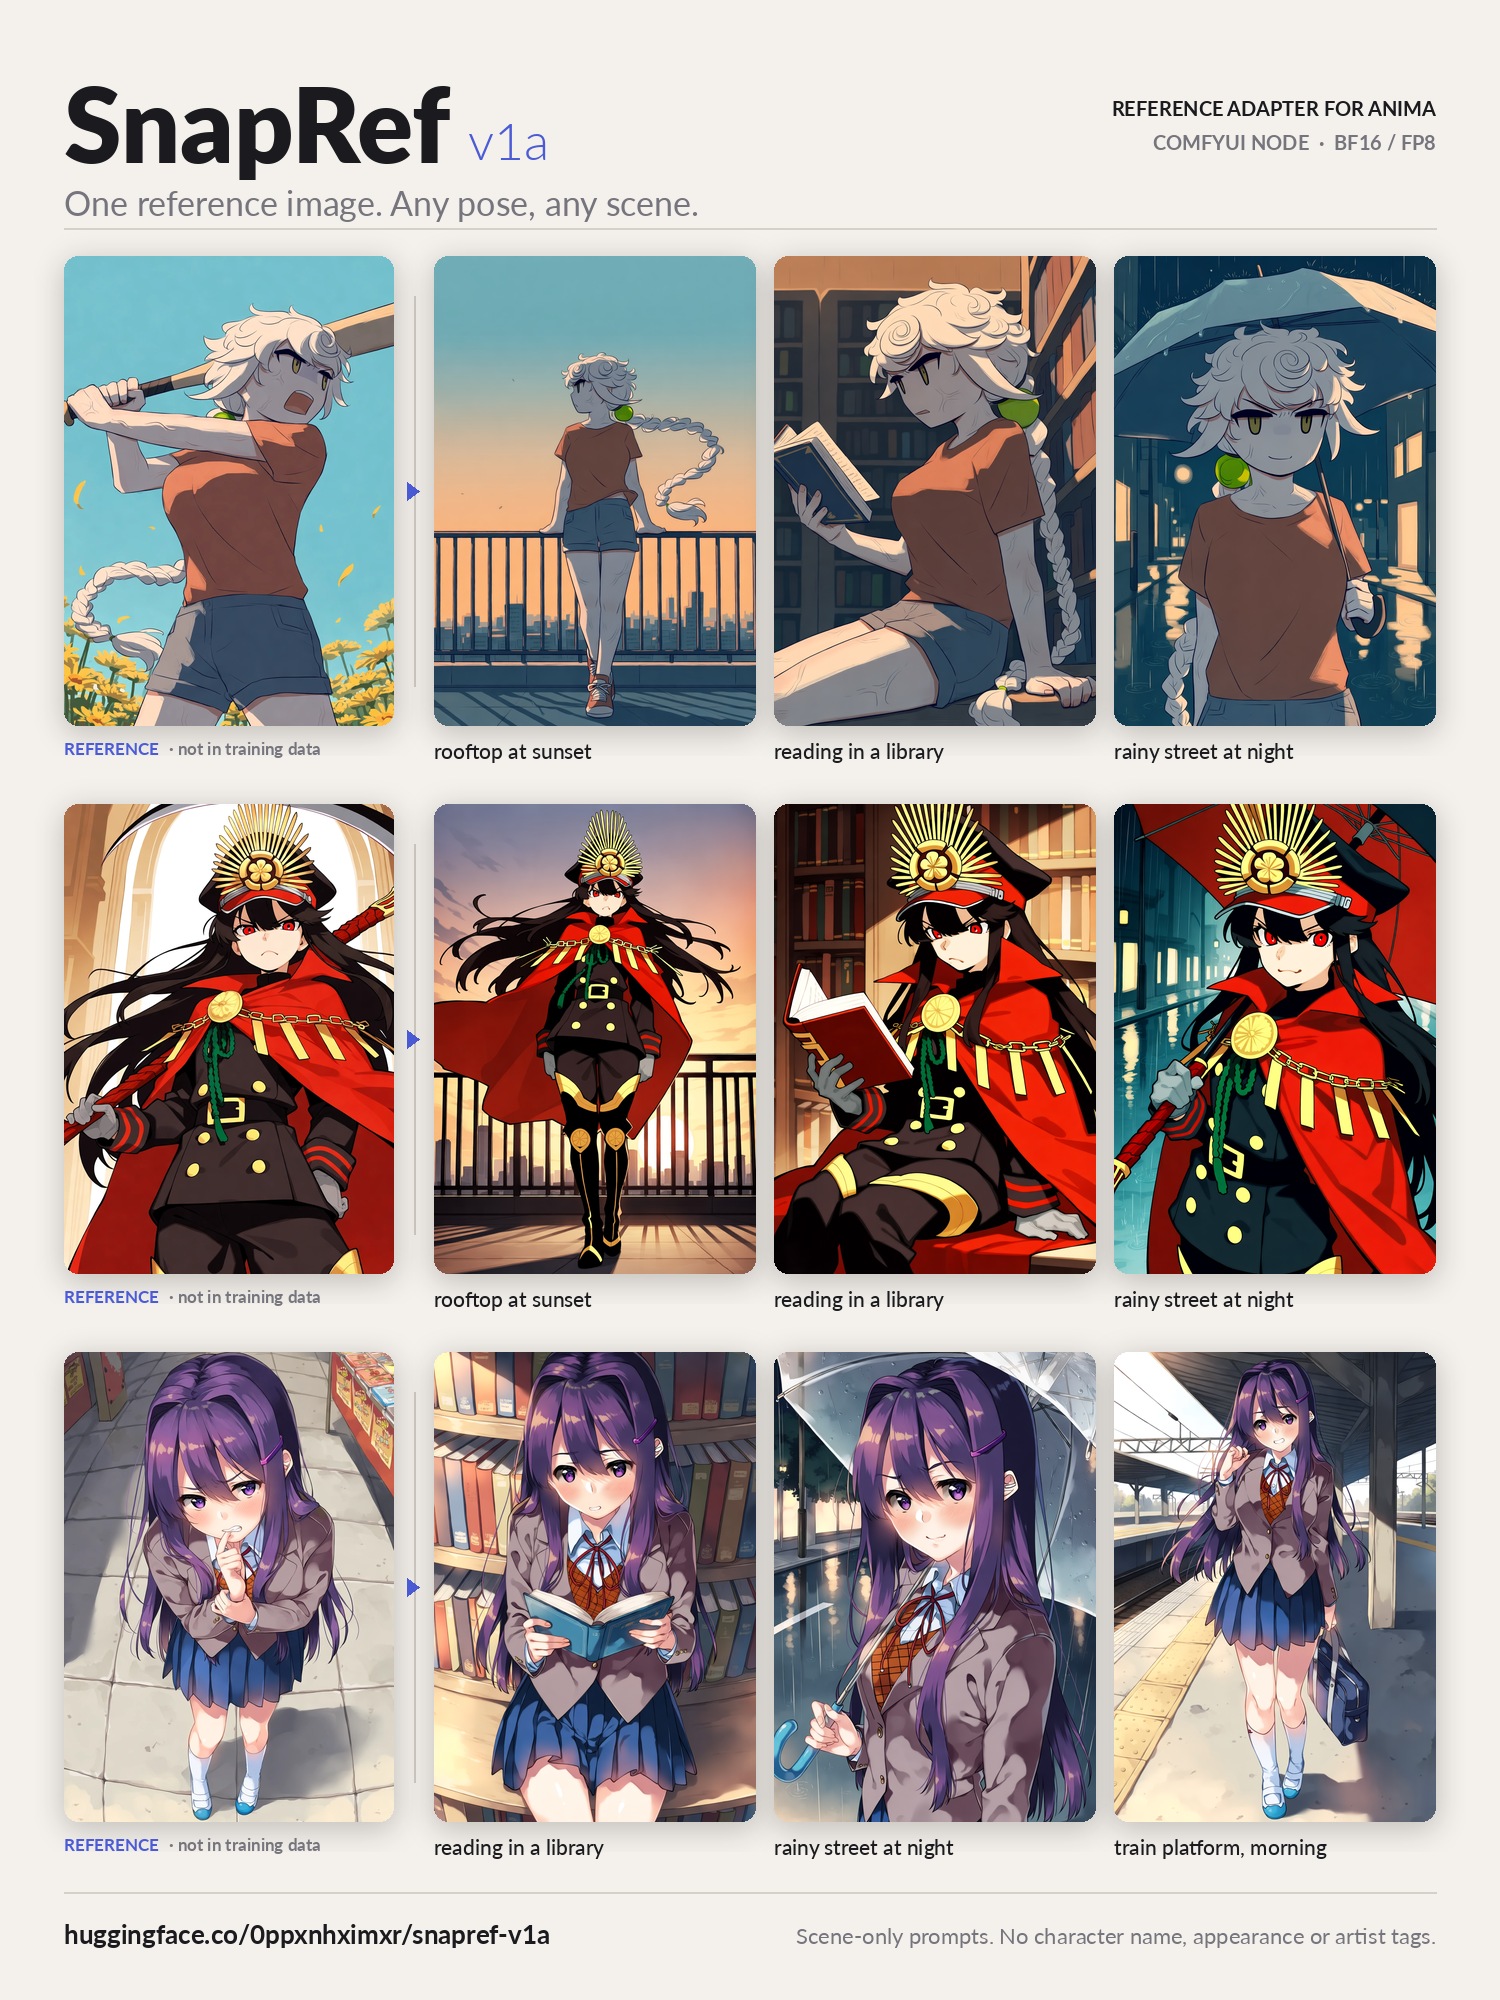
Одно референсное изображение и промпт, в котором названа только сцена.
Anima это модель с теговыми промптами, поэтому персонажа обычно воспроизводят, прописывая в промпте волосы, глаза и одежду, и только для персонажей, которых модель уже знает. Референс-адаптер переносит эту задачу на изображение: текст отвечает за позу, кадрирование и локацию, а референс за то, кто нарисован.
Для Anima эта идея не нова. Anima Reference Adapter сделал это 27 октября, добавив референс как смещённый второй латентный кадр, чтобы видеоприор не мог продолжить его как кадр сцены. SnapRef идёт другим путём: он один раз прогоняет референс через модель, кэширует то, что выдаёт каждый слой, и перечитывает этот кэш на каждом шаге выборки.
Как кэшируется референс
Файл адаптера это две ветви LoRA, объединённые под одним ключом anima_ref_kv/1: ветвь референса ранга 128 на self-attention, cross-attention и обоих слоях MLP всех 28 блоков, и ветвь ранга 64 на self-attention целевой стороны. Итого 190,8 млн параметров, 382 МБ в bf16.
Референс кодируется один раз и хранится как фиксированный набор токенов с собственной позицией в координатном пространстве модели, так что модель читает его ради внешнего вида, а не копирует его компоновку. Во время выборки каждый слой обращается к своим токенам плюс к кэшированному референсу. LoRA целевой стороны остаётся включённой при каждом прямом проходе цели, и по умолчанию референс читает только положительная ветвь CFG; ref_guidance направляет его в обе ветви. Поскольку референс не перекодируется на каждом шаге, карточка модели оценивает накладные расходы примерно в 15% относительно генерации без референса.
Доступны два режима: cs копирует персонажа и стиль вместе, char копирует только персонажа, чтобы стиль задавали теги художника. Отдельный путь ref_guidance сильнее тянет к референсу примерно за 1,4× времени, с APG или CFG rescale, чтобы цвета не перенасыщались, та же коррекция, которая требовалась предыдущему адаптеру.
Сколько это стоит по сравнению с другими вариантами
В репозитории есть comparison_summary.json, таблица замеров на одном и том же кейсе, снятая на A100 при 832×1216, 28 шагов, каждый адаптер со своими настройками по умолчанию:
| Вариант | Секунд на изображение |
|---|---|
| SnapRef v1a | 8,95 |
| ElectronGirl v2 | 14,36 |
| Role-Ref-KV | 12,53 |
| Anima Base, без референса | 7,72 |
Что касается идентичности, карточка модели сообщает, что на персонажах, не участвовавших в обучении, адаптер предсказывает цель лучше с правильным референсом, чем с неправильным: разрыв по идентичности 0,0041 по denoising loss на отложенной выборке, а цифры по каждому кейсу приведены в heldout_loss.json.
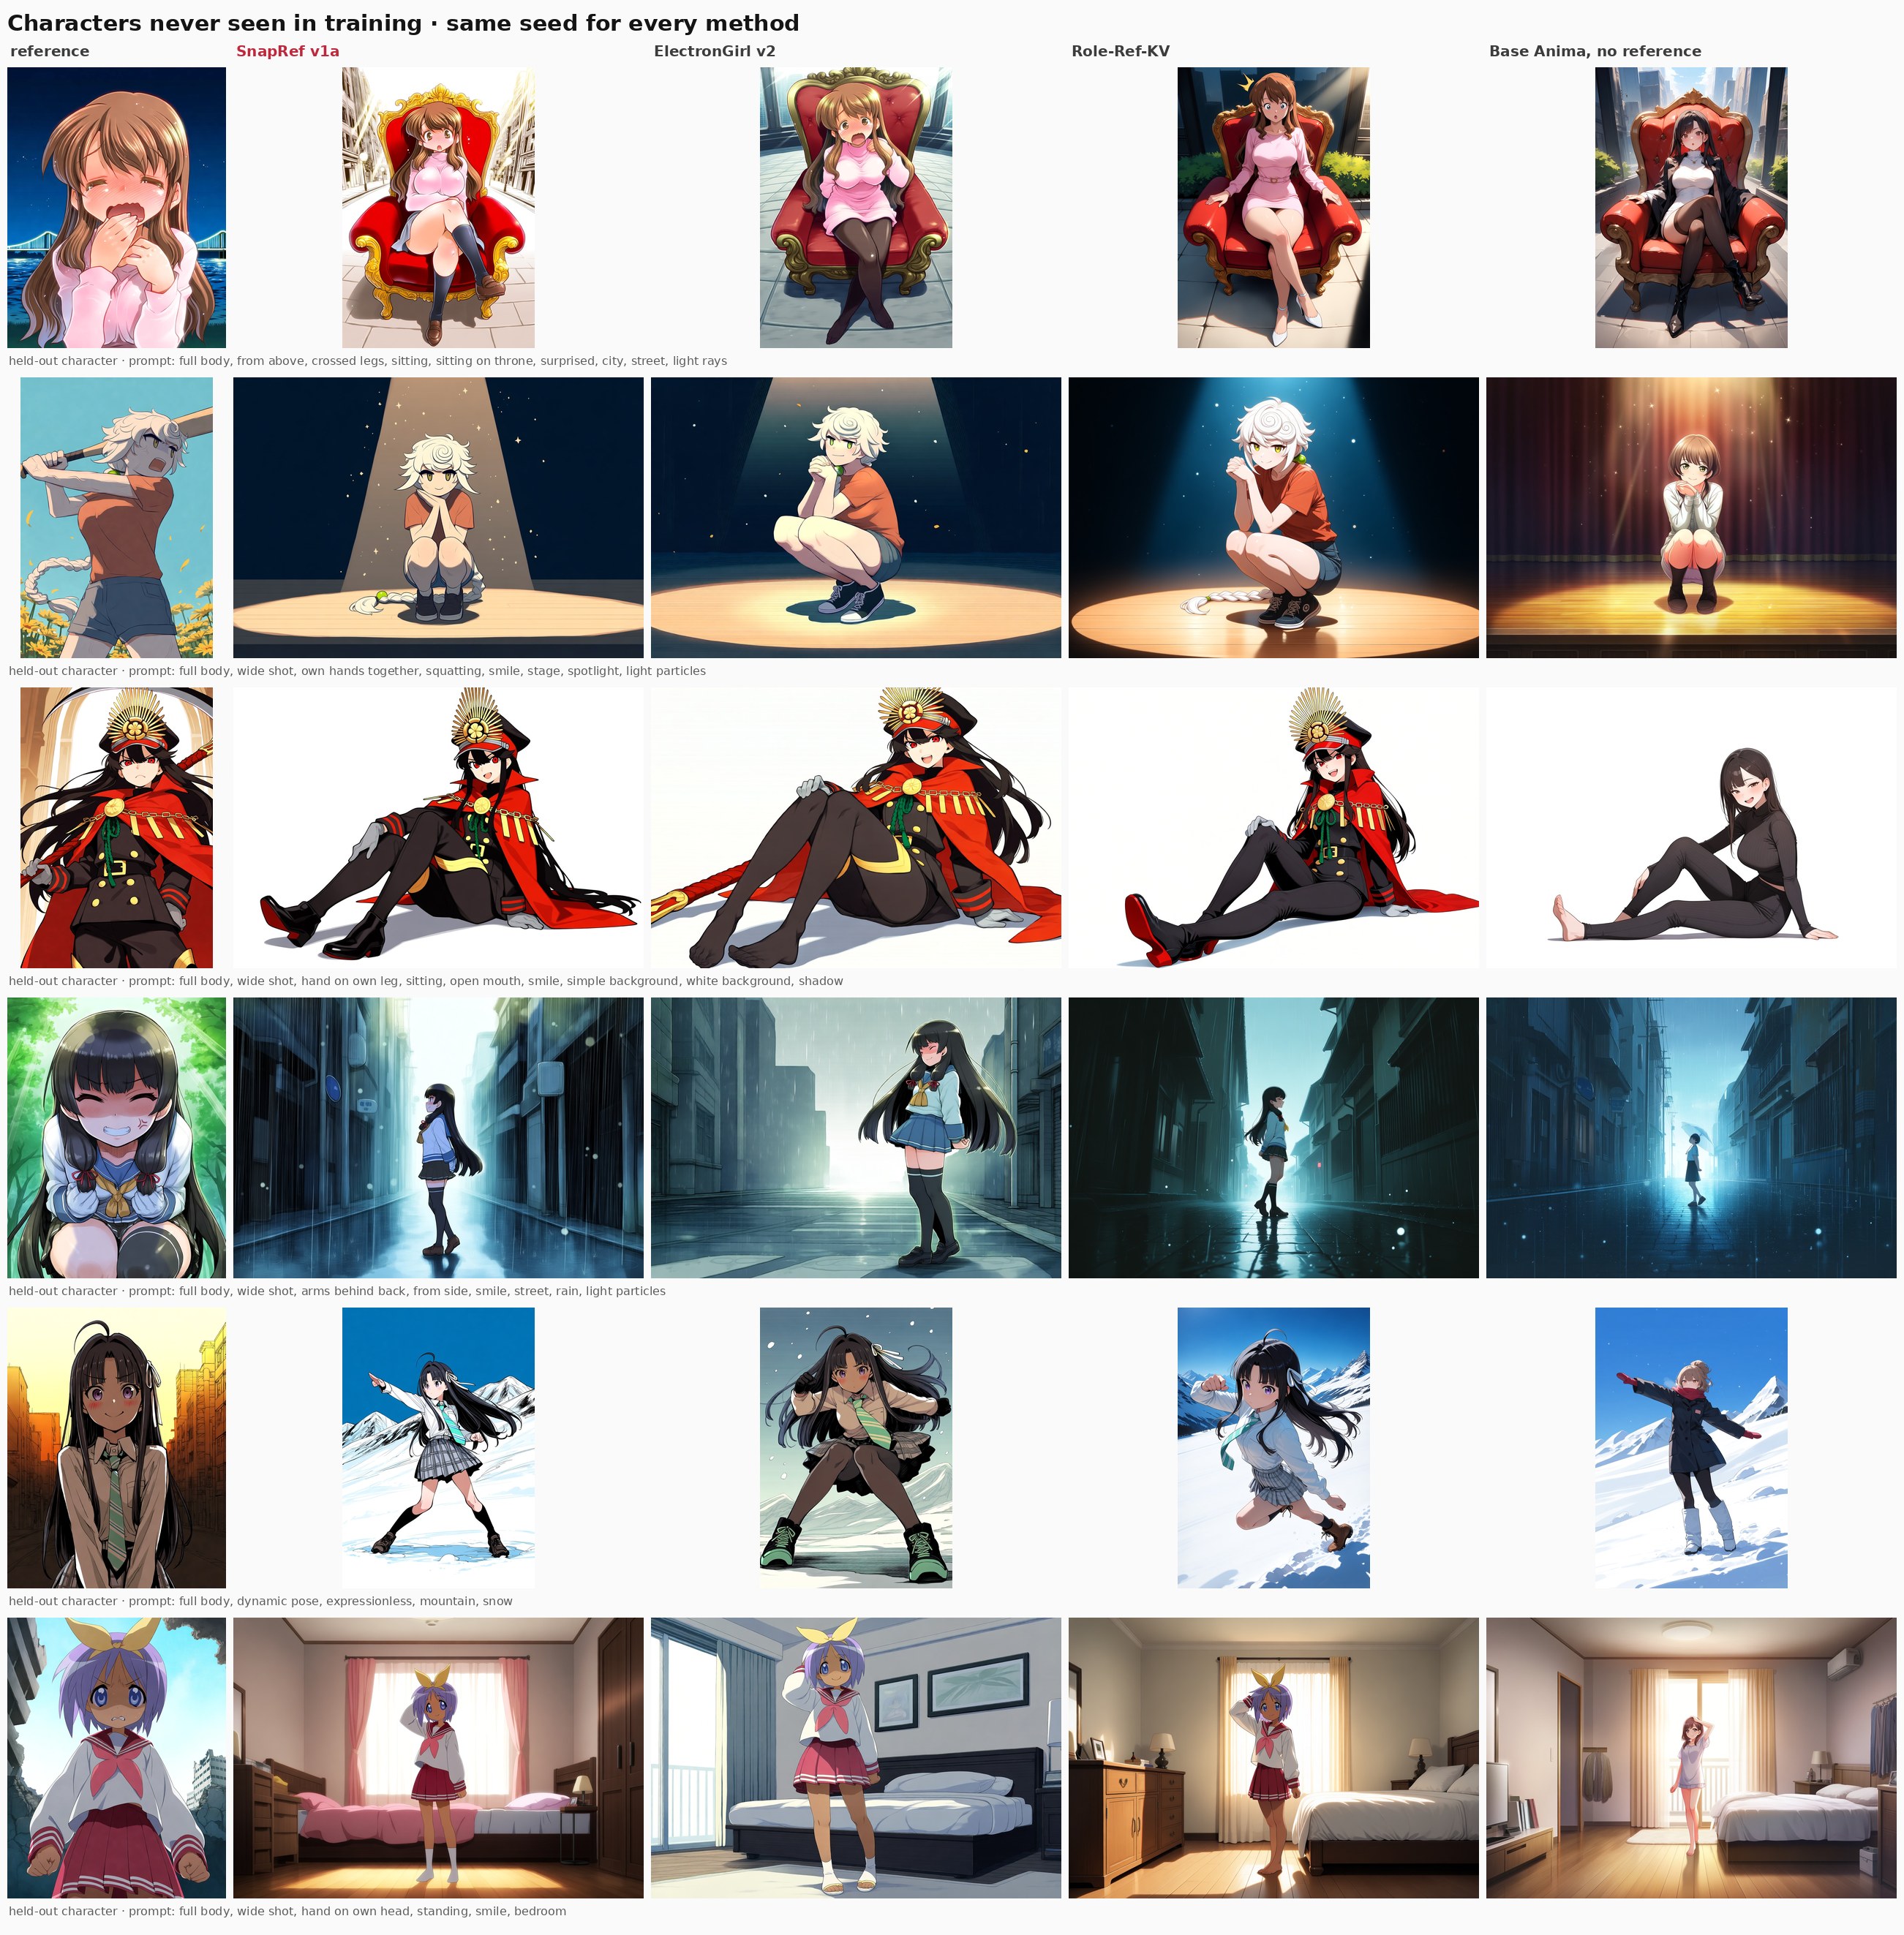
Персонажи, отсутствовавшие в обучении. В промпте названа только сцена; волосы, глаза и одежда берутся из референса.
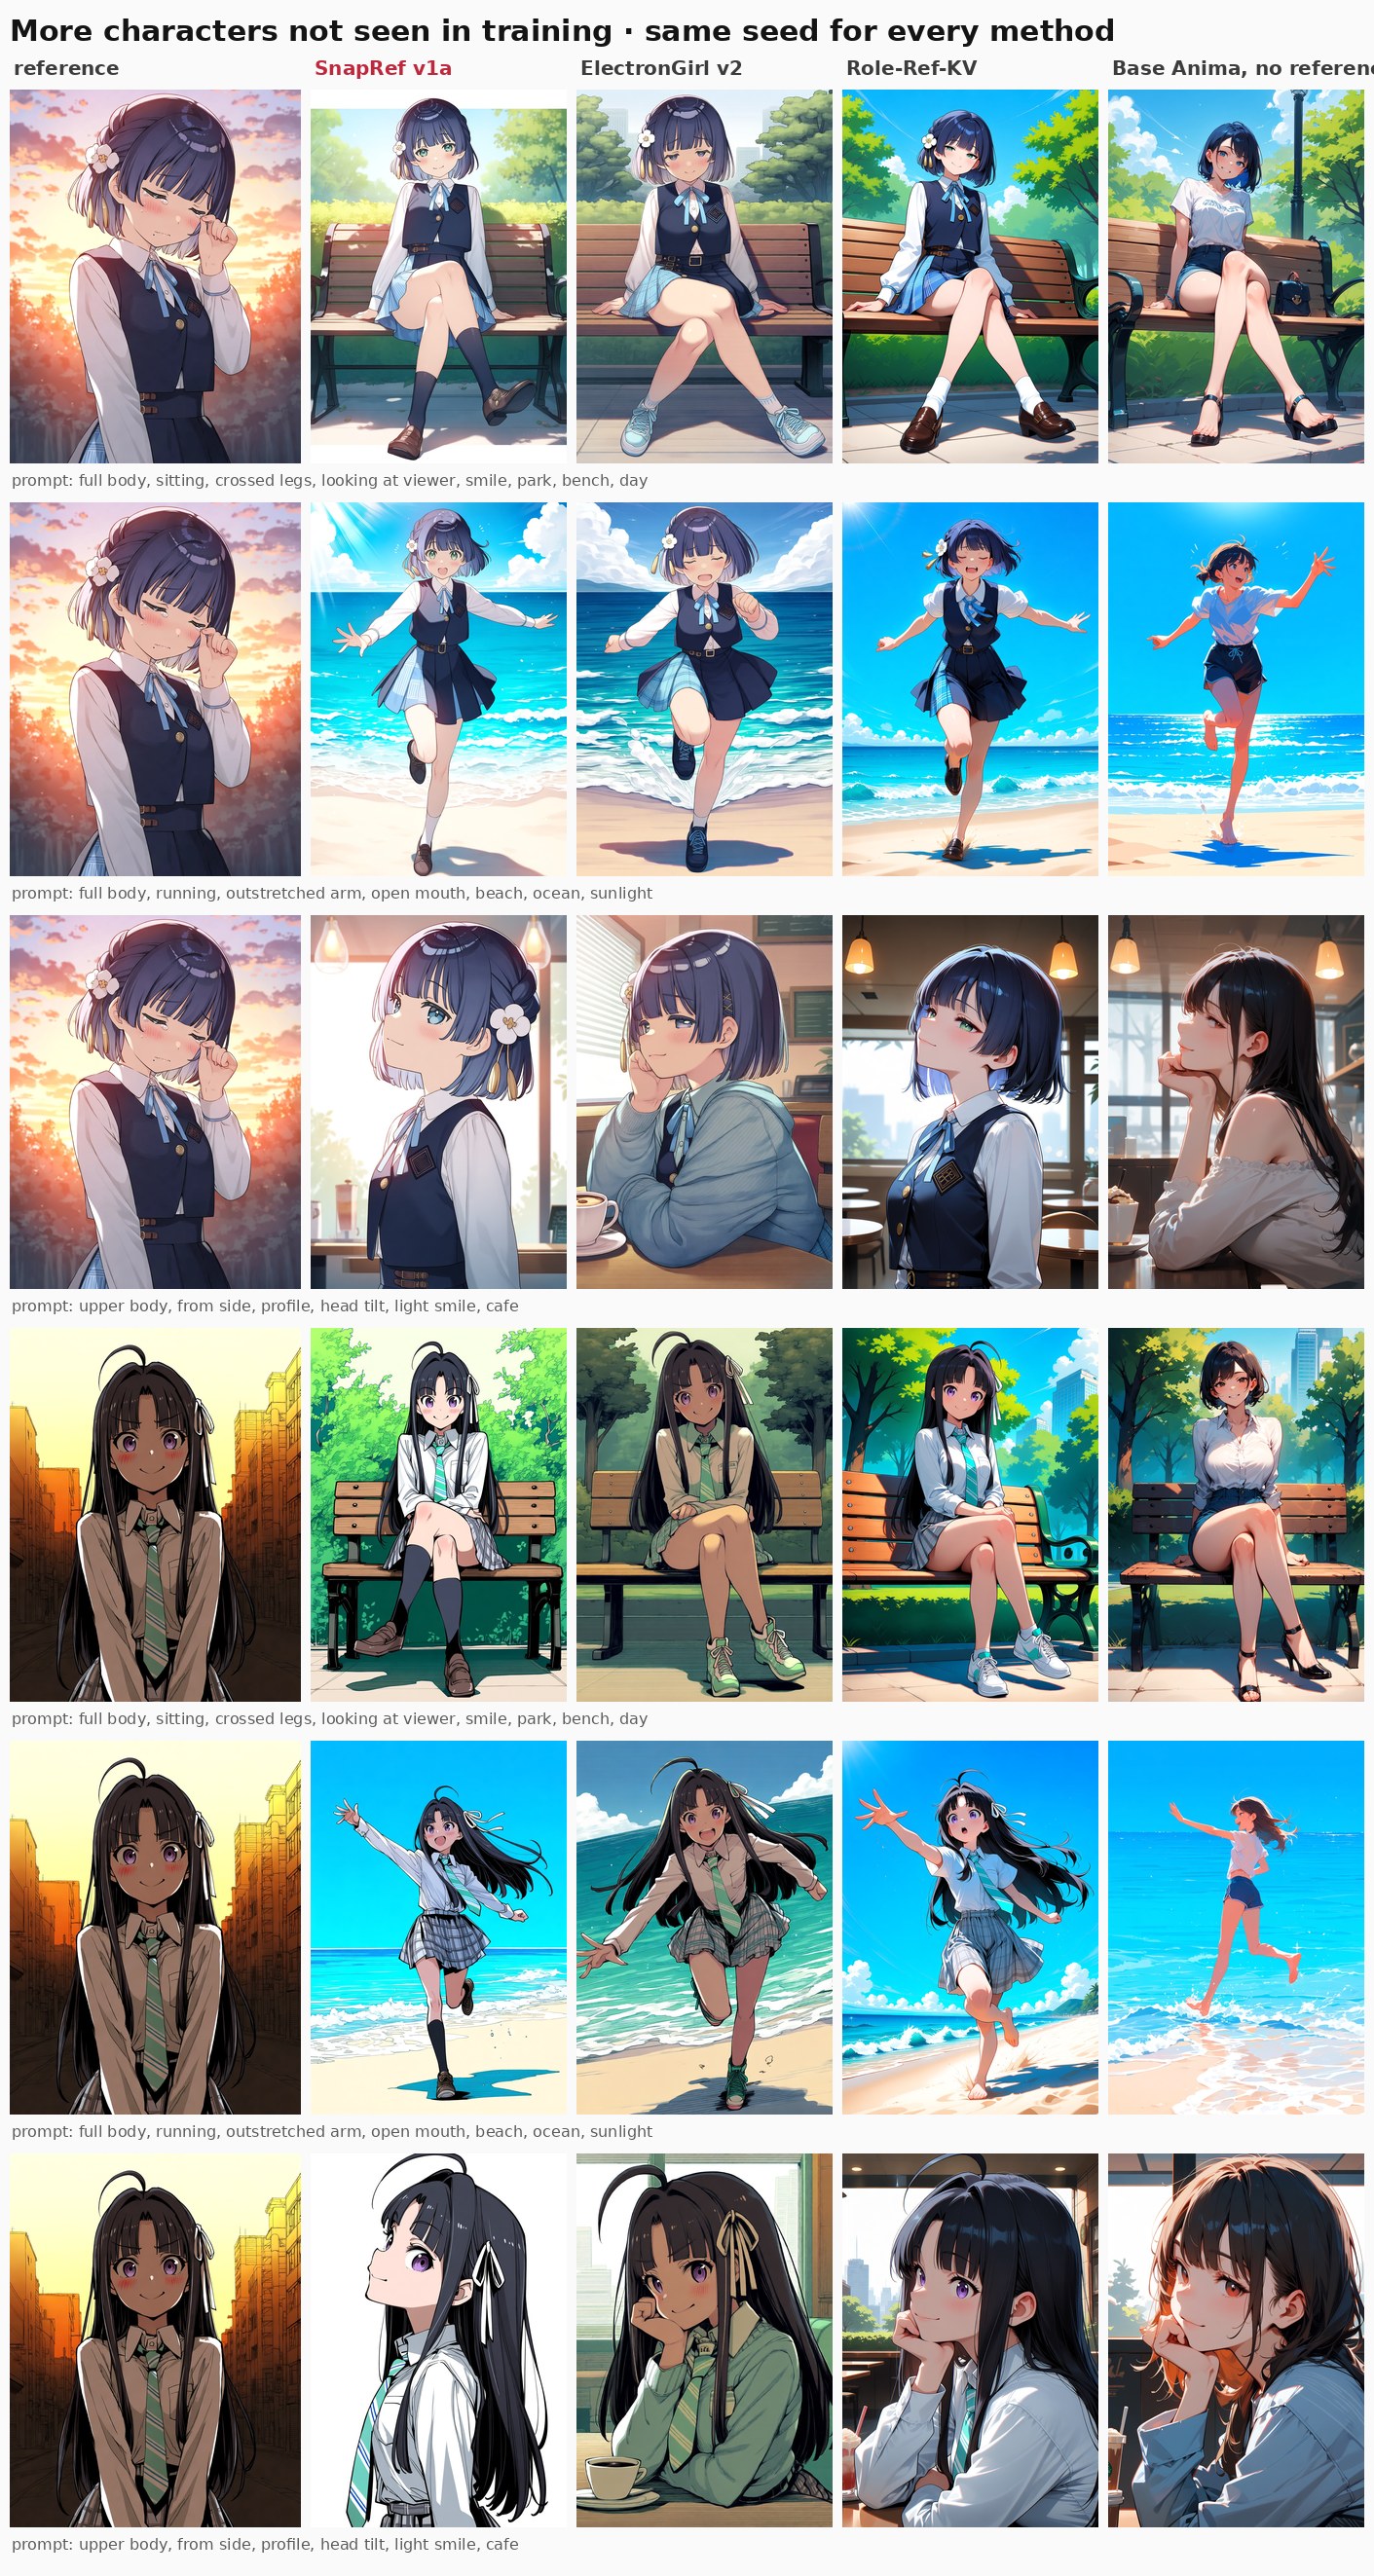
Референсы извне обучающего набора, прогнанные через адаптер.
Обучающие данные сгенерировала сама Anima: 58 300 изображений для 2 367 персонажей, каждый персонаж нарисован в ряде сцен и поз в одном стиле художника, затем прогон примерно на 120 GPU-часов H100. Второй чекпойнт, SnapRef v1b, удваивает ранг LoRA, точнее следует промпту и удерживает персонажа примерно так же.
Сторона ComfyUI
Пакет узлов лежит в репозитории в comfyui/snapref/; скопируйте его в custom_nodes/, положите адаптер в models/loras/ и загружайте его узлом SnapRef, а не загрузчиком LoRA, поскольку две ветви это не обычная LoRA. Простой узел принимает одно или два изображения, режим, strength и fidelity; расширенный узел открывает всё остальное, включая ref_in_uncond, ref_megapixels и ref_caption.
Включено пять рабочих процессов: один персонаж, два персонажа, несколько референсов одного персонажа, сравнение бок о бок с другими адаптерами и минимальный, приведённый ниже. Для двух персонажей инструкции советуют склеить два референса базовым узлом Image Stitch и описать в промпте, кто слева и кто справа. РЕКОМЕНДУЕТСЯ выборка euler или er_sde с simple, 28–30 шагов и CFG 4.5.
Адаптер FP8 весит 195 МБ вместо 382 МБ и, по сообщениям, даёт практически те же изображения, в том числе на базе Anima в FP8. 31 октября узел обновили, чтобы кодирование референса оставалось в fp32: с fp16-чекпойнтом, --fp16-unet или --fast с накоплением fp16 прежняя версия выдавала NaN и чёрное изображение.
Где он ломается
Карточка модели перечисляет режимы отказа, а не скрывает их. Очень мелкие детали, такие как серьги, тонкие узоры и шрамы, могут упрощаться, референс с тёмной кожей может получиться светлее, а некоторые уличные промпты в полный рост превращают низ кадра в ровный белый пол, если не назвать землю. Сцена может перебить одежду из референса, так что пляжный промпт вернёт купальник; повышение strength или упоминание одежды в промпте удерживает её. При двух персонажах атрибуты, которые референсы показывают нечётко, например закрытые глаза, могут перепутаться между ними.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.