Anima Reference Adapter: одно изображение, новая сцена в ComfyUI
Anima Reference Adapter сохраняет персонажа и манеру его рисовки из одного изображения, пока промпт задаёт позу и фон. LoRA ранга 32, три узла ComfyUI.
Аниме-модели с теговыми промптами рисуют того, кого вы просите, только если промпт перечисляет все черты, и только для персонажей, которых модель уже знает. Референсный адаптер снимает эту задачу с текста: укажите ему одно изображение, и промпт свободен описывать позу, кадрирование и локацию.
Большинство референсных кондиционирований, заимствованных из видеомоделей, такого размена не дают. ComfyUI-Cosmos-Reference добавляет референсный латент как дополнительный кадр клипа: это хорошо работает для редактирования, но также копирует позу и компоновку референса, потому что видеоприор читает этот кадр как предыдущий кадр. Anima Reference Adapter требует обратного: сохранить кто нарисован и как, отбросить где и в какой позе.
Как подключается референс
Anima работает на Cosmos-Predict2 MiniTrainDIT: 28 блоков, ширина 2048, 16 голов внимания, пространственные патчи 2×2 поверх 16-канального латента Wan 2.1, с текстовым энкодером Qwen3-0.6B и flow matching при shift 3. Это даёт ей 3D вращательные позиционные эмбеддинги по (t, h, w), и именно этот рычаг использует адаптер.
Референсное изображение вписывается с полями (letterbox) в выходное разрешение, один раз кодируется через VAE и добавляется как второй латентный кадр. Три изменения отличают его от обычного референса в видеостиле:
- Чистый референсный кадр. Референсный кадр подаётся при timestep 0, целевой кадр при σ. Со стороны референса ничего не зашумляется.
- Смещённый RoPE. Координаты высоты референсного кадра сдвигаются за пределы целевой сетки (на одну целевую высоту плюс небольшой джиттер во время обучения), поэтому попиксельное соответствие не сохраняется и модель не может продолжить референс как кадр.
- Обученный читатель. LoRA ранга 32 с α = 32 на self-attention, cross-attention и обоих слоях MLP каждого блока (280 модулей, 45,9 млн параметров) учится читать этот смещённый кадр. Она применяется через forward hooks и только во время вызовов модели, которые несут референс, поэтому загруженная базовая модель всё ещё может выполнить проход без референса.
Guidance тоже разделён. Когда референс присутствует в обеих ветвях CFG, усиливается только текст; вместо этого ГИД использует раздельные масштабы для текста и референса, так что ref_guidance может сдвигать результат к референсу, не трогая cfg. Высокий reference guidance перенасыщает, поэтому узел дополнительно применяет либо адаптивное проекционное управление, либо CFG rescale.
Что показывают отложенные персонажи
Обучающие данные синтетические и созданы самой Anima: 600 групп одного персонажа в одном стиле, по шесть рендеров в каждой с независимо сэмплированными кадрированием, камерой, позой, выражением лица, фоном и освещением, всего 3 600 изображений для 300 персонажей и 427 художников на одной RTX PRO 6000 Max-Q за 4,25 часа. Двенадцать персонажей были полностью отложены; оставшиеся 576 групп дали 17 280 упорядоченных пар «референс-цель», в 70% которых из промпта цели убирались все теги внешнего вида и одежды.
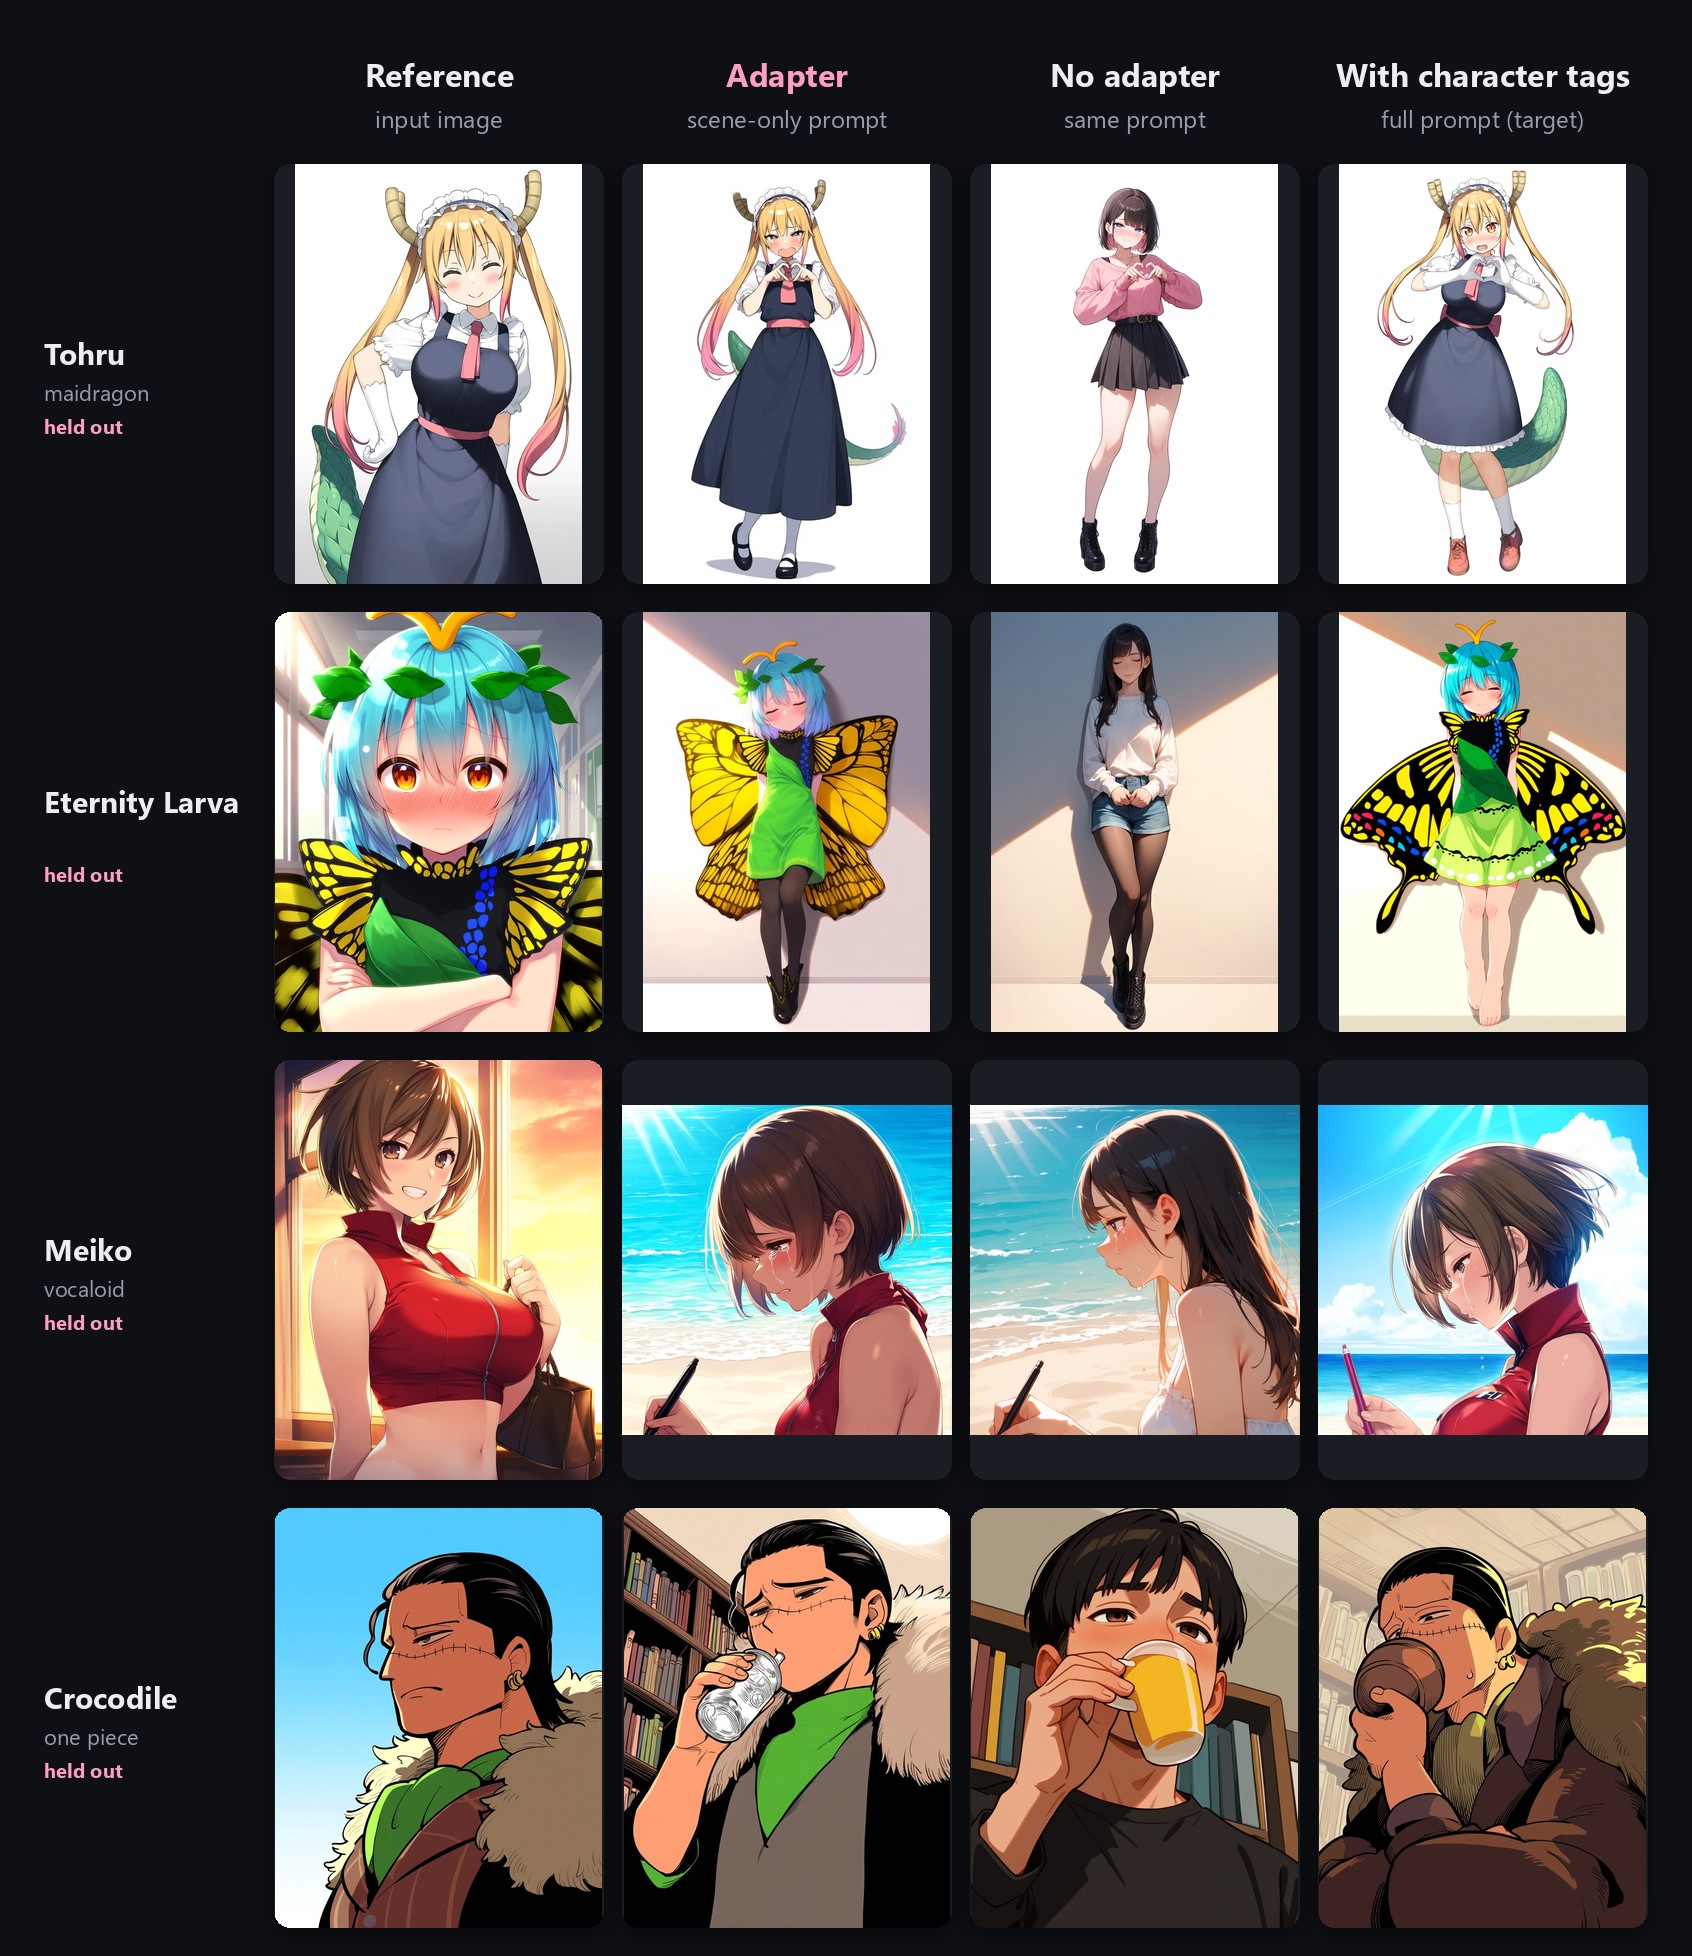
Отложенные персонажи, никогда не встречавшиеся в обучении. Каждая строка: референс; адаптер с промптом только сцены; тот же промпт без адаптера; базовая модель, которой персонаж задан по имени с полными тегами внешности.
В 18 случаях оценки адаптер воспроизводит цвет и укладку волос, цвет глаз, наряд и характерные аксессуары, такие как рога и хвост, нимб, крылья бабочки или платье горничной, тогда как тот же промпт только со сценой на чистой базовой модели выдаёт обобщённого персонажа. Поза, кадрирование и фон следовали промпту во всех случаях, копирования позы не наблюдалось.
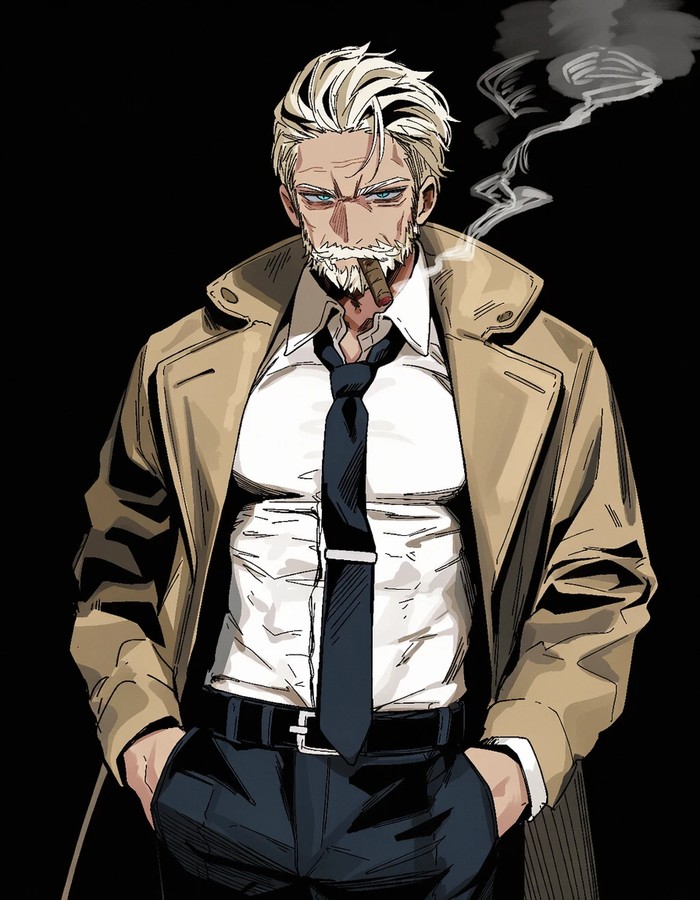
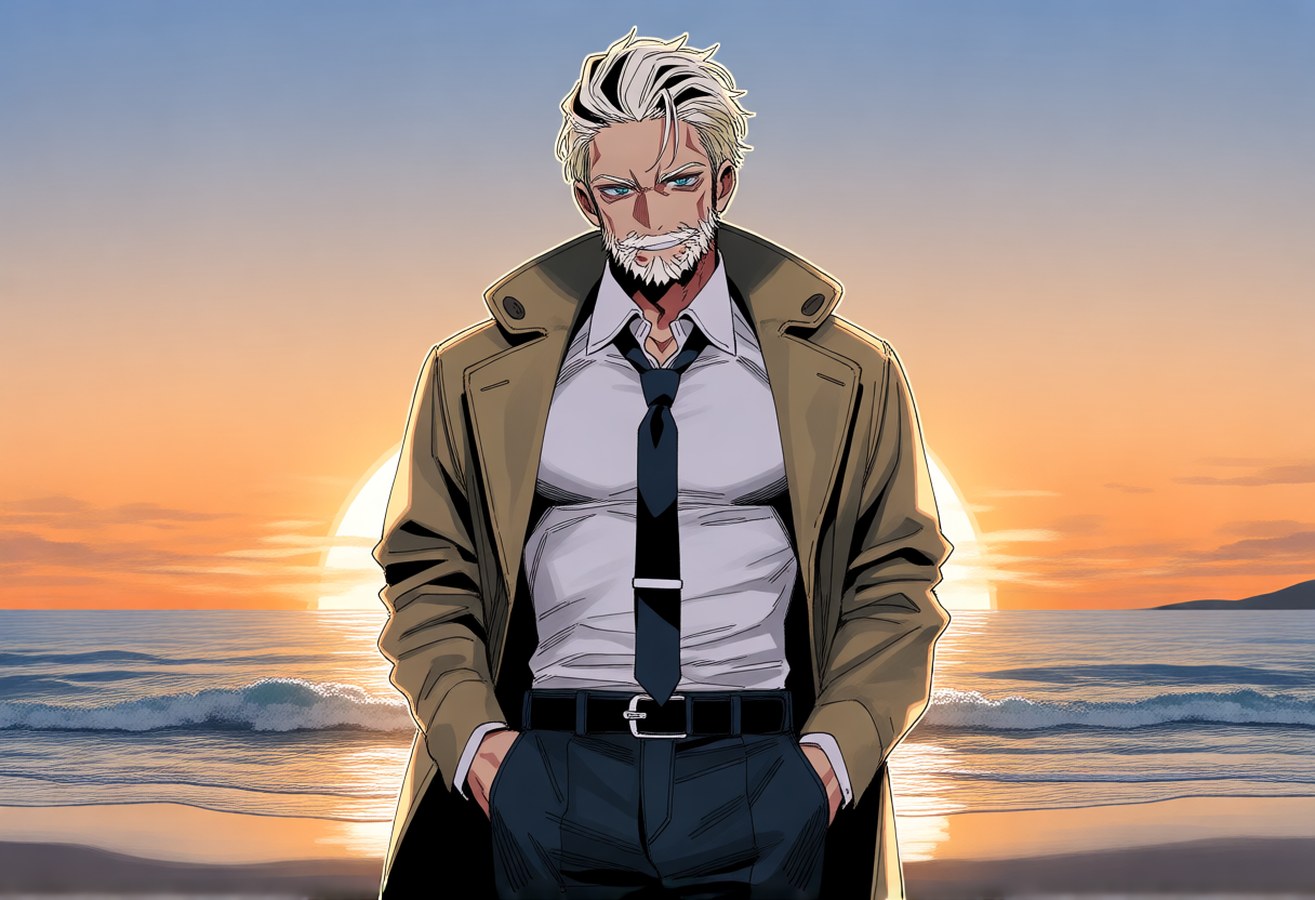
Два обычных референса показывают такое же разделение вне отложенного набора:
 |  |
|---|---|
| Референс A, единственное изображение, переданное адаптеру | cowboy shot, looking at viewer, smile, beach, ocean, sunset |
Промпт не содержит имени персонажа, тега художника или тегов внешности. Рекомендуемые настройки: Euler при 28–30 шагах с simple, текстовый CFG 4,5, reference guidance от 4,5 до 6 и APG, а также вычисления в bf16, поскольку Anima переполняется в fp16.
Стиль: более слабая половина
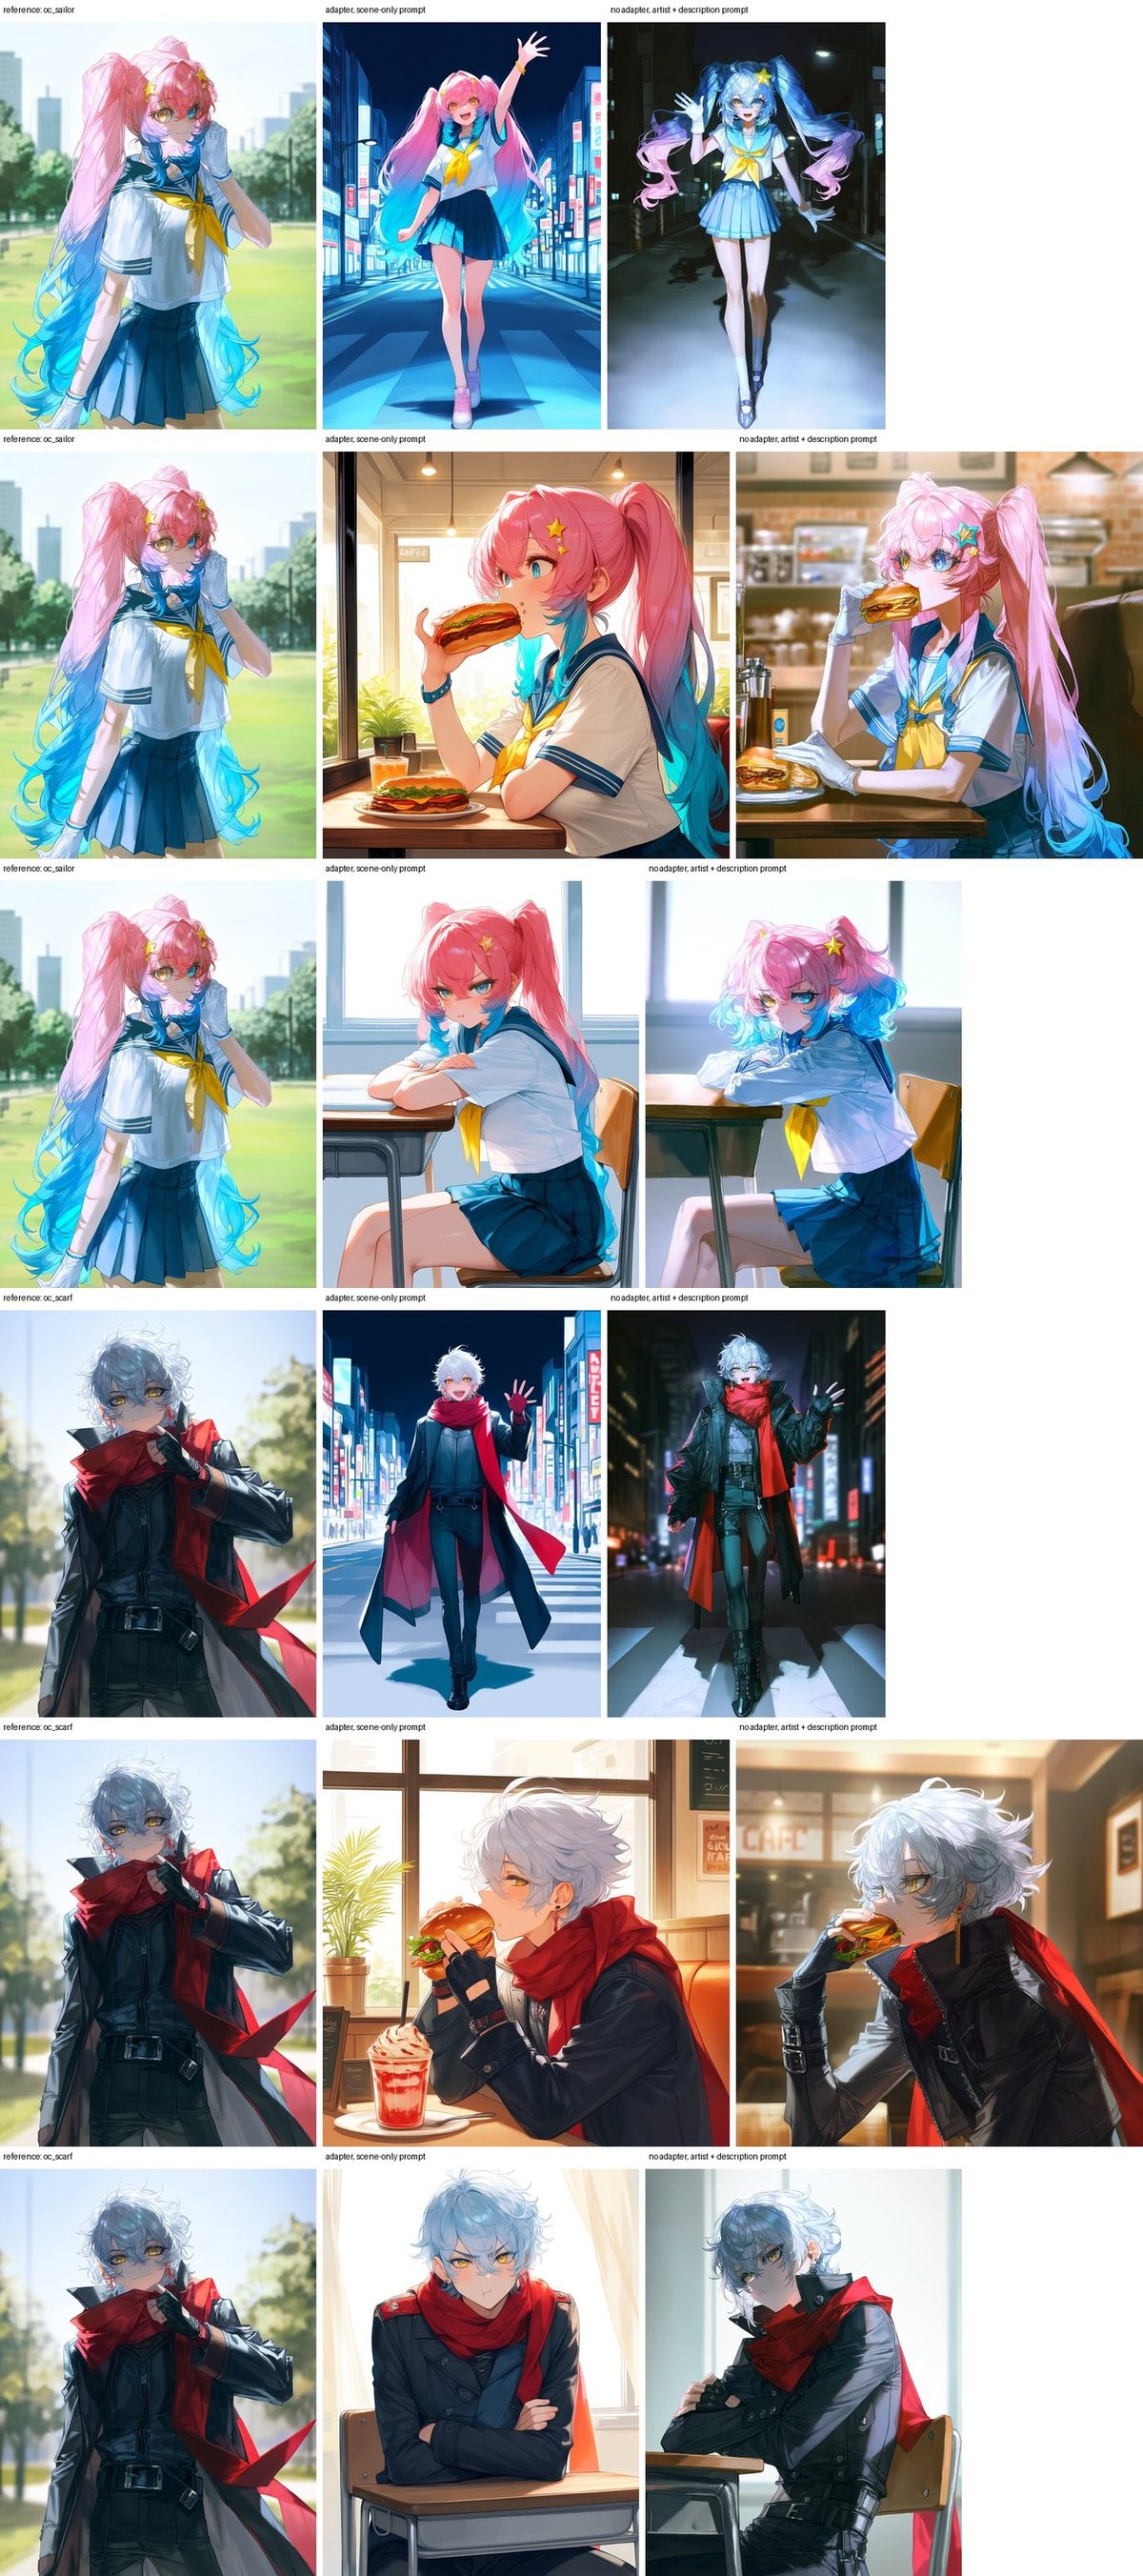
Оригинальные персонажи, нарисованные базовой моделью с тегом художника, который никогда не появлялся в обучении. Каждая строка: референс; адаптер с промптом только сцены; базовая модель с тегами художника и описания.
Дизайн персонажа переносится хорошо: градиентные двойные хвосты, звёздные украшения для волос, шейный платок, серебряные волосы с красным шарфом и перчатками. Живописная манера художника, мягкое освещение и приглушённая палитра не передаются при reference guidance 1, и результаты откатываются к более резкому стандартному виду Anima.
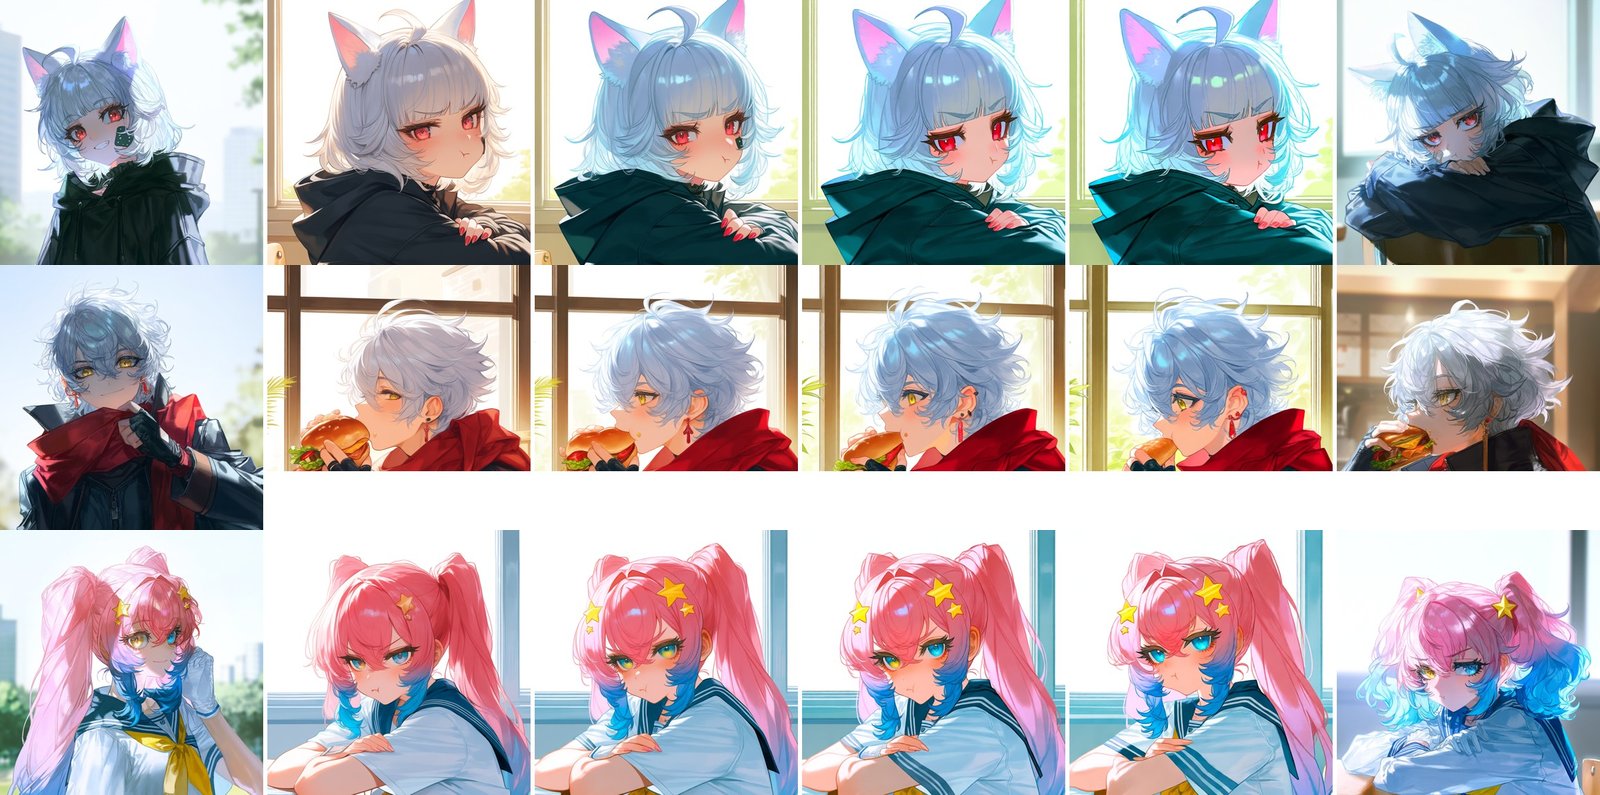
Кропы при reference guidance 1, 2,5, 4,5 и 6 рядом с референсом; справа базовая модель с полными тегами.
Повышение reference guidance возвращает текстуру волос и блики, отрисовку глаз, холодную палитру и мелкие аксессуары, такие как повязка или гетерохромия, которые guidance 1 отбрасывает. После примерно 4,5 цвета перенасыщаются, а существующий дрейф усиливается, для чего и нужна коррекция APG или rescale. Живописная манера всё равно не появляется, и автор объясняет это тем, что LoRA усвоила её в малой степени, а не недостаточным усилением. Автор готовит больший набор из 2 000 персонажей в трёх стилях художников и планирует раздельные референсы для персонажа и стиля.
Узлы
| Узел | Что делает |
|---|---|
| Anima Ref Adapter Loader | Прикрепляет LoRA адаптера к MODEL Anima. ref_offset_h остаётся равным 1.0, обучающему значению. |
| Anima Ref Latent | Вписывает референс в выходной размер с белыми полями, кодирует его и также возвращает пустой латент для этого разрешения. |
| Anima Ref Guider | GUIDER для SamplerCustomAdvanced с текстовым cfg, ref_guidance, коррекцией APG или rescale и пост-CFG патчами, такими как PAG. |
Остальное предоставляет ядро ComfyUI: UNETLoader для anima_baseV10.safetensors, CLIPLoader для энкодера Qwen3-0.6B, VAELoader для VAE Qwen-Image. Базовый граф запускается в 19 узлах на одном SamplerCustomAdvanced; второй рабочий процесс добавляет Anima Safe PAG. При ref_guidance = 1 референс присутствует в обеих ветвях CFG, и каждый шаг стоит столько же, сколько обычный шаг CFG; выше 1 каждый шаг прогоняет модель трижды, то есть примерно 1,5× обычного шага CFG. Примеры рабочих процессов также используют Patch Sage Attention из ComfyUI-KJNodes, который можно обойти.
Ограничения
Пилот обучался на 300 персонажах в течение 2 000 шагов при ранге 32, и автор перечисляет цену этого: идентичность переносится намного лучше стиля, сильно живописные стили почти не переносятся, мелкие узоры, шрамы, серьги и необычные оттенки кожи часто теряются, крупные элементы одежды могут дрейфовать по цвету, а референсный персонаж иногда снова появляется в сцене как объект. Все обучающие пары являются рендерами Anima, поэтому адаптер наследует смещения базовой модели, а оценка пока качественная, без метрик сходства идентичности или стиля.
Доступность
Веса адаптера опубликованы на Hugging Face как anima_ref_adapter_pilot_r32.safetensors (около 92 МБ) и помещаются в ComfyUI/models/loras/. Пакет узлов устанавливается командой git clone https://github.com/ElectronGirl/ComfyUI-Anima-Ref-Adapter.git внутри ComfyUI/custom_nodes и требует базовой Anima v1.0 вместе с её текстовым энкодером Qwen3-0.6B и VAE Qwen-Image. Адаптер обучался на базовой модели, поэтому turbo LoRA для Anima можно по-прежнему загрузить перед загрузчиком адаптера, используя её обычные шаги и CFG.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.