6-шаговые LoRA Qwen-Image 2.1 от Pruna: пакет ComfyUI
В v0.2 от PrunaAI два 6-шаговых адаптера Qwen-Image 2.1, один встраивает апсемплинг промпта в LoRA, плюс официальный экспорт ComfyUI с шестью воркфлоу.
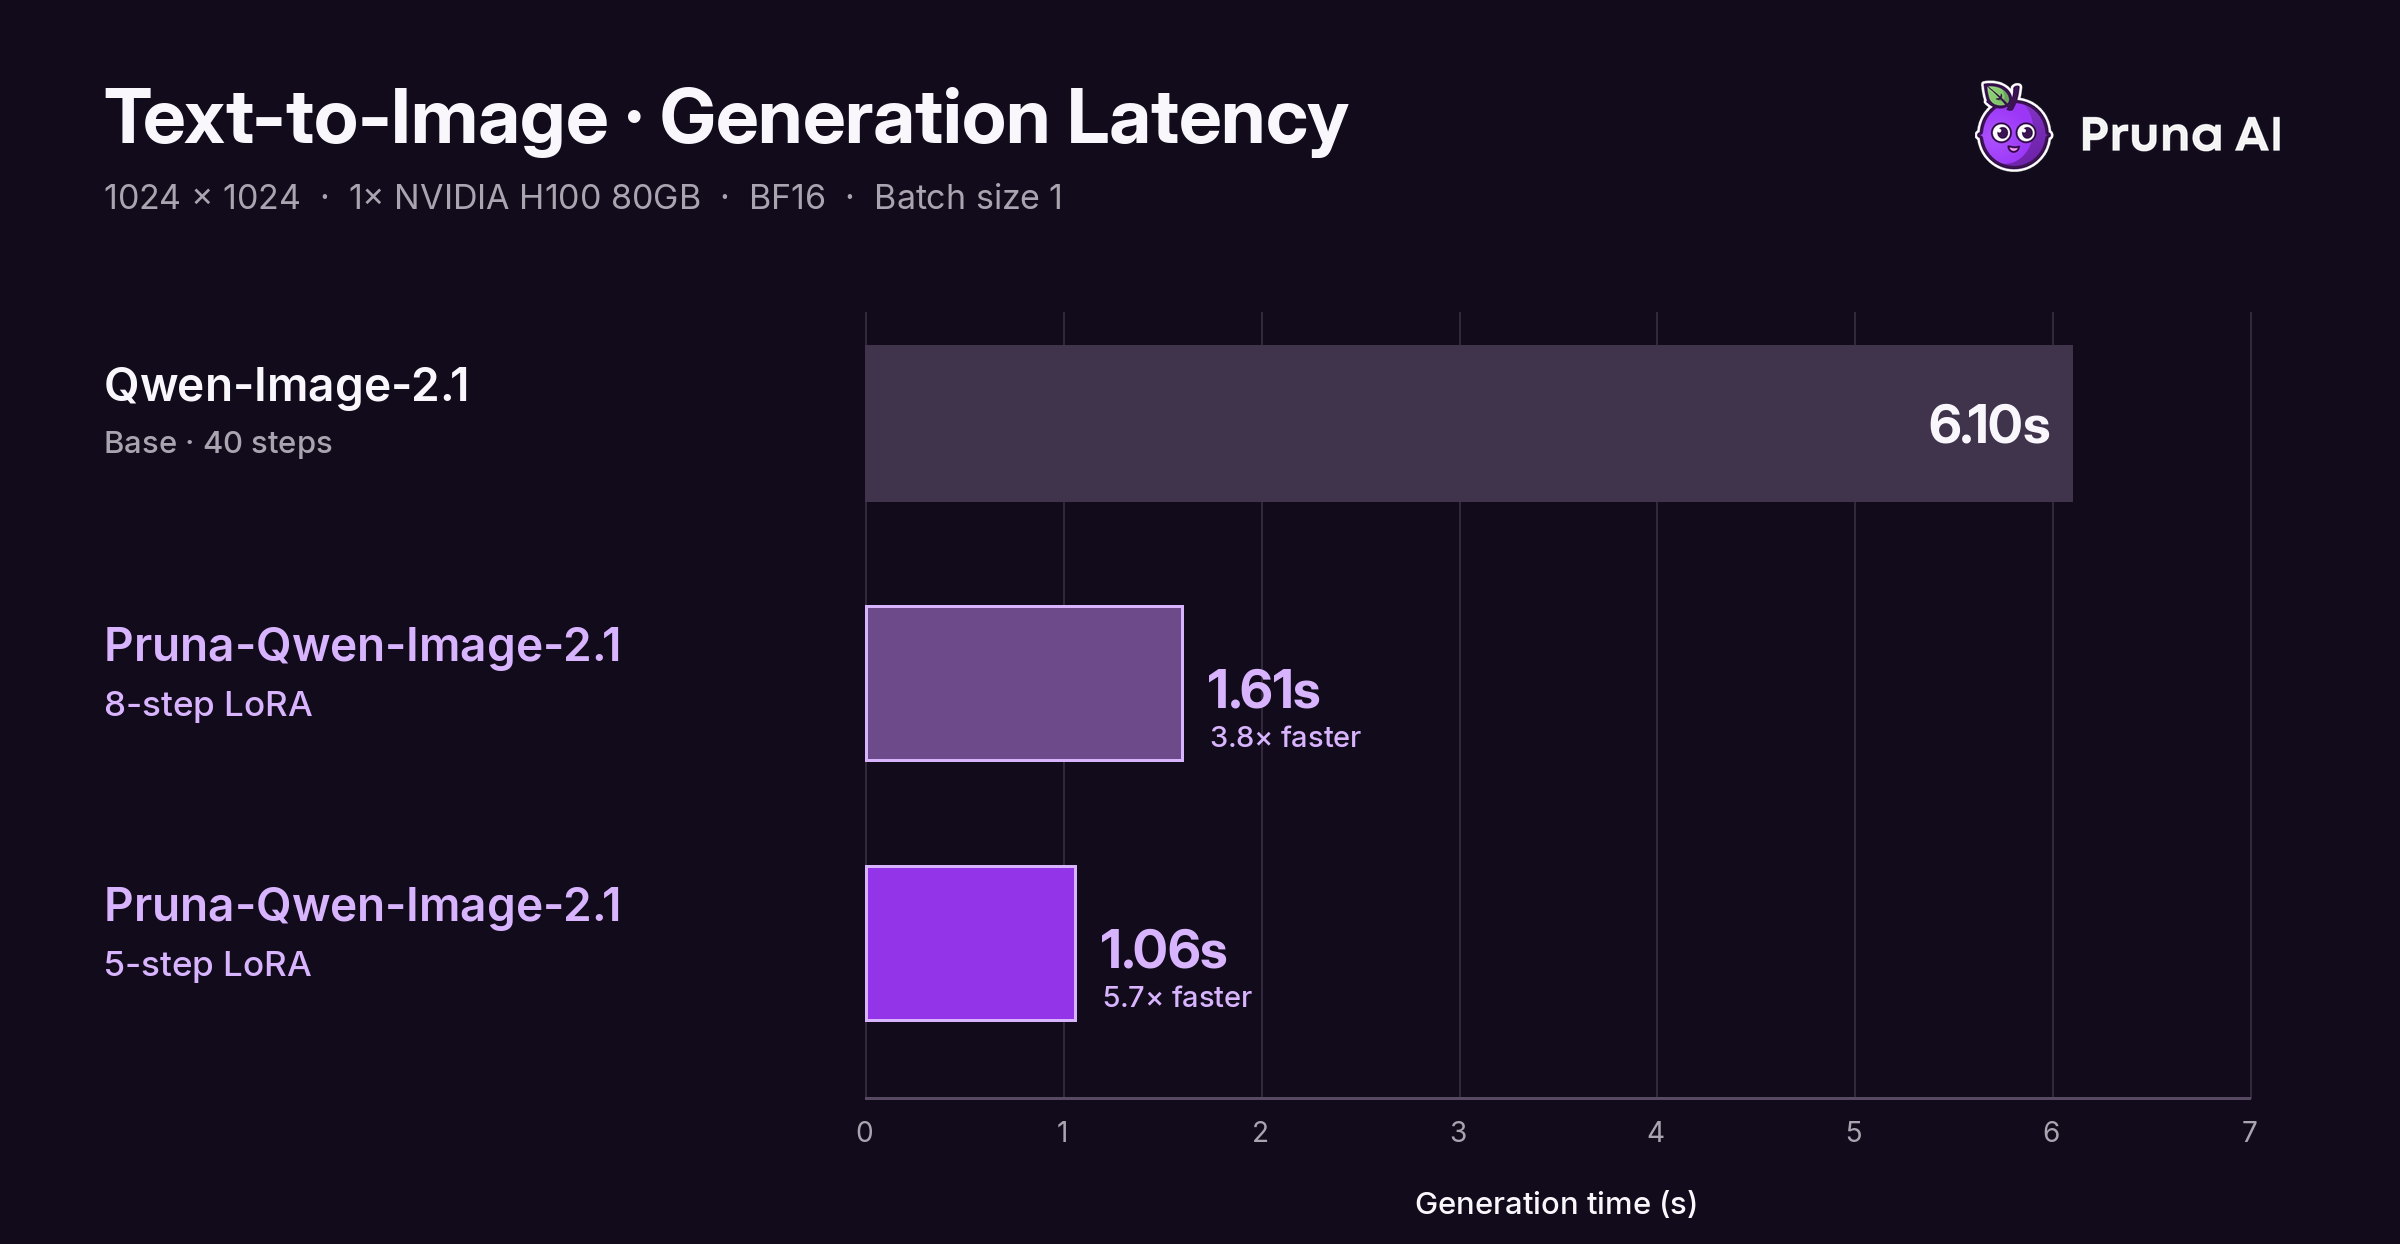
Примеры из официальной карточки модели при 1024.
Когда PrunaAI впервые выпустила эти адаптеры в сентябре, они поставлялись как файлы diffusers/PEFT с альфой, сохранённой в метаданных safetensors, которую загрузчик LoRA в ComfyUI не читает, а в карточке модели было указано, что официального пакета для ComfyUI нет. Теперь оба этих утверждения меняются: адаптеры поставляются как нативные файлы ComfyUI, работающие в задуманном масштабе, а рабочие процессы принадлежат автору, а не сообществу.
Два 6-шаговых адаптера
v0.2 сохраняет весь набор v0.1 (5 шагов и 8 шагов) и добавляет пару 6-шаговых students, обученных по-разному:
| Адаптер | Шаги | Для чего нужен |
|---|---|---|
p_q_image_2.1_6_steps_v0.2.safetensors | 6 | Расширенная дистилляция, прямая замена базовой модели. Лучше всего подходит для редактирования, где вход нужно сохранить. |
p_q_image_2.1_6_steps_upsampled_v0.2.safetensors | 6 | Дистиллирует рекомендуемый апсемплер промпта в LoRA: лучшее качество из короткого промпта без отдельного вызова апсемплинга. |
PrunaAI утверждает, что обычный 6-шаговый адаптер превосходит пару из v0.1 почти во всех категориях. Важная деталь: две схемы не взаимозаменяемы. Адаптеры v0.2 обучались на собственной sigma-схеме, и в карточке модели указано, что числа из v0.1 использовать нельзя.
Апсемплинг промпта, встроенный в LoRA
Официальный рецепт Qwen-Image 2.1 запускает улучшение промпта перед генерацией. Адаптер 6-steps-upsampled поглощает этот шаг, поэтому короткий промпт попадает сразу в выборку, а общее время сокращается на стоимость отдельного вызова усилителя.
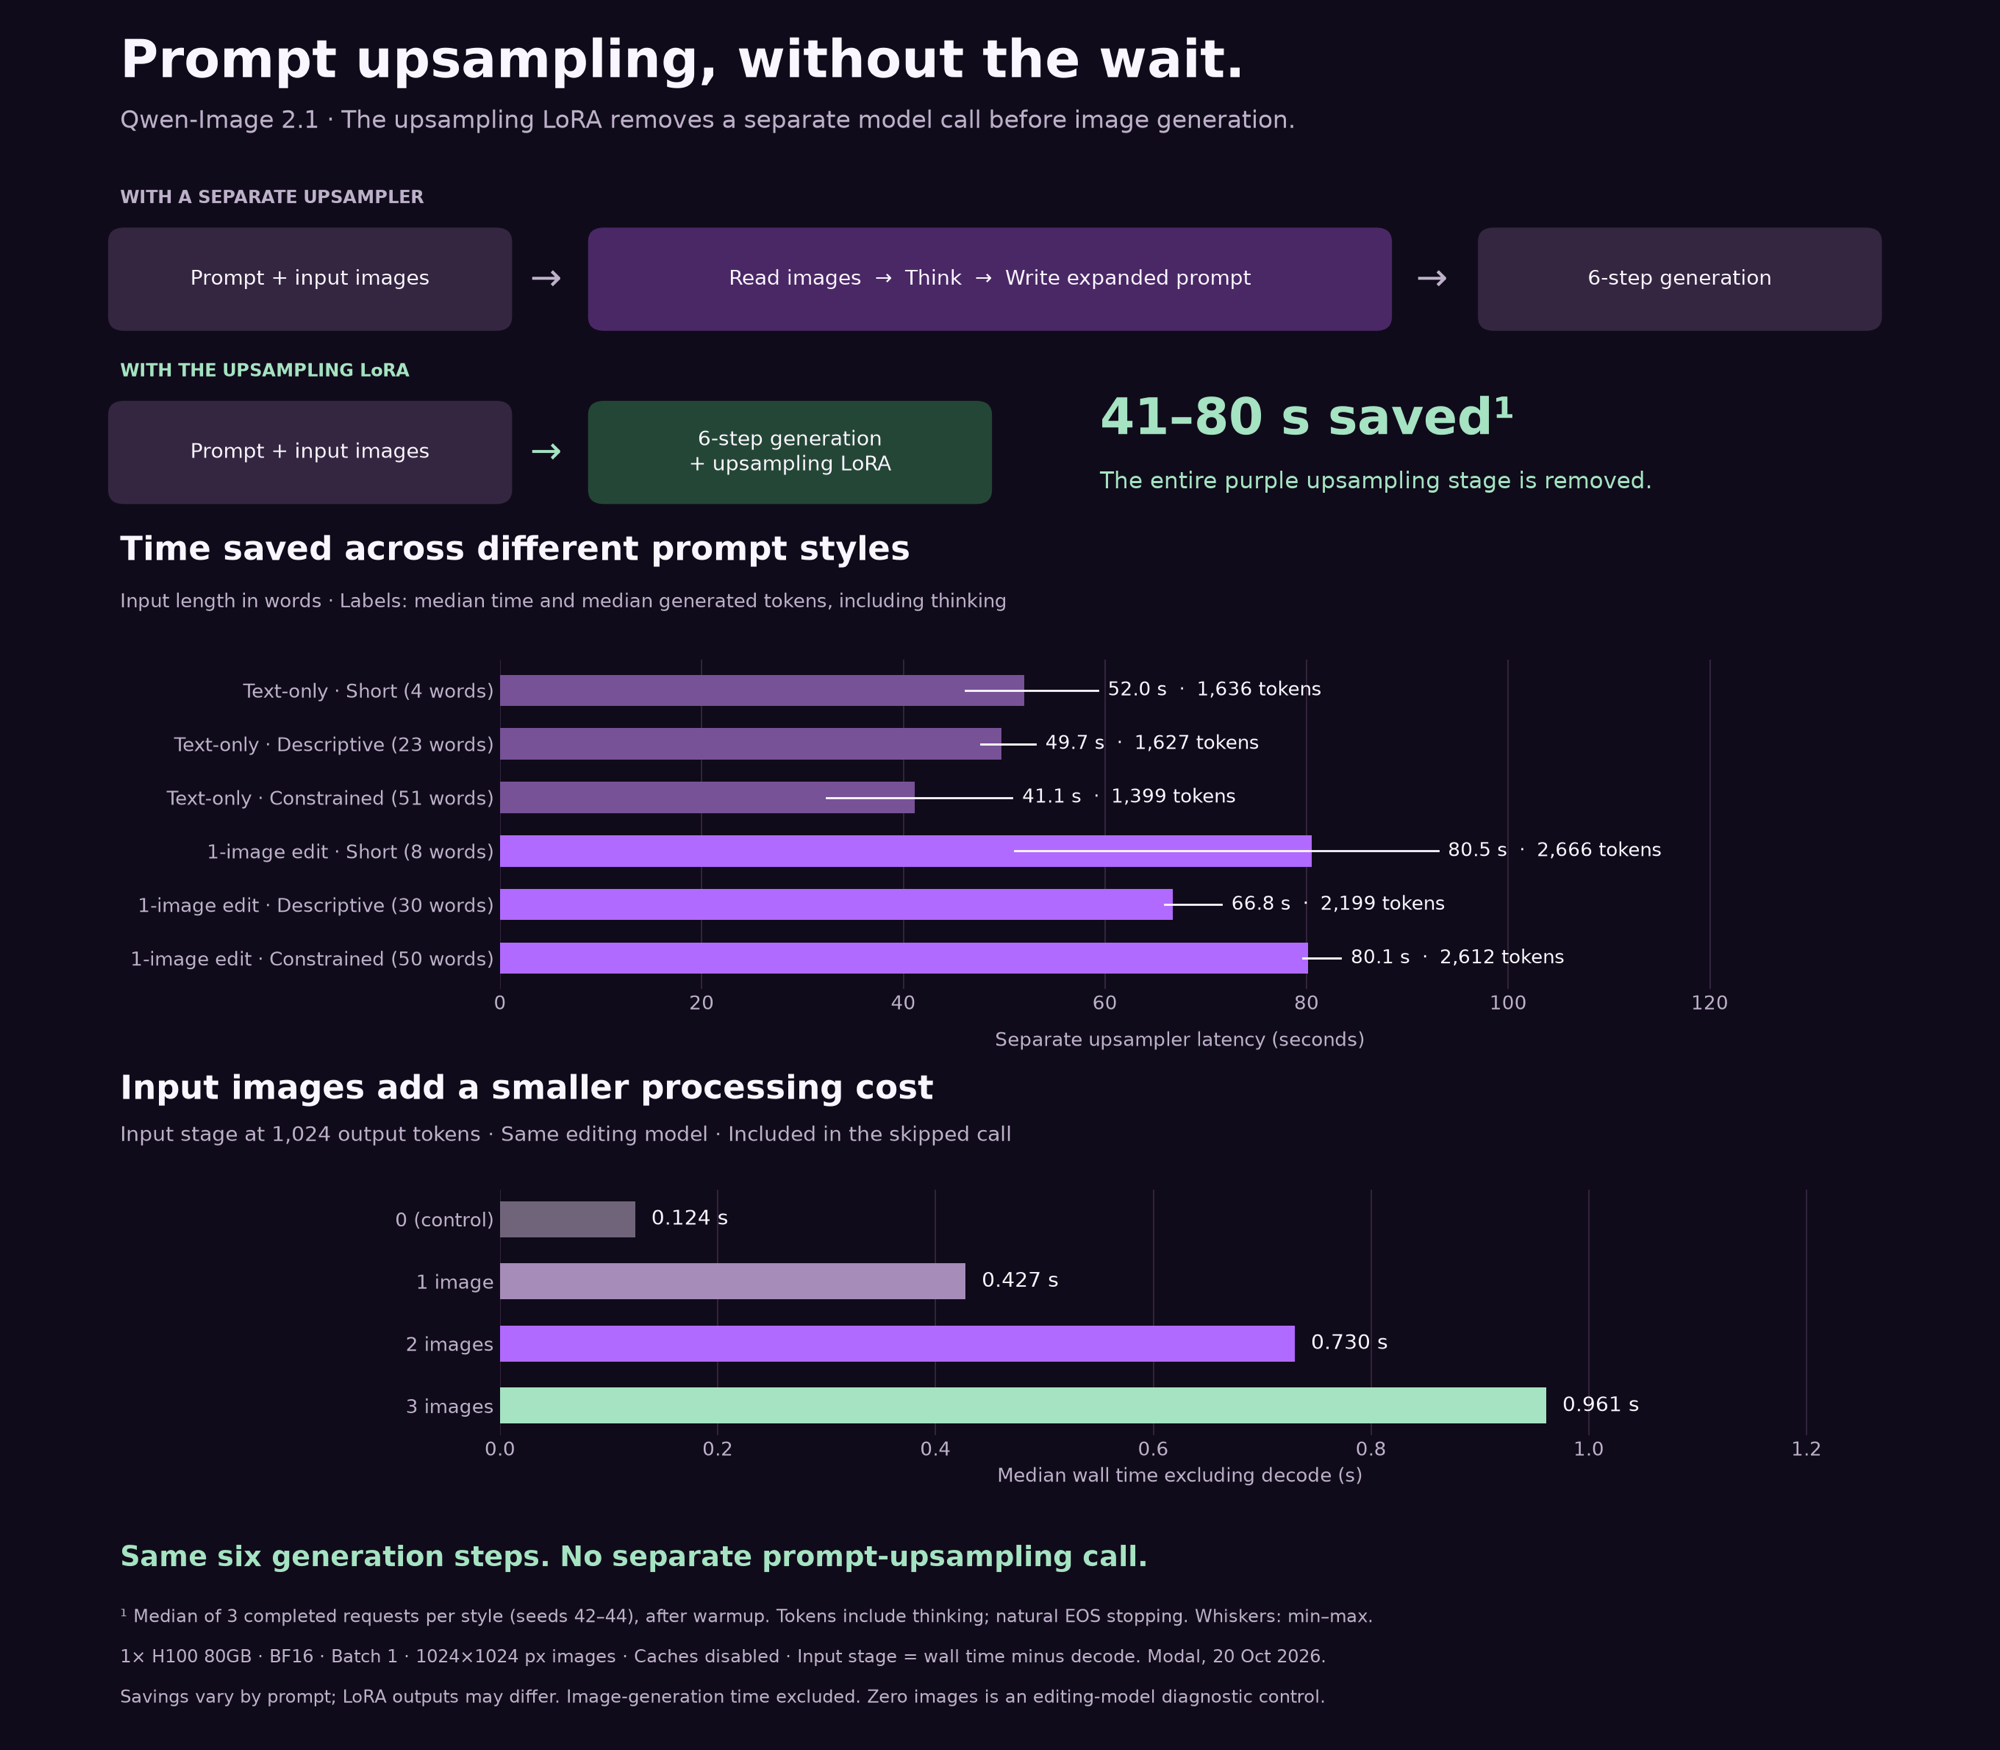
Отдельное измерение шага апсемплинга из карточки, который должен заменить адаптер v0.2.
Карточка аккуратно формулирует заявление. Она называет это первой дистилляцией, устраняющей необходимость в отдельном проходе апсемплинга промпта, а затем указывает, что адаптер может не воспроизводить в точности то, что сделал бы настоящий апсемплер, и обещает дополнительные работы. Pruna также измерила апсемплер отдельно, с официальными усилителями Qwen-Image-2.1-PE-T2I и PE-I2I, и предупреждает, что сложение двух медиан не даёт сквозного показателя.
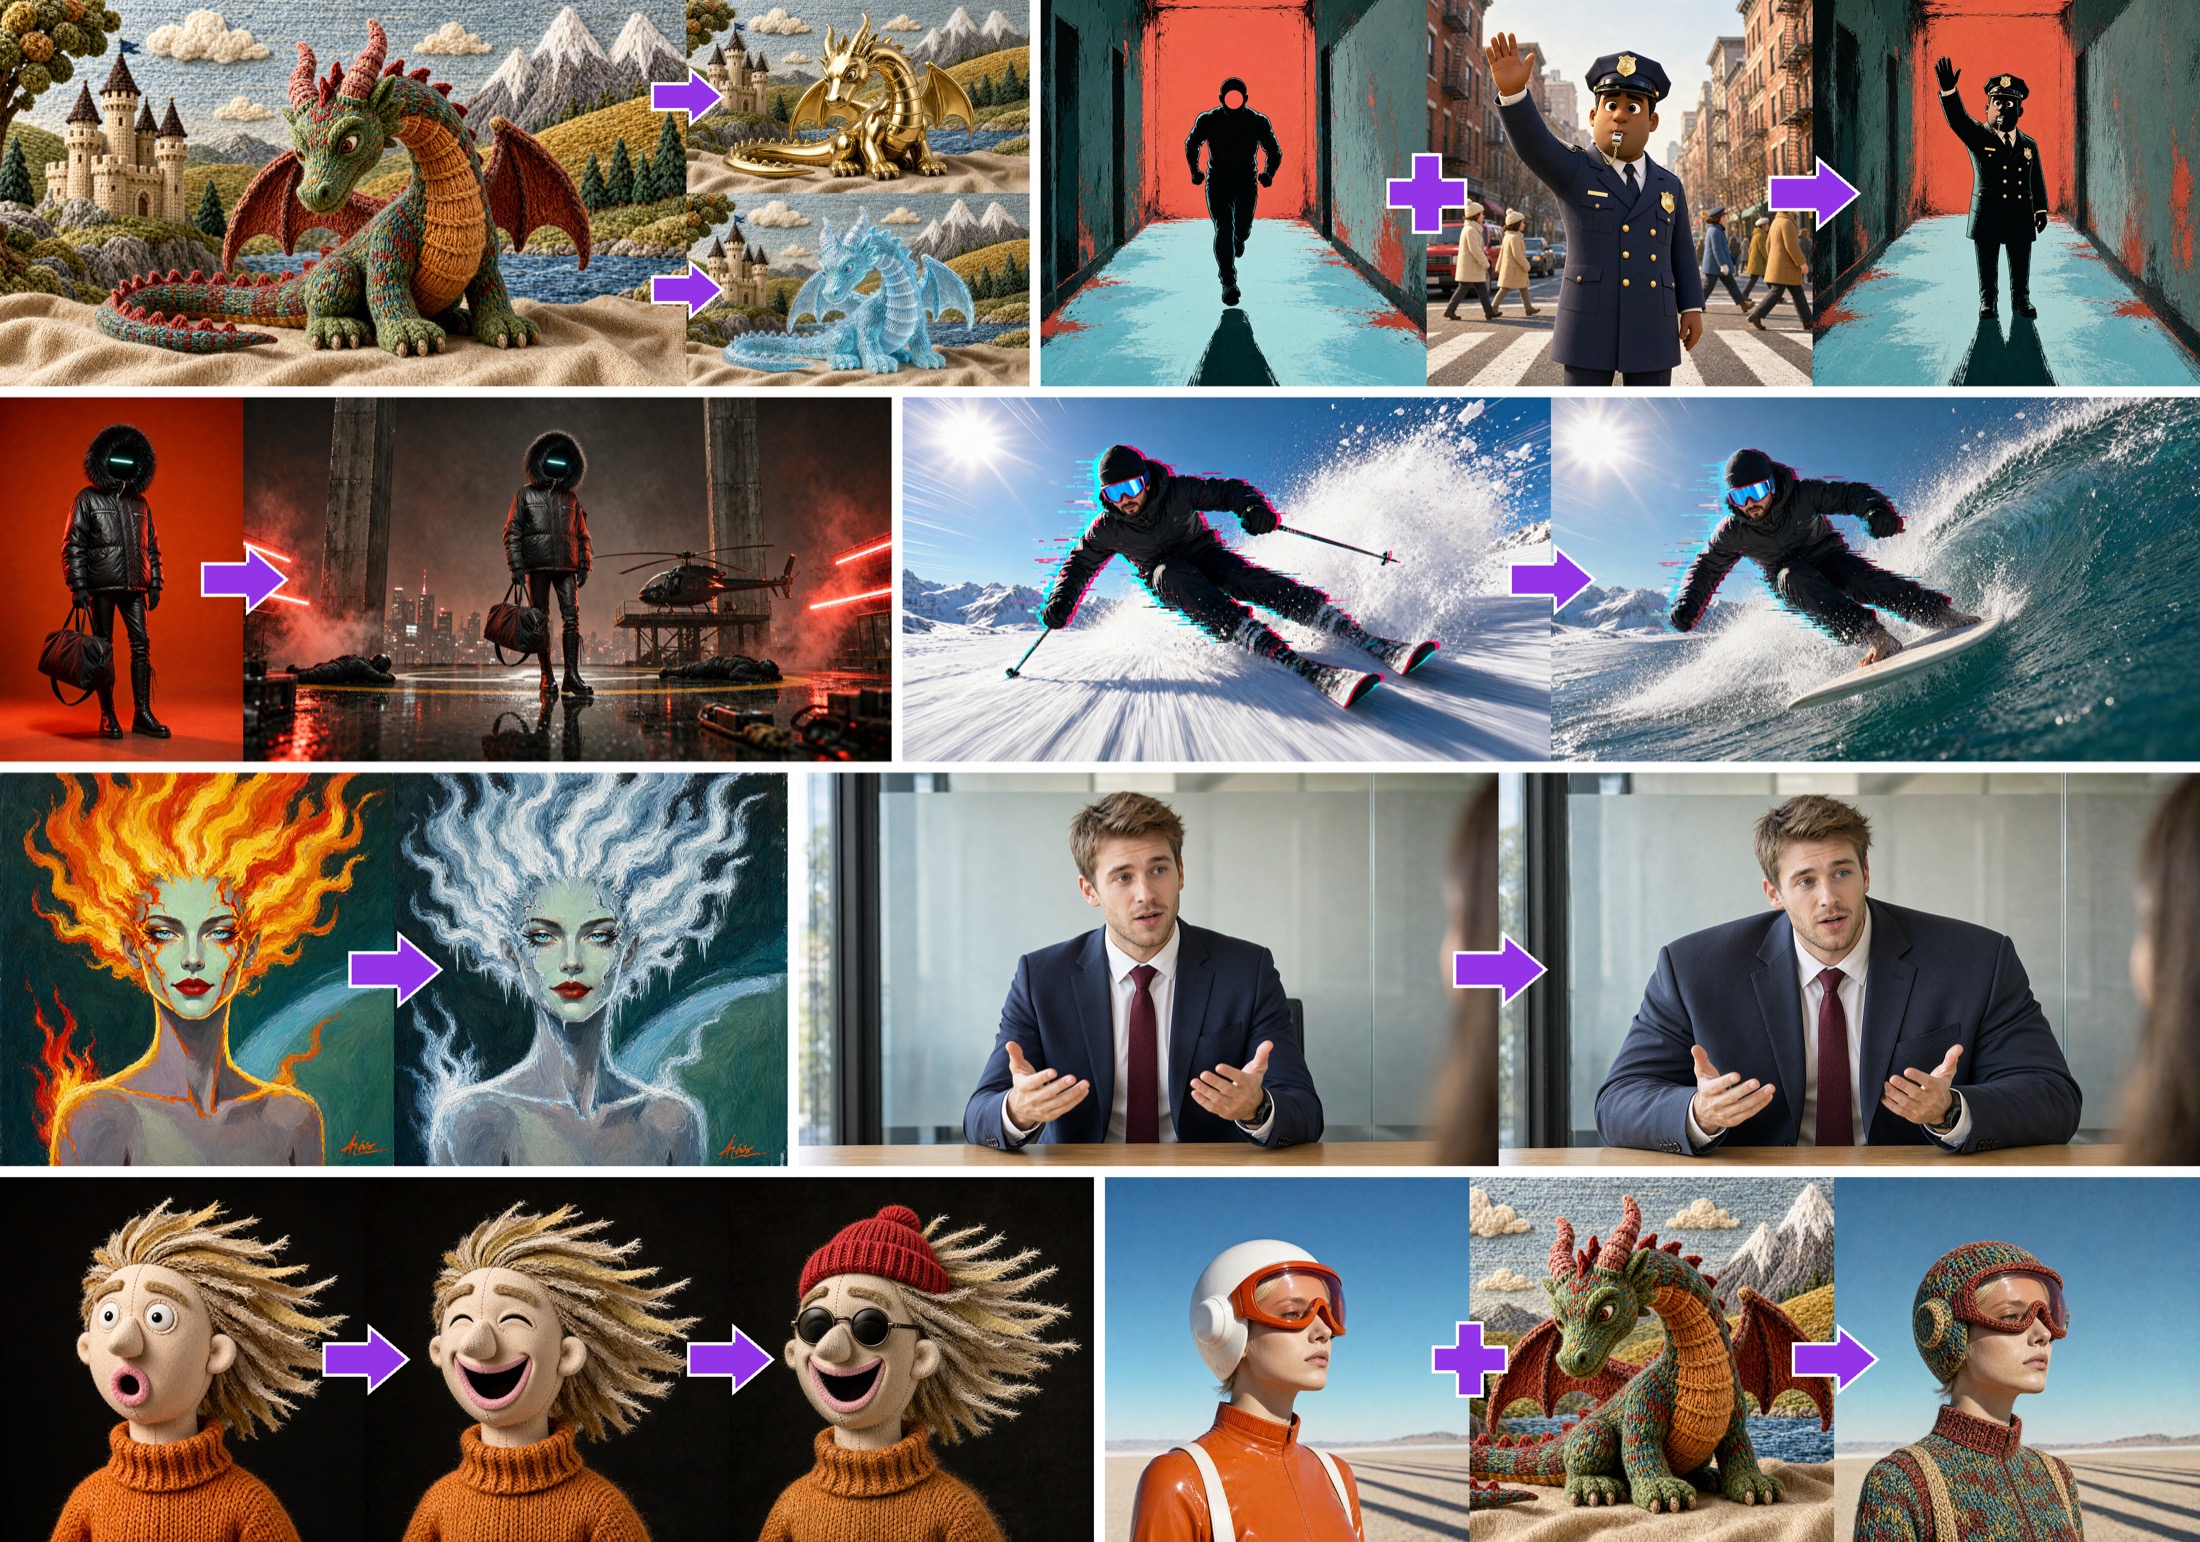
Результаты редактирования из официальной карточки: задача, под которую настроен обычный 6-шаговый адаптер.
Официальный экспорт для ComfyUI
В репозитории ComfyUI лежат четыре bf16-адаптера, по одному на каждый вариант, и шесть рабочих процессов: текст-в-изображение и редактирование изображений для 6-шагового v0.2, 8-шагового v0.1 и 5-шагового v0.1. Каждый рабочий процесс загружает один адаптер с силой 1.0 через нативную ноду LoraLoaderModelOnly, выполняет выборку с euler при CFG 1 и использует расписание ManualSigmas. Пользовательские ноды не требуются.
Структура та же, что уже есть у пользователей ComfyUI для Qwen-Image 2.1, с базовым checkpoint из Comfy-Org/Qwen-Image-2.1:
ComfyUI/
└── models/
    ├── diffusion_models/
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── loras/
    │   └── p_q_image_2.1_6_steps_v0.2_comfyui_bf16.safetensors
    ├── text_encoders/
    │   └── qwen3vl_8b_int8_convrot.safetensors
    └── vae/
        └── qwen_image_2.1_vae_bf16.safetensors
В карточке указан базовый checkpoint, а не Turbo, и одно расписание на адаптер:
| Адаптер | ManualSigmas |
|---|---|
| v0.2, 6 шагов | 1.0, 0.961054, 0.918949, 0.769302, 0.545554, 0.222292, 0 |
| v0.1, 8 шагов | 1.0, 0.933333, 0.857143, 0.769231, 0.666667, 0.545455, 0.4, 0.222222, 0 |
| v0.1, 5 шагов | 1.0, 0.94, 0.857143, 0.666667, 0.4, 0 |
Одно и то же расписание покрывает оба 6-шаговых варианта: в ComfyUI вся разница между ними сводится к переключению lora_name в рабочих процессах v0.2 с 6-steps на 6-steps-upsampled.
Что не изменилось
- Охват обучения по-прежнему 1K. Адаптеры обучались при 1024 с максимум тремя референсными изображениями для редактирования. Pruna рекомендует начинать с 1024x1024 и считает 2K и большее число референсов выходом за пределы охвата, где качество может варьироваться.
- До 6,3 раза быстрее остаётся главным показателем, без CFG и без негативного промпта. Графики v0.2 содержат новые измерения, и в карточке отмечено, что они не сопоставлены с графиками v0.1.
- Ранг 64 по 232 линейным целям, включая
proj_out, обучение при альфе 128 с коэффициентом 2x, встроенным в экспортированные матрицы B. Именно поэтому силу нужно оставлять на 1.0. - v0.1 всё ещё на месте. 5-шаговый и 8-шаговый адаптеры не изменились, поэтому существующий рабочий процесс с конвертацией от сообщества можно перевести на официальные файлы без изменения расписания.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.