MOSS-Image: управление цветом и глубиной в ядре ComfyUI
Адаптер от сообщества управляет MOSS-Image с помощью карты плоских цветовых областей и карты глубины, начиная с чистого шума, а поддержка в ядре ComfyUI появилась в тот же день.
MOSS-Image это 5B модель текста и макета от OpenMOSS, которая вышла с реализацией в ядре ComfyUI на той же неделе. Существующие инструменты управления композицией: JSON-макет из рамок и LoRA редактирования для изменений по референсу. Ни один из них не отвечает на более простой вопрос: поместить этого человека здесь, в таком масштабе, стоящим перед тем столом.
Новый адаптер отвечает на него двумя картами вместо изображения. Цвет кодирует, где находится каждая область, глубина кодирует, насколько далеко каждая поверхность, а генерация по-прежнему начинается с чистого шума. Ничего из референсного изображения не копируется, поэтому фон берётся из промпта, а не из того рендера, с которого снимались карты.
Две карты как условие
Карточка модели описывает входы узко, и именно это делает адаптер пригодным к использованию:
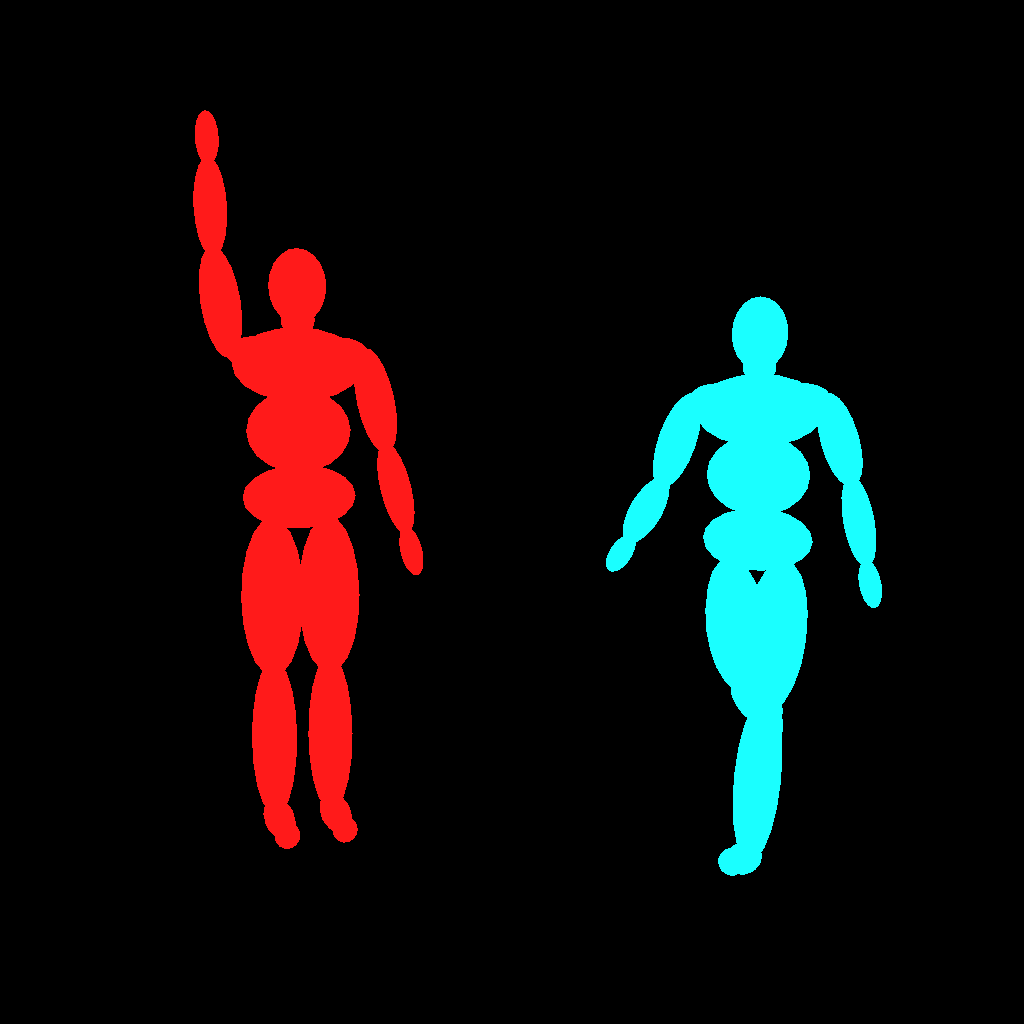
- Цветовая карта: RGB-изображение в размере вывода, где каждый объект или область получает один плоский цвет. Цвета это идентификаторы областей, а не цвета для закрашивания, чёрный означает «не задано».
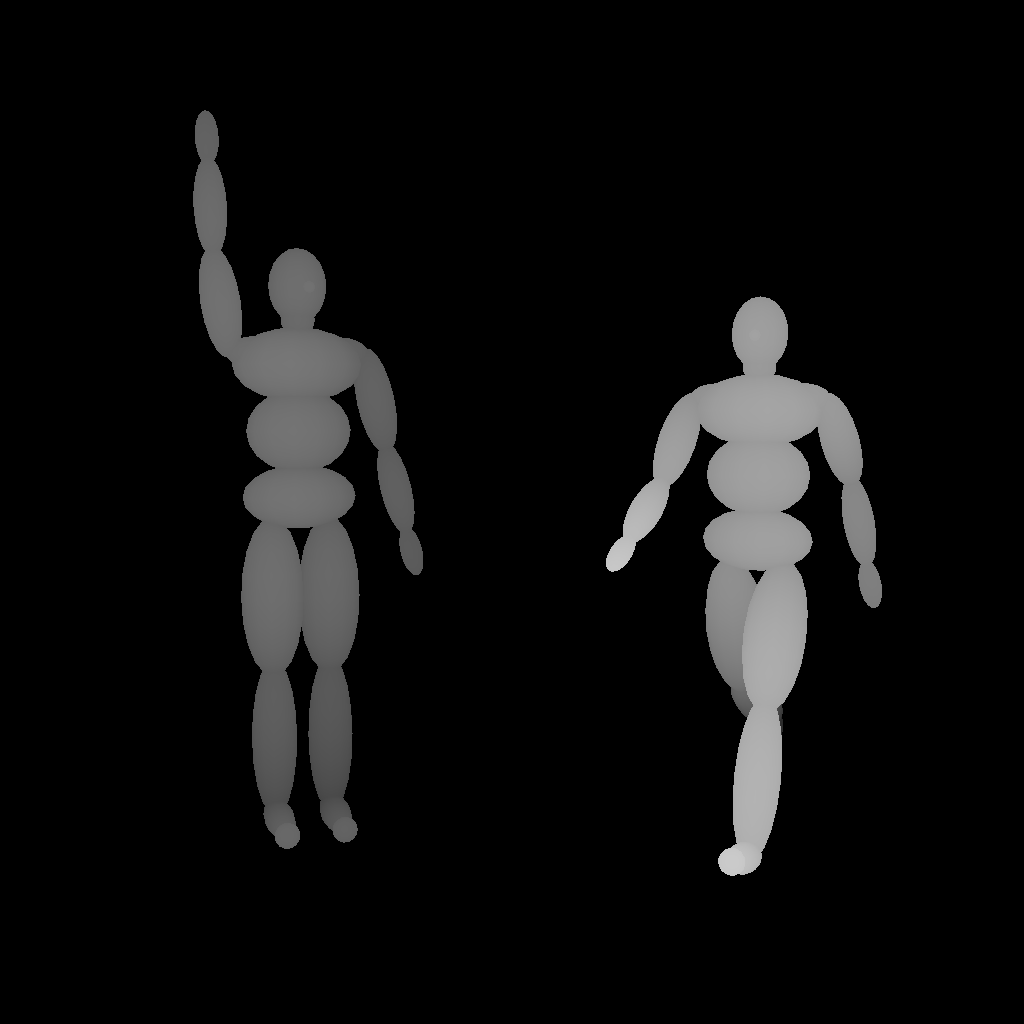
- Карта глубины: градации серого в размере вывода, ближнее белое.
- Любую из карт можно опустить. Адаптер обучался с отключением контроля: 35% только цвет, 35% только глубина, 20% обе карты, 10% ни одной, поэтому запуски с одной картой остаются в пределах обучающего распределения.
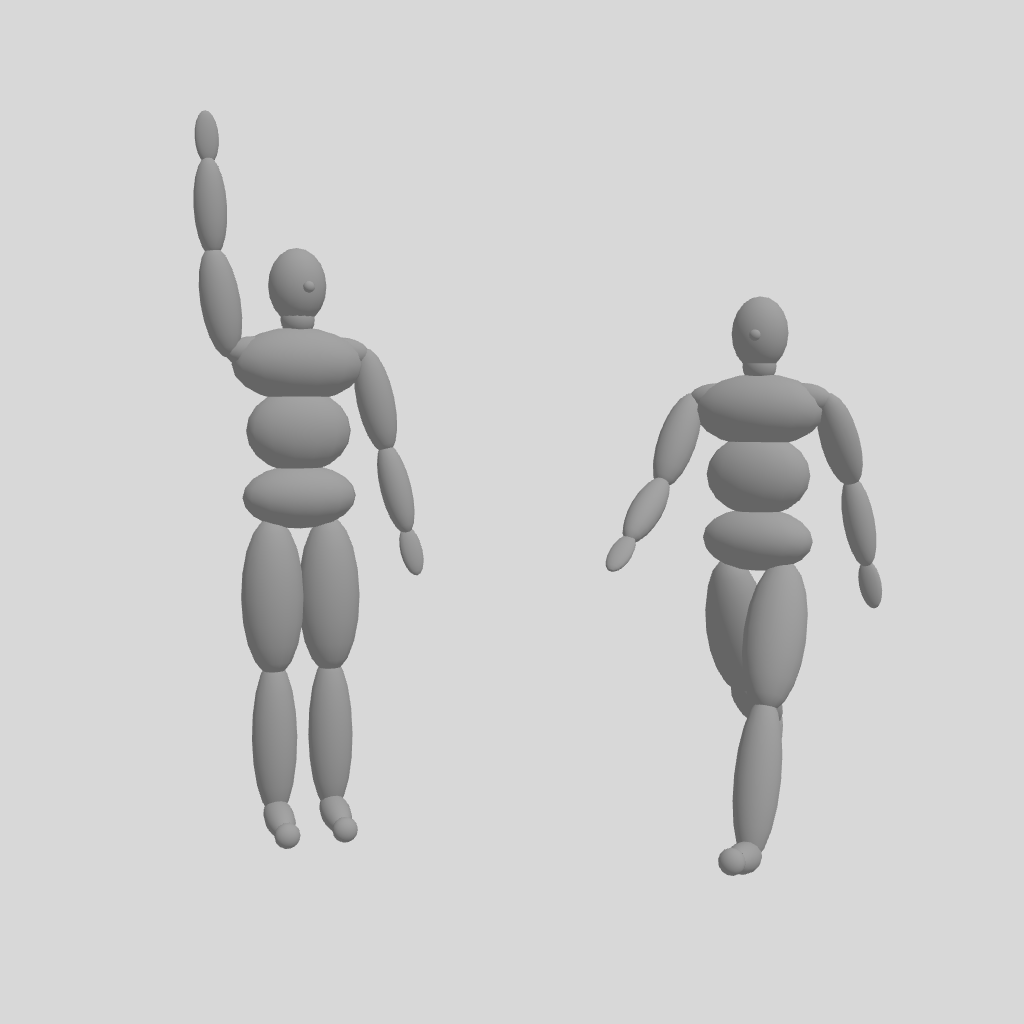
Каждая сцена создаётся в редакторе манекенов на three.js, который экспортирует затенённый рендер, цветовой проход и проход глубины вместе:
 |  |  |
|---|---|---|
| Исходный рендер | Карта цветовых областей | Карта глубины, ближнее белое |
Важное сравнение с image-to-image. Подача 3D-рендера в проход img2img сохраняет макет, но также сохраняет плоский фон и серые поверхности рендера. С адаптером размещение, масштаб и поза следуют картам, а материал и освещение генерируются, поэтому опубликованные сцены это 3D-манекены, а не фотографии.
Как выглядит результат
Главная иллюстрация карточки это сетка одной и той же сцены с двумя людьми-манекенами, где контроль удерживается весь прогон или отключается на середине.
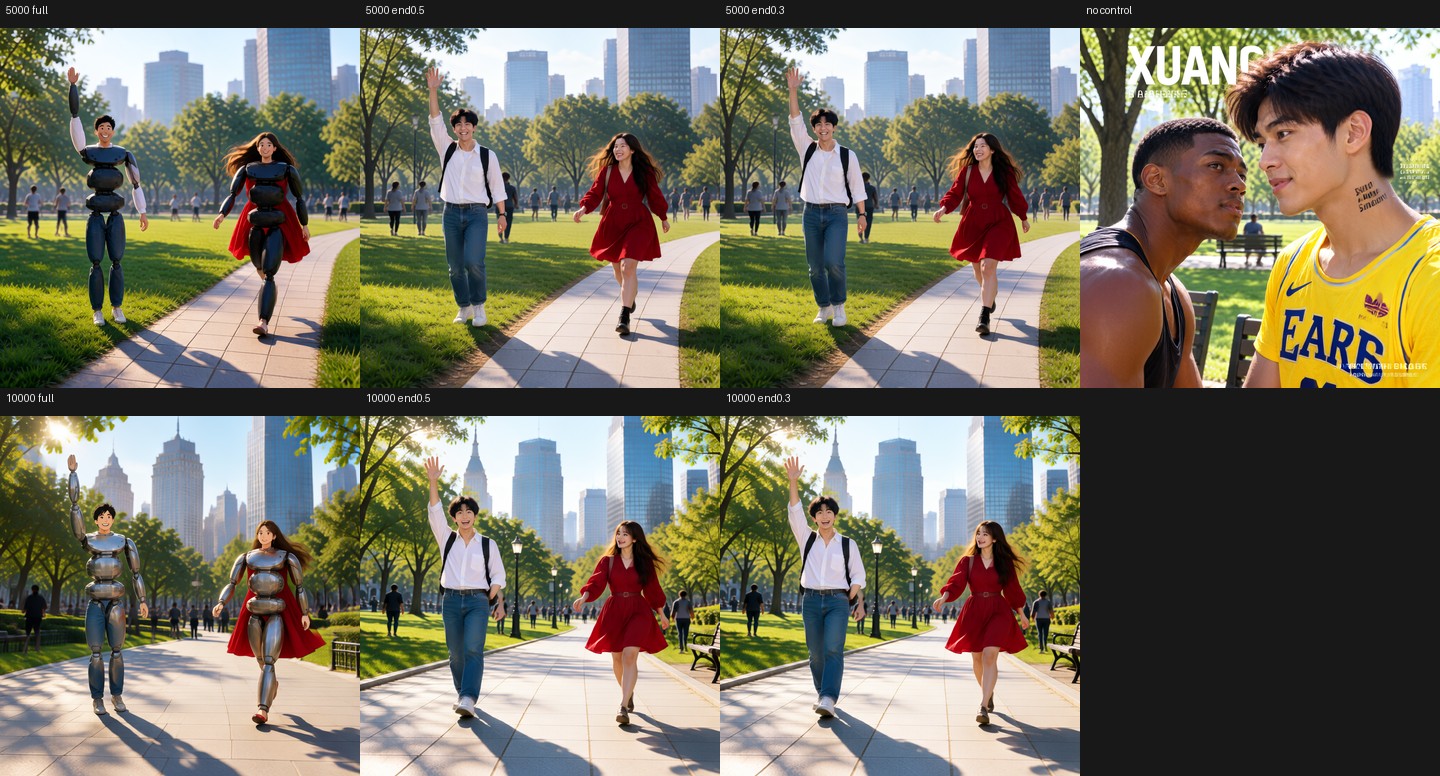
Опубликовано с адаптером: верхний ряд на 5 000 шагов, нижний ряд на 10 000; сравнивается контроль, удерживаемый до конца, завершение на 0.5, завершение на 0.3 и базовая модель без контроля. При удержании до конца поверхность манекена проступает; при завершении на 0.5 реальные люди оказываются там, где указывают карты.
Эта сетка также честно показывает главную слабость адаптера. Контроль на весь прогон воспроизводит манекен, потому что обучающие карты глубины получены с реальных фотографий, и ничто в картах не говорит «перестань быть деревянным». Завершение контроля на половине шагов сохраняет макет и позволяет оставшимся шагам проработать кожу, одежду и фон.
Тот же адаптер только с картами и без промптов для отдельных областей даёт другой режим отказа, задокументированный в карточке: с цветовой картой в стиле манги макет панелей уплывает, а текст деградирует на более поздних чекпойнтах.
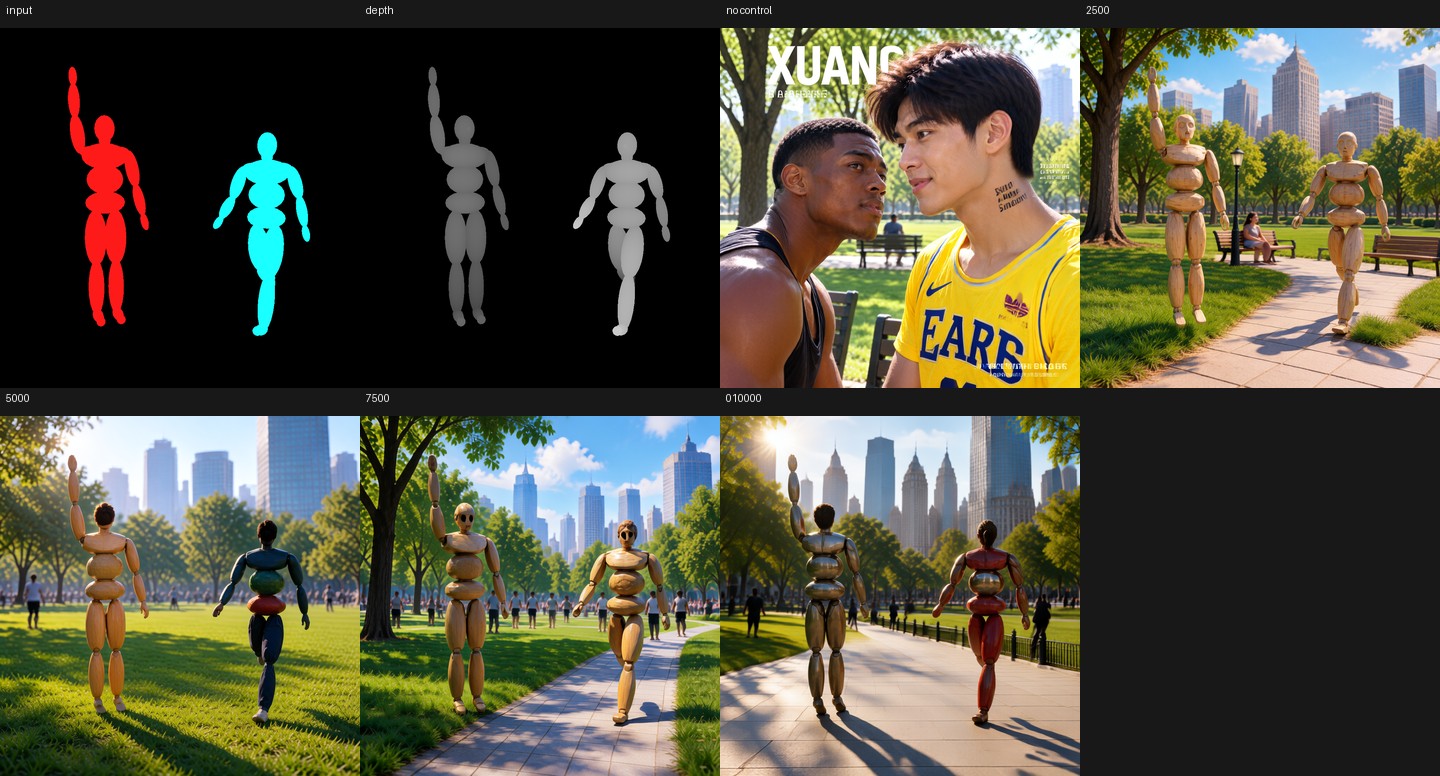
Сцена с двумя людьми с использованием карт без промптов для отдельных областей. Источник: darask0/MOSS-Image-color-depth-control
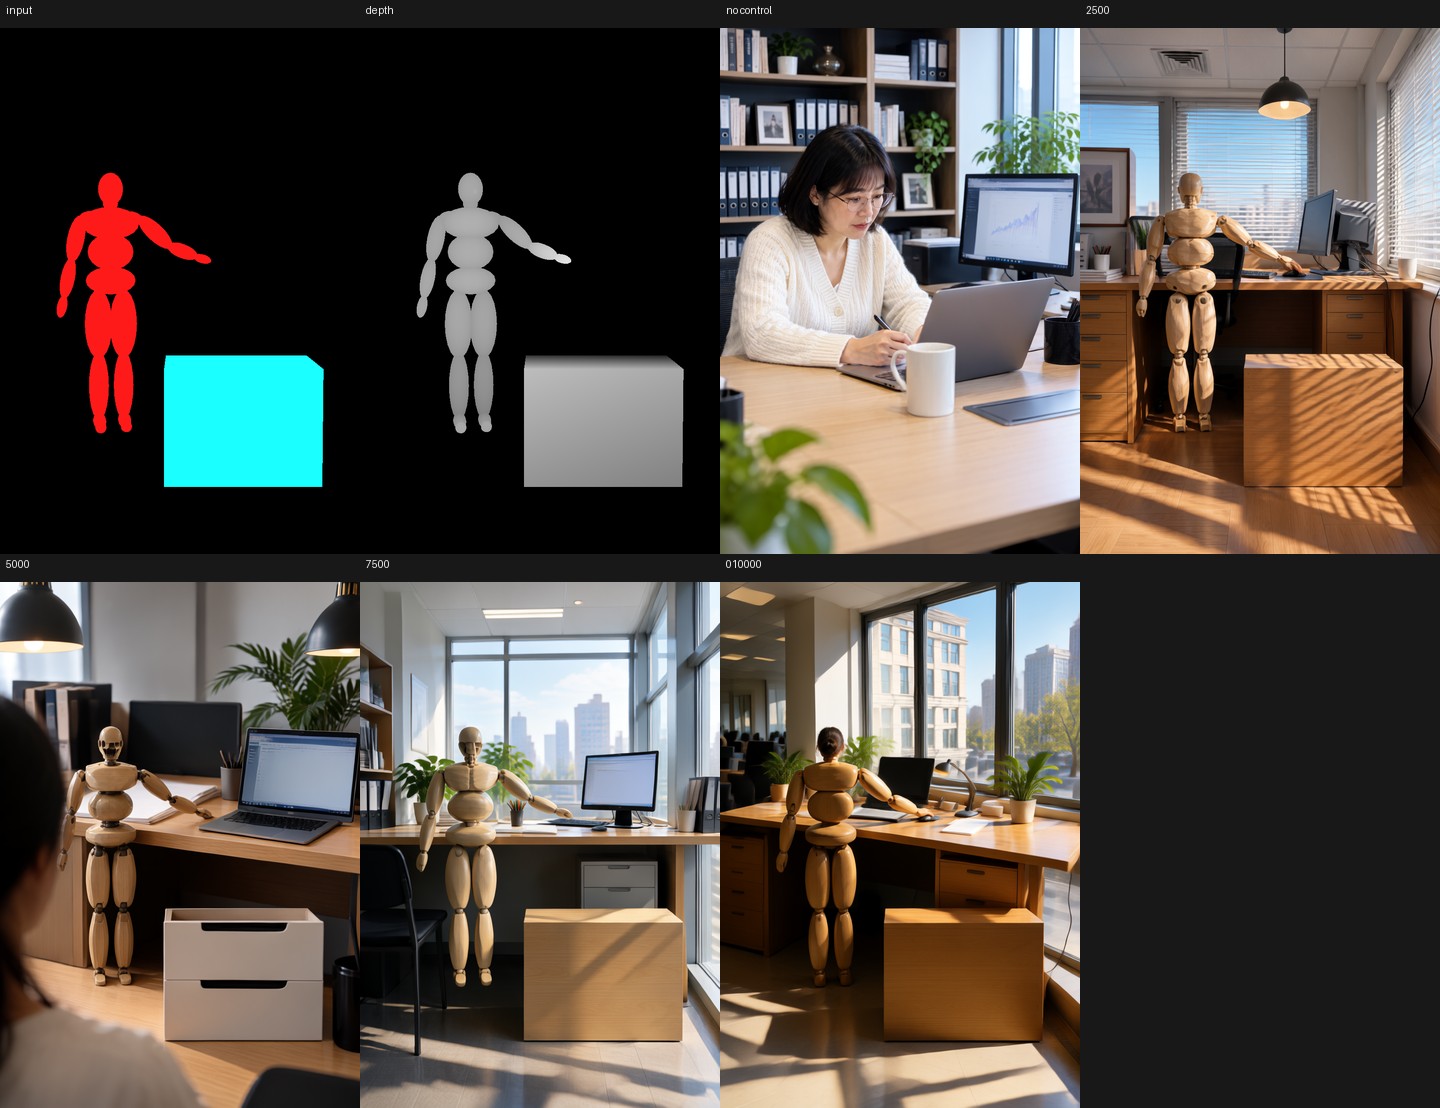
Вторая опубликованная сцена, человек за столом, снова только с картами.
Путь через ядро ComfyUI
PR #17206 от Kijai, влитый 19 октября в 22:15 UTC, добавляет один узел: MOSS-Image Color/Depth Control (MOSSImageControl), экспериментальный, в категории model/conditioning/moss_image. Он принимает положительное и отрицательное условие, VAE, необязательный color_map, необязательный depth_map, а также strength, start_percent и end_percent, и возвращает оба потока условий.
Граф это обычный граф MOSS-Image с двумя дополнениями. Адаптер загружается через стандартный загрузчик LoRA на diffusion-модель, а узел контроля стоит между кодированием текста и сэмплером. start_percent и end_percent это эквивалент в ядре для color_end и depth_end из карточки, поэтому задокументированные 0.5 для синтетических входов и 1.0 для карт, снятых с реальных изображений, напрямую переходят в значения узла.
Механизм стоит знать, потому что он объясняет формат файла. Адаптер расширяет вход video_embedder модели с 128 до 384 каналов: зашумлённый латент FLUX.2 VAE в первой трети, латент цветовой карты во второй, латент карты глубины в третьей. PR добавил в класс модели MOSS-Image метод concat_cond, который апсемплит то, что передаёт узел, добавляет результат к шуму и подставляет нулевой латент, когда карта отсутствует, поскольку нулевой вход для линейного эмбеддера это в точности «нет контроля». Он также добавил в lora_convert.py преобразование, которое превращает расширенные ключи video_embedder в патчи замены, а не в прибавления, так как эмбеддер заменяется, а не подправляется.
Промпты для отдельных областей остаются отдельным путём, существовавшим до этого PR: MOSS-Image Layout Prompt строит JSON-макет из рамок, созданных узлом Create Bounding Boxes, где подпись каждой рамки служит её промптом. Карточка адаптера рекомендует сочетать карты контроля с этими промптами для областей, и опубликованные примеры были сгенерированы именно так.
Поддержка влита после тега v0.42.1, поэтому для установленного релиза нужна сборка новее этого тега.
Настройки из карточки
| Настройка | Значение | Почему |
|---|---|---|
| Чекпойнт адаптера | moss-control.safetensors | 10 000 шагов, рекомендуемый |
strength | 1.0 | обученное значение; 0.0 равно отсутствию карт |
end_percent (карты 3D-манекенов) | 0.5 | контроль задаёт макет и позу, затем отпускает |
end_percent (карты с реальных фото) | 1.0 | удерживать контроль весь прогон |
| Промпты областей | по одному на цвет | без них карта формы манекена будет нарисована как манекен |
Более ранние чекпойнты это альтернатива доле завершения: 2 500 шагов следует за картой менее строго и меньше похож на манекен, 7 500 и 10 000 следуют строже. Все четыре есть в репозитории.
Для скорости задокументированная пара это 4-шаговый адаптер rapid-moss того же автора из darask0/MOSS-Image_4-step_adapter_lora, о котором сайт писал 17 октября: карточка сообщает о примерно 1,8 с на изображение 1024² на RTX PRO 6000 с ним.
Как он обучался
Заголовок safetensors содержит 526 тензоров: LoRA-пары ранга 64 с alpha 64 на q, k, v, o, ffn_up_gate и ffn_down всех 42 слоёв DiT (252 пары), пять проекций на блок в двух блоках текстового эмбеддера (10 пар), а также замещающие вес и смещение video_embedder.
Обучение шло на трансформере MOSS-Image Base, замороженном в FP8, с эмбеддером, расширенным до 384 входов, и его столбцы контроля инициализированы нулями. Данные это 10 000 изображений Krea 2 Turbo в разрешении класса 1024 при пяти соотношениях сторон вместе с их подписями; цветовые карты получены Mask2Former Swin-L на панорамной сегментации COCO, карты глубины от Depth Anything V2 Large. Оптимизация: AdamW с 1e-4 и 10-кратной скоростью обучения на столбцах контроля эмбеддера, batch 1, 10 000 шагов по 0,8 с на шаг на одной RTX PRO 6000, логит-нормальное распределение таймстепов MOSS и 10% пустых подписей. Конфиг и скрипт обучения поставляются вместе с весами.
Ограничения, о которых стоит знать
Карточка необычно прямо говорит о том, что не работает:
- Вид манекена. Контроль на весь прогон по 3D-рендеру воспроизводит деревянную или металлическую поверхность рендера, поскольку обучающая глубина бралась с фотографий.
- Точность позы грубее карты. Пальцы и лица генерируются, а не проецируются.
- Одного контроля недостаточно для макетов. На цветовой карте в стиле манги он теряет структуру панелей и искажает текст начиная с 7 500 шагов.
- Комбинирование ограничено в рантайме Hayate автора. В карточке указано, что там адаптер нельзя сочетать с img2img или инпейтингом, только одно или другое.
- Стилевой приор фотографический. Обучающие данные это вывод Krea 2 Turbo.
- Без бенчмарка. По карточке, оценка проводилась на нескольких сценах и двух сидах.
Адаптер также не является официальным релизом OpenMOSS: веса, код обучения и референсный рантайм принадлежат одному автору, а поддержка в ядре это та часть, которую проверили мейнтейнеры ComfyUI.
Доступность
- Адаптер: darask0/MOSS-Image-color-depth-control, четыре чекпойнта, около 30 лайков через неделю после загрузки.
- Ядро ComfyUI: PR #17206, влит 19 октября 2026 года, после релиза v0.42.1.
- Пара для скорости: darask0/MOSS-Image_4-step_adapter_lora.
- Базовые модели: MOSS-Image-Base и MOSS-Image-SFT, с однофайловыми весами ComfyUI в Comfy-Org/MOSS-Image.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.