MOSS-Image Edit HQ v5: LoRA для редактирования в двух форматах ComfyUI
Community-LoRA для редактирования MOSS-Image дошла до v5: masked loss, бюджет референса 256 токенов и два формата ComfyUI, плюс сетки оценки и демо Space.
MOSS-Image: 5-миллиардная модель текста и компоновки от OpenMOSS, о которой писали на релизе, через две недели получила редактирование по инструкции благодаря community-адаптеру ранга 64. Этим адаптером был chinoll/Moss-Image-Edit, и открытым оставался вопрос: насколько поведение редактирования определяется именно этим единственным набором данных. MOSS-Image-Edit-HQ отвечает на него, заново выстраивая эту возможность на других данных и сравнивая себя с оригиналом.
Что на самом деле меняет v5
Репозиторий это журнал пяти веток обучения, а не один релиз. Каждая ветка продолжала предыдущий чекпойнт, и каждая сохранена на диске вместе со своими сэмплами, поэтому различия можно проверить, а не просто принять на слово.
| Ветка | Данные и изменения | Результат |
|---|---|---|
| v1 | warm-start плюс обучение с нуля, данные с несколькими референсами, 1024px | не прошла оценочный порог, chinoll лучше сохранял идентичность |
| v2 | точечные строки OmniEdit, lr 1e-5, 300 шагов | заменена на v3 |
| v3 | точечные строки ConceptEdit-12M, отфильтрованные до 6 000, 700 шагов | заменена на v4 |
| v4 | данные удаления, лиц и окружения, 4 644 строки, masked loss с inverted_mask_prior | заменена на v5 |
| v5 | 5 644 строки с полными описаниями сцены, pixel-diff маски, masked loss, бюджет референса 256 токенов, 1 200 шагов | текущий чекпойнт |
Самое важное изменение в v5: бюджет референса. Базовая MOSS-Image даёт референсному изображению 144 токена; эта ветка поднимает его до 256, и именно отсюда, как утверждается, берётся прирост в сохранении идентичности и мелких деталей. Остальное в v5 это работа с данными: pixel-diff маски, чтобы неизменённые области оставались близки к источнику, и полные описания сцены, собранные из метаданных ConceptEdit, чтобы инструкция описывала весь кадр, а не только правку.
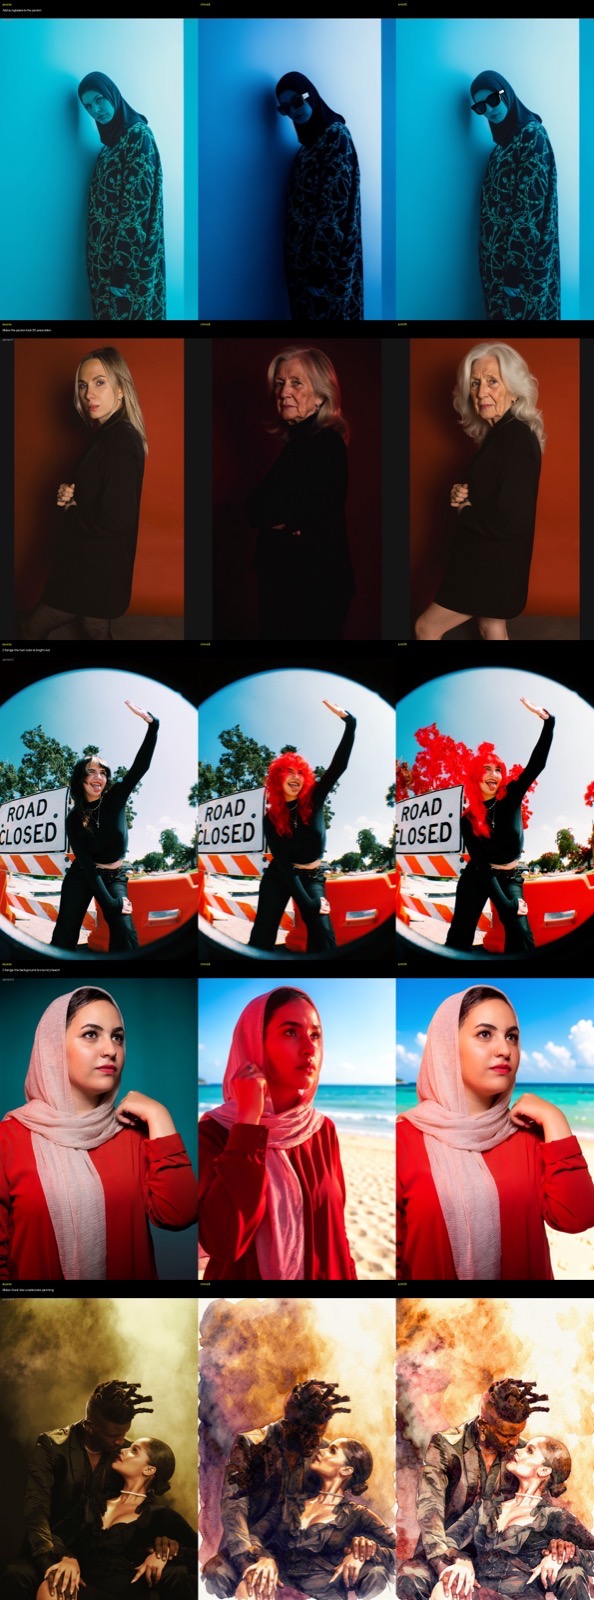
Каждая строка начинается с исходного изображения и продолжается результатом v5. Источник: akhaliq/MOSS-Image-Edit-HQ
Чекпойнты весят по 495 МБ каждый в формате peft: финальный плюс шаги 250, 500, 750 и 1000. Обучение шло на ai-toolkit на коммите 14f8f95, по одному GPU на ветку, с замороженным текстовым энкодером и обязательным gradient checkpointing при 1024px. Данные обучения тоже опубликованы: 6 000 отфильтрованных строк ConceptEdit-12M в виде TAR-шардов, а конфиги веток лежат в репозитории.
Два пути в ComfyUI, два формата LoRA
Этот релиз требует внимательного чтения потому, что одни и те же веса поставляются в двух форматах, которые загружаются разными механизмами ComfyUI.
Нативный путь использует weights/armV5/armV5.safetensors как обычную LoRA: положите файл в models/loras/, добавьте LoRA loader после Load Diffusion Model и кодируйте экспериментальным узлом Text Encode MOSS-Image Edit с edit_format, установленным в ai-toolkit. Референсы уменьшаются максимум до 384x384, прежде чем их увидит текстовый энкодер.
Путь через плагин использует armV5-moss-edit-lora.safetensors: он кладётся в models/model_patches/ и загружается через Chenkin-x/ComfyUI-Moss-Image-Edit, тот же пакет узлов, который использует предыдущий адаптер. Этот пакет требует ComfyUI 0.42.3 или новее.
Нативный путь доступен только в текущей сборке master. PR #17296 от Kijai был смержен 22 октября и добавил узел редактирования, но новейший помеченный релиз v0.42.5 от 23 октября всё ещё поставляется со старым comfy_extras/nodes_moss_image.py без него, поэтому установленной версии придётся обновиться до ночной сборки, чтобы использовать edit_format = ai-toolkit. Оба рабочих процесса поставляются с уже заполненными именами файлов и настройками: для одного референса и для до четырёх.
| Настройка | Значение |
|---|---|
| Сэмплер | Euler, flow matching |
| Shift | 5.0 |
| Шаги | 50 (качество), 8 со стеком ускорения DMD |
| CFG | 3.0, поднимите до 3.5 или 4.0 при слабых правках |
| Слой SLG | 22 |
| Размер референса | разрешение источника в энкодер, максимум 384x384 |
| Выход | до 1024px |
Формат ai-toolkit не совпадает с форматом Moss-Image-Edit, который использует предыдущий адаптер, и карточка модели говорит об этом прямо: адаптер chinoll использует раздельные ключи q, k и v, тогда как ai-toolkit объединяет их, поэтому warm-start одного из другого требует точного блочно-диагонального слияния ранга 192. В репозитории есть конвертер, и сообщается о совпадении 336 из 336 тензоров после конвертации.
Где быстрее, а где нет
Совмещение LoRA редактирования с 8-шаговой DMD LoRA ускорения сокращает выборку до 8 шагов и CFG 1, ускоряя редактирование примерно в шесть раз. Вердикт самой карточки: проход в 50 шагов всё равно выигрывает: на 8 шагах добавление объектов ослабевает, а удержание цвета деградирует, так что быстрый путь подходит для черновиков.
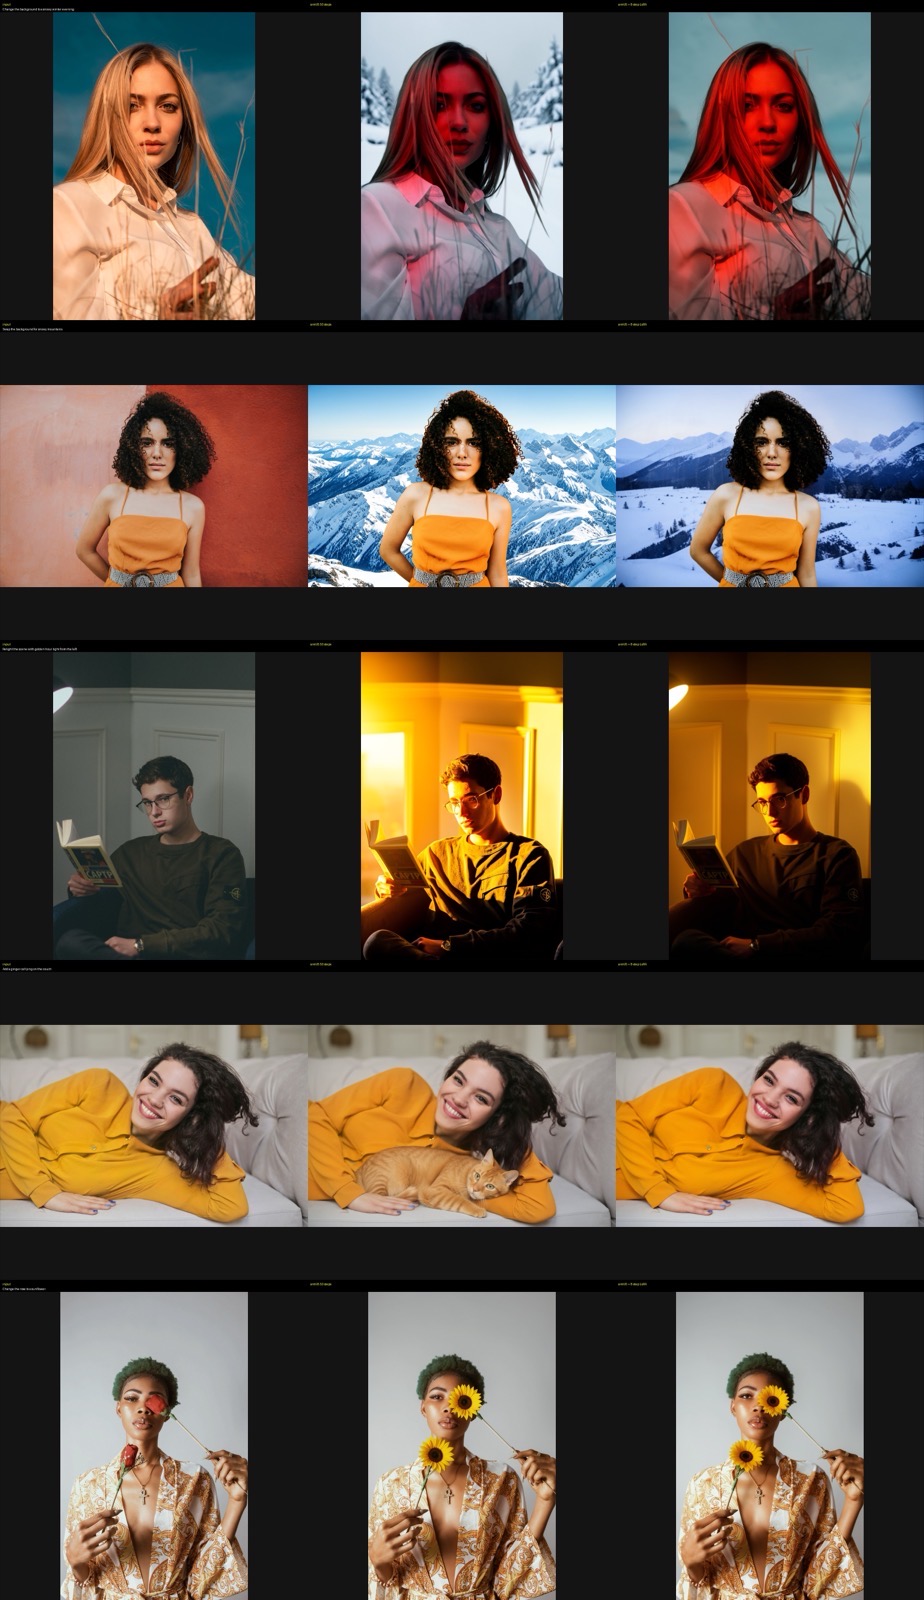
Вход, затем 50 шагов, затем 8-шаговый стек DMD. Источник: akhaliq/MOSS-Image-Edit-HQ
Демонстрация v5: одна инструкция на правку, отрендерено с настройками демо: 50 шагов и CFG 3.
Та же честность относится и к сравнениям. Заявленная цель проекта: превзойти chinoll/Moss-Image-Edit по качеству, и ветка v1 открыто не прошла этот порог по сохранению идентичности, прежде чем последующие ветки перешли на masked loss. Опубликованные сетки сравнивают v5 и с предыдущим адаптером, и с Krea 2, но это собственные наборы автора для оценки и демо Space, а не сторонний бенчмарк.
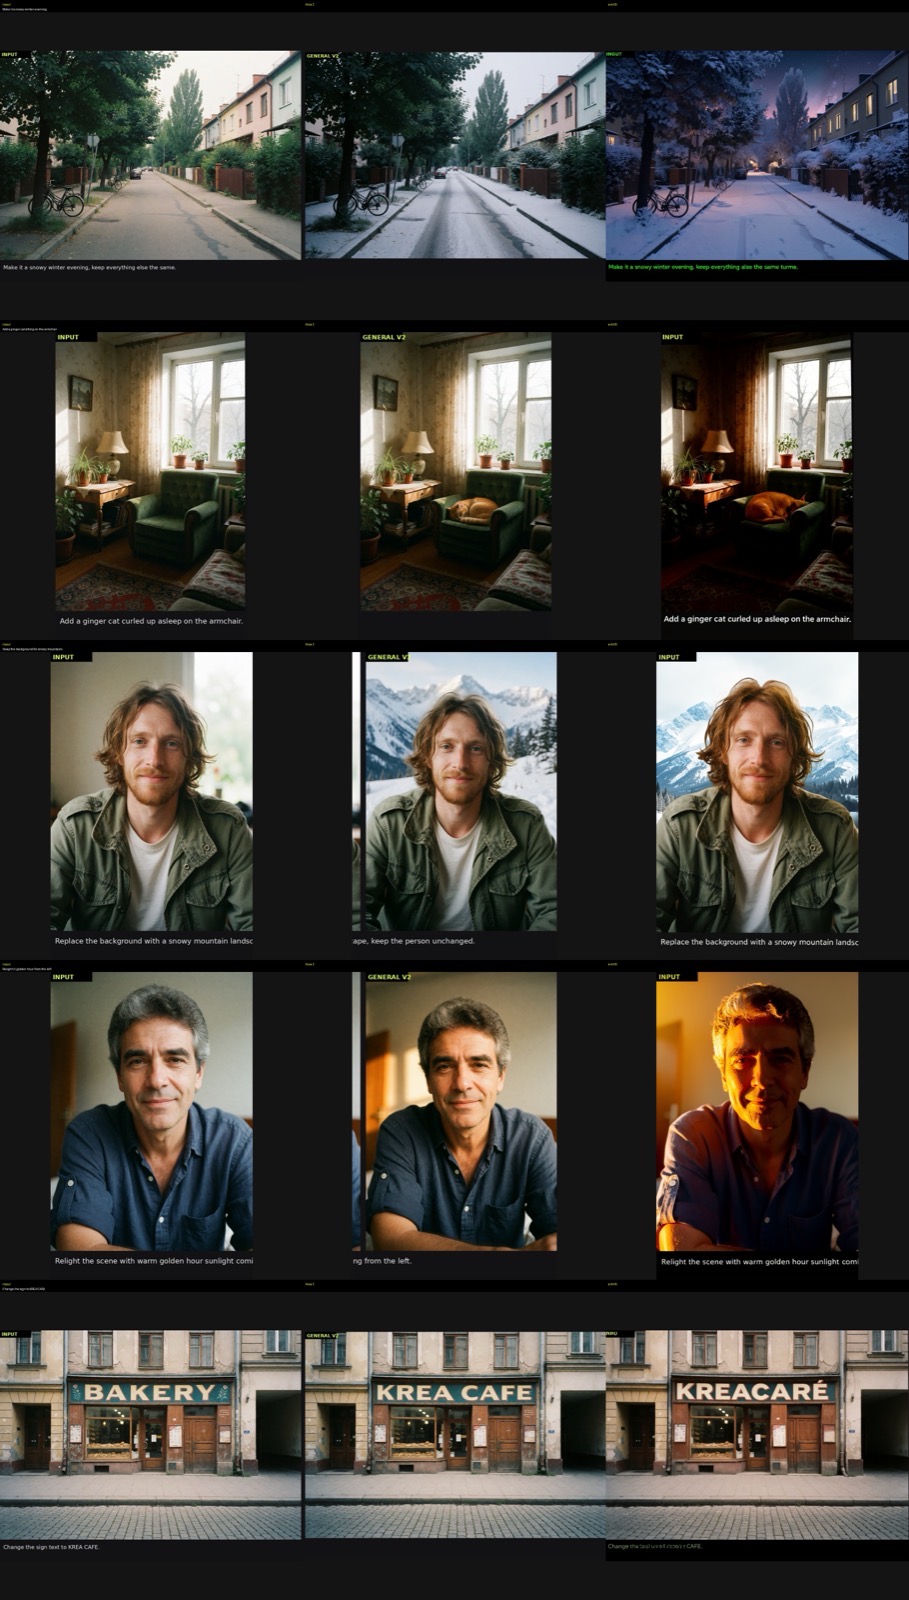
Правки v5 по промптам из шоукейса Krea 2 рядом с эталонными рендерами Krea 2. Источник: akhaliq/MOSS-Image-Edit-HQ
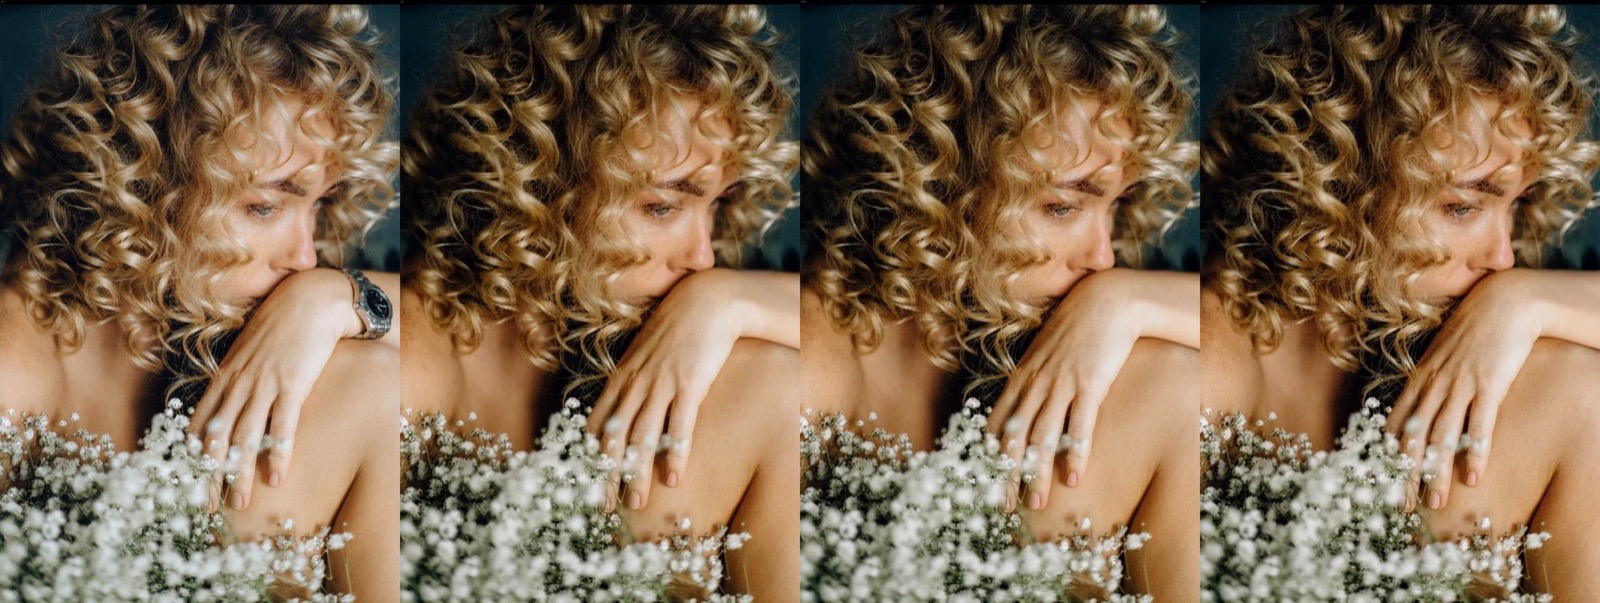
Примеры удаления объектов из репозитория. Источник: akhaliq/MOSS-Image-Edit-HQ
Для быстроты знакомства карточка также ссылается на демо Space на Gradio, где работают оба режима, качественный и 8-шаговый, так что компромисс можно проверить до загрузки 495 МБ.
Ограничения, о которых стоит знать
- VRAM: пайплайну нужно около 20 ГБ в bf16. Карточка прямо отвечает на очевидный вопрос: нет, она не запустится на 6 ГБ, даже с community-сборками базовой модели в int8.
- Базовая модель: обучение шло на MOSS-Image-SFT. Совместимость с Base и Kromoss указана как непроверенная, а нативный путь описан как надёжный.
- Обучение на одном референсе: архитектура принимает до четырёх референсов, но адаптер обучался на парах правок с одним референсом. Композиционирование человека или объекта из одной фотографии в другую явно не то, для чего он обучался.
- Цвет: известная особенность v3 завышать насыщенность относительно источника была описана пользователем в карточке модели, и против неё нацелена masked loss в v4.
- Область применения: правки атрибутов, удаление, освещение, лица и текст. Об изменении позы в релизе ничего не говорится, а именно об этом просили в первом комментарии к анонсу.
Ничто из этого не является релизом OpenMOSS. Веса, данные, сетки оценки и демо происходят от одного автора, и карточка говорит об этом прямо.
Доступность
- LoRA: akhaliq/MOSS-Image-Edit-HQ, v5 опубликована 25 октября 2026 года.
- Рабочие процессы:
armV5_workflow_single.jsonиarmV5_workflow_multi.json. - Демо: moss-image-edit-hq-demo на Hugging Face Spaces.
- Ядро ComfyUI: PR #17296, смержен 22 октября 2026 года, только master и ночная сборка.
- Пакет узлов: Chenkin-x/ComfyUI-Moss-Image-Edit, с ComfyUI 0.42.3 или новее.
- Данные и код обучения: moss-image-edit-conceptedit-packed плюс каталог
training/репозитория.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.