MOSS-Image Edit LoRA добавляет редактирование по инструкции в ComfyUI
Edit-LoRA ранга 64 даёт MOSS-Image редактирование по инструкции с одной-четырьмя референсами, а ядро ComfyUI в тот же день получило нативную поддержку таких адаптеров.
MOSS-Image это модель текста и раскладки на 5B параметров от OpenMOSS, о которой сайт рассказывал на релизе: разборчивый текст, JSON-боксы раскладки и реализация в ядре ComfyUI, вышедшая в ту же неделю. Чего у неё не было, так это способа взять готовое изображение и изменить его. Редактирование означало правки раскладки или control-адаптер, а не «наденьте на этого человека другой пиджак».
Новый адаптер закрывает этот пробел. Это релиз сообщества, а не OpenMOSS, но именно вокруг этой реализации мейнтейнеры ComfyUI выстроили поддержку в ядре.
Что меняет LoRA
Карточка модели прямо описывает охват: цвет, одежда, освещение, времена года и визуальный стиль, управляемые текстовой инструкцией и до четырьмя референсными изображениями. Инструкция говорит, что менять; референсы несут то, что должно остаться.
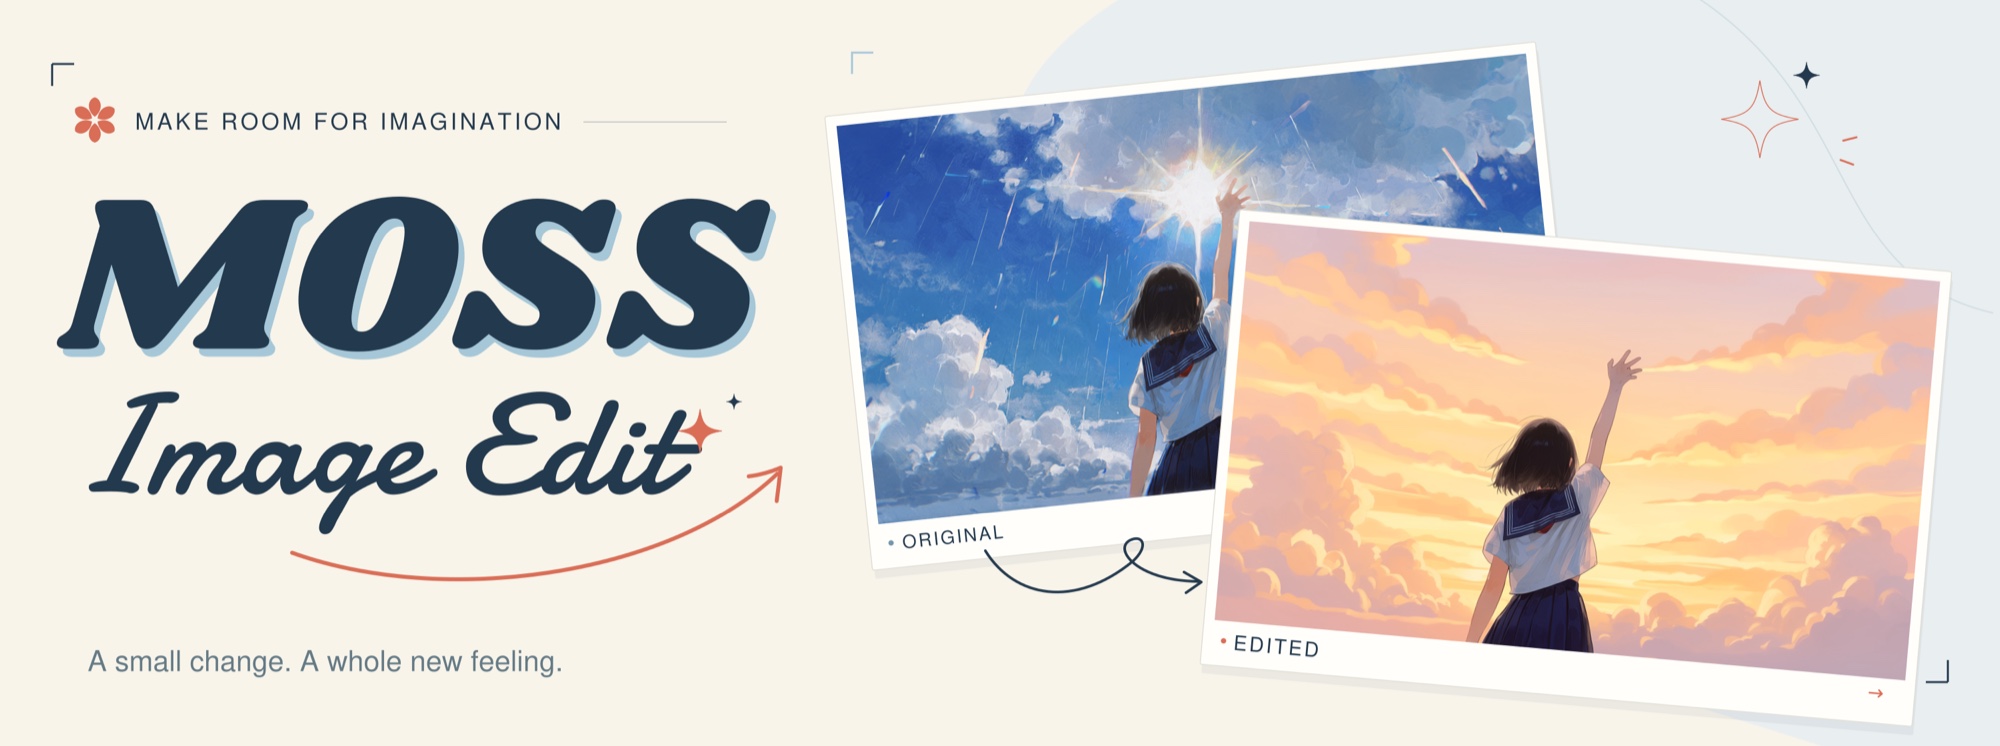
Сетка кейсов, опубликованная вместе с LoRA. Источник: chinoll/Moss-Image-Edit
Если референсов больше одного, каждое изображение нужно назвать в инструкции, поскольку сам адаптер роли не назначает. Пример промпта из пакета узлов: Dress the person in image 1 in the outfit from image 2.
Технически адаптер небольшой и обычный. Заголовок safetensors содержит 504 тензора по всем 42 слоям DiT, по шесть проекций на слой (q, k, v, o, ffn_up_gate, ffn_down), при ранге 64 и alpha 64. Его adapter_config.json объявляет формат moss-edit-lora версии 1 и фиксирует обучающий контракт как ref-prefix-only-t0__target-text-original-moss-v1, что соответствует раскладке, которую ComfyUI теперь реализует под именем Moss-Image-Edit.
Одни и те же веса работают как с MOSS-Image-Base, так и с MOSS-Image-SFT; Base сохраняет больше обучающего сигнала, SFT это более аккуратная отправная точка. Примеры из карточки обучались и сэмплировались на SFT.
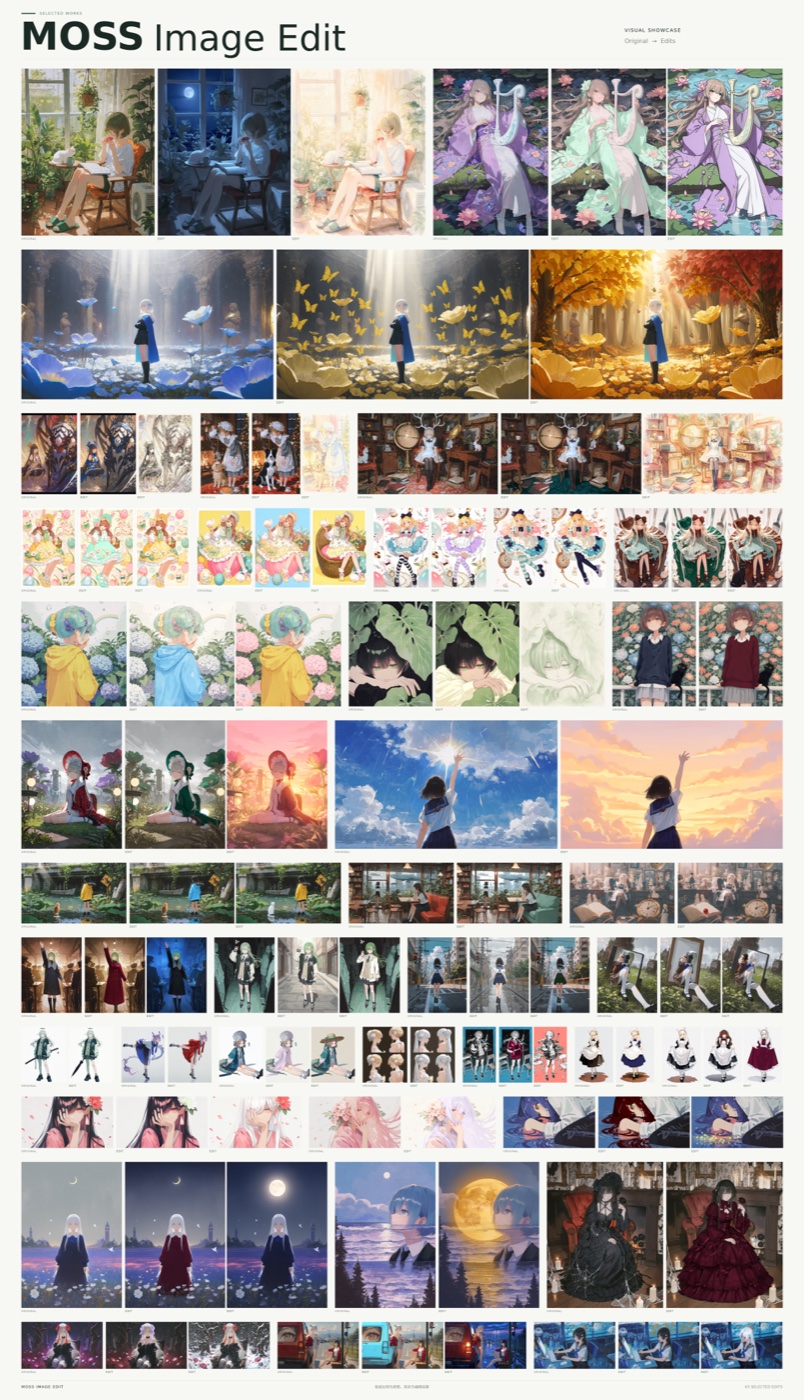
Витрина редактирования из репозитория проекта: каждая группа начинается с исходного изображения и продолжается его правками.
Путь через ядро ComfyUI
PR #17296 от Kijai добавляет узел Text Encode MOSS-Image Edit, всё ещё отмеченный как экспериментальный, в категорию model/conditioning/moss_image. Он принимает clip, prompt, vae, выбор edit_format и автоматически расширяемый набор изображений. Селектор edit_format это самое интересное, потому что он отражает тот факт, что edit-LoRA не взаимозаменяемы:
| Вариант | Раскладка референсов | Текстовый энкодер видит референсы |
|---|---|---|
ai-toolkit | index_timestep_zero_isolated | Да, с префиксом Picture N: |
ai-toolkit (kv_cache off) | index_timestep_zero | Да, и референсы через внимание обращаются к сгенерированному изображению на каждом шаге |
Moss-Image-Edit | index_timestep_zero_text_start | Нет |
При раскладке Moss-Image-Edit визуальный энкодер (vision tower) вообще не получает референсные изображения, поэтому инструкция должна описывать правку сама по себе; внешний вид целиком берётся из референсных латентов, внедряемых в DiT. Для адаптеров, обученных на ai-toolkit, референсы уменьшаются максимум до 384×384 и добавляются в начало промпта как токены Picture N:.
Адаптер загружается через стандартный загрузчик LoRA, поскольку PR добавил алиасы для «голого» стиля ключей layers.N.proj.q, который используется в этих файлах. Это значит, что нативный путь это обычный граф MOSS-Image с однофайловыми весами из Comfy-Org/MOSS-Image, плюс загрузчик LoRA и новый узел кодирования текста; референсные изображения подключаются к узлу как изображения, а не как отдельный латентный вход.
PR также содержит не новую функцию, а исправление скорости: для изолированных раскладок K/V референсов по каждому блоку вычисляются один раз в extra_conds, а не на каждом шаге, что сокращает время шага при 1024² с референсом в 1 MP с 826 мс до 457 мс. Поддержка была смёржена после тега v0.42.1, поэтому в релизной установке нужно обновиться до версии после этого тега, чтобы её использовать.
Путь через пакет узлов
Тот же автор выпускает самодостаточный пакет узлов, Chenkin-x/ComfyUI-Moss-Image-Edit, появившийся 22 октября и добавляющий и загрузчик, и узел редактирования в категорию MOSS Image Edit. Он запускает собственную копию рантайма MOSS вместо узлов ядра и ожидает полный снапшот Diffusers, а не однофайловую перепаковку:
ComfyUI/models/moss_image/
├── MOSS-Image-SFT/          # pipeline_moss_image.py, transformer/, text_encoder/, tokenizer/, vae/, scheduler/
└── Moss-Image-Edit/         # adapter_config.json, adapter_model.safetensors
Параметр загрузчика snapshot_dir указывает на базовую модель, а adapter_dir на адаптер. В комплекте идут два рабочих процесса, один для одного референса и один для двух; чтобы добраться до трёх или четырёх, нужно добавить узлы Load Image к свободным входам reference_3 и reference_4. Задокументированные значения по умолчанию: выход 512×512, 30 шагов, CFG 4.0, inference_shift 5.0 и длинная сторона референса 512 без обрезки.
| Параметр | По умолчанию | Примечание |
|---|---|---|
width / height | 512 / 512 | кратны 16 |
reference_max_edge | 512 | выравнивается до 16, никогда не обрезается |
steps | 30 | |
cfg | 4.0 | |
inference_shift | 5.0 | распределение времени выборки |
seed | 42 | фиксировано по умолчанию |
Как референсы попадают в DiT
Оба пути опираются на один и тот же приём. Референсные изображения кодируются через VAE в латентные токены и добавляются к последовательности изображения под собственным индексом RoPE, на нулевом таймстепе, взаимодействуя через внимание только друг с другом. Поскольку эти токены не меняются в течение цикла выборки, их K/V по каждому блоку можно вычислить один раз и переиспользовать, и именно это позволяет адаптеру ранга 64 без обучения текстового энкодера удерживать идентичность, пока инструкция переписывает всё остальное.
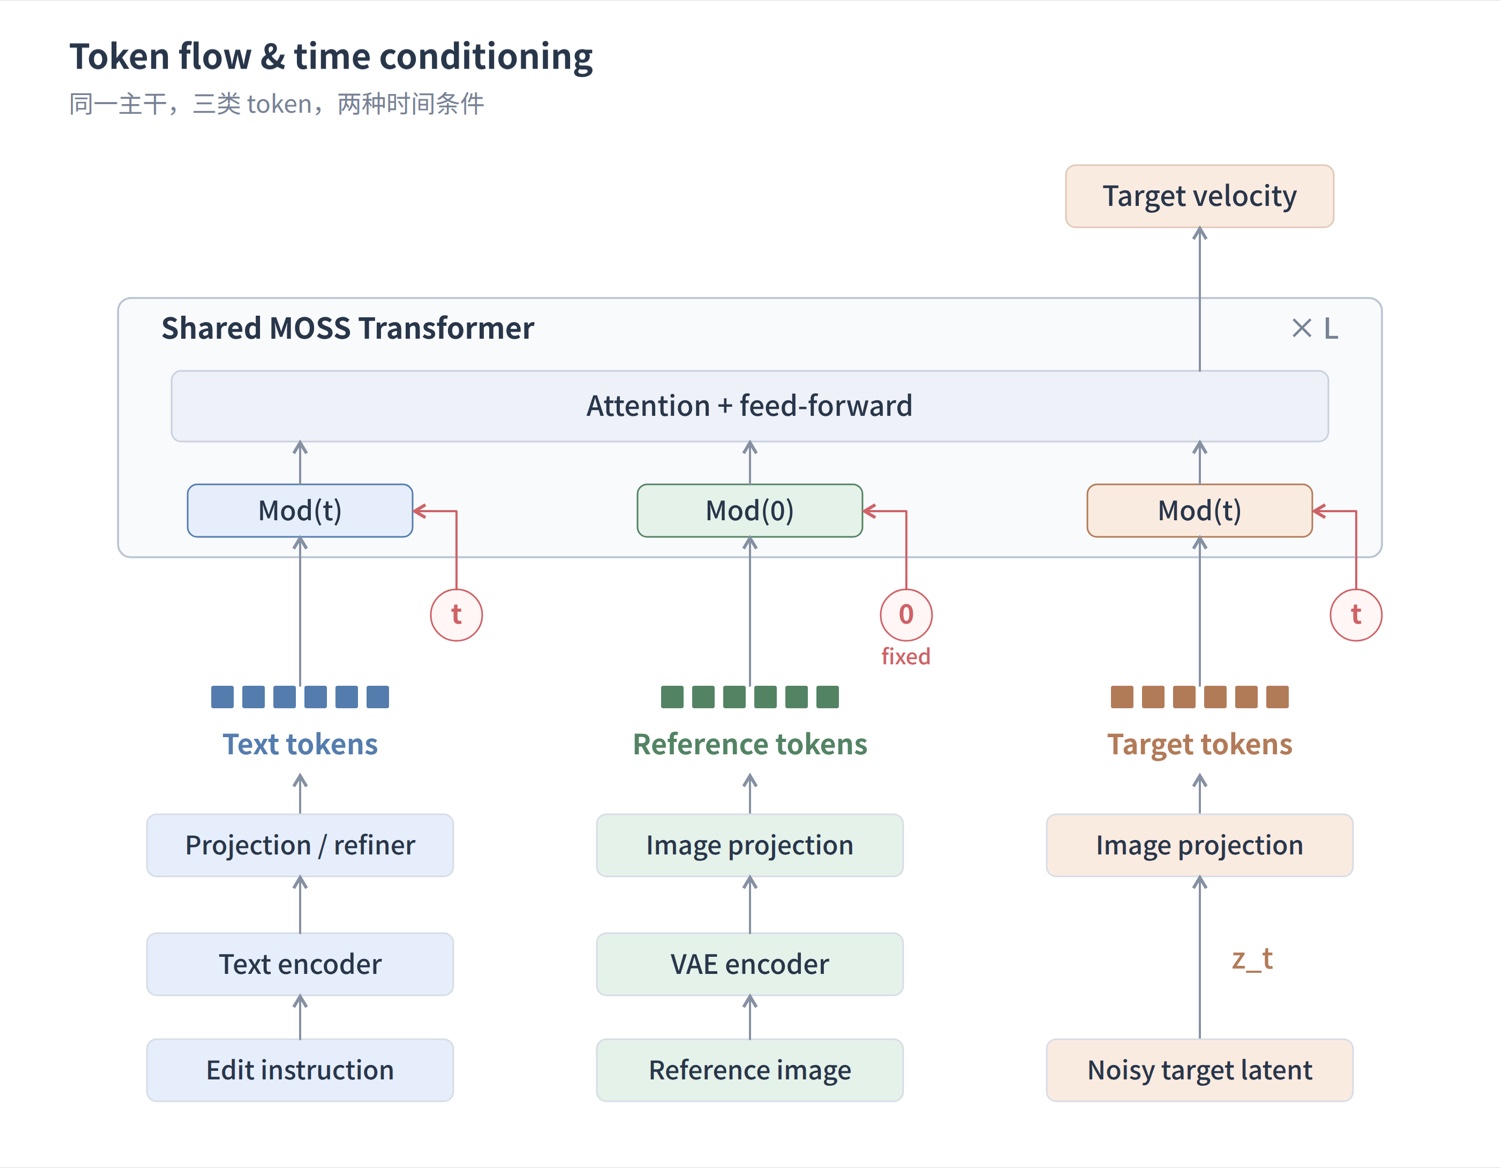
Диаграмма кэша K/V референсов из обучающего репозитория: кэшированные блоки референсов рядом со сгенерированными токенами.
Обучающий репозиторий публикует весь рецепт, а не только веса: подготовку данных, конфиги и скрипт вывода. Обучающие данные это пары NOOB2 плюс набор ConceptEdit-12M, инструкции берутся из instruction.detailed_en, исходное и отредактированное изображения кодируются VAE вместе, и оба масштабируются так, чтобы длинная сторона оставалась меньше max_edge, без обрезки и паддинга. Обучение запускается через torchrun с четырьмя процессами, DeepSpeed Muon на ZeRO-2 через пропатченную adjust_lr_fn, Flash Attention 4 с varlen-упаковкой, а текстовый энкодер квантуется в int8 во время обучения. Валидационные сэмплы записываются на каждом шаге вместе с тройками сгенерированное/исходное/целевое, поэтому чекпойнты из репозитория можно воспроизвести или расширить.
Ограничения, о которых стоит знать
LoRA это bf16-адаптер размером 297 МБ, небольшой по сравнению с базовой моделью, но это не универсальный редактор. Заявленный охват это правки атрибутов и сцены: цвет, одежда, освещение, сезон и стиль, а также выражения. В карточке не описана вставка объектов, не опубликован бенчмарк и нет заявлений о компоновке двух субъектов в одну сцену. Мультиреференсное редактирование зависит от того, назначает ли промпт роли, как отмечено выше. И это не официальный релиз OpenMOSS: веса, пакет узлов и код обучения принадлежат одному автору, и только PR в ядро прошёл проверку мейнтейнеров ComfyUI.
Доступность
- LoRA: chinoll/Moss-Image-Edit, около 21 лайка на момент написания, через день после загрузки.
- Ядро ComfyUI: PR #17296, смёржен 22 октября 2026 года, после релиза v0.42.1.
- Пакет узлов: Chenkin-x/ComfyUI-Moss-Image-Edit с рабочими процессами для одного и нескольких референсов.
- Код обучения и вывода: Chenkin-x/Moss-Image-Edit, включая
prepare_data.py,configs/train.jsonиinfer.py. - Базовые модели: MOSS-Image-Base и MOSS-Image-SFT, однофайловые веса ComfyUI в Comfy-Org/MOSS-Image.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.