KohakuMoss: обучение LoRA для MOSS-Image с экспортом в ComfyUI
KohakuMoss 0.1.0 обучает LoRA, LyCORIS или полный файнтюн на MOSS-Image-Base и SFT, работает на картах от 6 ГБ и экспортирует адаптеры в раскладке ключей ComfyUI.
KohakuMoss это фреймворк для файнтюнинга MOSS-Image-Base и MOSS-Image-SFT, опубликованный как версия 0.1.0 на PyPI 18 октября 2026 года. Его создал KohakuBlueleaf, автор LyCORIS, и он закрывает ту часть инструментальной цепочки MOSS-Image, которую не покрыли ни релиз модели, ни few-step адаптеры от сообщества: обучение на собственных изображениях в нативном разрешении и последующий экспорт в формате, который ComfyUI загружает без отдельного шага конвертации.
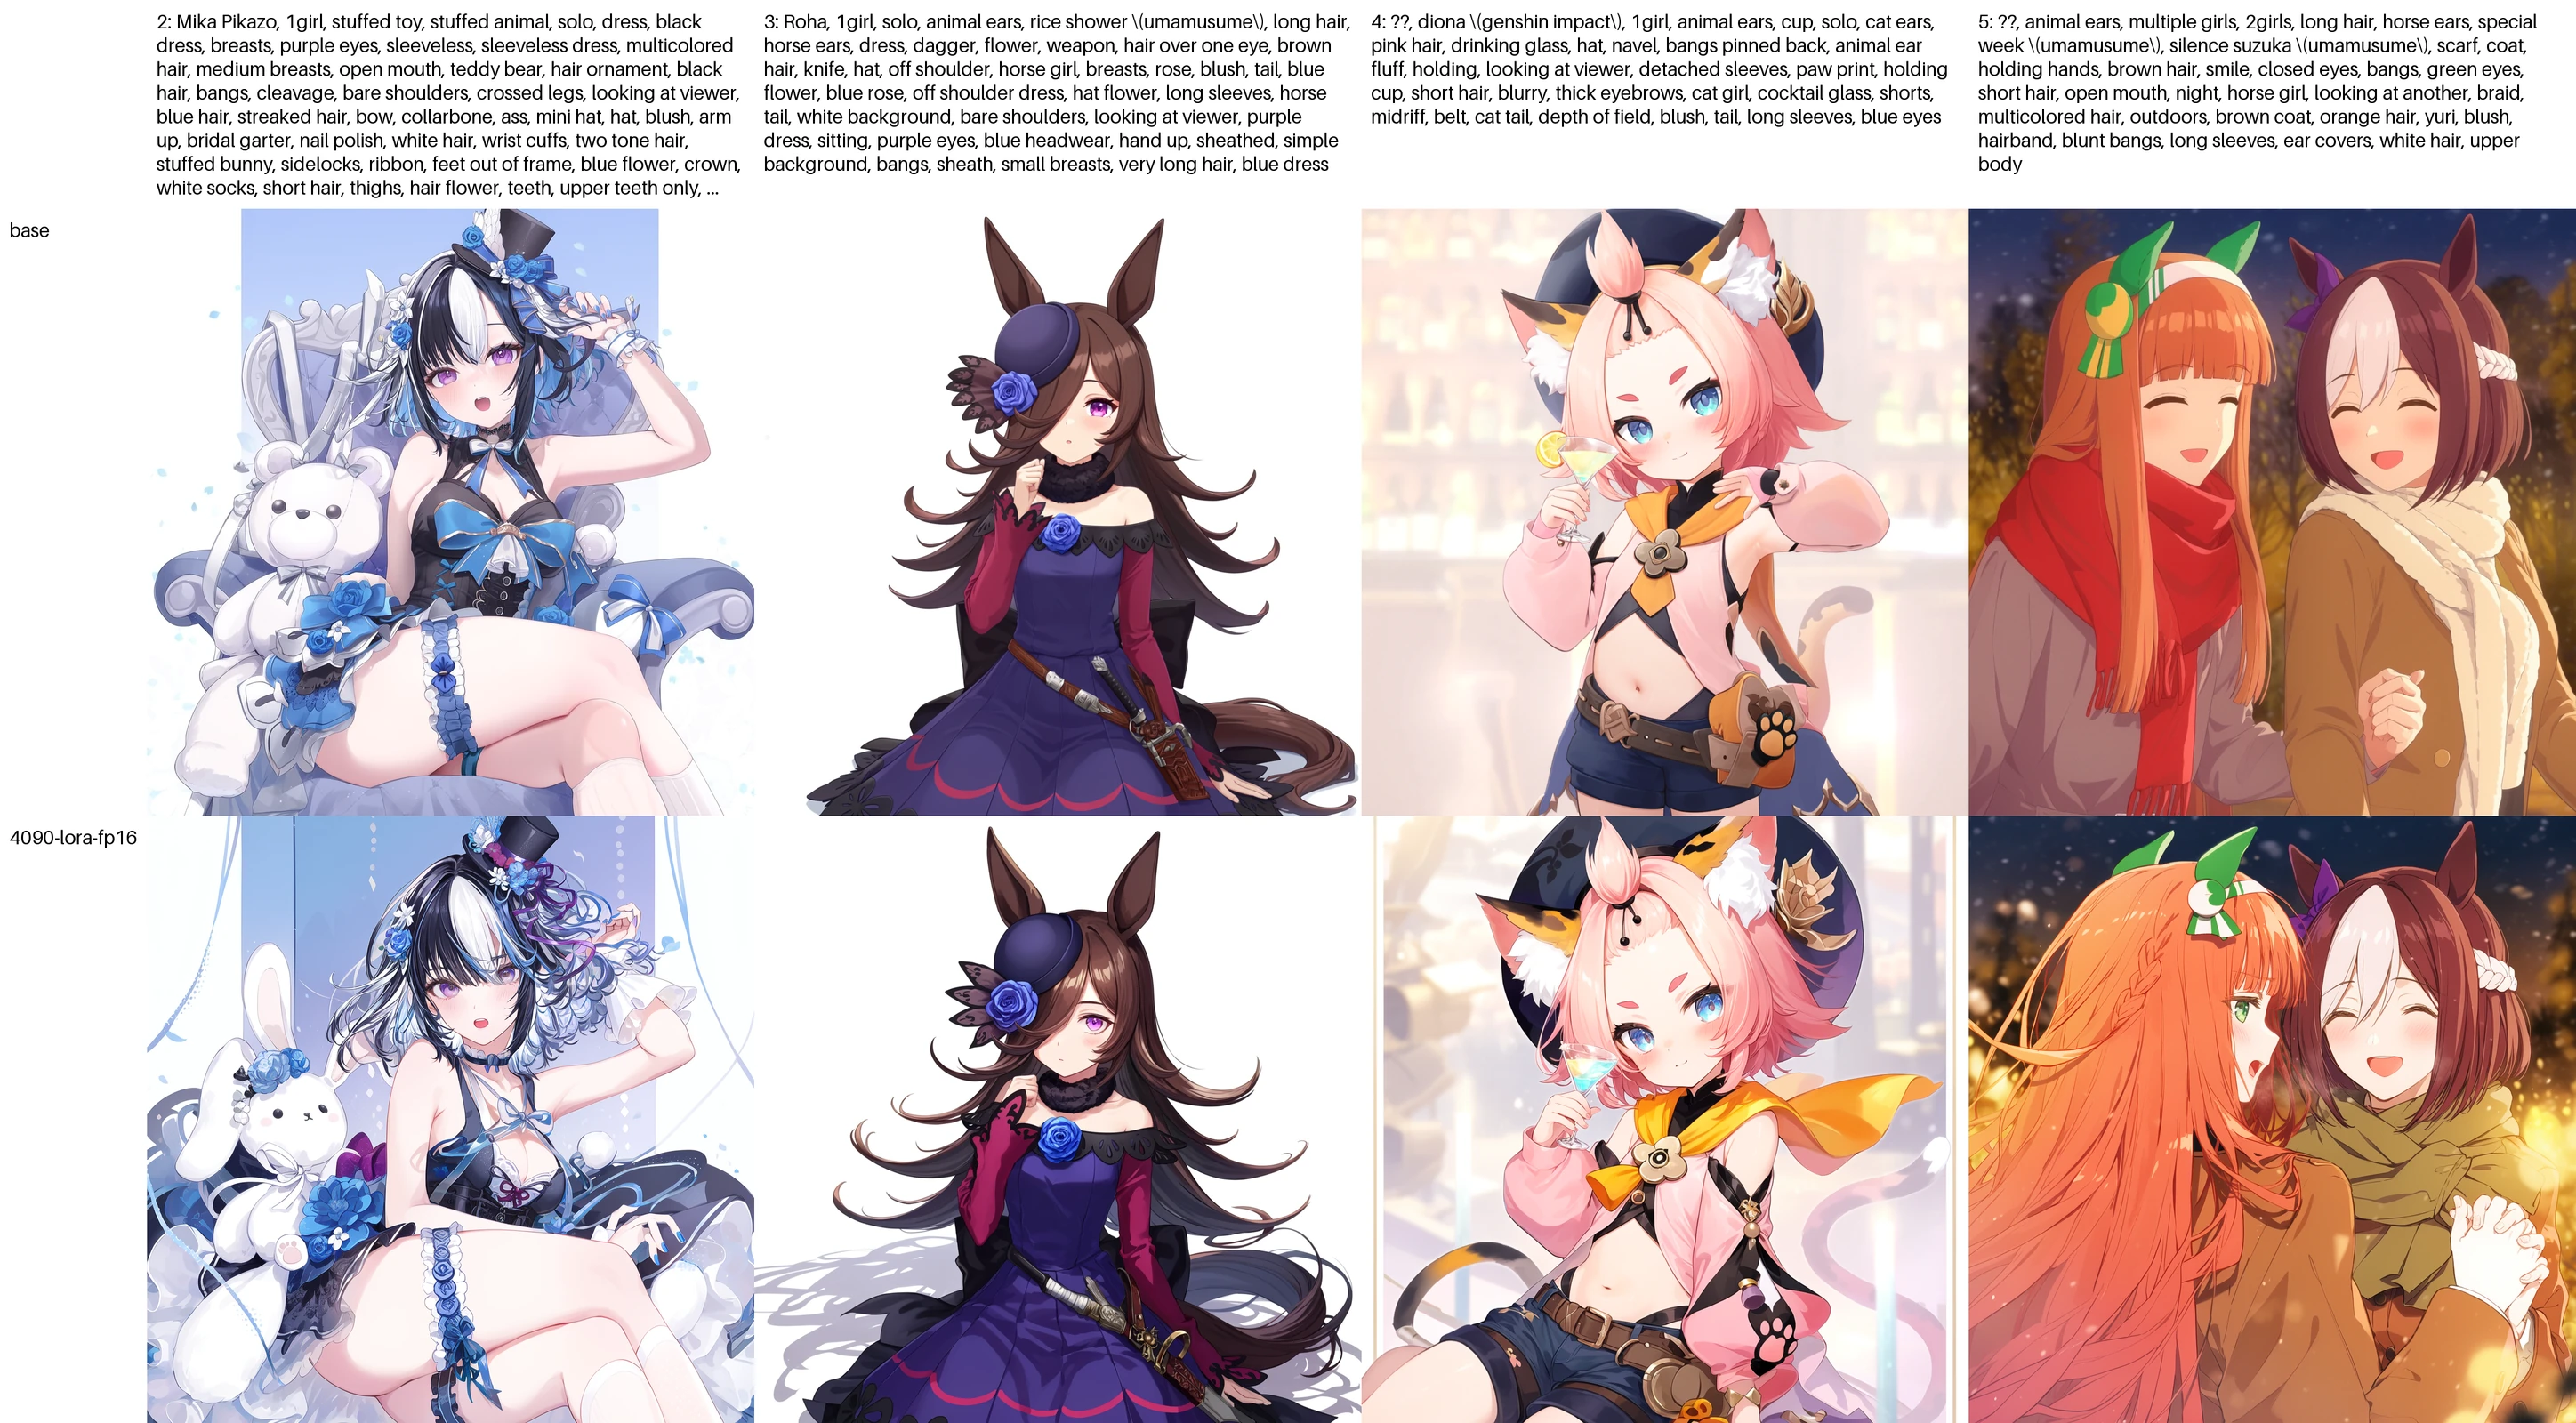
Какую задачу он решает
MOSS-Image появился 16 октября с двумя чекпойнтами, управлением компоновкой и поддержкой ComfyUI в день релиза, а 4-step и 8-step LoRA от сообщества вышли в течение суток. Ни там, ни там не было тренера, рассчитанного именно на этот 5B diffusion transformer и его текстовый энкодер Qwen3.5-9B. Универсальные тренеры для diffusion предполагают UNet или стек в стиле Flux; MOSS-Image требует собственного упакованного внимания и собственных имён ключей. KohakuMoss предоставляет и то, и другое: независимую реализацию MOSS-Image, набор адаптеров LyCORIS, конвейер данных и планы по памяти, необходимые для запуска на одной карте.
Адаптеры и полный файнтюн
Обучение адаптеров охватывает LoRA и LoCon, LoHa, LoKr, DoRA, OFT, BOFT, GLoRA, IA3, DyLoRA и T-LoRA, всё через LyCORIS, поэтому его алгоритмы, формат сохранения и fused-ядра используются без изменений. Dropout, LoRA+, обход или объединённый прямой проход (merged forwards) и пресеты таргетинга задаются настройками, а не отдельными скриптами.
Полный файнтюн также поддерживается: используется Muon с AdamW и EMA, как в техническом отчёте MOSS. Он умещается на одной карте с 24 ГБ, если держать мастер-веса в памяти хоста, так что платить приходится системной RAM, а не второй GPU.
Работа на 6 ГБ
Память управляется набором уровней, а не одним переключателем: чекпойнтинг блоков, потоковая подгрузка весов, выгрузка активаций, выгрузка градиентов и состояния оптимизатора в памяти хоста. Четыре именованных профиля охватывают диапазон от speed до minimal, kohakumoss-config выбирает один из них исходя из обнаруженной карты, а под ним есть каталог из 240 записей для ручной настройки. Обучение адаптеров доходит до карт на 8 ГБ, а уровень для 6 ГБ умещается, когда и латентный кэш, и кэш текста построены заранее. Карта на 24 ГБ по-прежнему покрывает случай полного файнтюна.
Точность следует за аппаратурой: bf16 там, где она есть, fp16 на старых картах с исправлением для residual-ветвей, вычисления в fp8 и MXFP8 на sm89 и новее как для DiT, так и для текстового энкодера при обучении и при выводе, а также weight-only квантование в int8 или fp8 для замороженной базы.
Ядра под каждую архитектуру
Проект поставляет собственные ядра вместо зависимости от одного стека: TileLang для sm70 и sm75, Triton для sm80 и новее, а также для Intel Arc, при этом за обоими стоят torch.compile и eager. Varlen-внимание, блочные операции и fused-линейные слои выбирают бэкенд под архитектуру, dtype и форму, один раз замеряются на карте и сохраняются в таблицу тюнинга, поэтому одна и та же установка по-разному настроена на V100 и на RTX 5090.
Реализация модели работает с упакованными батчами переменной длины: одна плоская ось токенов, а внимание остаётся внутри каждого сэмпла. По сравнению с официальным кодом проект сообщает относительную ошибку прямого прохода в fp32 4.7e-6 и LPIPS выборки за 50 шагов 2.3e-6.
Данные и продолжение обучения
Входные форматы включают папки в стиле kohya, jsonl, parquet, webdataset и нативные шарды, а инкрементальный каталог кэшируется после первого сканирования. Планировщики изменения размера, бакетов и кадрирования работают с изображениями в нативном разрешении, батчинг по токенам выравнивает шаги, а латентный и текстовый кэши можно построить заранее или наполнять во время обучения. План выборки это чистая функция от данных, сида и настроек, поэтому возобновлённый запуск воспроизводит тот же порядок, а не приближается к нему.
Мульти-GPU только для Linux: DDP при любом профиле памяти, включая потоковую подгрузку весов, FSDP2, pipeline и многопоточный pipeline.
Экспорт в ComfyUI
Именно шаг экспорта делает его не просто очередным тренером. Запуск может дать файл LyCORIS, объединённую модель, transformer для diffusers или адаптер в формате ComfyUI, записанный под собственную раскладку ключей MOSS-Image в ComfyUI, включая перепаковку под её fused-проекцию q/k/v. Этот файл кладётся в models/loras и загружается в обычном рабочем процессе ComfyUI, поэтому обученной здесь LoRA не нужен сторонний узел или ноутбук для конвертации. Экспорт также работает с любым сохранённым чекпойнтом, а не только с финальным шагом.
Измеренная скорость
В таблицах релиза приведено обучение при 1 MP на MOSS-Image-Base с LoRA ранга 32 в профиле balanced. На RTX 5090 запуск достигает 1.01 сэмпла в секунду без кэша и 1.14 с латентным и текстовым кэшами; RTX 4090 поднимается с 0.49 до 0.73, а RTX 3090 с 0.31 до 0.39. Пики шага в большинстве этих строк держатся около 6.6 GiB памяти, выделенной torch, а числа для 5090 включают резидентный текстовый энкодер на 15.6 GiB, поэтому именно её показатель без кэша оказывается выше.
Пример из README ближе к реальному первому проекту: style LoRA ранга 8 в fp16 поверх базы в fp8, 100 шагов примерно по 20k токенов на шаг, с агрессивным профилем ckpt-ring4-actoff и кодированием текстового энкодера и VAE на лету на каждом шаге. На одной RTX 4090 он занимает от 12 до 13 ГБ и выдаёт около 0.85 изображения в секунду.
Конфигурация
Каждый скрипт это скрипт KohakuEngine, поэтому настройки задаются параметрами уровня модуля, а конфиг может накладывать пресеты друг на друга. kohakumoss-config записывает проверенный конфиг для обнаруженного GPU и набора данных, kohakumoss-config wizard спрашивает GPU, алгоритм, данные и веса вместо флагов, а фиксированные рецепты вроде lora_24g_bf16 можно расширять любым из перечисленных параметров.
Доступность и лицензия
KohakuMoss находится по адресу github.com/KohakuBlueleaf/KohakuMossTrainer и устанавливается из PyPI как kohakumoss. Помощники установки определяют драйвер, выбирают подходящий индекс torch и затем запускают kohakumoss-doctor, который сообщает обо всём отсутствующем вместе с командой, которая это исправляет. Обязательно нужен Python 3.10 или новее, а также CUDA 12.6 или новее либо драйвер Intel Arc; в Windows нужны Visual Studio Build Tools, а карты sm70 и sm75 требуют CUDA toolkit для nvcc.
Лицензия это KohakuMoss License 1.0: Apache 2.0 плюс одно условие: производная работа, пакет, продукт или сервис, построенные на KohakuMoss, должны содержать «Kohaku» в названии. Модели, адаптеры и изображения, обученные или сгенерированные с помощью фреймворка, явно выведены из этого условия, поэтому LoRA или чекпойнт, созданные с его помощью, можно называть и лицензировать так, как пожелает автор.
О самих чекпойнтах читайте в обзоре релиза MOSS-Image и в материале о 4-step и 8-step адаптерах, которые сделали быструю выборку практичной.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.