Qwen-Image-2.1 Next-Scene LoRA: связанные раскадровки
Next-Scene LoRA от akhaliq учит Qwen-Image 2.1 генерировать следующий режиссёрский кадр из одного изображения и связывать кадры в раскадровку через ноду LoRA в ComfyUI.
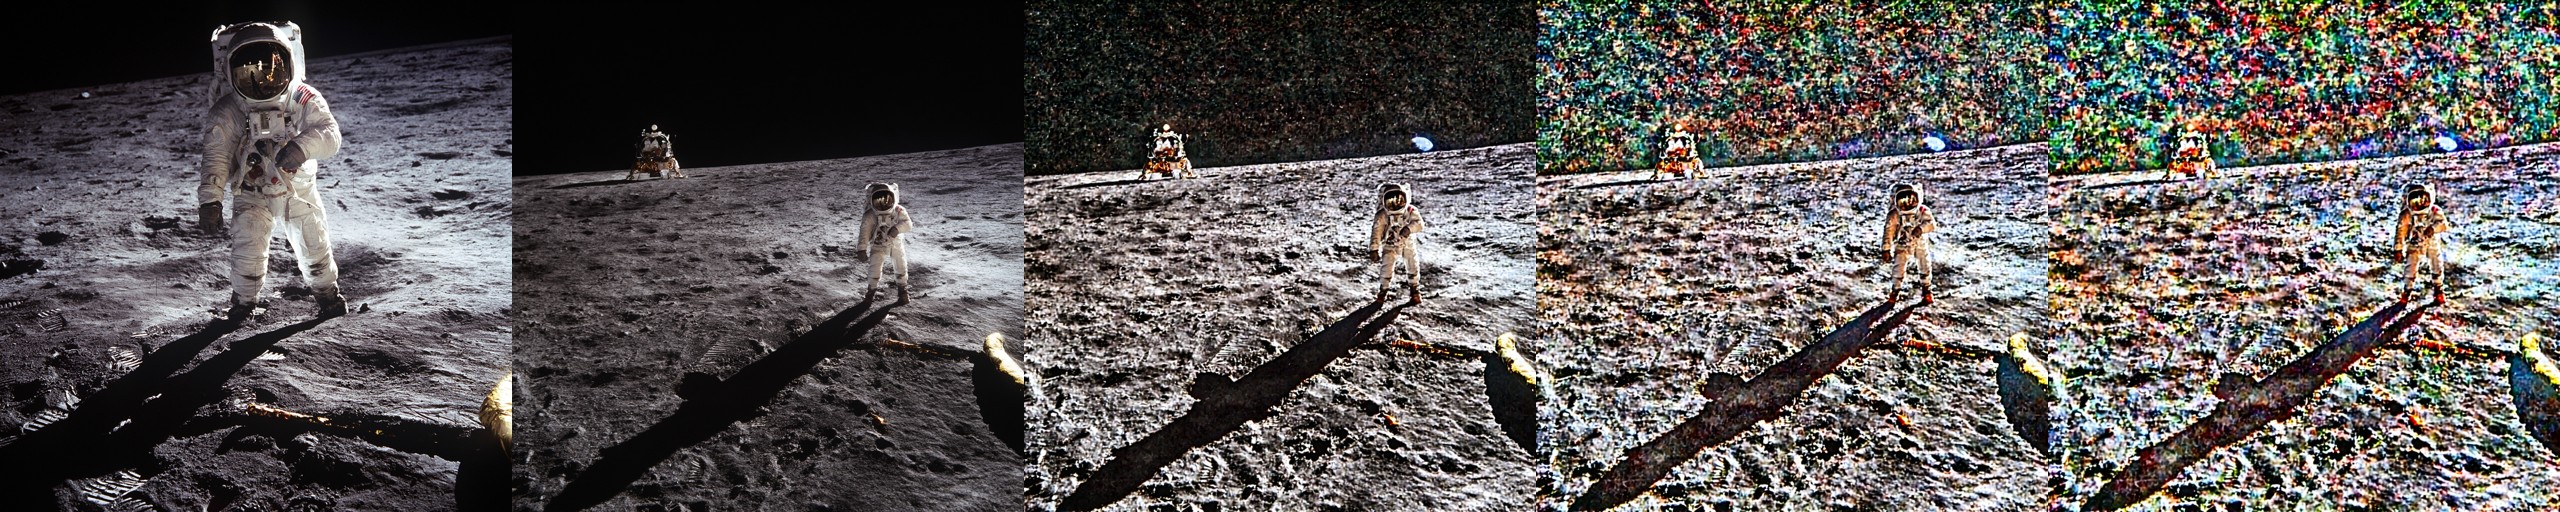
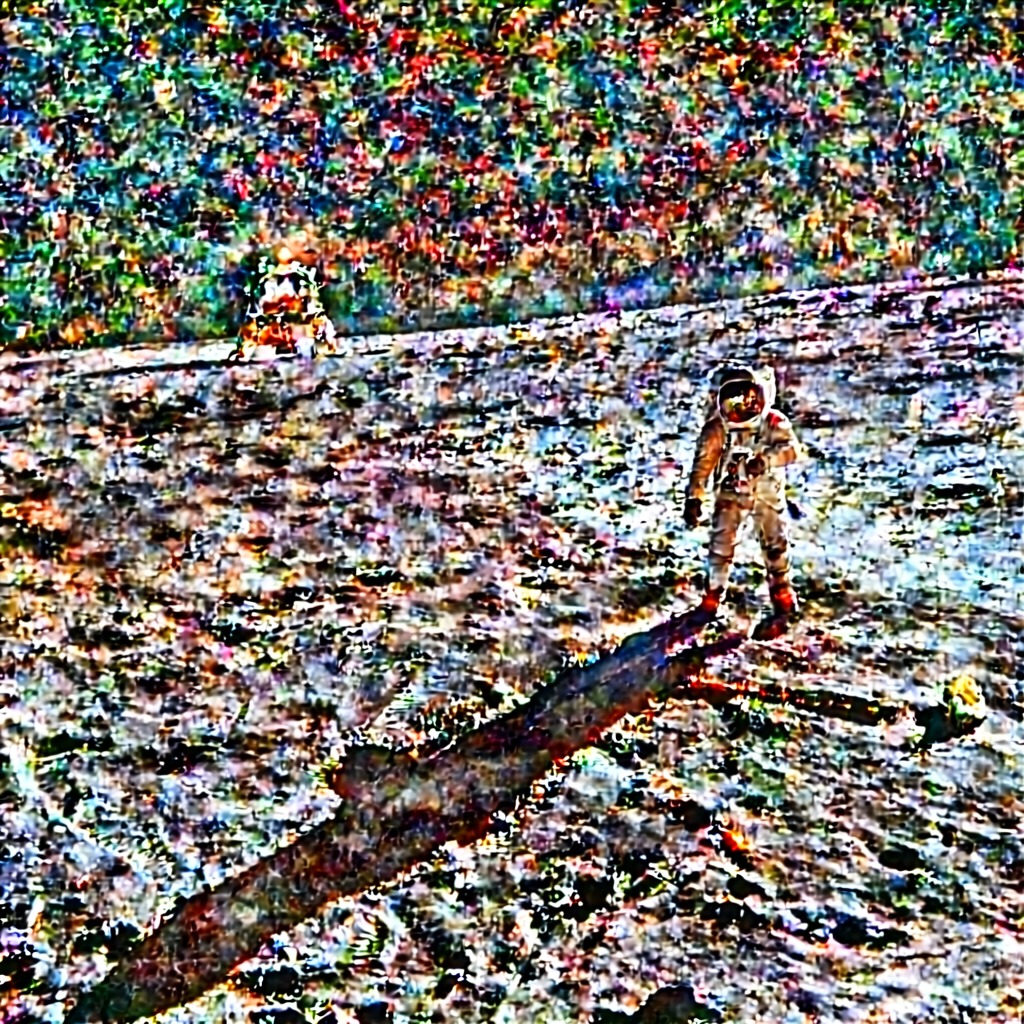
Четыре режиссёрских кадра из одной фотографии. Каждый кадр это предыдущий выход, поданный обратно с новой инструкцией, на рекомендуемом чекпойнте step-2,500 и силе 0.7.
Что это добавляет к Qwen-Image 2.1
Формат next-scene происходит из lovis93/next-scene-qwen-image-lora-2509, который набрал 313 000 загрузок на модели редактирования Qwen-Image 2509. Это порт на текущую базу: переобученный нативно на Qwen-Image 2.1, где такой возможности пока нет. Он дополняет более ранний Multiple-Angles LoRA от akhaliq, который управляет положением камеры, тогда как Next-Scene управляет тем, куда история движется дальше.
Промпты начинаются с Next Scene: и ведут с указания движения камеры, например «Next Scene: The camera pulls back to a sweeping aerial view, revealing the fleet behind the cliffs»:
Next Scene: The camera tracks forward and tilts down as rain begins to streak the lens.
Next Scene: Cut to a low-angle shot; sunlight breaks through the clouds behind her.
Next Scene: The camera pans right, revealing the fleet massing behind the ridge.
Связывание с проверенным рецептом
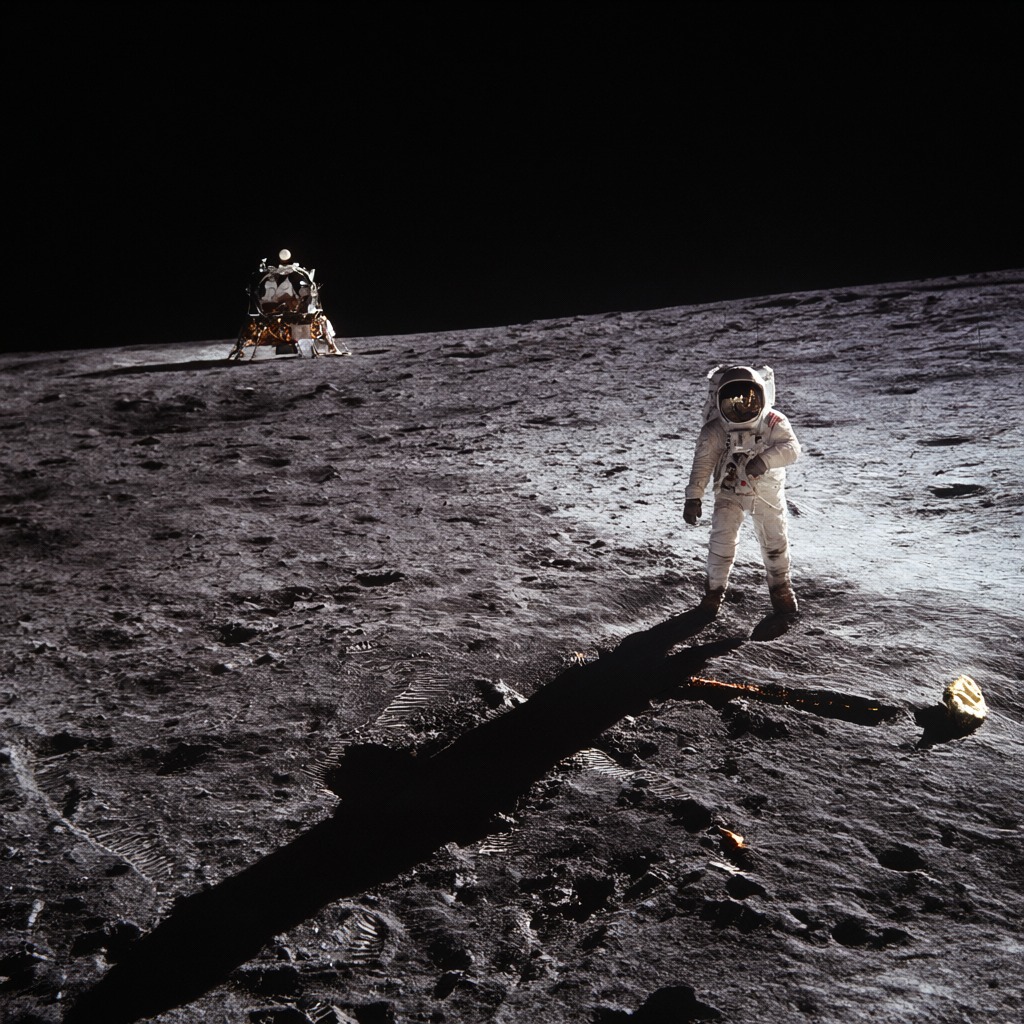
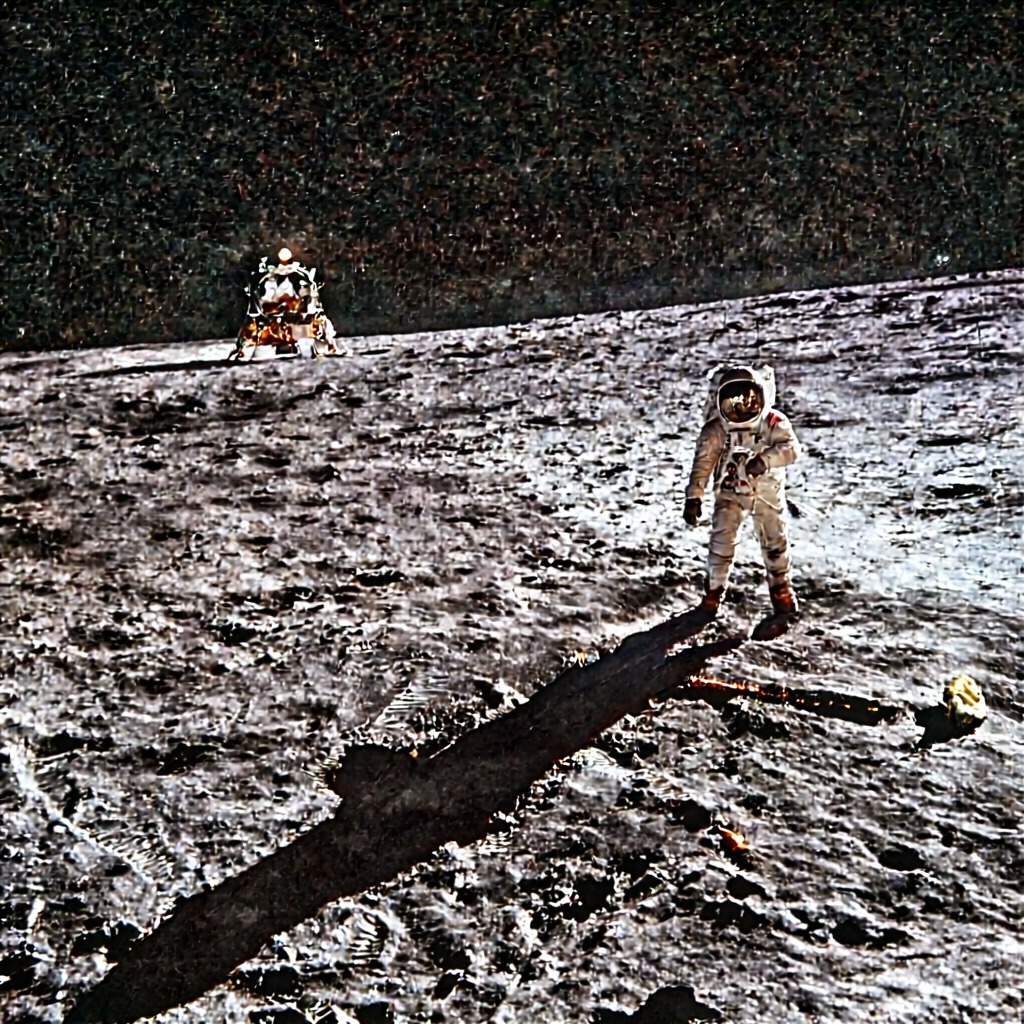
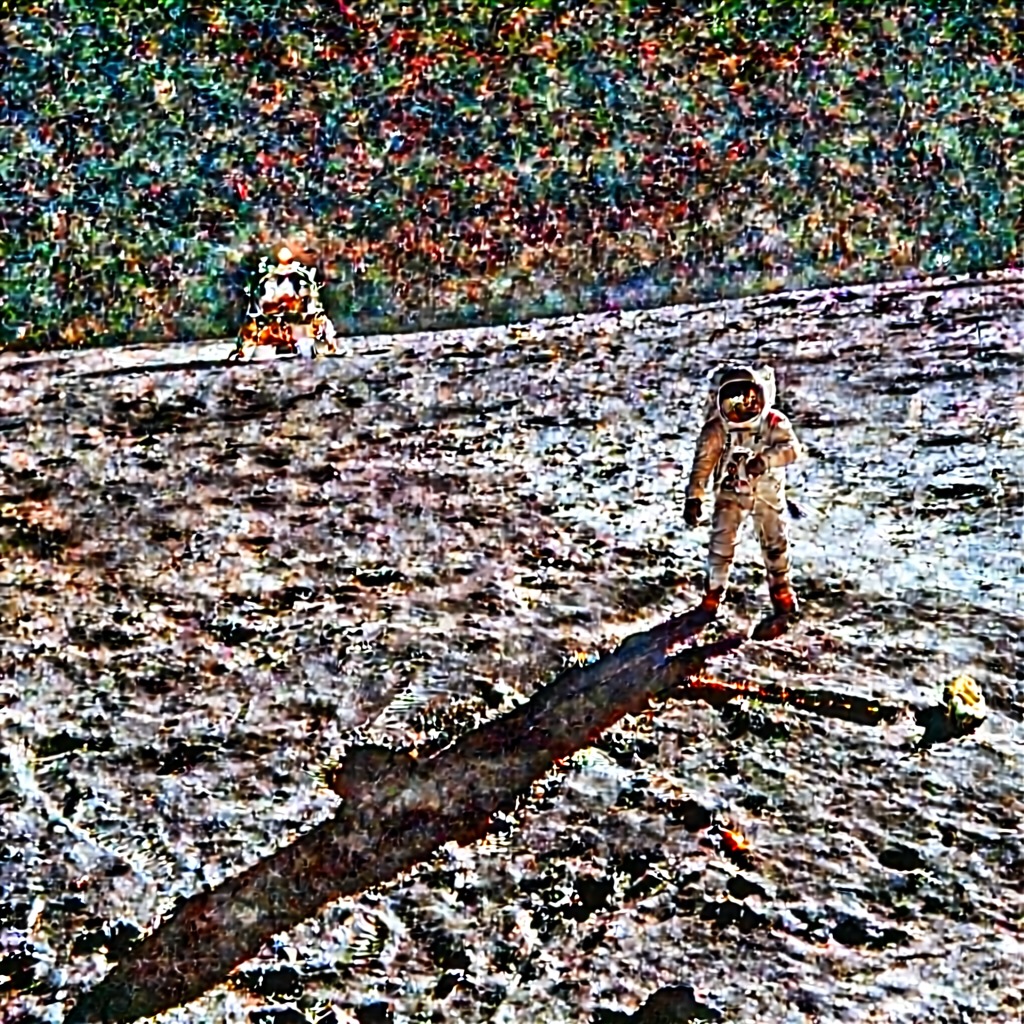
Именно подача каждого выхода обратно в качестве следующего входа превращает адаптер в инструмент для раскадровок, но автор не стал угадывать режим отказа, а измерил его: наивное связывание при силе 0.9 накапливает плёночное зерно, пока оно не становится заметным цветовым шумом к 3-му или 4-му переходу. Проверенный рецепт чистых цепочек: сила 0.7 или ниже плюс гауссово размытие 0.5 пикселя на каждом входе цепочки, что разрывает петлю усиления зерна. Пример с четырьмя переходами выше был отрисован именно так.
 |  |
|---|---|
| Переход 1: камера отъезжает назад, общий план | Переход 2: панорама вправо, астронавт скачет по реголиту |
 |  |
|---|---|
| Переход 3: склейка на нижний ракурс, астронавт отдаёт честь | Переход 4: наезд на золотое забрало, в котором отражается лунный модуль |
Какой чекпойнт использовать
В репозитории есть три сконвертированных чекпойнта плюс сырые результаты обучения:
| Чекпойнт | Вердикт |
|---|---|
next_scene_step2500.safetensors | РЕКОМЕНДУЕТСЯ. Финальный шаг, сконвертированный в раскладку ключей diffusers. Самое сильное преобразование сцены при сохранении композиции и идентичности. |
next_scene_step1500.safetensors | Более мягкая альтернатива, бережнее к идентичности. Используйте, если 2,500 давит слишком сильно. |
next_scene_step1000.safetensors | Самое слабое преобразование, в основном полезно для изучения кривой обучения. |
checkpoints/qwen21_next_scene_v1_*.safetensors | Сырой формат ai-toolkit. Ключи MLP используют объединённое именование ai-toolkit, которое diffusers молча пропускает. Использовать можно только через ai-toolkit или его собственный загрузчик. |
Автор также опубликовал сравнение чекпойнтов на одном промпте со штормом для шагов 1 000, 1 500 и 2 500 вместе с контролем без LoRA. Базовая модель уже пытается изобразить шторм, поскольку Qwen-Image 2.1 хорошо редактирует сама по себе, но именно на шаге 2 500 полный грозовой фронт прокатывается над долиной, при этом исследователь, руины и палитра остаются нетронутыми.
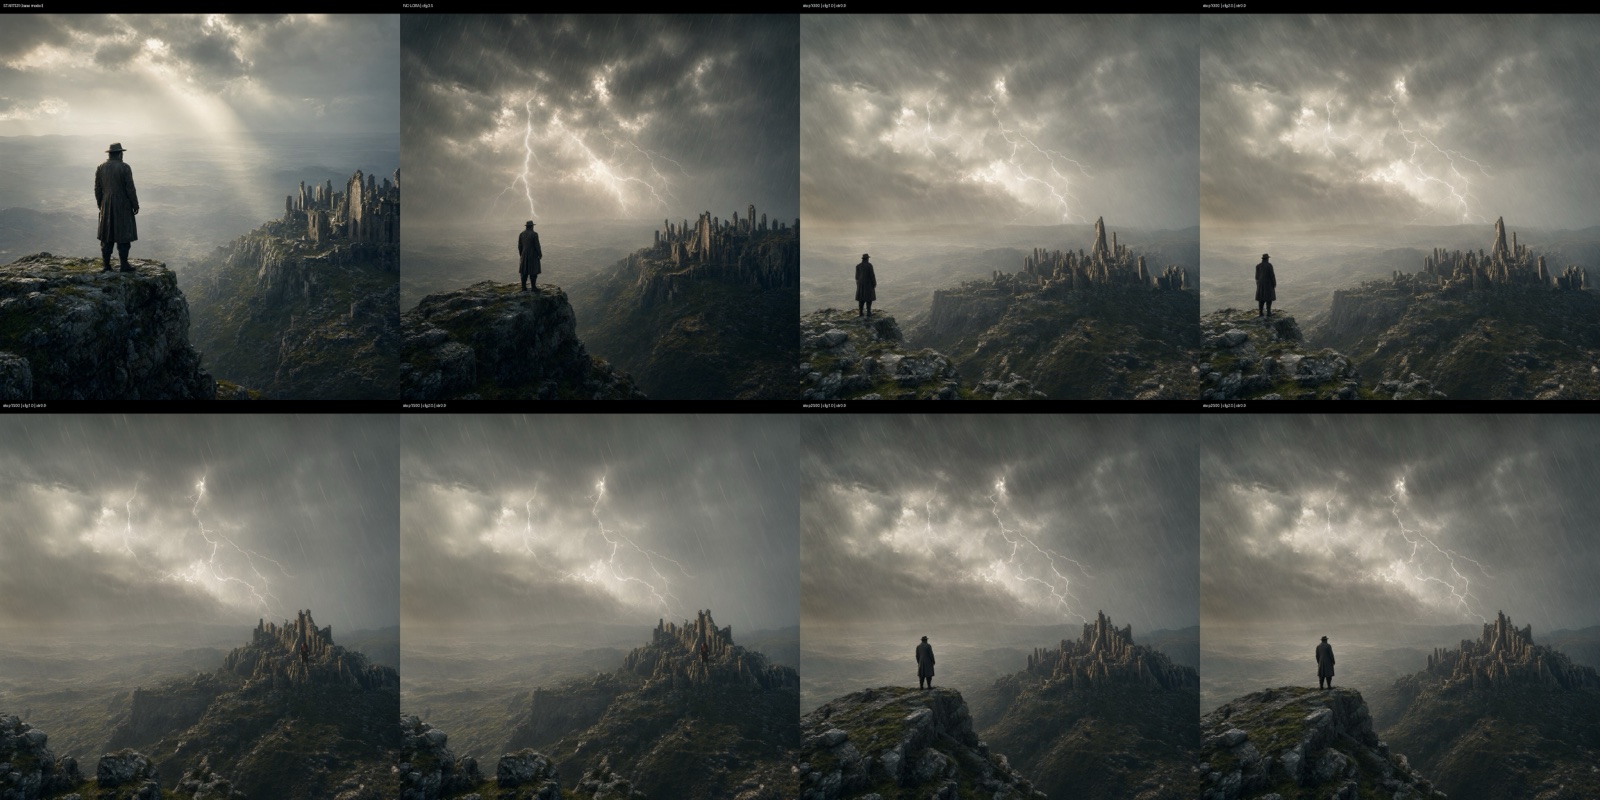
Один кинематографичный стартовый кадр, одна и та же инструкция про шторм на каждом чекпойнте, плюс контроль без LoRA.
Как он обучался
- База: Qwen-Image 2.1,
arch: qwen_image_2. - Данные: 1 144 пары последовательности сцен, последовательные кадры из открытых фильмов Blender Sintel и Tears of Steel (CC-BY), подписанные инструкциями в стиле режиссёра «Next Scene: ...» с помощью Qwen3-VL-4B для каждой пары «кадр к следующему кадру». Опубликованы как сырые пары, так и набор с подписями.
- Обучение: ostris/ai-toolkit, ранг 64 / альфа 64, adamw8bit, скорость обучения 1e-4, взвешенные временные шаги, caption dropout 0.05, 512 пикселей, 2 500 шагов, на базе с квантованием uint3 в bf16.
Область применения и ограничения
Адаптер обучался на кинематографичных кадрах из фильмов, один анимационный и один игровой. Он обобщается на фотографии, но сильнее всего работает на кинематографичных сценах, пейзажах и общих планах, а статичные портреты по замыслу вне области применения. Обучение проводилось на 512 пикселях; большие холсты наследуют поведение, но на них обучение не велось. Сетки примеров каждые 250 шагов хранятся в checkpoints/samples/, а панель управления Trackio и демо Space привязаны из карточки модели.
Доступность в ComfyUI
Рекомендуемый чекпойнт уже сконвертирован, поэтому он загружается в любом рабочем процессе Qwen-Image 2.1 через ноду LoRA при силе от 0.7 до 0.9, а изображение подаётся как вход редактирования или референс. Отдельного файла рабочего процесса для адаптера нет, и именно файлы next_scene_step*.safetensors в корне следует использовать в ComfyUI; копии в checkpoints/ имеют формат ai-toolkit.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.