Qwen-Image 2.1 Multiple-Angles LoRA: пересъёмка с любого ракурса
LoRA Multiple-Angles от Akhaliq добавляет управление камерой в Qwen-Image 2.1: подайте фото, выберите один из 72 ракурсов по азимуту и высоте и переснимите объект в ComfyUI.
Облёт золотистого ретривера на уровне глаз, все 12 шагов азимута, получено с чекпойнтом v2 на шаге 1 500.
Что добавляет адаптер
Qwen-Image 2.1 умеет и генерировать, и редактировать в одной модели, но не имеет понятия о том, где стоит камера. Если в промпте попросить "показать спину", объект обычно остаётся примерно там же. Этот LoRA вместо этого учит словарь поз: каждый промпт начинается с триггера <mva>, за которым следует именованный азимут и высота, и модель двигает камеру, а не сцену.
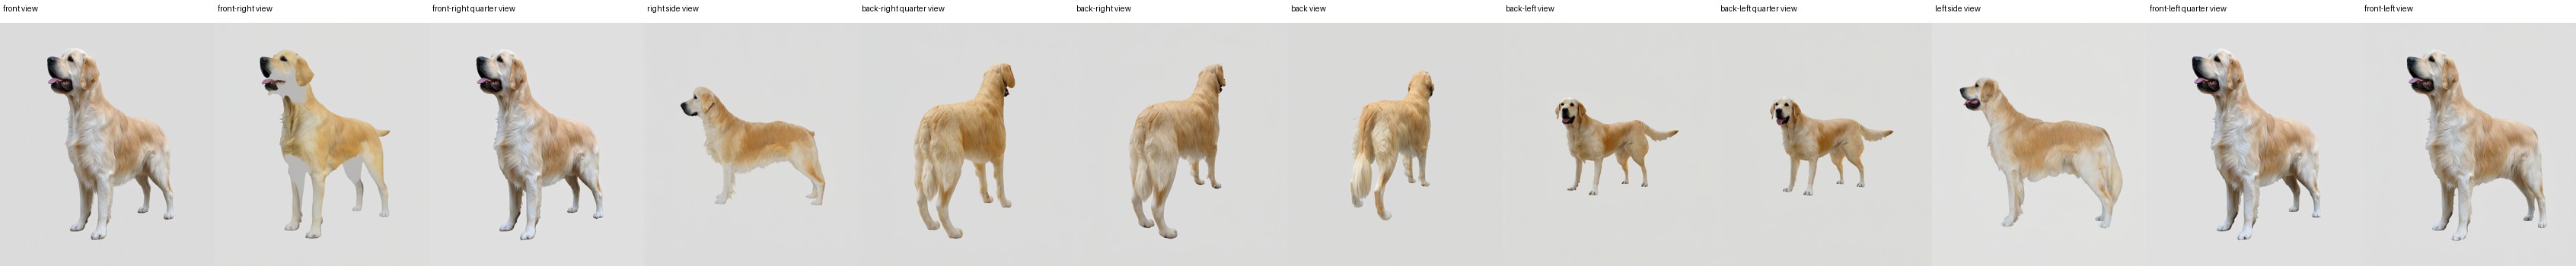
Тот же облёт в виде размеченной полосы, один кадр на азимут.
Грамматика короткая:
<mva> {azimuth}, {elevation}[ close-up]- 12 азимутов с шагом 30 градусов, от вида спереди через оба бока до вида сзади.
- 4 высоты: на уровне глаз, с возвышения (30 градусов), верхний ракурс (60 градусов) и вид сверху (90 градусов).
- Вариант
close-up(крупный план) для каждой комбинации, всего 72 адресуемых ракурса. - Рекомендуемая сила LoRA от
0.8до1.0в ComfyUI или diffusers.
Работа на реальных фотографиях
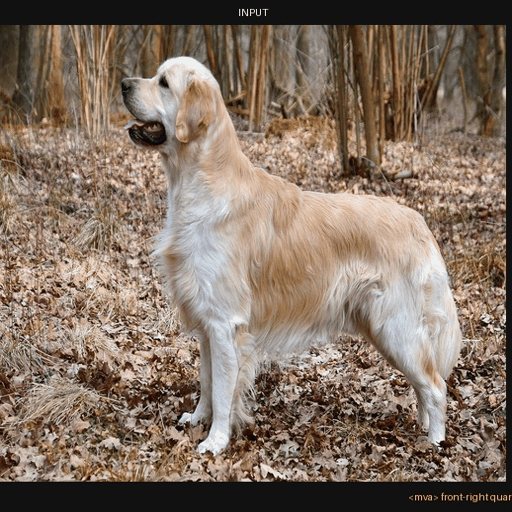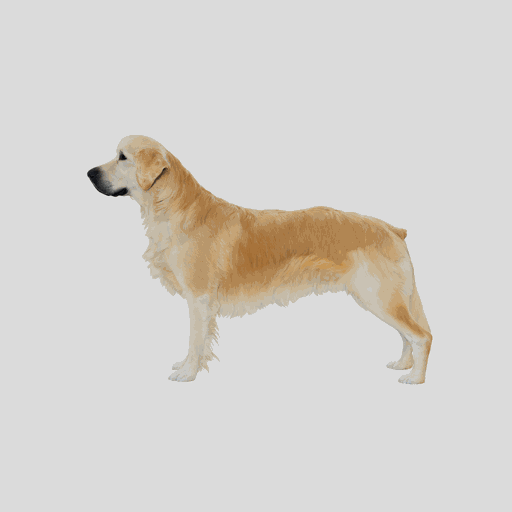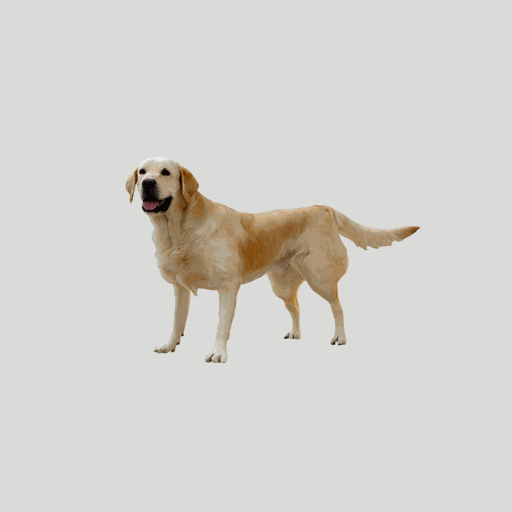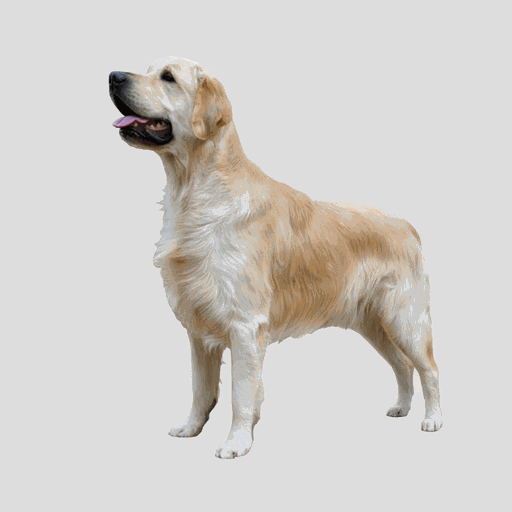
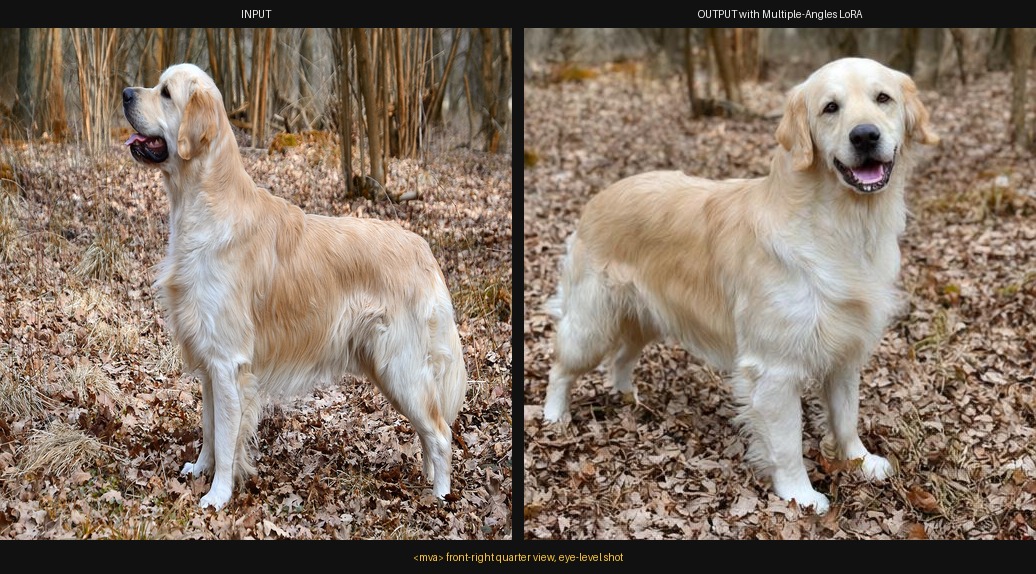
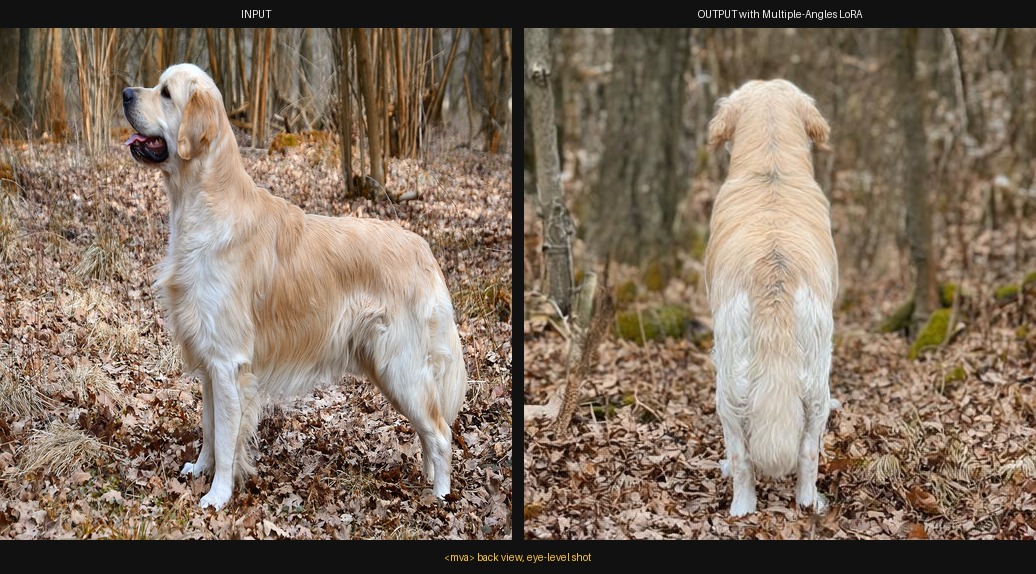
Обучающий набор это отрендеренные объекты, но карточка модели документирует отложенный тест на обычных фотографиях, которых модель никогда не видела: золотистый ретривер, кот и яблоко с Wikimedia Commons. При силе около 1.0 объект поворачивается в запрошенный ракурс, и сцена в основном сохраняется, хотя мелкие детали, например шерсть, смягчаются на объектах, далёких от распределения обучающих данных.
 |  |
|---|---|
| Вид спереди-справа в четверть оборота, на уровне глаз | Вид сзади, на уровне глаз |
Практическое правило из карточки: начинайте с силы 1.0; если пересъёмка начинает копировать референсное фото вместо того, чтобы двигать камеру, снижайте силу к 0.8, а не меняйте чекпойнты.
Что меняет v2
Вторая ревизия это рекомендуемый вариант для скачивания. Она увеличивает число обучающих пар с 5 028 до 13 328 (набор Dome-Objaverse с приоритетом персонажей плюс отфильтрованные по лицензии риггированные персонажи), поднимает ранг с 32 до 64 и переключает базовую точность с convrot int8 на bf16 со взвешенной выборкой временных шагов.
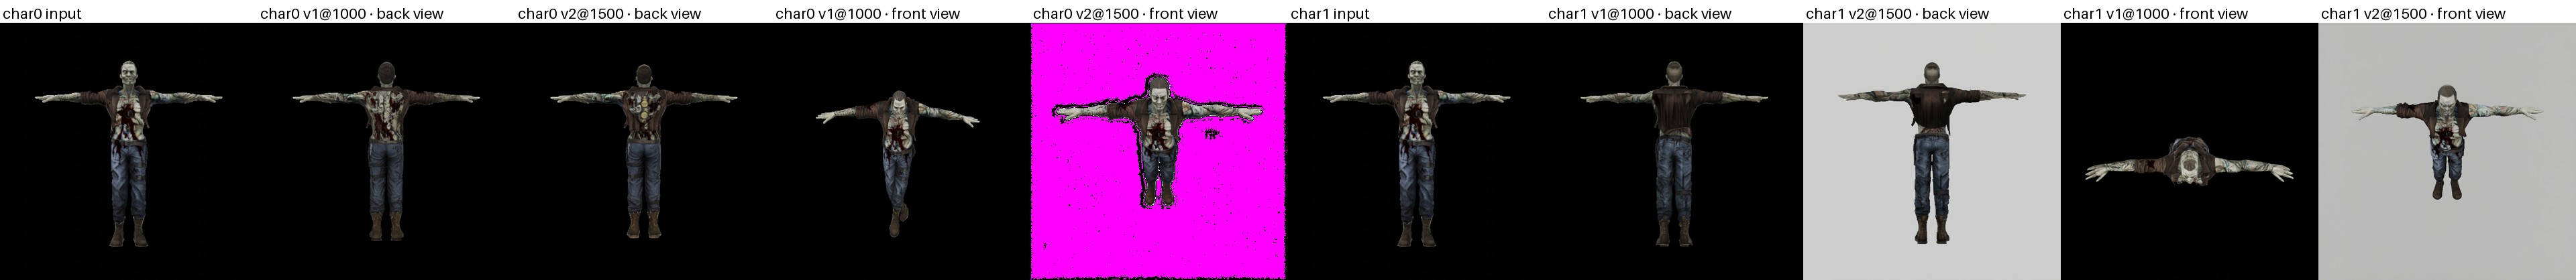
Лист персонажных поз, сравнивающий v1 на шаге 1 000 и v2 на шаге 1 500.
Грамматика <mva> и словарь поз между версиями не изменились, поэтому рабочий процесс, собранный для v1, продолжит работать после замены файла. Карточка рекомендует шаг 1 500 прогона v2 (ранг 64, полная точность, около 319 МБ в checkpoints_v2/); файлы v1 остаются в checkpoints/, где лучшим выбором является шаг 1 000.
Запуск в ComfyUI
Адаптер это обычный LoRA, поэтому пакет узлов не нужен: поместите .safetensors в ComfyUI/models/loras/ и загрузите его стандартным загрузчиком LoRA вместе с диффузионной моделью Qwen-Image 2.1, её текстовым энкодером и подходящим VAE. Карточка рекомендует силу от 0.8 до 1.0; специфичного для адаптера сэмплера или значения CFG нет, поэтому применяются настройки самой базовой модели.
Бенчмарк без прикрас
Карточка публикует отложенный бенчмарк из 144 случаев (24 невиданных объекта, по шесть поз каждый), оценённый против эталонных купольных рендеров по косинусной близости CLIP image-image, и сообщает о результатах честно: неадаптированная базовая модель на самом деле набирает чуть больше в среднем (0.857 против 0.832), потому что эта метрика в основном измеряет глобальное сходство изображений, а не то, сдвинулась ли камера. Авторы отмечают, что правильный протокол это точность определения позы, для которой нужен ещё один проход рендеринга, и направляют читателей к A/B-изображениям с совпадающими промптами как к главному свидетельству самой возможности.
Доступность
Веса: akhaliq/Qwen-Image-2.1-Multiple-Angles-LoRA
Базовая модель: Qwen/Qwen-Image-2.1
Обучающие данные (v2): akhaliq/qwen21-multiple-angles-train-v2
Страница семейства базовой модели: Qwen-Image 2.1
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.