Pruna 5-шаговые и 8-шаговые LoRA для Qwen-Image 2.1 в ComfyUI
LoRA Pruna-Qwen-Image-2.1 от PrunaAI сокращают генерацию и редактирование Qwen-Image 2.1 до 5 или 8 шагов без CFG, с конверсиями ComfyUI от сообщества и сигмами по шагам.
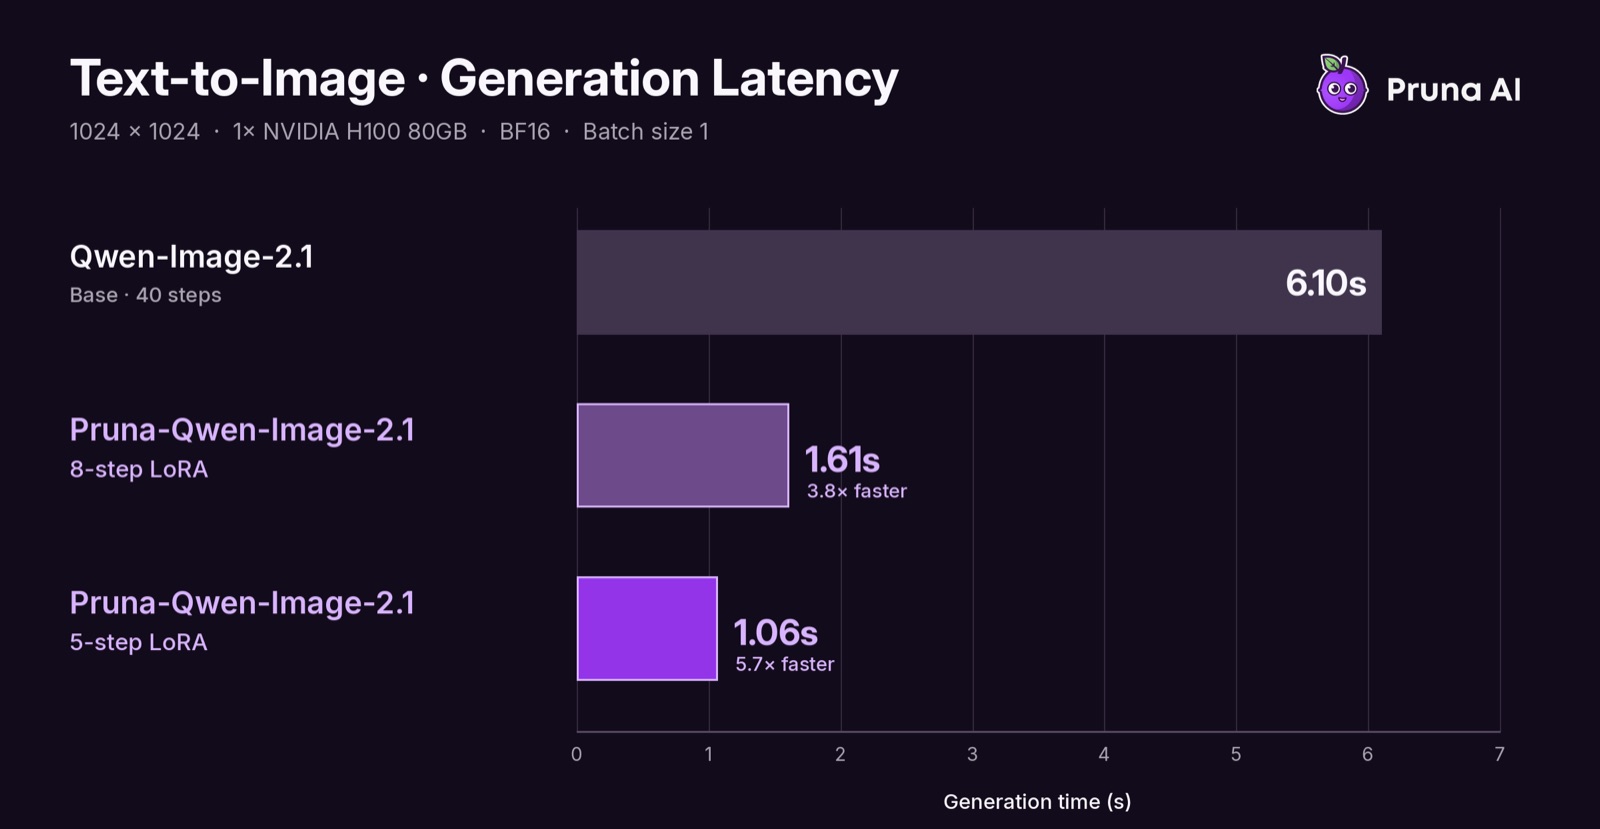
Сравнения text-to-image из официальной карточки модели.
Два адаптера, два расписания
Этот релиз представляет собой не одну дистиллированную модель, а двух отдельно обученных «учеников», и PrunaAI предлагает выбрать один из них в зависимости от того, что для вас важнее: качество или скорость:
| Адаптер | Шаги | Компромисс |
|---|---|---|
p_qwen_image_2.1_8step_v0.1.safetensors | 8 | Более высокое качество, рекомендуется по умолчанию |
p_qwen_image_2.1_5step_v0.1.safetensors | 5 | Быстрее, но изображения заметно хуже |
Каждый адаптер обучался под своё собственное расписание сигм, и карточка модели просит загружать только один за раз. Именно расписания нужно копировать точно, потому что «ученики» не обучались на число шагов, которое сэмплер выводит самостоятельно:
| Шаги | Сигмы |
|---|---|
| 5 | 1.0, 0.94, 0.857142857, 0.666666667, 0.4 |
| 8 | 1.0, 0.933333333, 0.857142857, 0.769230769, 0.666666667, 0.545454545, 0.4, 0.222222222 |
Оба адаптера обучены методом DMD, оба работают при CFG 1.0 с пустым негативным промптом, а завершающий 0 добавляется scheduler'ом, а не записывается в расписание. Другие значения числа шагов, расписаний или CFG выходят за пределы того, для чего адаптеры обучались.
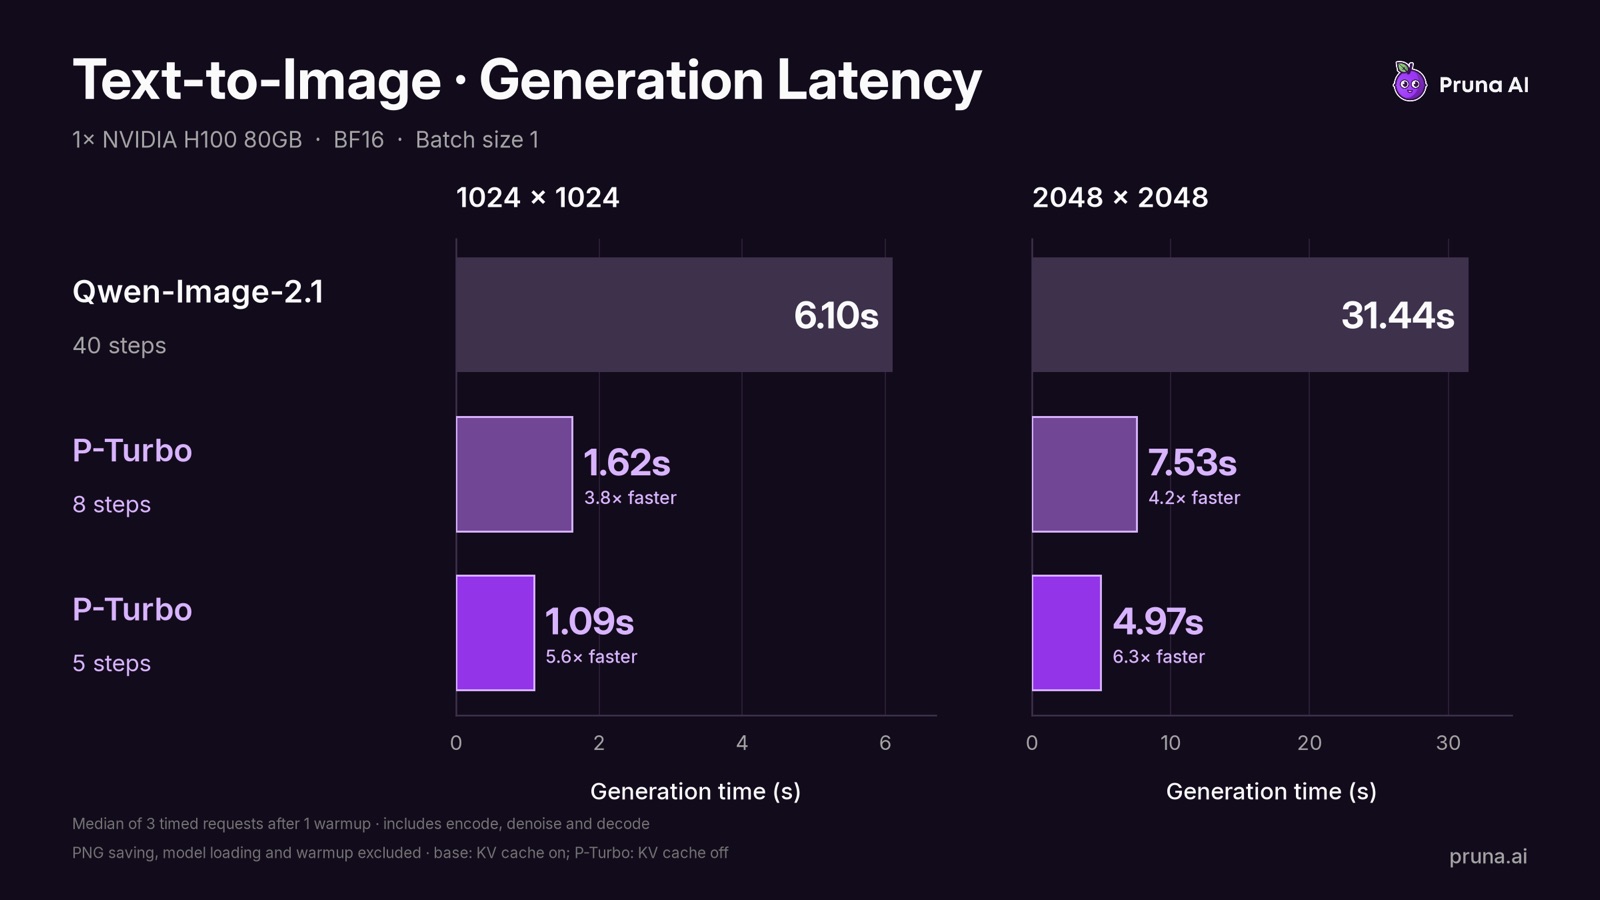
Диаграмма задержки text-to-image из карточки, измеренная на одном H100 80GB: медиана трёх запросов после одного прогрева, включая кодирование промпта, денойзинг и декодирование, при этом базовая модель работает в 40 шагов с KV-кэшем, а адаптеры в 5 или 8 шагов без него.
Главная цифра PrunaAI: до 6.3x быстрее, и карточка осторожна в том, чего она не утверждает: тайминги не подразумевают одинаковое качество изображений, для бенчмарка LoRA оставляли необъединёнными, а в примерах изображений включено KV-кэширование, тогда как диаграмма с этой настройкой не пересчитывалась.
Охват обучения и ограничения
Адаптеры обучались только при разрешении 1K на смеси обычных и апскейленных промптов, охватывая text-to-image и редактирование одного или нескольких изображений с до 3 референсными изображениями. PrunaAI рекомендует начинать с 1024x1024 и считает выход 2K, большее число референсных изображений и короткие расплывчатые промпты выходящими за пределы охвата, где качество может варьироваться.
Релиз явно помечен как v0.1, в процессе разработки:
- Качество ниже, чем у базовой модели с 40 шагами, и репозиторий будет обновляться по мере улучшения дистилляции.
- 5-шаговый адаптер быстрее, и его изображения заметно хуже, чем у 8-шагового.
- Это не самостоятельная модель: базовые веса
Qwen/Qwen-Image-2.1всё ещё обязательны.
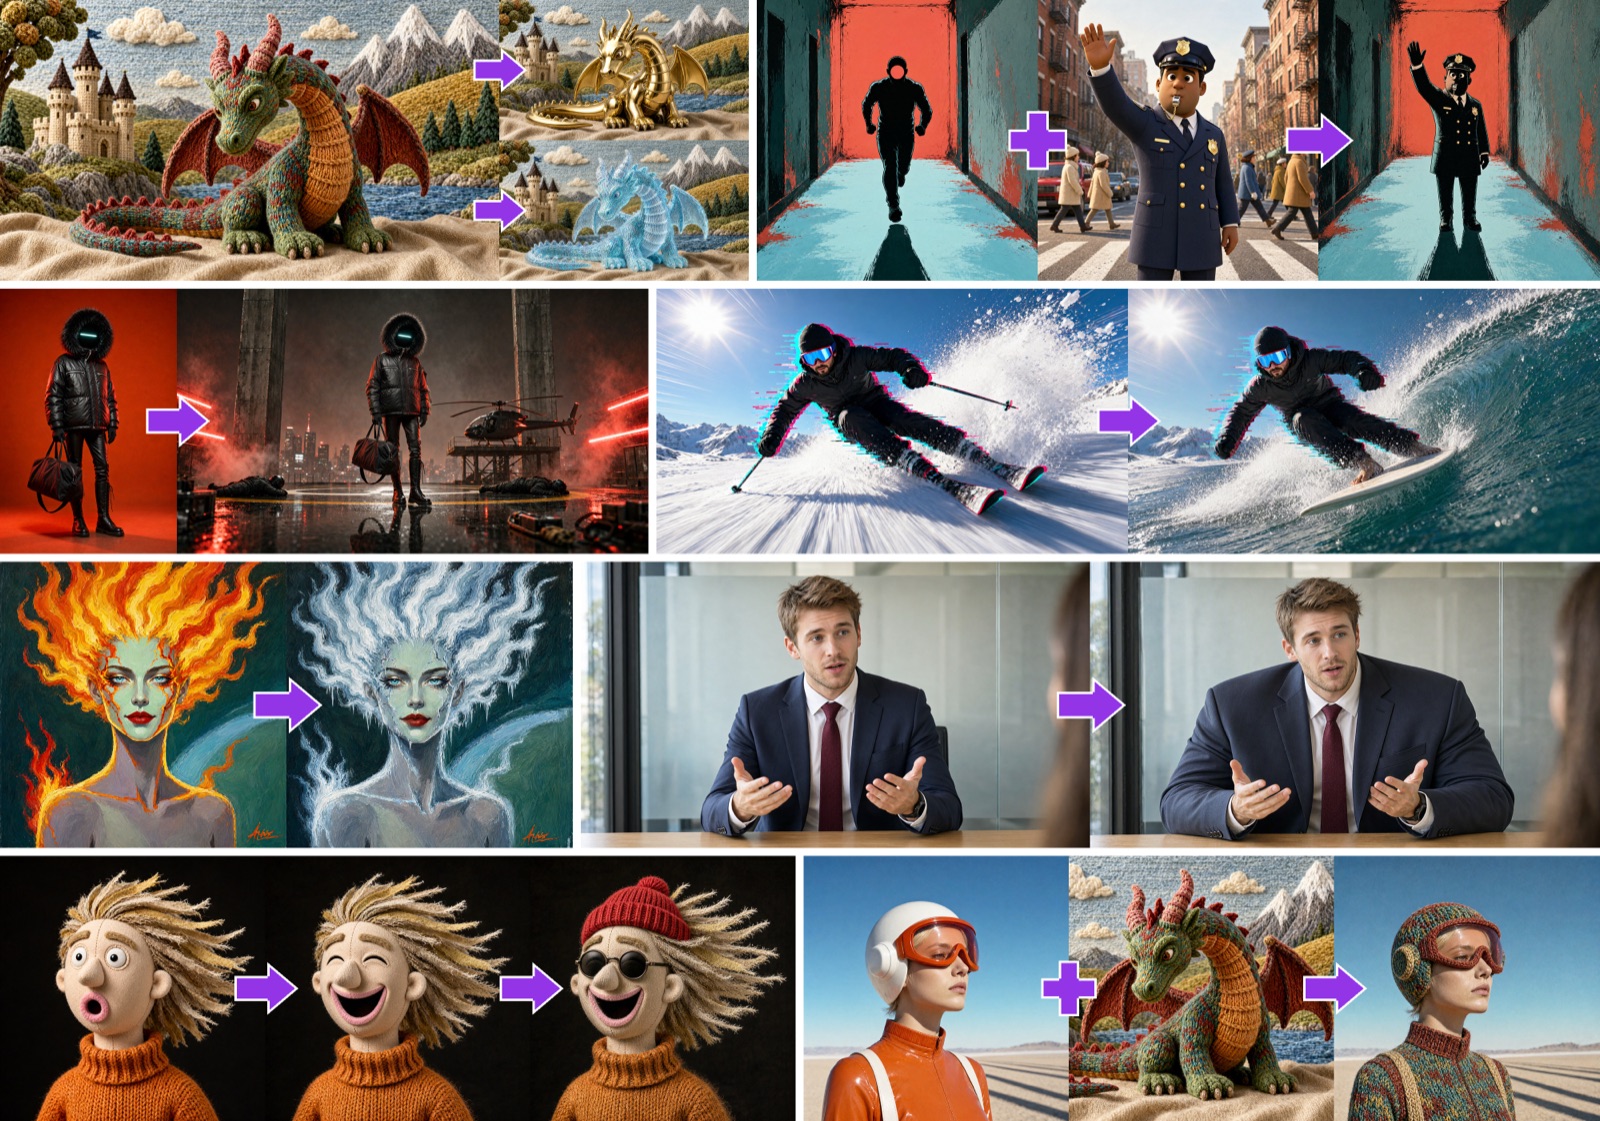
Сетки редактирования из официальной карточки модели.
Доступность в ComfyUI
Официального пакета ComfyUI для адаптеров пока нет: они поставляются как файлы diffusers/PEFT с rank 64 и PEFT alpha 128, причём alpha хранится в метаданных safetensors, а не в тензорах, которые читает загрузчик LoRA в ComfyUI, поэтому прямое добавление запустило бы их в неправильном масштабе. Сообщество закрыло этот пробел в течение дня после релиза:
NidAll/pruna-image-2.1-comfyui-lorasпредставляет собой неофициальную конверсию, которая добавляет скалярный тензор.alphaк каждой из 224 целей LoRA, чтобы адаптеры работали в задуманном масштабе при силе LoRA 1.0, не трогая веса A и B. Она поставляется с собственными JSON-файлами рабочих процессов на 5 и 8 шагов.- Эти рабочие процессы используют только нативные узлы ComfyUI:
ManualSigmas,SamplerCustom, Euler, CFG 1.0, силу LoRA 1.0, без негативного промпта и text-to-image в 1024x1024. Базовые файлы берутся изComfy-Org/Qwen-Image-2.1, а значит трансформерint8_convrotявляется практичной целью для всех, кто ограничен потребительской VRAM.
ComfyUI поддерживает Qwen-Image 2.1 нативно с момента релиза в день выхода, поэтому ничего дополнительно устанавливать не нужно: недавняя версия ComfyUI с ManualSigmas и SamplerCustom покрывает оба поставляемых рабочих процесса.
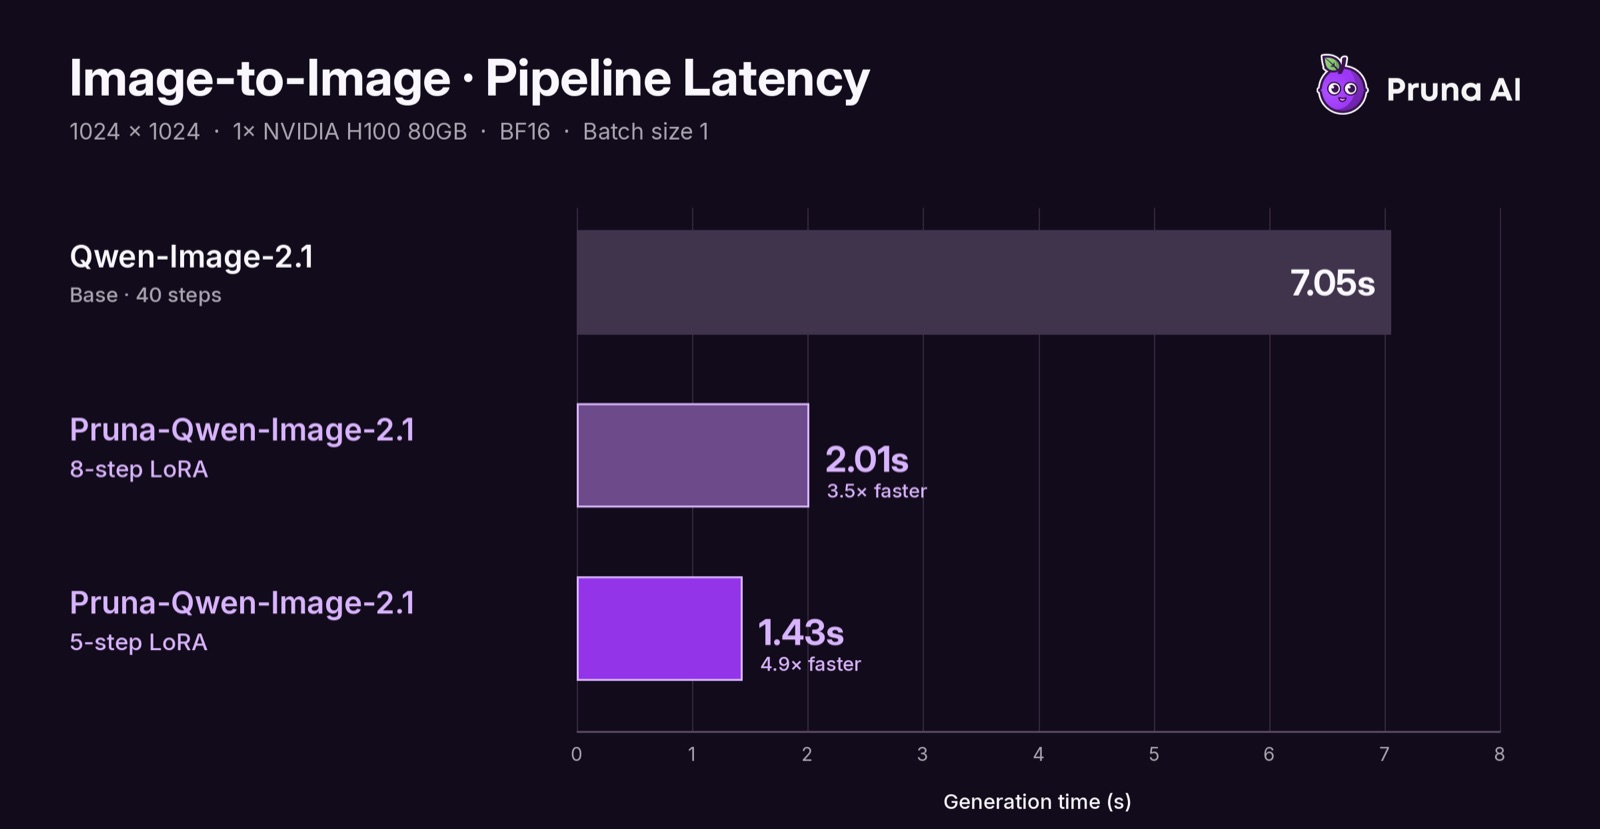
Пример редактирования из карточки модели, выполненный с малошаговыми адаптерами.
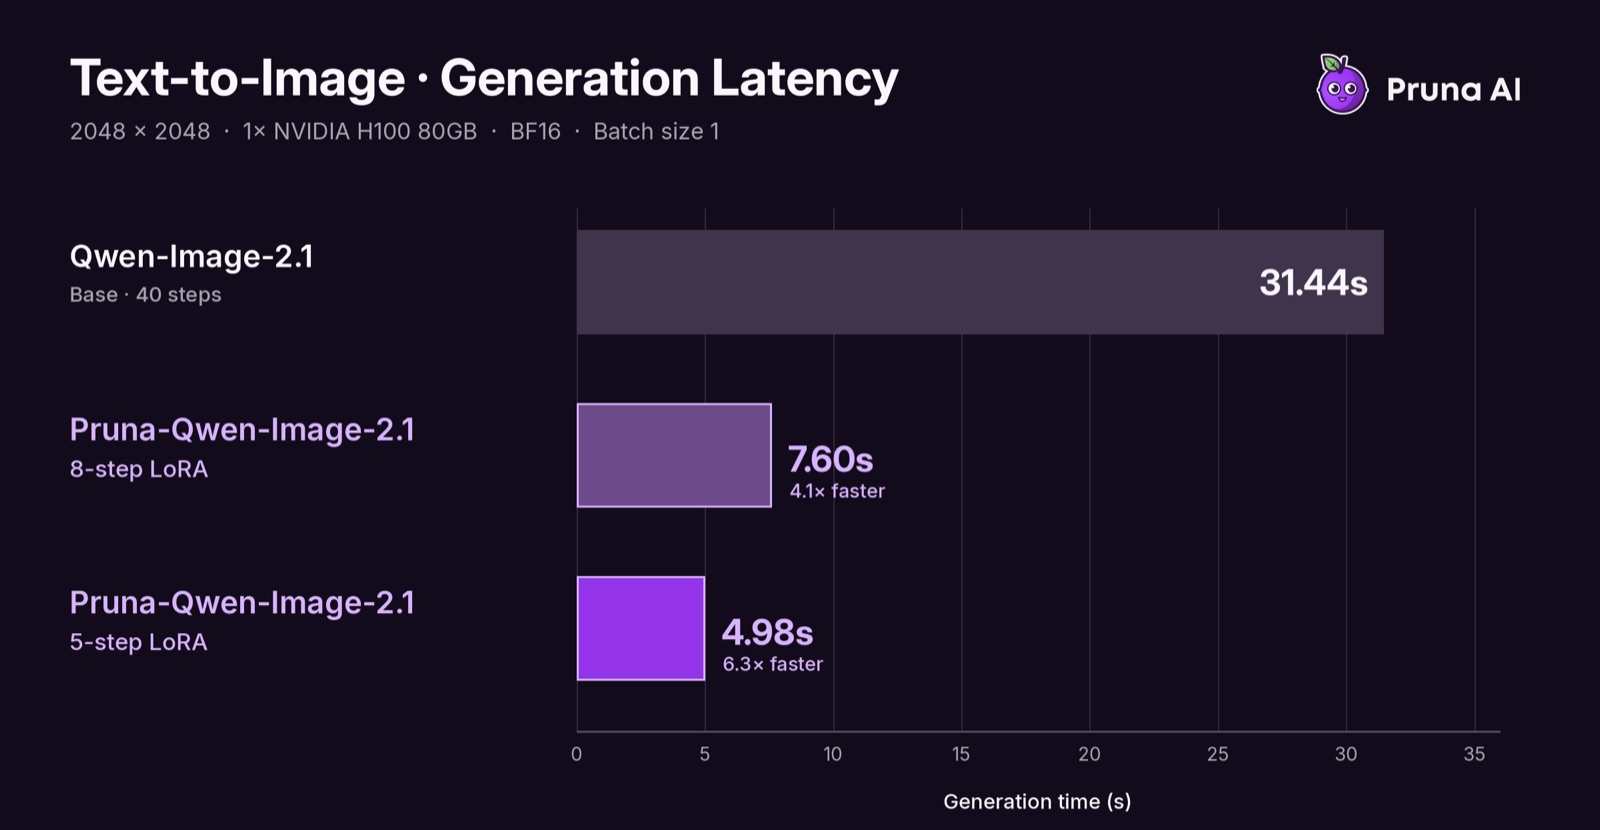
Text-to-image в 2048, за пределами охвата обучения при 1K, но часть опубликованных измерений задержки.
Ранние тесты идут в основном от сообщества ComfyUI, а не от самого релиза: адаптеры сравнивали с turbo от Viggle и официальными Qwen Acc LoRA в канале #qwen-image Banodoco, где тестировщики особо отметили 8-шаговый адаптер, а также публиковали их в r/StableDiffusion и X вскоре после появления весов.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.