LongCat Video Avatar 1.6, 이제 ComfyUI에서 실행
Meituan의 오디오 기반 아바타 모델을 이제 ComfyUI에서 실행할 수 있습니다. Comfy-Org가 가중치를 재패키징했고, 커뮤니티 네이티브 노드 팩이 있으며, 코어 지원은 리뷰 중입니다.
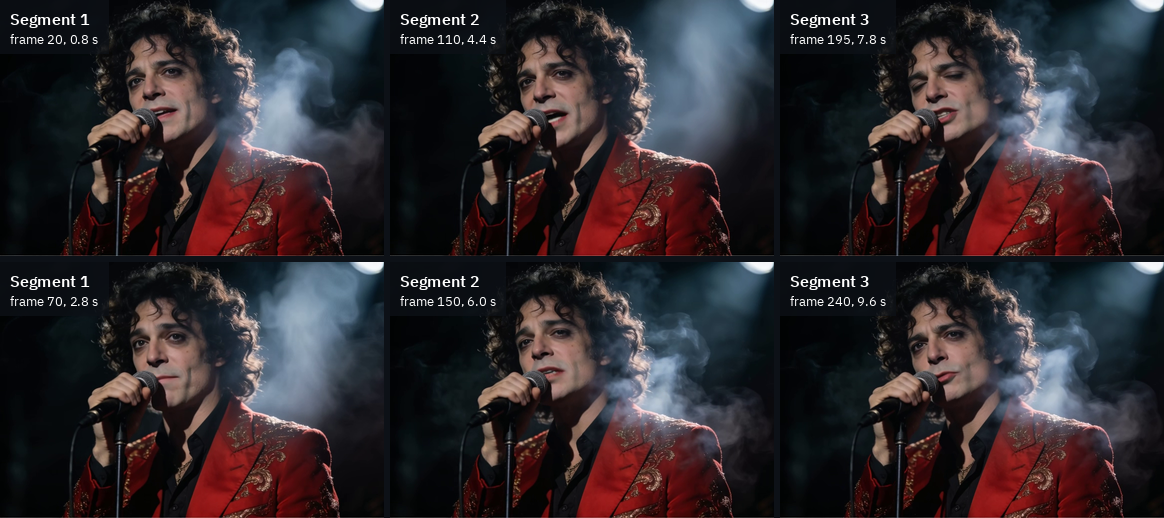
93프레임 세그먼트 세 개에서 각각 두 프레임씩 뽑은 이미지. 각 세그먼트는 이전 세그먼트의 마지막 13프레임에서 이어집니다.
세 가지 접근 경로
| 경로 | 상태 | 내용 |
|---|---|---|
| Comfy-Org 가중치 | 다운로드 가능 | 공식 int8 DiT, 두 LoRA, Whisper 인코더, 그리고 Wan 2.1의 공용 VAE와 텍스트 인코더 |
| ComfyUI-LongCat-Avatar (커뮤니티) | 오늘부터 동작 | Pedro(LatentSpacer)가 만든 네이티브 노드 팩, 8스텝 증류 및 50스텝 베이스 비디오 노드 |
| 코어 지원 (CORE-720, Kijai) | PR 17831, 열려 있음 | comfy/ldm/wan/model_longcat.py와 오디오 인코더 연결을 추가하며, 아직 병합되지 않음 |
이 노드 팩은 ComfyUI-Manager에서 LongCat Avatar Native로 설치하거나 comfy node install longcat-avatar-native로 설치할 수 있습니다. ComfyUI 0.44에서 테스트되었으며, ComfyUI 자체 패키지 외에는 별도의 패키지가 필요하지 않습니다.
다운로드할 파일
Comfy-Org/LongCat-Video-Avatar의 폴더 구조는 ComfyUI/models와 동일합니다.
| 파일 | 폴더 | 크기 |
|---|---|---|
longcat-avatar-1.6_int8_convrot.safetensors | diffusion_models | 14.9 GiB |
longcat-avatar-1.6_dmd_lora_rank128_bf16.safetensors | loras | 1.2 GiB |
longcat-avatar-1.6_opsd_lora_rank128_bf16.safetensors | loras | 1.2 GiB |
umt5_xxl_int8_convrot 또는 umt5_xxl_fp16 | text_encoders | 5.3 또는 10.6 GiB |
whisper_large_v3_encoder_fp16.safetensors | audio_encoders | 1.2 GiB |
wan_2.1_vae.safetensors | vae | 242 MiB |
텍스트 인코더와 VAE는 Wan 2.1 파일이므로, 이미 ComfyUI를 설치해 두었다면 해당 파일이 이미 있을 가능성이 높습니다.
4090 한 장에서의 속도
이 포팅의 작성자는 768×512 해상도에서 int8 ConvRot와 ComfyUI의 ck 어텐션을 사용해 연속 스텝당 5.1초를 측정했습니다. 253프레임 클립(10.1초 분량의 발화)을 세 세그먼트로 나누어 처리하는 데 약 162초가 걸렸습니다. 또한 W6A8 및 W4A8 버전도 함께 배포했는데, int8의 14.9GiB, bf16의 29.5GiB에 비해 각각 12.3GiB와 8.8GiB이며 두 LoRA 모두 이 모든 버전에 적용됩니다.
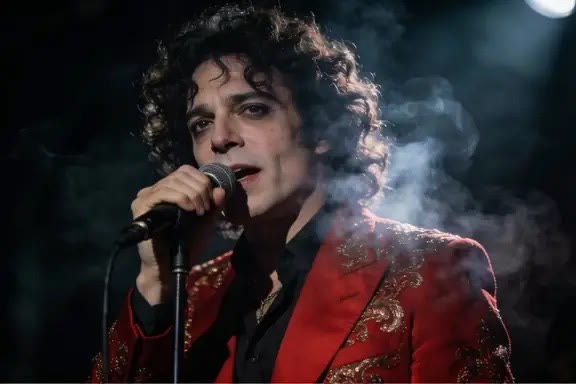
노드 팩으로 생성한 클립 하나. 입 모양이 세 세그먼트 전반에서 발화를 따라갑니다.
베이스 50스텝 노드는 텍스트 및 오디오 가이드를 사용하고 LoRA 없이 동작하며, 각 스텝마다 모델을 세 번 실행하기 때문에 증류 경로보다 몇 배는 느립니다.
제공 현황
- ComfyUI 가중치: Comfy-Org/LongCat-Video-Avatar
- 노드 팩: ComfyUI-LongCat-Avatar, 가중치 미러: PedroMarinhoDev/LongCat-Video-Avatar-1.6-ComfyUI
- 코어 지원: Comfy-Org/ComfyUI PR 17831
- 원본 모델: meituan-longcat/LongCat-Video-Avatar-1.6
댓글
GitHub로 로그인하고 토론에 참여하세요.