Direct3D-V3: ComfyUI에서 잠재 데이터 없는 복셀 메시 정밀화
Direct3D-V3는 VAE 대신 잠재 데이터 없는 복셀 확산으로 거친 3D 메시를 정밀화하며, 커뮤니티 ComfyUI 노드 팩으로 Windows GPU에서 실행할 수 있습니다.
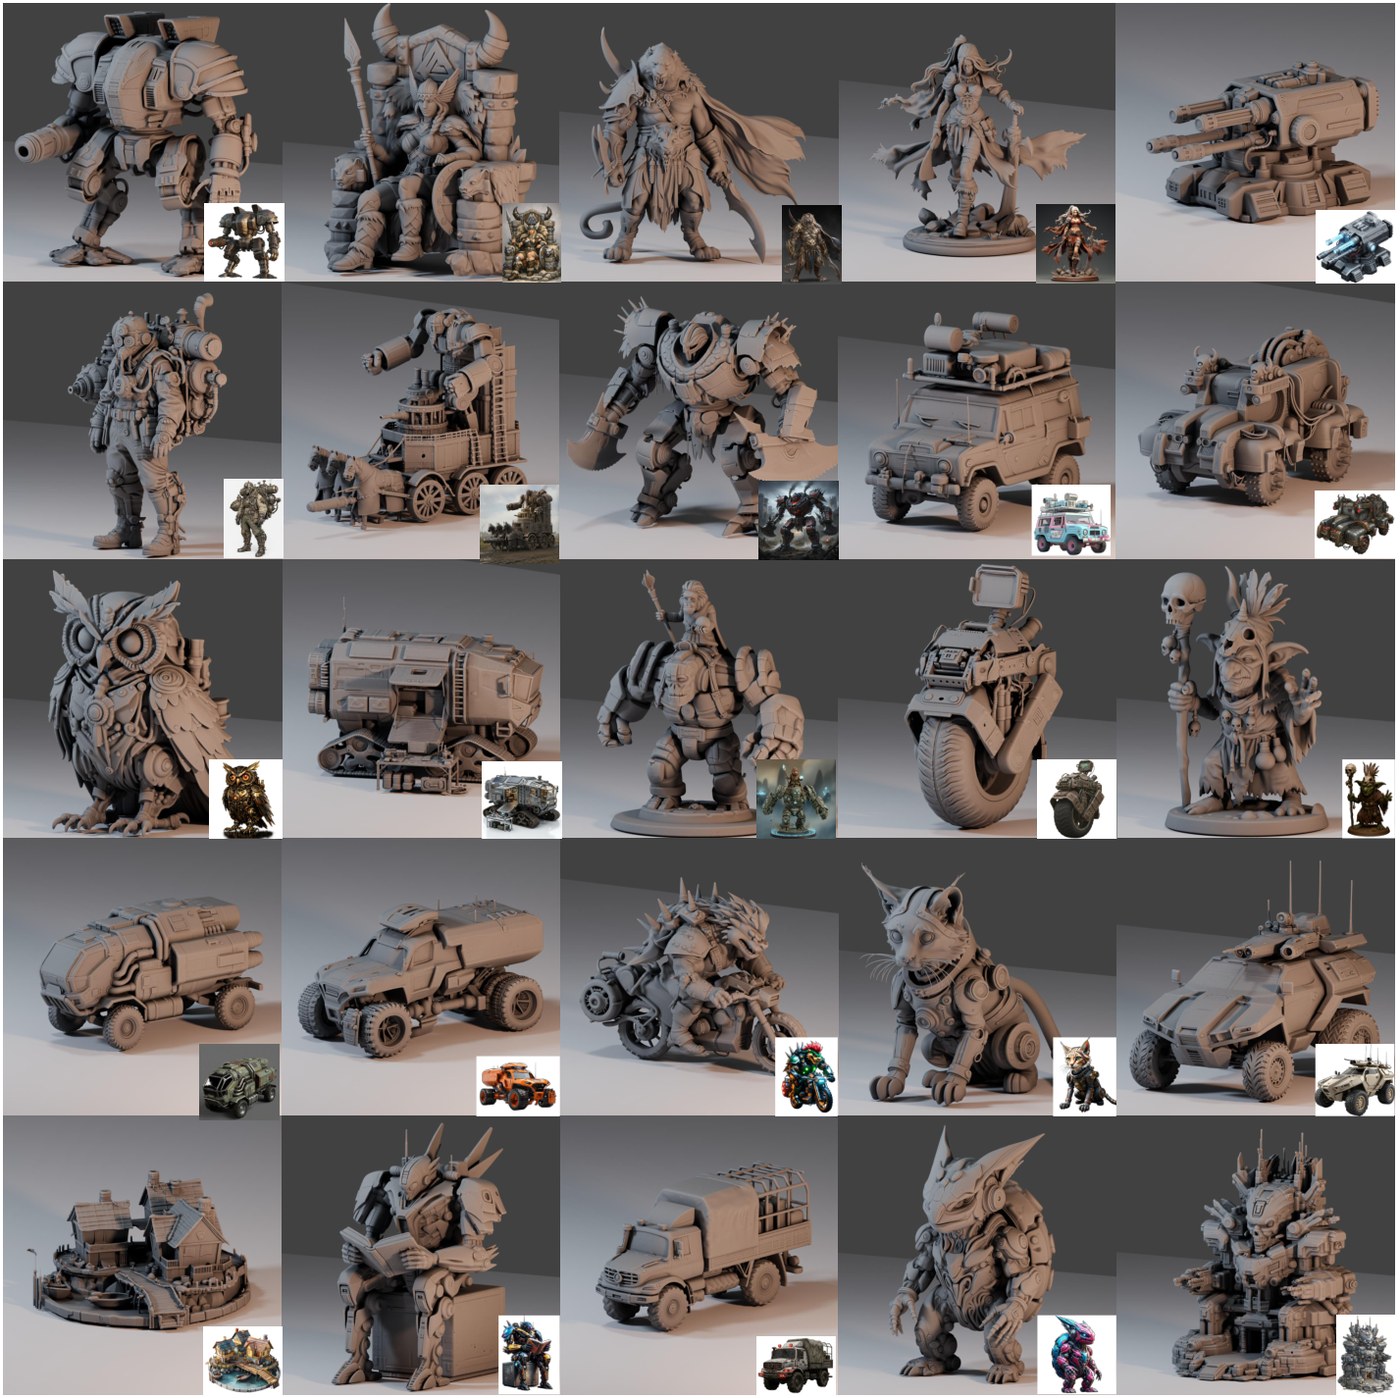
논문의 추가 결과에서 가져온 생성된 메시와 표면 디테일.
기능
참조 이미지와 같은 방향의 거친 메시를 입력하면 형태를 정밀화합니다. 거친 단계에서 매끄럽게 사라진 홈, 베벨, 얇은 구조, 날카로운 모서리를 복원합니다. 암시적 매니폴드 정규화가 표면을 닫힌 상태로 유지합니다. 메시는 기본적으로 200만 삼각형(target_faces)으로 단순화되며 GLB로 내보낼 수 있습니다.
논문의 주장은 잠재 확산 기반의 모든 이미지→3D 스택이 세밀한 기하를 두 번 버린다는 것입니다. 한 번은 VAE가 형태를 압축할 때, 또 한 번은 VAE가 재구성용으로 학습되는 반면 생성기는 분포 매칭용으로 학습되기 때문입니다. Direct3D-V3는 VAE를 제거하고 확산 트랜스포머로 원시 SDF 복셀 그리드를 직접 모델링하며, 인접 복셀에 대한 매니폴드 정규화와 보조 카메라 예측 작업을 추가해 조건화 이미지가 생성된 기하와 정렬되도록 합니다.
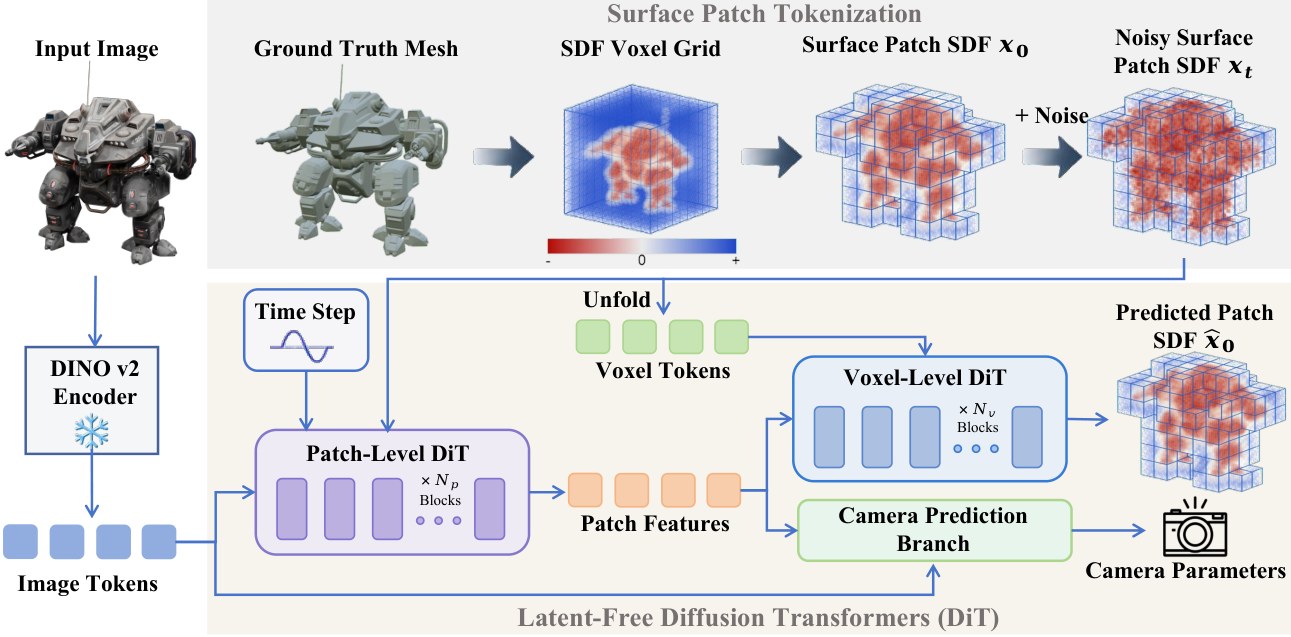
학습과 샘플링은 복셀 그리드 자체에서 이루어지며, 메시는 Marching Cubes를 통해 생성됩니다.
체크포인트는 512, 1024, 1536 세 가지로 제공됩니다. 캐스케이드 또는 단일 단계로 실행할 수 있으며, 시작 기준값은 512와 1024에서 15 스텝, CFG 4입니다.
ComfyUI에서 실행하기
- Direct3D-V3_Comfyui_Nodes에서 Windows 빌드 중 하나를 받아(Python 3.12 및 PyTorch 2.8용 cu128, Python 3.13 및 PyTorch 2.12.1용 cu130) 폴더를
ComfyUI/custom_nodes에 압축 해제합니다. - Hugging Face에서 DINOv3 ViT-H+ 접근을 요청합니다. 노드는 이를 이미지 인코더로 사용하며, 설정 시 읽기 토큰을 요구합니다.
- 노드 폴더에서
setup.cmd를 실행합니다. 전용.runtimePython 환경을 만들고 PyTorch, DINOv3, 1536 체크포인트를 다운로드합니다. 수 GB의 디스크 공간을 확보해 두어야 합니다. - Direct3D-V3 Clean | Mesh File Path와 **Refine (Mesh File, Low VRAM)**를 추가하고, 메시 경로, 참조 이미지, 전경 마스크를 연결한 다음
resolution = 1536,stage_mode = single_stage로 시작합니다.
두 노드 빌드 모두 자체 완결형입니다. CUDA Toolkit이나 Visual Studio가 필요 없고, RTX 20~50 시리즈용 복셀라이저가 미리 빌드되어 있으며, ComfyUI는 자체 Python과 PyTorch를 유지합니다. 어텐션 기본값은 efficient이고, cudnn_fp16은 FP16에서 더 빠르지만 반올림이 달라지므로 내보내기를 비교할 때는 시드를 고정하세요.
테스터들이 본 것
- 노드 팩을 만든 MostAadTech는 114,832개의 복셀 패치로 1536 단계를 실행해 최대 예약 VRAM 6,008 MiB를 기록했고, cuDNN 프리셋으로 완전한 드래곤을 9분 56초에 완료했으며 수축은 0이었습니다.
- 두 번째 실행에서는 정점 415만 / 삼각형 830만이 보고되었고 프롬프트는 325초에 완료되었습니다.
- Kijai는 약 10만 토큰에서 활성화 피크 약 4.9 GB를 측정했으며, 그중 약 2 GB는 상주하는 스킵 토큰입니다.
- 실제 전체 파이프라인은 리파이너 단독보다 깁니다. Pixal3D 또는 TRELLIS.2에서 거친 메시를 만들고, Qwen-Image-2.1로 노멀 맵을 생성한 뒤, Direct3D-V3를 거치고, 마지막으로 UltraTex로 텍스처링합니다.
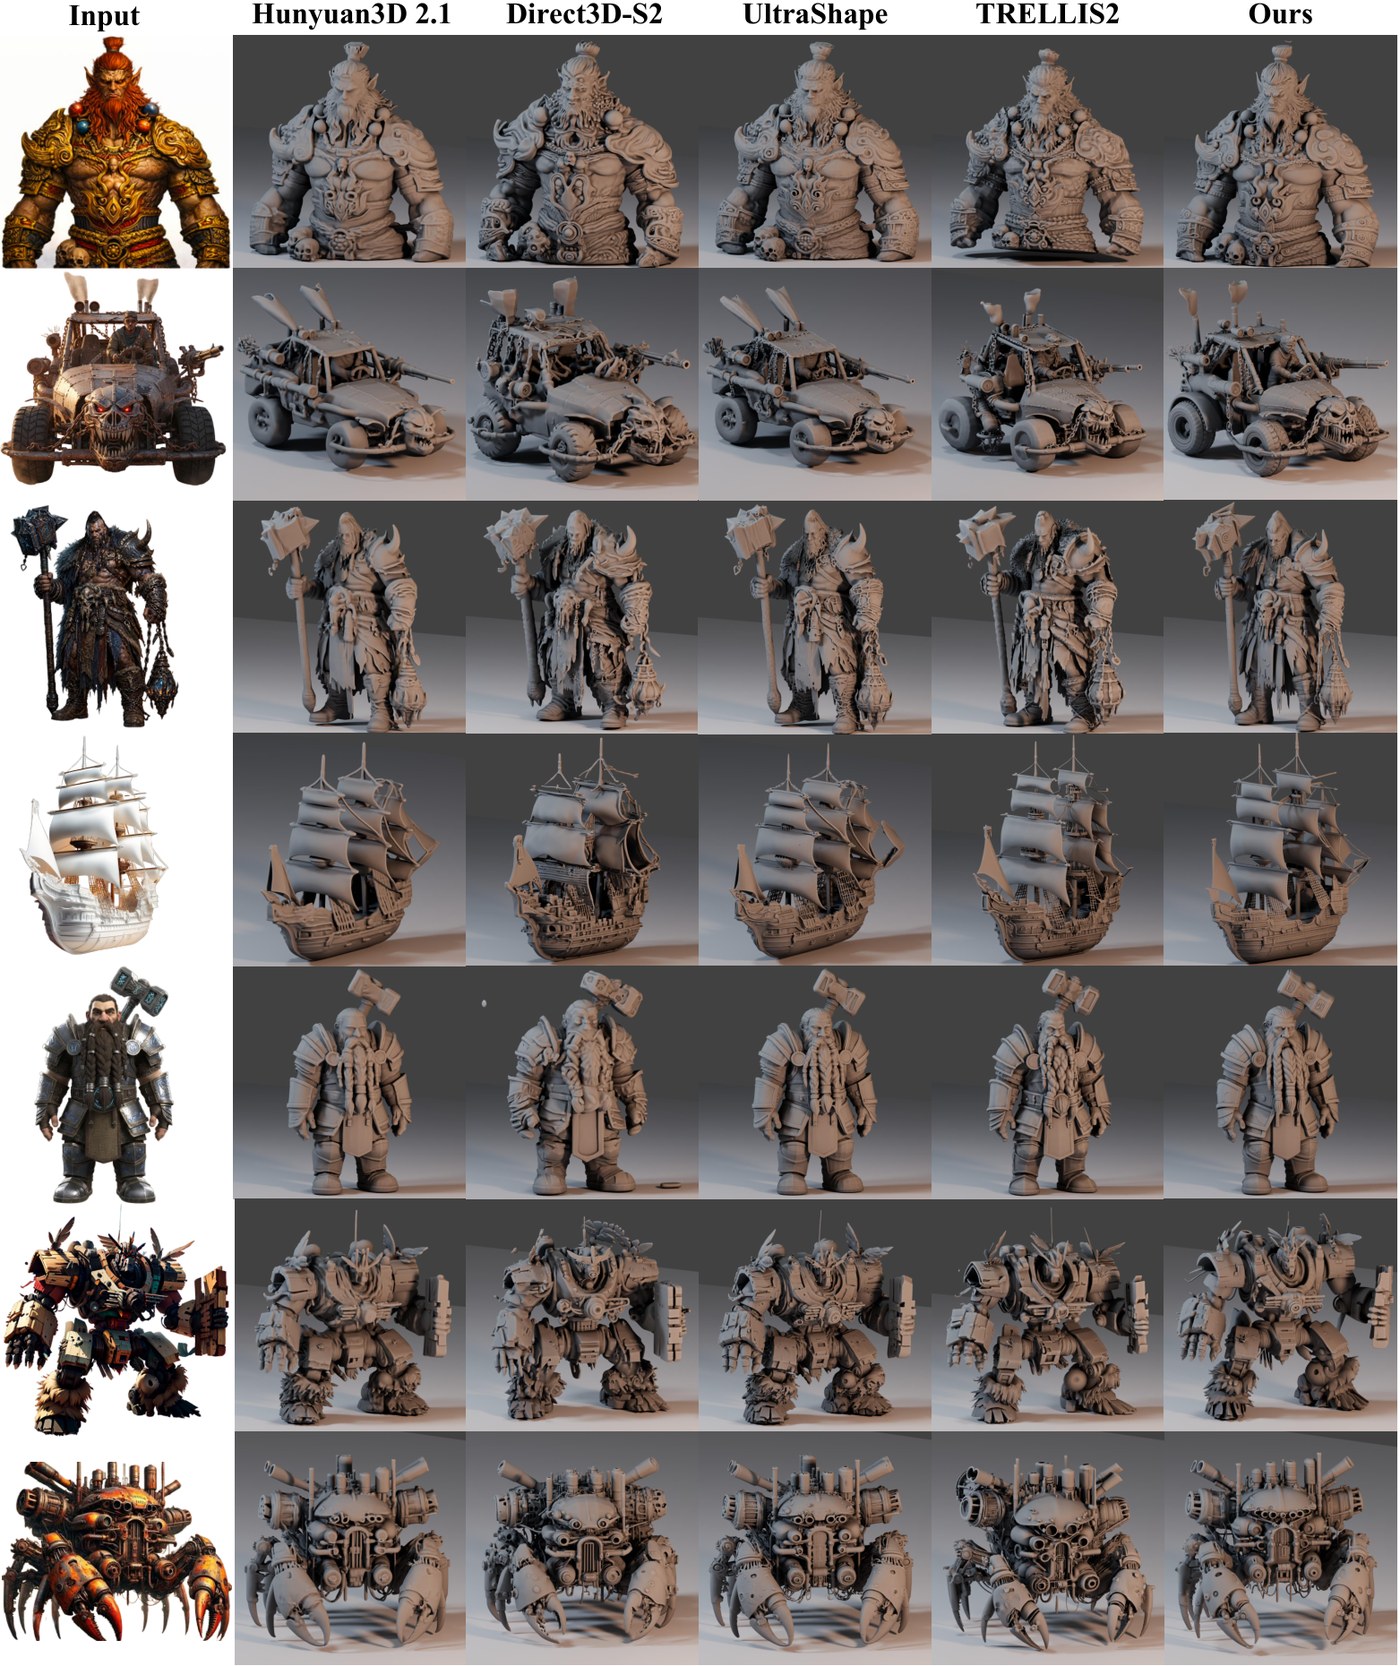
논문의 다른 오픈소스 이미지→3D 방법과의 정성적 비교.
시작하기 전에
- 이번 릴리스에는 거친(coarse) 단계가 없습니다. 저자들은 초기 메시를 위해 Hunyuan3D-2.1 또는 UltraShape-1.0을 권장하며, 자체 거친 모델은 아직 할 일 목록에 남아 있습니다.
- 참조 이미지가 평소보다 중요합니다. 표면 노멀 맵이나 흰색 클레이 렌더가 텍스처가 있는 RGB 이미지보다 눈에 띄게 세밀한 디테일을 제공합니다. 리포지토리에서는 해당 변환에 ChatGPT(GPT Image 2.5) 또는 Lotus-2를 권장하며, Qwen-Image-2.1은 무료 옵션으로 사용할 수 있습니다.
- 공개된 가중치는 논문보다 최신입니다. 저자들에 따르면 공개된 체크포인트는 DINOv3 레이어 4개와 Muon 옵티마이저를 사용하며 논문에서 평가한 모델보다 더 세밀한 표면을 생성하므로, 논문의 수치는 현재 출력을 과소평가합니다.
- 텍스처링과 학습 코드는 아직 공개되지 않았습니다. 이번 릴리스에는 메시 정밀화만 포함되므로 텍스처는 별도 모델에서 처리합니다.
다운로드
- 가중치: wushuang98/Direct3D-V3 (512, 1024, 1536 단계 체크포인트)
- 공식 코드, Gradio 데모 및 추론 예제: DreamTechAI/Direct3D-V3
- 논문: SIGGRAPH Asia 2026, arXiv 2611.26511, 결과는 프로젝트 페이지에서 확인
- ComfyUI 어댑터 (Windows): Mstafa-awad/Direct3D-V3_Comfyui_Nodes
댓글
GitHub로 로그인하고 토론에 참여하세요.