ComfyUI, 프레임별 업스케일을 위한 Video Deflicker 노드 추가
ComfyUI 코어에 Kijai의 Video Deflicker 노드가 추가되었습니다. 프레임별로 처리된 비디오의 깜빡임을 제거하며, torchvision보다 2.3배 빠른 네이티브 RAFT 흐름을 사용합니다.
ComfyUI 코어에 Video Deflicker 노드가 추가되었습니다. 프레임별 업스케일처럼 프레임 단위로 처리한 뒤 깜빡이는 프레임을 입력하면, 각 프레임의 디테일은 유지하면서 이웃 프레임 쪽으로 끌어당깁니다. Kijai의 PR #17754를 통해 11월 15일 병합되었습니다. 추가로 필요한 파일은 ComfyUI/models/optical_flow/에 넣는 torchvision의 RAFT-large checkpoint뿐입니다.
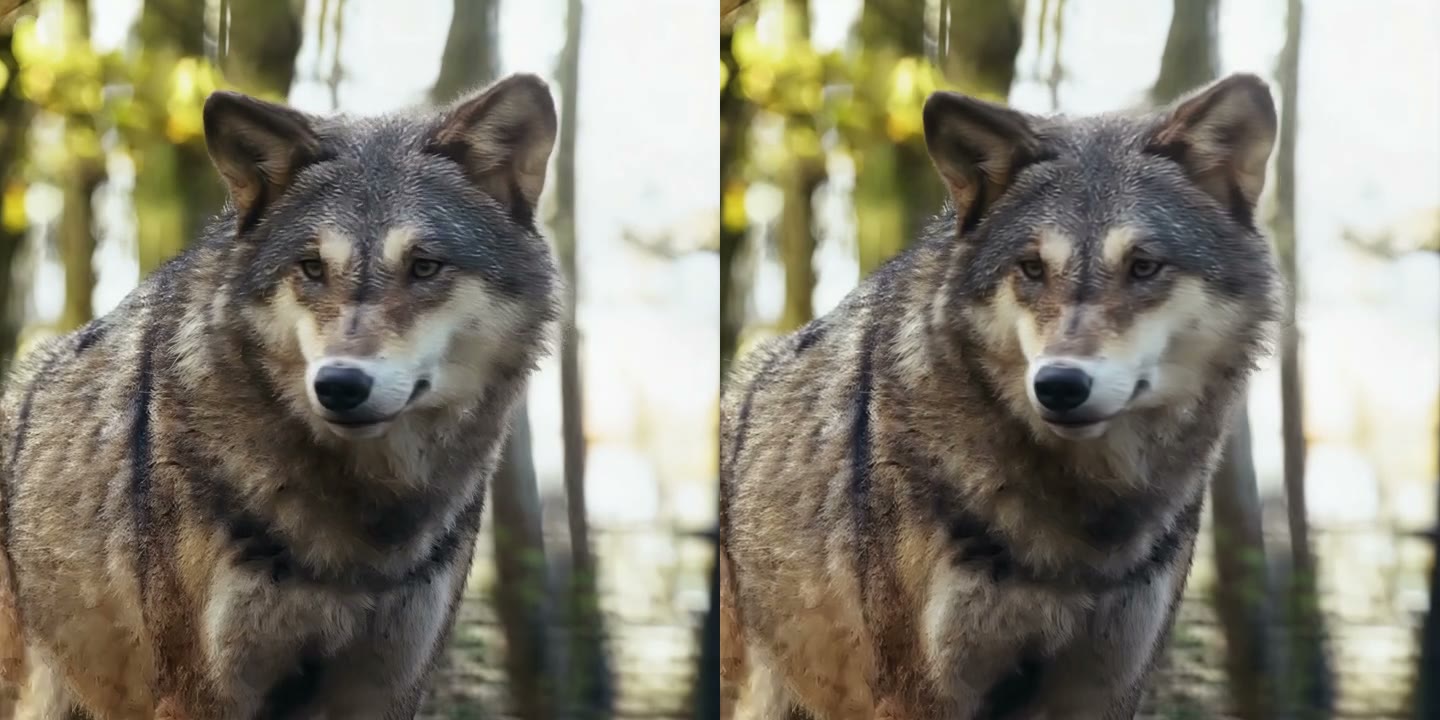
왼쪽: 프레임 단위로 처리된 클립. 오른쪽: Video Deflicker 적용 후 같은 클립. 소스: Comfy-Org/ComfyUI #17754
두 클립을 나란히 배치한 모습. 각 53프레임이며 패널당 720 px로 재인코딩했습니다.
해결하는 문제
- 프레임별 업스케일과 프레임별 편집: 각 프레임이 개별적으로 처리되어 프레임 사이의 작은 차이가 깜빡임으로 보이는 경우를 해결합니다.
- 깨끗한 소스를
guide로 전달하는 것이 잘 동작하게 만드는 핵심입니다. 노드는 깜빡이는 프레임이 아니라 안정적인 프레임에서 움직임을 읽습니다. guide가 없으면 입력 프레임을 사용하며 제거 효과가 줄어듭니다. - 실제 변화는 유지됩니다.
threshold는 움직임 보정된 이웃 프레임과의 차이를 실제 변화로 판단하므로, 컷이나 빠른 동작이 뭉개지지 않습니다.
실행 방법
raft_large.pth(torchvision RAFT-large, 21 MB)를 download.pytorch.org에서ComfyUI/models/optical_flow/로 다운로드합니다. ComfyUI는 광학 흐름 가중치를 자동으로 다운로드하지 않습니다.- **광학 흐름 모델 불러오기(Load Optical Flow Model)**를 추가하고
raft_large.pth를 선택합니다. - Video Deflicker(카테고리
video)를 추가하고, 흐름 모델과 깜빡이는 프레임, 깨끗한 소스 프레임을guide에 연결합니다.
| 입력 | 기본값 | 동작 |
|---|---|---|
optical_flow | 필수 | 광학 흐름 모델 불러오기에서 가져온 RAFT-large |
images | 필수 | 깜빡이는 프레임 |
guide | images | 움직임을 읽어올 안정적인 프레임, 해상도 무관 |
strength | 1.0 | 각 프레임이 이웃 프레임을 얼마나 강하게 따를지. 높을수록 세부 디테일이 더 많이 스무딩됨 |
direction | bidirectional | 정방향과 역방향 패스를 평균. forward는 시간이 절반 소요 |
threshold | 0.1 | 이 값을 넘는 변화는 선명하게 유지. 0이면 모든 변화를 동일하게 스무딩 |
흐름은 내부적으로 최대 768x768에서 계산되므로, 4K guide는 움직임 추정을 위해 다운스케일되고 해석(solve) 단계만 전체 해상도에서 실행됩니다.
코어의 더 빨라진 RAFT
같은 PR에서 torchvision의 raft_large를 네이티브 구현으로 교체했습니다. fp16 네트워크에 fp32 상관(correlation)을 사용하며, 업데이트 루프는 동적 VRAM 환경에서 CUDA graph로 실행됩니다. 1024x576 기준으로 torchvision 버전보다 약 2.3배 빠릅니다. VOID warped-noise 노드도 이제 이 구현을 사용합니다.
사용 가능 시점
이 노드는 11월 15일 병합 기준으로 main 분기에 포함되어 있습니다. 최신 태그 릴리스인 v0.45.0(11월 10일)은 그보다 이전이므로, 다음 릴리스까지는 최신 테스트 버전(nightly) 빌드를 사용하세요.
댓글
GitHub로 로그인하고 토론에 참여하세요.