ComfyUI v0.45.0: Qwen3.x 텍스트 생성 속도 2배 향상
ComfyUI Wikinews
ComfyUI v0.45.0은 Qwen3.x 텍스트 생성을 재작성했습니다. RTX 5090에서 Qwen3.5 9B가 초당 106토큰에서 219토큰으로 빨라지며, 적응형 트리 MTP와 INT8 어텐션을 사용합니다.
Comfy Org는 11월 11일 ComfyUI 엔지니어링 글을 게시했습니다. Qwen3.x 텍스트 생성 경로를 재작성하여 동일한 체크포인트가 동일한 GPU에서 최대 2배 빠르게 실행되며, 모델이나 생성되는 텍스트는 바뀌지 않습니다. 여기서 다루는 모든 내용은 ComfyUI v0.45.0에 포함되어 출시됩니다.
ComfyUI의 프롬프트 개선, 이미지 캡셔닝, 스토리 작성은 모두 텍스트 생성이므로 이 속도 향상을 그대로 누릴 수 있습니다. 설정할 것은 Generate Text 노드의 mtp 옵션뿐이며, 기본값은 auto로 유지됩니다.
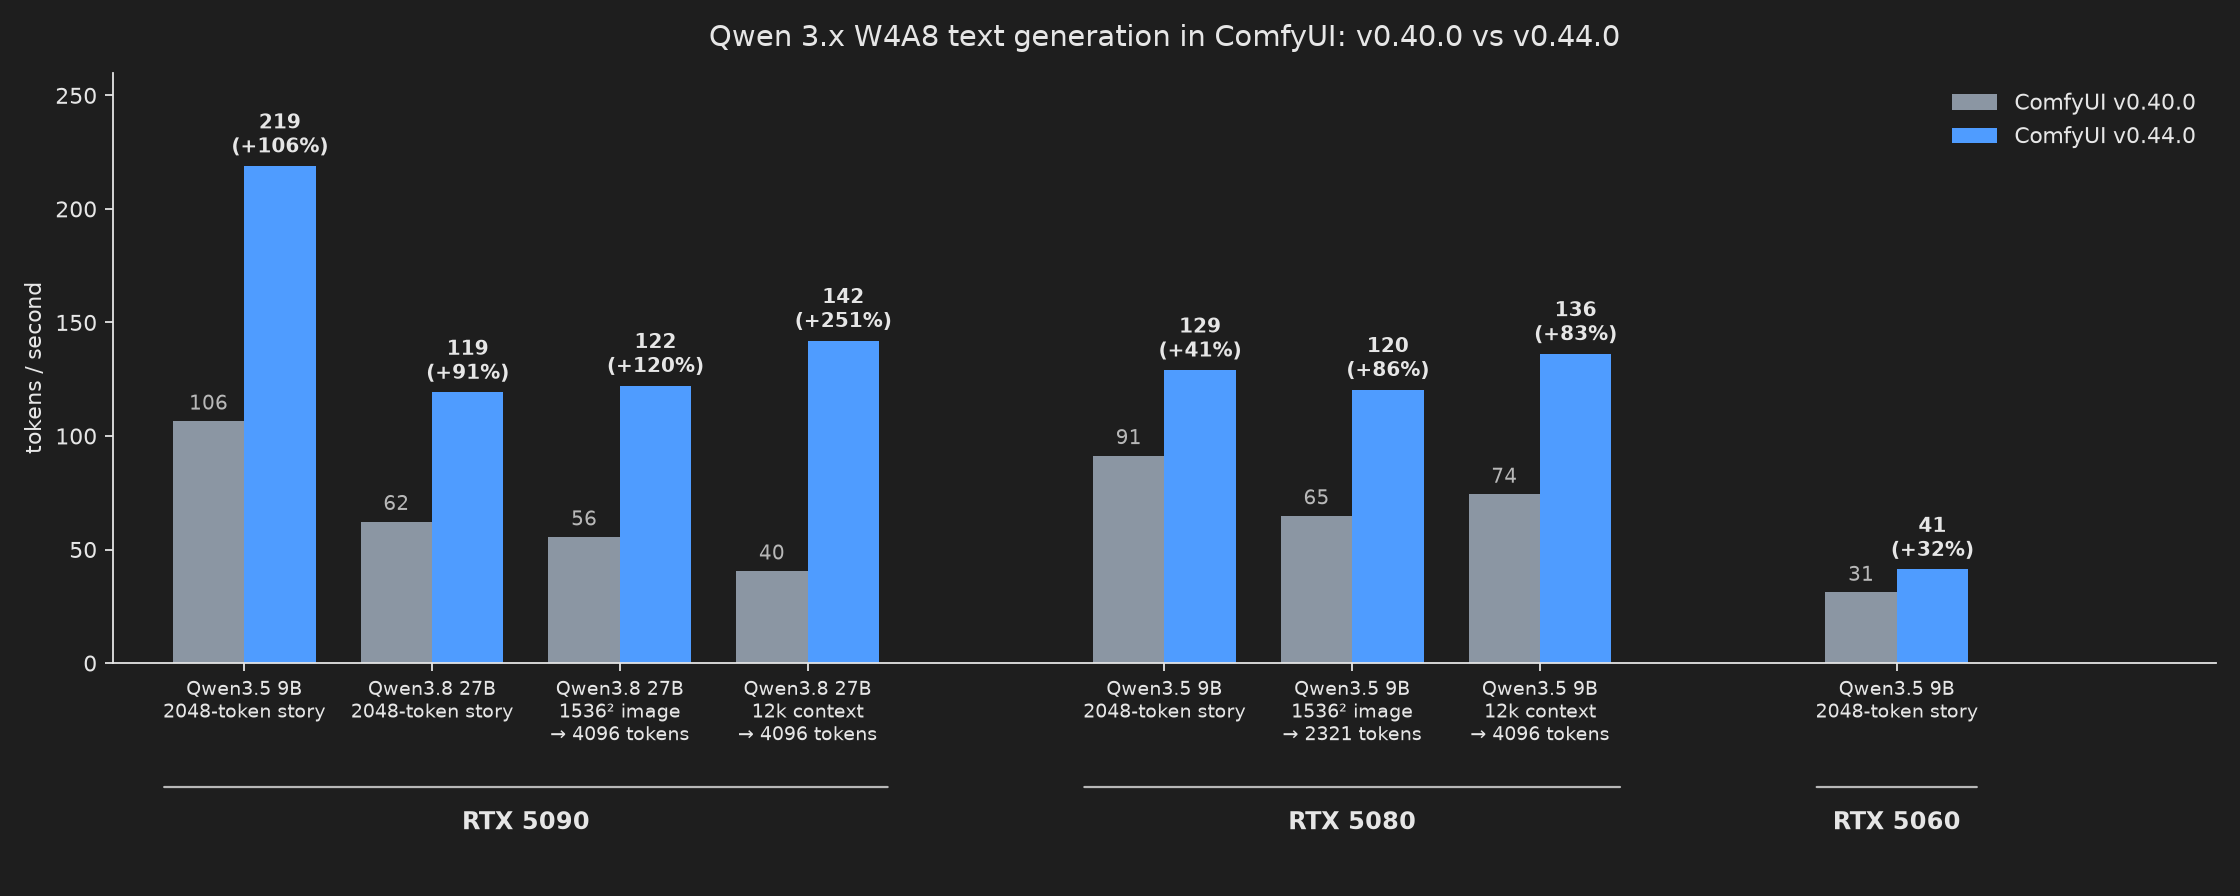
재작성을 발표한 Comfy-Org 엔지니어링 글에서 발췌.
측정된 토큰 속도
| 체크포인트 | GPU | 이전 | v0.45.0 |
|---|---|---|---|
| Qwen3.5 9B | RTX 5090 | 106 tok/s | 219 tok/s |
| Qwen3.5 9B | RTX 5080 | 91 tok/s | 129 tok/s |
| Qwen3.8 27B, 1536×1536 이미지 설명 | RTX 5090 | 55 tok/s | 122 tok/s |
Qwen3.8 27B W4A8은 RTX 5090에서 1500×1500 이미지를 설명하고 스토리를 작성하는 동안 초당 137토큰에 도달했습니다.
달라진 점
- 행렬-벡터 커널: W4A8 및 W6A8 가중치가 이제 커널이 읽는 순서대로 그룹별 스케일과 인터리브되어, 각 스레드 블록이 두 텐서 사이를 오가지 않고 하나의 연속된 구간을 스트리밍합니다. 재배치는 모델을 로드할 때 VRAM에서 한 번만 수행되며, 추가 RAM이나 VRAM 비용이 들지 않습니다.
- 적응형 트리 MTP: 다중 토큰 예측 헤드가 더 이상 단일 추측 체인을 작성하지 않습니다. 차선 토큰을 형제로 유지하고, 한 번의 패스에서 최대 8개의 행을 검증하며, 32단계마다 트리 형태를 다시 계획합니다. 코드, 목록, 출력에 재사용되는 프롬프트는 깊이에 유리하고, 창의적 글쓰기는 넓이에 유리합니다.
- Comfy-Kitchen 어텐션: LLM 어텐션 경로에 INT8 어텐션과 KV 캐시 지원이 추가되어 KV 캐시 VRAM 사용량을 줄이고 긴 프롬프트와 시스템 프롬프트의 프리필 속도를 높입니다.
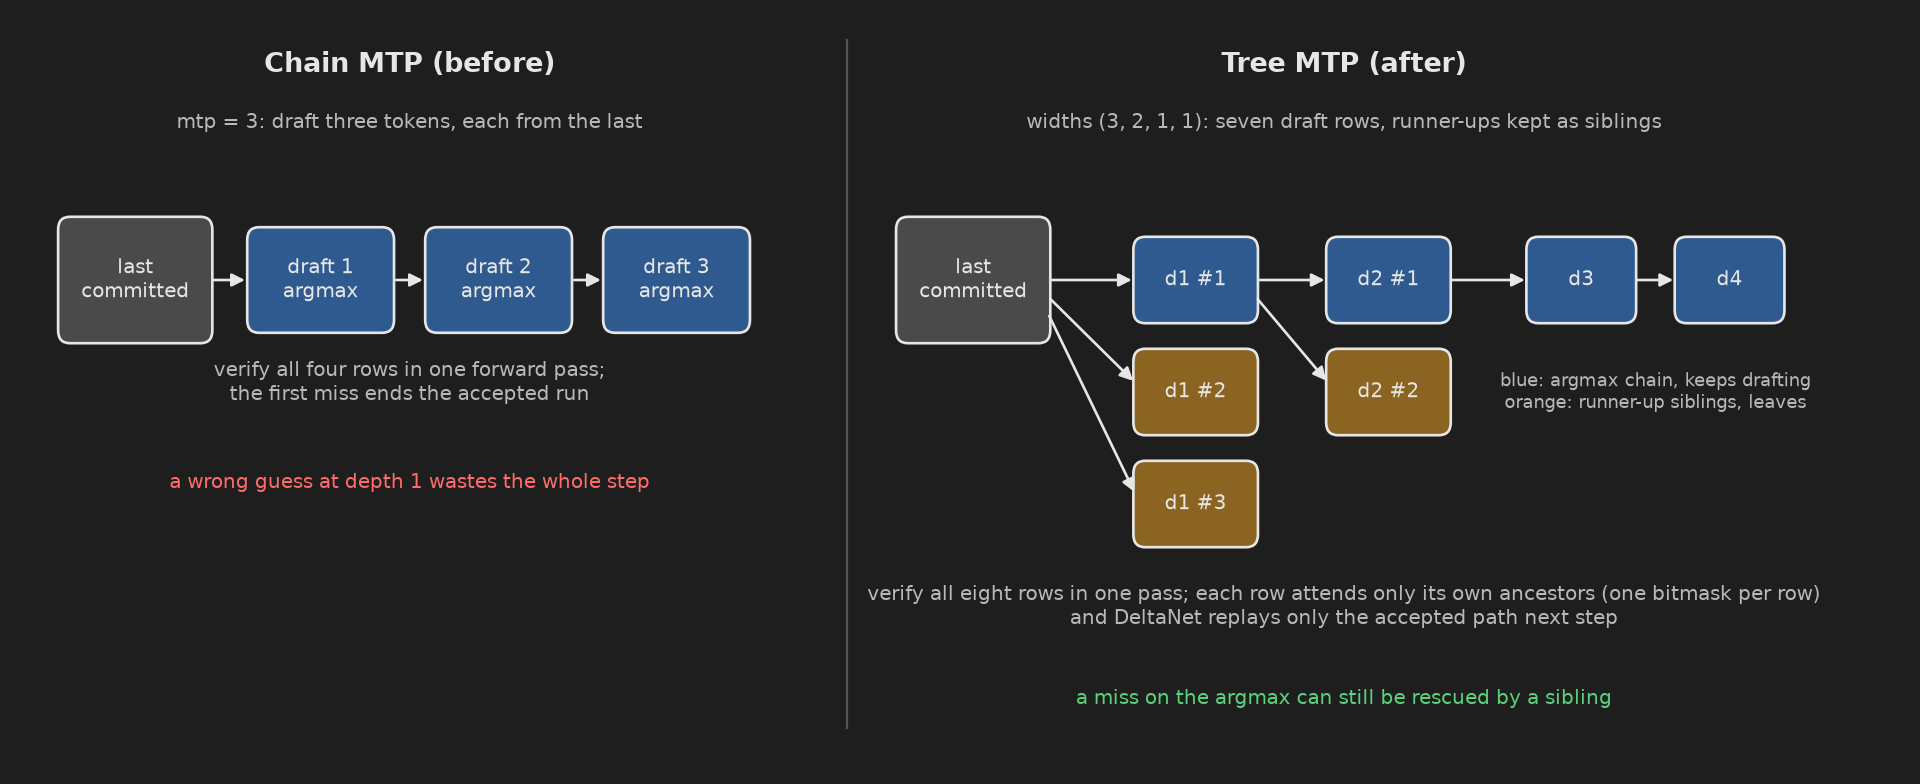
체인 MTP는 하나의 경로를 작성하고, 트리 MTP는 차선 토큰을 형제로 유지한 뒤 함께 검증합니다.
켜는 방법
- ComfyUI v0.45.0 이상으로 업데이트합니다.
- Qwen3.x 체크포인트를 로드하고
Generate Text노드로 실행합니다. mtp를auto로 둡니다. 고정된 값2부터5는 여전히 드래프트 깊이를 고정하며,tree*모드는 넓이와 깊이를 모두 고정합니다.- 선택 사항: Comfy-Kitchen 어텐션을 사용하려면
--use-ck-attention으로 ComfyUI를 시작합니다. 어텐션 지원이 포함된 Comfy Kitchen 빌드가 필요합니다.
위의 모든 기능은 NVIDIA 및 AMD GPU, Windows와 Linux에서 작동하며, 이전에는 메모리가 부족했던 더 긴 컨텍스트도 이제 처리됩니다. 노드 툴팁의 한 가지 세부 사항: MTP 출력은 올바르게 분포되지만 동일한 시드에 대해 비 MTP 출력과 다릅니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.