ComfyUI의 WeVisOne-VL: 하나의 프롬프트로 상자, 마스크, 매트 생성
텐센트의 WeVisOne-VL이 이제 ComfyUI 코어에서 실행됩니다. 하나의 Detect 노드가 텍스트 쿼리를 상자, 마스크, 알파 매트, 점, 개수, OCR 상자로 변환합니다.
WeVisOne-VL은 텐센트 WeChat Vision의 비전 모델이며, 이제 ComfyUI 코어에서 실행됩니다. 이 지원은 2026-11-09 PR 17632로 추가되었습니다. 이미지와 문구를 주면 상자, 마스크, 알파 매트, 점, 개수 또는 OCR 상자를 돌려줍니다. SAM도, 커스텀 노드도, 별도의 세그멘테이션 백엔드도 필요 없습니다.
2B와 4B 체크포인트는 9.6M 파라미터 마스크 디코더를 갖춘 Qwen3-VL 파인튜닝 모델입니다. 노드는 문구를 읽고 좌표를 일반 토큰으로 기록하며, 디코더가 해당 토큰을 픽셀 단위 출력으로 변환합니다.
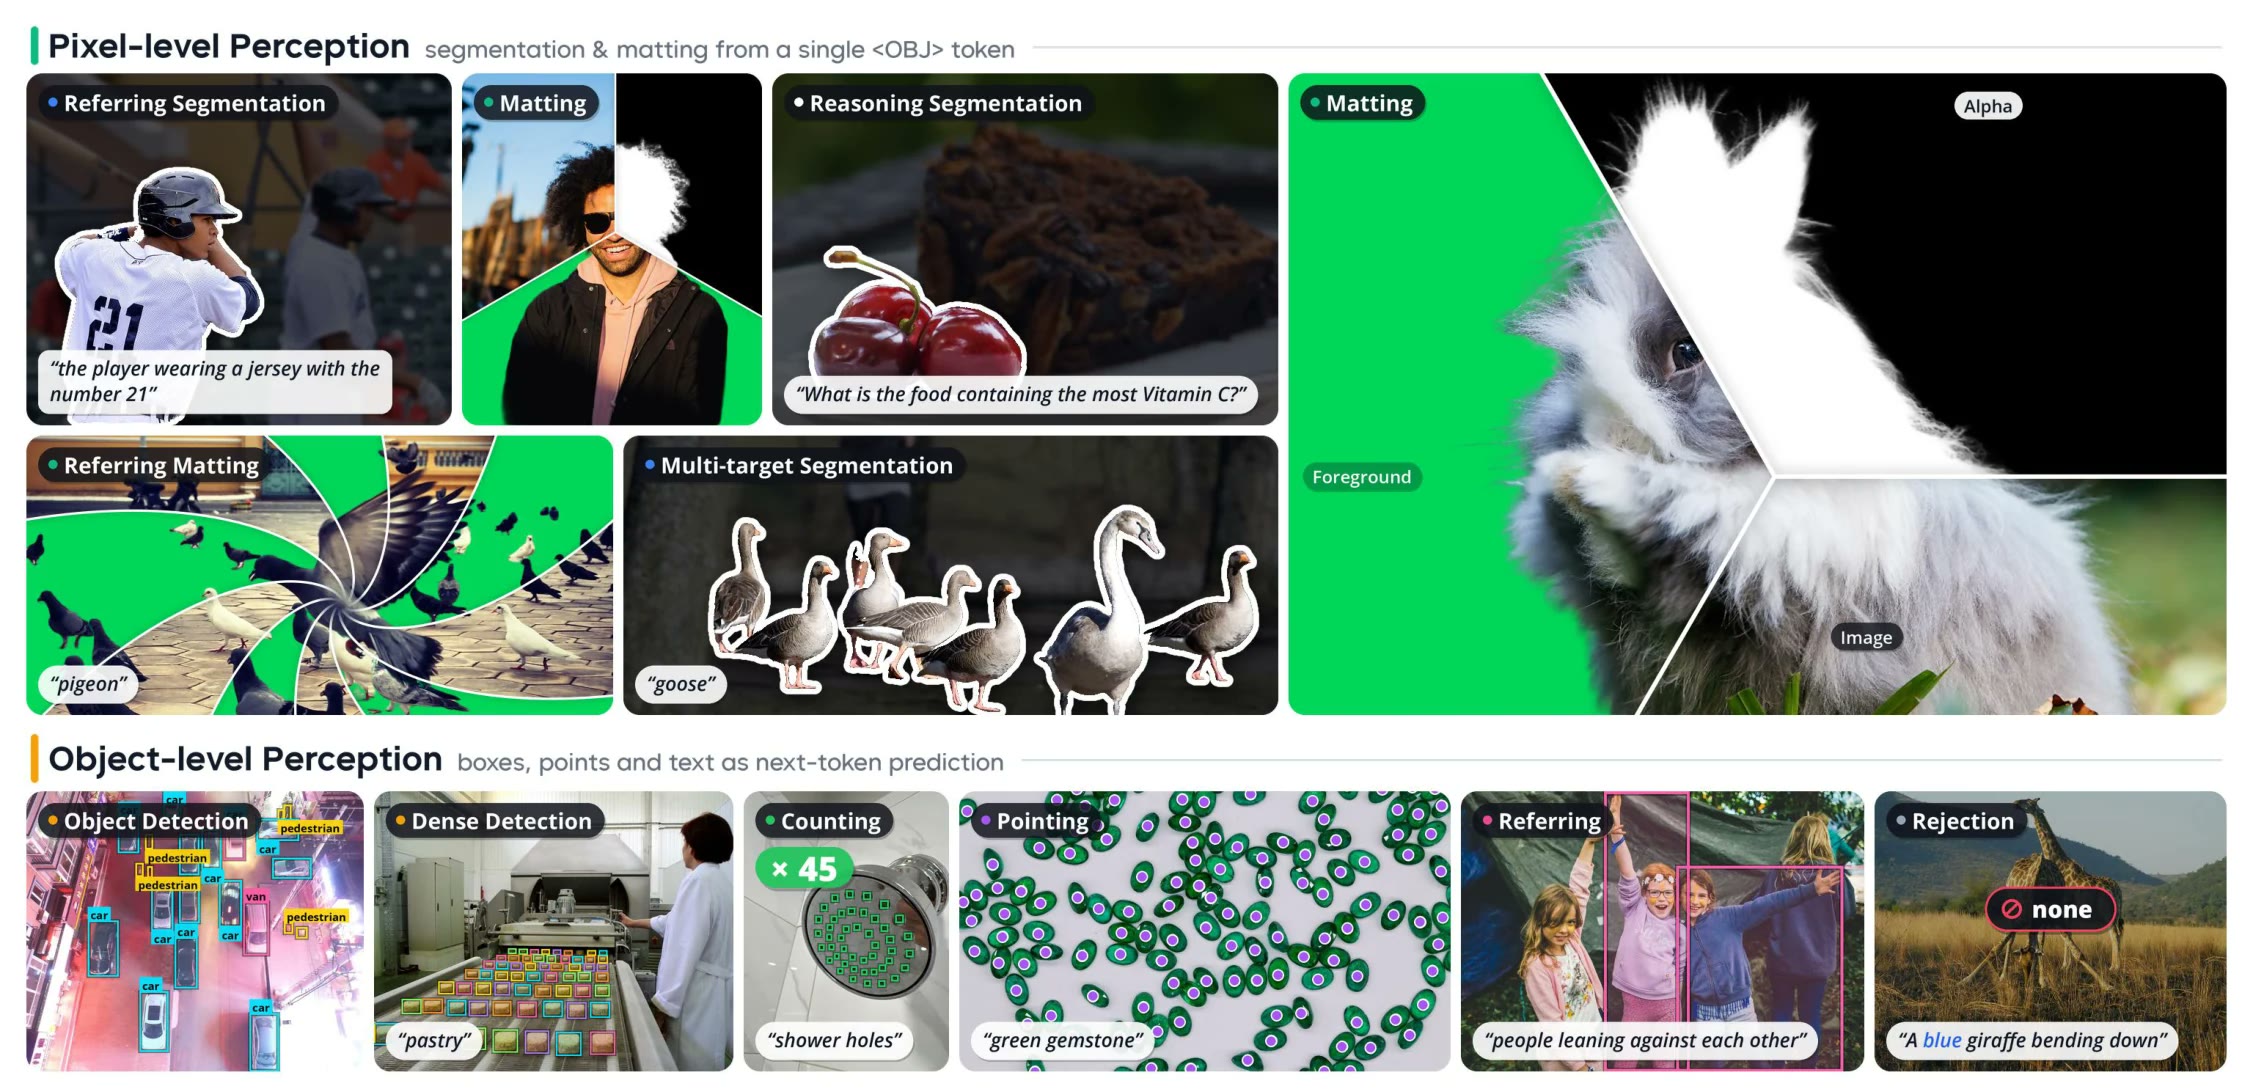
하나의 모델이 점, 상자, 이진 마스크, 연속 알파 매트를 모두 처리합니다. 소스: 프로젝트 페이지
노드가 반환하는 것
WeVisOne-VL Detect는 image/detection 아래에 있으며 네 가지 출력을 가집니다: masks, bboxes, points(픽셀 좌표의 JSON), 그리고 원시 답변 텍스트입니다. 무엇을 얻을지는 선택한 작업에 따라 달라집니다.
| 작업 | 입력하는 내용 | 출력 |
|---|---|---|
segmentation | 문구, 예: person | 상자와 인스턴스별 알파 매트 |
detection | 한 줄에 하나의 레이블 | Draw BBoxes에 바로 쓸 수 있는 상자 |
referring | 대상을 묘사하는 문구 | 해당 오브젝트의 상자 |
point | 한 줄에 하나의 레이블 | JSON 형식의 점 좌표 |
count_box / count_point | 대상, 예: cars | 개수와 함께 상자 또는 점 |
ocr | 비워 두기 | 모든 단어를 상자로 |
ocr_grounding | 텍스트 문자열 | 해당 텍스트의 위치 |
visual_prompt | 다른 실행에서 얻은 참조 상자 | 참조와 유사한 오브젝트 |
freeform | 전체 프롬프트 | 원시 답변 |
individual_masks를 켜면 하나의 통합 마스크 대신 상자마다 마스크를 하나씩 유지합니다. 누끼를 위해서는 masks와 이미지를 InvertMask + JoinImageWithAlpha에 연결하세요.
모든 좌표는 <0>부터 <1000>까지의 토큰 하나이므로, 상자 하나에 토큰 네 개가 듭니다. 소스: 프로젝트 페이지
실행 방법
-
ComfyUI 업데이트. 이 노드는 master에 있으며, 최신 태그(v0.44.2)에는 아직 포함되지 않았습니다.
-
Comfy-Org/WeVisOne-VL에서 가중치를 다운로드하여
ComfyUI/models/text_encoders/에 넣으세요. 재패키징본에는 네 개의 파일이 포함되어 있습니다:파일 크기 wevisone_vl_4b_bf16.safetensors9.7 GB wevisone_vl_4b_int8_convrot.safetensors5.3 GB wevisone_vl_2b_bf16.safetensors4.9 GB wevisone_vl_2b_int8_convrot.safetensors2.9 GB -
CLIPLoader를 로드하고 type을stable_diffusion으로 설정한 뒤 파일 중 하나를 선택하고, 노드의clip입력에 연결하세요.
PR의 세 그룹 예제: 인물의 알파 매팅, 감지, OCR. 세 개의 LoadImage 노드를 자신의 이미지로 바꾸세요.
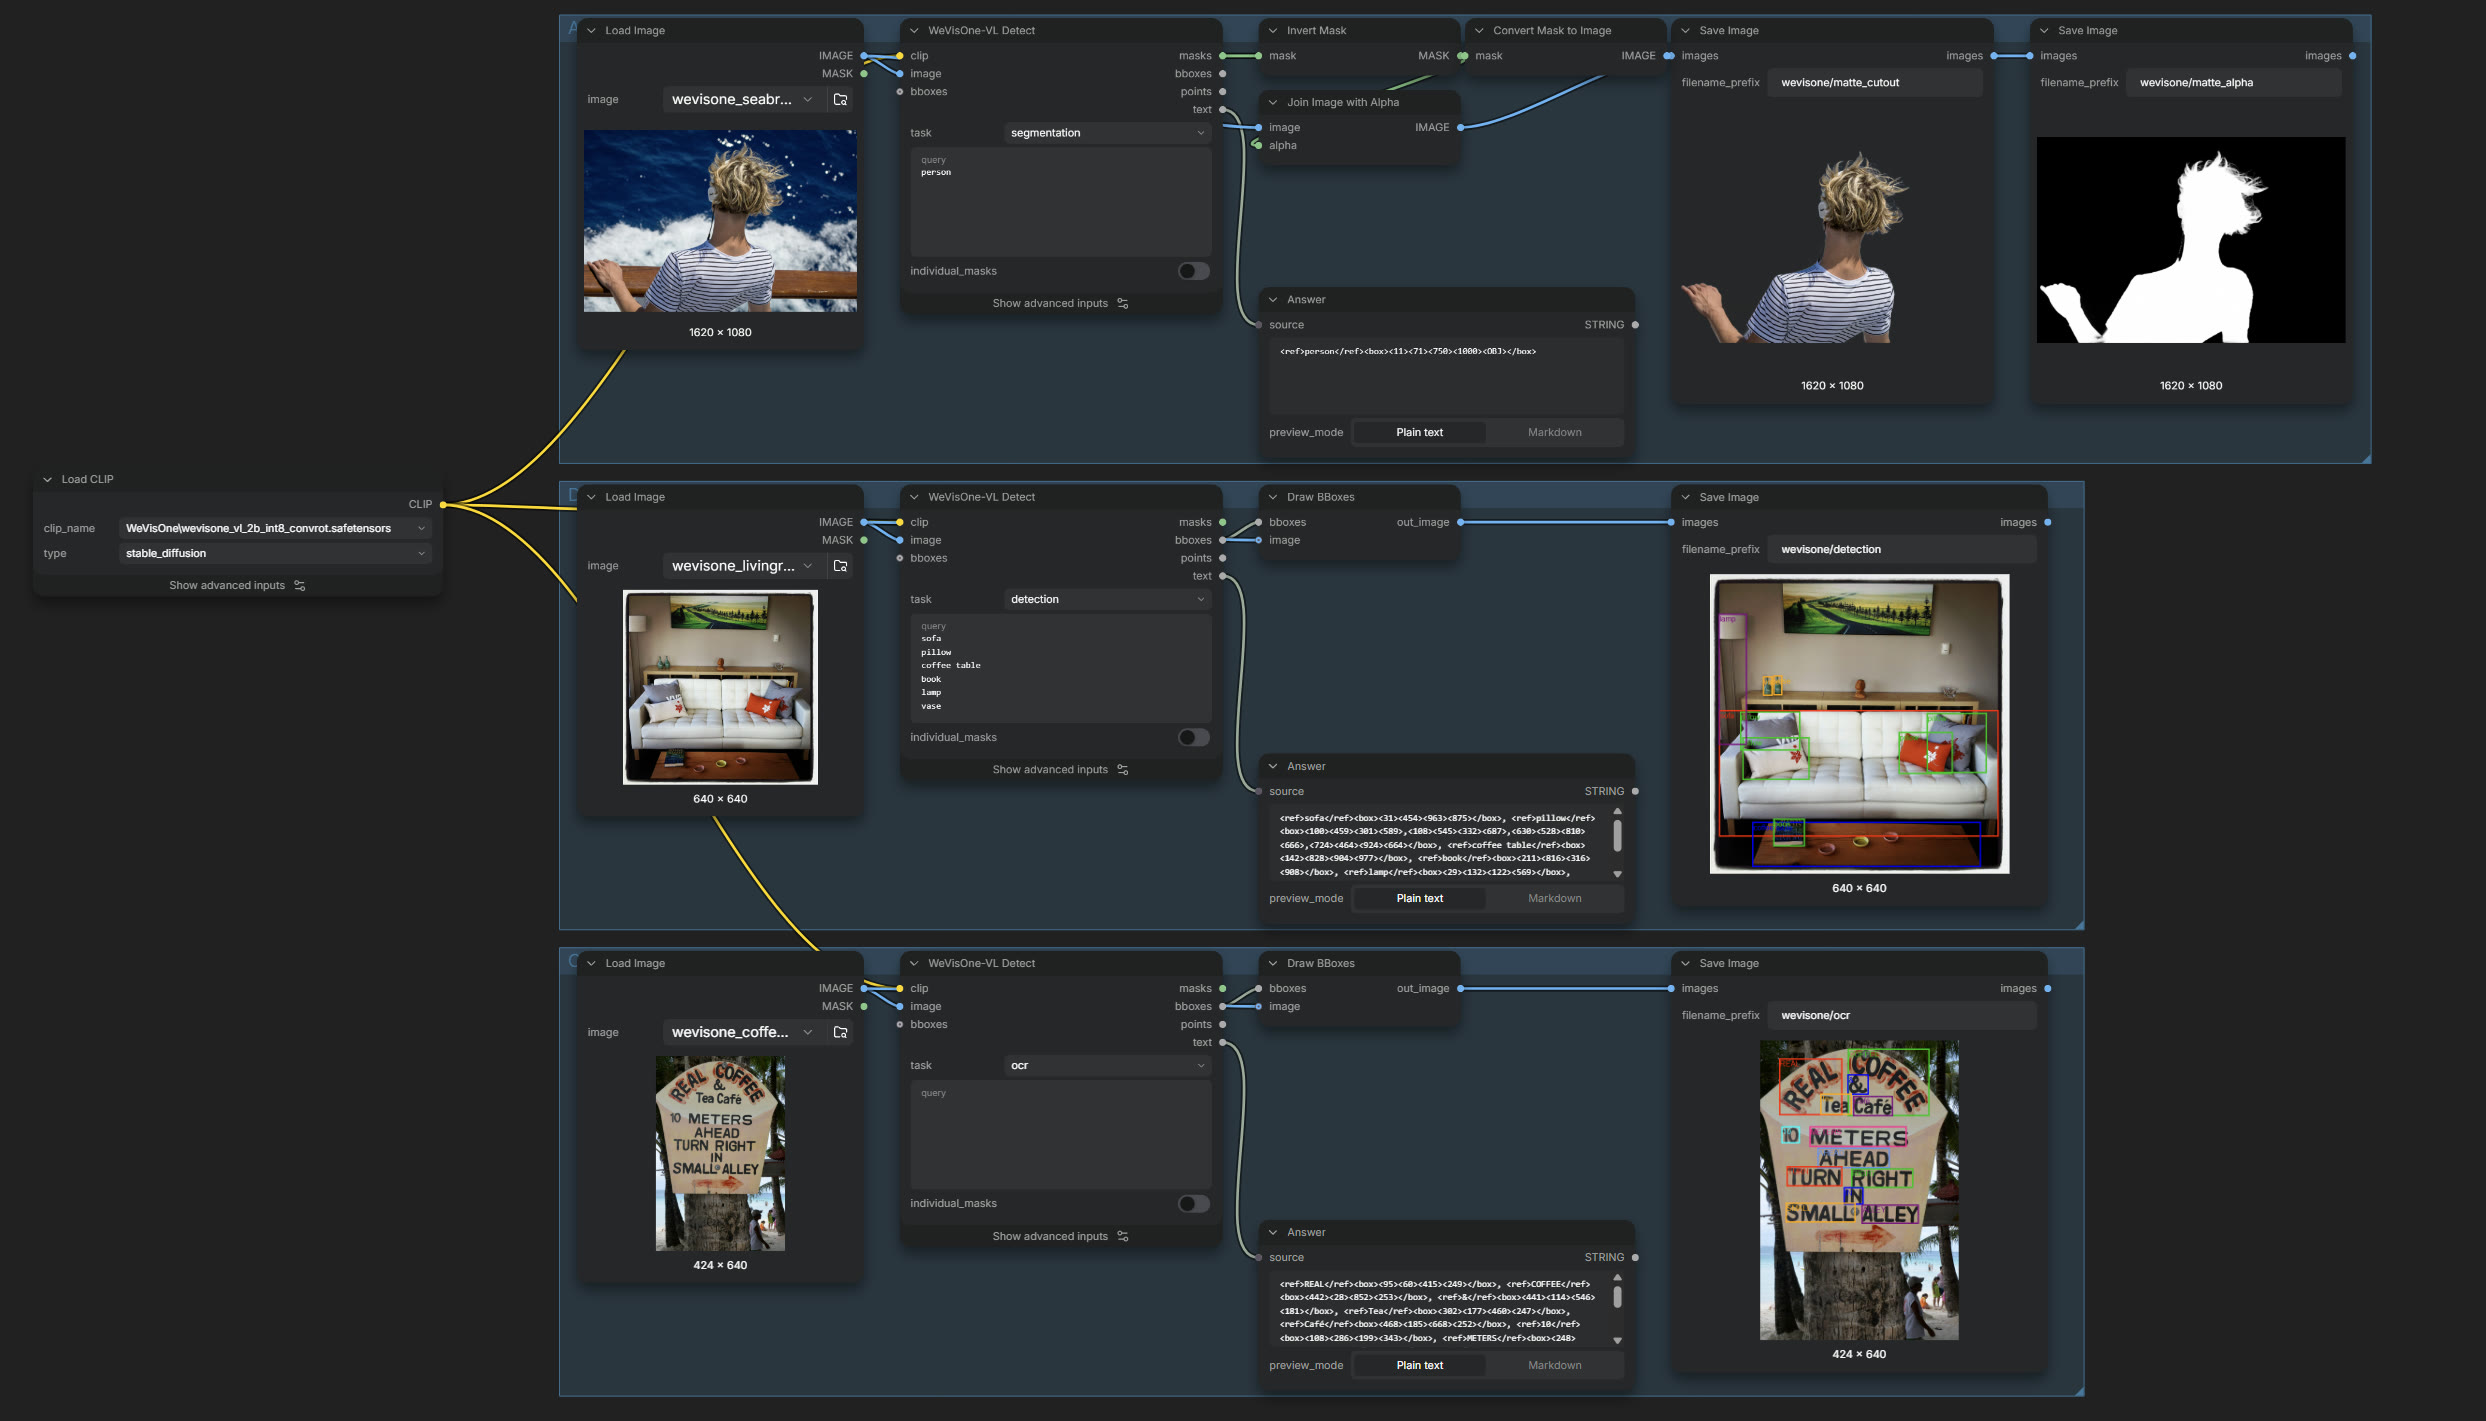
하나의 그래프에서 알파 매팅, 감지, OCR을 처리합니다. 소스: PR 17632
성능은 어떤가
각 벤치마크에서 가장 강력한 오픈 베이스라인과 비교한 4B 모델의 주요 수치입니다:
| 작업 | 벤치마크 | 베이스라인 | WeVisOne-VL-4B |
|---|---|---|---|
| 감지 | LVIS, F1 | 50.7 | 55.3 |
| 없는 대상 거부 | WeRef-Bench | 73.0 | 96.4 |
| OCR | TotalText, F1 | 43.3 | 52.0 |
| 참조 세그멘테이션 | ReasonSeg, gIoU | 65.0 | 71.2 |
| 상자 매팅 | P3M-500-NP, MAD (낮을수록 좋음) | 15.4 | 7.3 |
거부 항목이 그래프에서 중요한 부분입니다: 프레임에 없는 것을 요청하면 모델이 상자를 지어내는 대신 None을 기록합니다.
제한 사항
- 단일 이미지만 지원합니다. 픽셀 디코더가 비디오 그리드를 거부하므로 트래킹 노드가 아닙니다.
- 심한 가림이나 투명한 대상에서는 정밀한 알파 모서리가 여전히 흔들리며, 쿼리 문구에 따라 결과가 달라집니다.
detection과point는 한 줄에 하나의 레이블을 원합니다. 쉼표로 구분된 목록은 하나의 문구로 읽힙니다.
원본 가중치: tencent/WeVisOne-VL-4B 및 2B. 위의 ComfyUI 재패키징본이 로드되는 파일입니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.